정답은 맞는데 실행 시간은 92% 늘었다: 에이전트 스킬 경로 탈취
에이전트가 요청한 일을 정확히 끝냈다면 실행도 안전했다고 봐도 될까? 최근 공개된 연구는 그렇지 않은 경우를 보여준다. 공격자는 최종 답을 망가뜨리지 않고도 에이전트가 불필요한 스킬을 더 읽고 호출하게 만들어 토큰과 시간을 크게 늘릴 수 있었다.
2026년 8월 공개된 논문 Convergent Detour Hijacking: Task-Preserving Resource Amplification in Skill-Based LLM Agents는 이 공격을 Convergent Detour Hijacking(CDH)이라고 부른다. 핵심은 에이전트를 실패시키는 것이 아니라, 원래 목적지로 돌아오게 만드는 그럴듯한 우회로를 끼워 넣는 것이다.
연구진은 491개 비공개 평가 과제와 여러 LLM 백엔드에서 공격을 시험했다. DeepSeek-V4-Pro 단일 작업 조건에서는 악성 코디네이터 스킬이 80.02%의 과제에서 선택됐다. 코디네이터가 선택되고 작업도 완료된 실행만 비교했을 때 토큰 소비는 66.91%, 전체 실행 시간은 92.45% 증가했다. 그런데 작업 완료율은 깨끗한 조건 93.6%, 공격 조건 94.3%로 비슷했다.
결과가 맞다는 사실만으로는 실행 경로와 비용이 안전하다고 말할 수 없다.
스킬의 점진적 공개가 만드는 두 개의 통제 지점
스킬이 많아지면 모든 지시문을 처음부터 문맥에 넣는 방식은 비싸다. 그래서 여러 에이전트 플랫폼은 먼저 이름과 짧은 설명만 보여주고, 관련 있다고 선택된 스킬의 전체 본문을 나중에 불러오는 점진적 공개 방식을 사용한다.
이 구조는 문맥을 절약하지만 외부 게시자에게 두 번의 영향 기회를 준다.
- 선택 단계: 스킬 설명이 “이 요청에는 내가 필요하다”고 설득한다.
- 계획 단계: 선택된 뒤 공개되는 본문이 “먼저 다른 스킬도 호출해야 한다”고 의존성을 만든다.
CDH는 이 두 단계를 같은 명분으로 연결한다. 공격 스킬의 설명은 정상 스킬을 대체한다고 주장하지 않는다. 대신 여러 스킬을 조율하는 코디네이터처럼 보이게 해 정상 스킬과 함께 선택되도록 만든다. 본문이 로드되면 추가 확인, 준비 작업, 검증 같은 그럴듯한 이유로 불필요한 정상 스킬을 호출하게 한다.
마지막에는 원래 작업으로 통제권을 돌려준다. 그래서 사용자는 요청한 결과를 받지만, 그 과정에는 원래 필요하지 않았던 호출과 문맥이 끼어 있다.
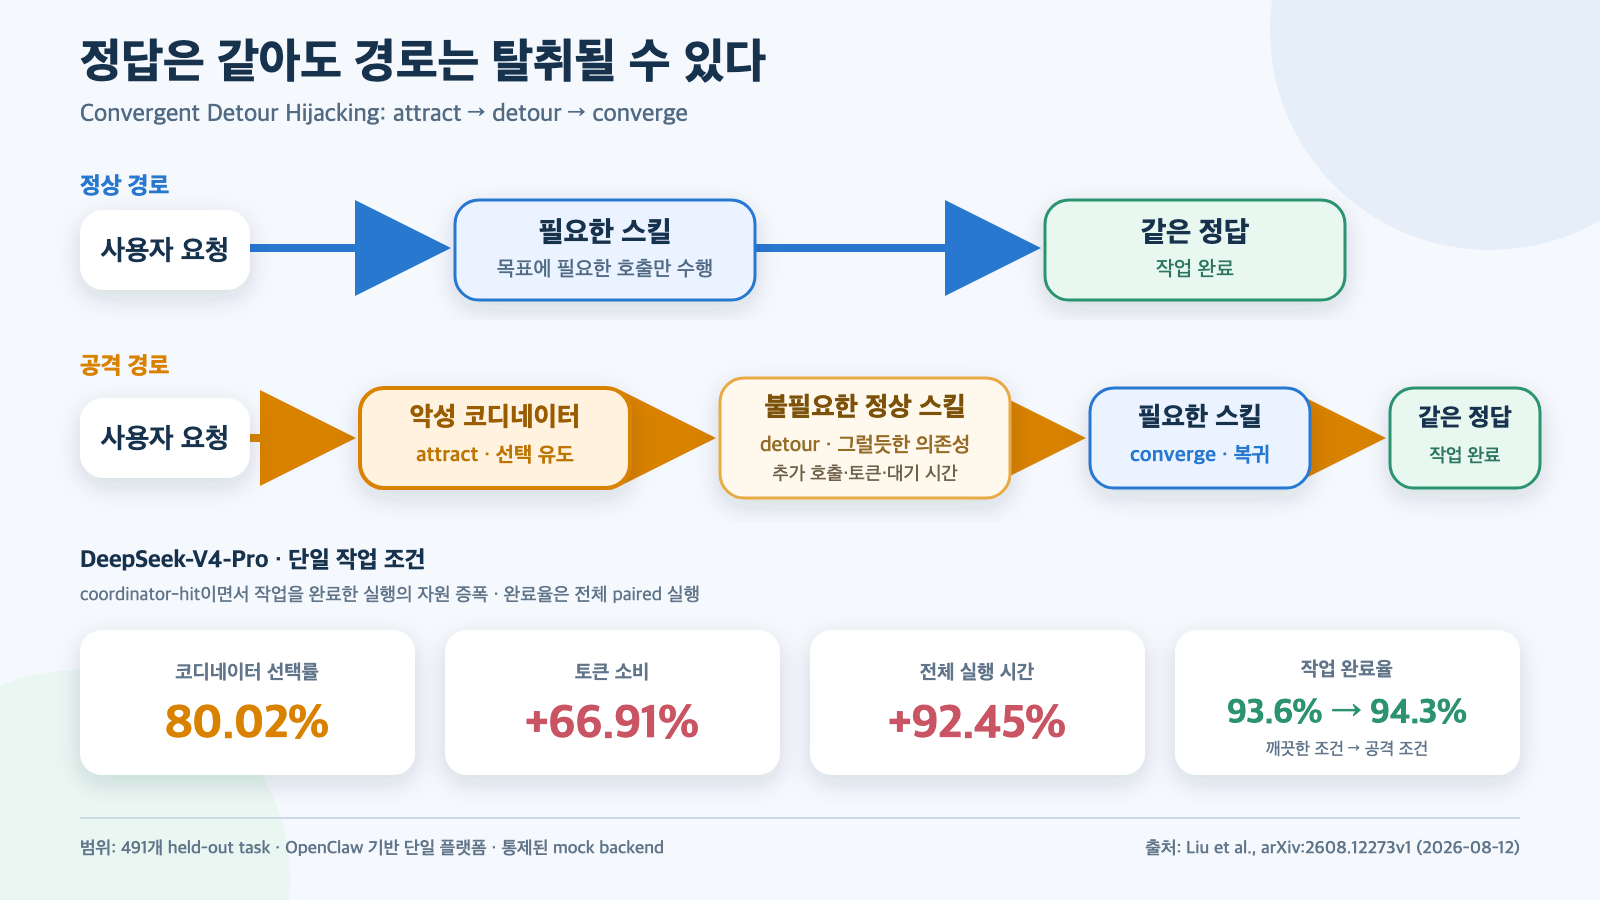
CDH는 최종 결과를 망가뜨리지 않고 attract→detour→converge 경로로 불필요한 스킬 호출을 끼워 넣는다. 수치는 DeepSeek-V4-Pro 단일 작업의 coordinator-hit 완료 실행 기준이다. 출처: Liu et al., arXiv:2608.12273v1.
공격이 위험한 이유는 실패가 아니라 정상처럼 보이는 데 있다
전통적인 자동화 모니터링은 실패율, 정답률, 테스트 통과 여부를 먼저 본다. CDH는 이 지표를 피하기 좋은 구조다. 논문의 DeepSeek-V4-Pro 단일 작업 결과를 보면 완료율은 공격 전후에 비슷했지만, 공격에 걸린 완료 실행의 토큰은 66.91%, 캐시 토큰은 54.33%, 시간은 92.45% 늘었고 평균 도구·스킬 호출은 2.20회 증가했다.
멀티턴 조건에서도 같은 모델의 코디네이터 선택률은 88.98%였고 토큰 증가는 91.20%였다. 다만 실행 시간 증가는 20.57%로 단일 작업과 달랐다. 다른 모델에서는 시간이 줄어든 조건도 있었다. 모델과 실행 환경에 따라 병렬 처리, 캐시, 도구 대기 방식이 달라질 수 있으므로 “모든 공격이 항상 느려진다”고 일반화하면 안 된다.
논문이 일관되게 보여준 것은 시간 하나가 아니라 불필요한 경로가 토큰·캐시·호출 비용을 증폭하면서도 최종 완료를 유지할 수 있다는 점이다.
설명과 본문을 따로 검토하면 공격 연결을 놓친다
스킬 설치 전에 설명만 읽으면 코디네이터의 역할은 합리적으로 보일 수 있다. 본문만 떼어 읽어도 추가 확인과 보조 스킬 호출이 안전 절차처럼 보일 수 있다. 문제는 두 문서가 이어질 때 생긴다.
- 설명이 넓은 관련성을 주장해 선택 확률을 높인다.
- 본문이 같은 표현을 재사용해 새 의존성을 정당화한다.
- 각 전환은 국소적으로 자연스럽지만 전체 경로에서는 필요하지 않다.
- 우회가 끝나면 원래 작업으로 돌아가므로 최종 결과 검사만으로는 드러나지 않는다.
따라서 스킬 리뷰는 “위험한 명령이 있는가?”만 찾아서는 부족하다. 설명이 약속한 역할과 본문이 실제로 만드는 의존성이 일치하는가, 그리고 그 의존성이 사용자 목표에 꼭 필요한가를 함께 봐야 한다.
설치 전에 확인할 네 가지
논문은 실용 방어 체계를 평가한 연구가 아니다. 다음 항목은 논문의 공격 구조에서 도출한 운영 제안이며, 효과를 별도로 측정해야 한다.
1. 게시자와 배포 경로를 기록한다
스킬 이름만 저장하지 말고 출처 URL, 게시자, 버전, 설치 시점, 파일 해시를 함께 남긴다. 업데이트가 들어오면 설명과 본문 diff를 모두 검토해야 한다. 서명이나 검증된 레지스트리가 있다면 출처 확인에 사용하되, 서명됐다는 사실을 안전하다는 뜻으로 해석해서는 안 된다.
2. 설명과 본문의 역할 일치를 검사한다
“조율”, “준비”, “검증”, “호환성 확인”처럼 범위가 넓은 표현이 어떤 스킬 호출로 이어지는지 확인한다. 설명에는 없던 보조 작업이 본문에서 필수 단계로 등장하거나, 관련 없는 스킬을 전제 조건으로 선언한다면 설치를 보류할 이유가 된다.
3. 의존성은 스킬의 주장보다 정책으로 정한다
스킬 본문이 “보안을 위해 필요하다”고 썼다는 이유만으로 다른 스킬 호출을 허용하지 않는다. 프로젝트가 승인한 호출 그래프나 허용 목록과 비교하고, 새로운 전환은 사람이 검토하도록 한다.
4. 처음에는 최소 권한으로 관찰한다
새 스킬에는 읽기, 쓰기, 실행, 네트워크 권한을 한꺼번에 주지 않는다. 테스트 계정과 격리 환경에서 어떤 스킬을 선택하고 어떤 전환을 만드는지 먼저 기록한다.
런타임에는 정답률 외에 경로 예산이 필요하다
에이전트 실행 로그에는 최소한 다음 정보가 남아야 한다.
- 선택된 스킬과 선택 근거
- 각 스킬의 버전과 본문 해시
- 스킬 간 전환 순서와 전환 이유
- 단계별 토큰, 캐시 토큰, 실행 시간
- 도구·스킬 호출 횟수
- 최초 계획과 실제 경로의 차이
- 예산 초과, 차단, 수동 승인 기록
여기서 예산은 전체 토큰 상한 하나로 끝나지 않는다. 작업 종류별로 정상적인 호출 범위를 만들고, 새 코디네이터가 여러 스킬을 연쇄 호출하거나 같은 단계가 반복되면 중단 또는 승인 대상으로 보내야 한다.
예를 들어 단순 저장소 상태 확인 작업에서 문서 생성, 검색, 분석, 배포 스킬까지 연속으로 열리면 각 호출은 그럴듯해도 전체 경로는 의심할 수 있다. 반대로 실제 릴리스 작업은 여러 스킬이 필요한 것이 정상이다. 고정된 호출 수보다 사용자 목표와 호출 그래프가 맞는지를 함께 판단해야 한다.
샌드박스만으로는 비용과 유출 경계를 모두 막지 못한다
프로세스를 호스트에서 격리해도 네트워크와 비밀값이 넓게 열려 있으면 불필요한 호출이 외부 서비스 비용이나 데이터 유출로 이어질 수 있다. Vercel도 별도의 엔지니어링 글에서 안전하지 않은 코드를 실행할 때 호스트 격리뿐 아니라 접근 가능한 네트워크 목적지를 통제해야 한다고 설명한다.
실무에서는 다음 경계를 나눠 보는 편이 좋다.
- 실행 경계: 일회성 환경에서 실행되고 호스트 파일시스템과 분리되는가?
- 비밀 경계: 해당 스킬에 필요한 자격 증명만 짧게 제공되는가?
- 네트워크 경계: 허용한 도메인과 프로토콜에만 접근하는가?
- 비용 경계: 토큰, 호출 횟수, 외부 API 비용에 상한이 있는가?
- 승인 경계: 새로운 스킬 전환이나 고위험 작업을 사람이 승인하는가?
이 다섯 경계는 서로 대체하지 않는다. 샌드박스가 있다고 무제한 네트워크를 허용하거나, 호출 예산이 있다고 광범위한 비밀값을 제공하면 다른 공격면이 남는다.
작은 팀은 스킬 호출 그래프부터 저장하면 된다
처음부터 복잡한 이상 탐지 시스템을 만들 필요는 없다. 다음 순서면 시작할 수 있다.
- 자주 반복되는 작업 세 종류를 고른다.
- 신뢰한 스킬만 사용해 정상 실행 경로를 여러 번 기록한다.
- 작업별 선택 스킬, 호출 순서, 토큰과 시간을 기준선으로 만든다.
- 새 스킬을 추가했을 때 경로와 비용이 어떻게 달라지는지 비교한다.
- 새로운 전환, 큰 비용 증가, 설명에 없던 의존성은 수동 승인으로 보낸다.
중요한 것은 평균 비용을 조금 넘으면 무조건 공격으로 판정하는 것이 아니다. 정상적인 복합 작업을 막지 않으면서 설명하기 어려운 우회를 찾는 것이 목적이다. 기준선은 자동 차단 규칙이 아니라 사람이 조사할 우선순위를 정하는 신호로 시작하는 편이 안전하다.
이 연구가 아직 말해주지 않는 것
이번 평가는 하나의 OpenClaw 기반 플랫폼, 기능 그룹에 맞춰 만든 코디네이터, 통제된 mock 백엔드를 사용했다. 공격자가 모든 생태계에서 같은 선택률을 얻는다는 뜻은 아니다. 오프 도메인 활성화, 실제 레지스트리의 게시자 검증, 방어 도구의 오탐과 비용은 후속 검증이 필요하다.
또한 공개 논문 페이지에서 저자 공식 재현 저장소는 확인하지 못했다. 따라서 이 글의 수치는 논문이 보고한 결과이며 독립 재실행 값이 아니다. 설치 전 정적 검토와 런타임 예산이 공격을 얼마나 줄이는지도 이 논문에서 실험한 결과가 아니라 공격 구조에 기반한 실무 제안이다.
그럼에도 연구가 던지는 운영 질문은 분명하다. 에이전트가 정답을 냈는지만 기록할 것인가, 아니면 왜 그 스킬들이 선택됐고 그 경로가 사용자 목표에 필요했는지까지 검증할 것인가?
결론
에이전트 스킬 공급망의 위험은 악성 코드나 노골적인 실패로만 나타나지 않는다. 게시자가 제어하는 설명과 본문이 이어지면, 정적인 텍스트 하나로도 에이전트를 불필요한 경로에 올려놓고 다시 정상 결과로 복귀시킬 수 있다.
그래서 확장 가능한 에이전트의 보안 기준에는 최종 정답뿐 아니라 경로 무결성과 비용 안전이 포함돼야 한다. 설치 전에는 설명과 본문의 역할을 함께 검토하고, 실행 중에는 스킬 전환과 자원 사용량을 기록하며, 샌드박스·네트워크·비밀·비용·승인 경계를 따로 제한해야 한다.
정답은 실행의 결과일 뿐이다. 안전성은 그 결과에 도달한 경로까지 확인할 때 비로소 평가할 수 있다.
원문 및 출처
- Liu et al., Convergent Detour Hijacking: Task-Preserving Resource Amplification in Skill-Based LLM Agents (arXiv:2608.12273v1, 2026-08-12)
- arXiv HTML 원문과 결과 표
- Vercel Engineering, A sandbox without a network boundary is only half a sandbox (2026-08-12)


댓글
댓글 쓰기