docs 커밋의 74%는 문서가 아니었다: Claude Code 플러그인 마켓플레이스 77,773개 커밋 분석
에이전트 플러그인은 자연어 지침 파일, 스크립트, 설정 파일의 묶음이다. 커밋 접두어를 보면 docs:가 붙은 변경이 많은데, 전통적인 감각으로는 문서를 고친 것으로 읽힌다. 그런데 그 문서가 사람을 위한 README가 아니라 에이전트가 런타임에 읽는 지침이라면 이야기가 달라진다. 지침을 고쳤다는 것은 에이전트 행동을 고쳤다는 뜻이고, 그 커밋은 기능 추가나 버그 수정에 가깝다. 라벨이 말하는 것과 커밋이 하는 일이 갈라지는 순간, 커밋 통계로 유지보수 상태를 읽던 기존 방법이 흔들린다.
Queen's University SAIL 연구실(Hereiz, Lyu, Li, Adams, Hassan)은 8월 28일 이런 질문을 다룬 실증 논문 On the Maintenance and Co-evolution of Agent Plugins을 공개했다. 연구진은 GitHub에서 marketplace.json을 찾는 방식으로 Claude Code 플러그인 마켓플레이스 1,926개 저장소를 수집했고, 2,018개 마켓플레이스의 플러그인 8,351개와 플러그인 관련 커밋 77,773개(고유 기여자 3,948명)를 분석했다. 데이터 수집 시점은 2026년 4월 2일이다. 결론부터 요약하면 이 생태계는 세 가지에서 기존 소프트웨어와 다르다. 성장 속도, 커밋 라벨의 의미, 그리고 지침 파일과 스크립트 사이에 새로 생긴 유지보수 의존성이다.
성장은 6개월 동안 매달 새 기록을 세웠다
2025년 10월 Claude Code 플러그인 마켓플레이스가 공식 출시된 뒤 6개월간 플러그인 관련 커밋은 2,923건에서 25,618건으로 8.8배 늘었다. 월별로 매달 직전 기록을 갱신했고, 맨-켄달 추세 검정에서 상승 추세가 유의했다(p=0.003). Sen's slope 추정으로는 한 달에 약 4,550건씩 증가하는 셈이다. 데이터 마감 시점까지 정체 구간은 없었다.
저장소 수도 같은 방향으로 늘었다. 출시 후 6개월 창(2026년 1~3월)에 새로 만들어진 마켓플레이스 저장소는 1,102개로, 출시 직후 3개월(2025년 10~12월)의 525개보다 2.1배 많았다. 출시 이후 창에 만들어진 저장소가 전체의 84.5%다. 통계 검정(Mann-Whitney U, p<0.001, Cliff's δ=1.0)도 출시 이후 집중을 뒷받침한다.
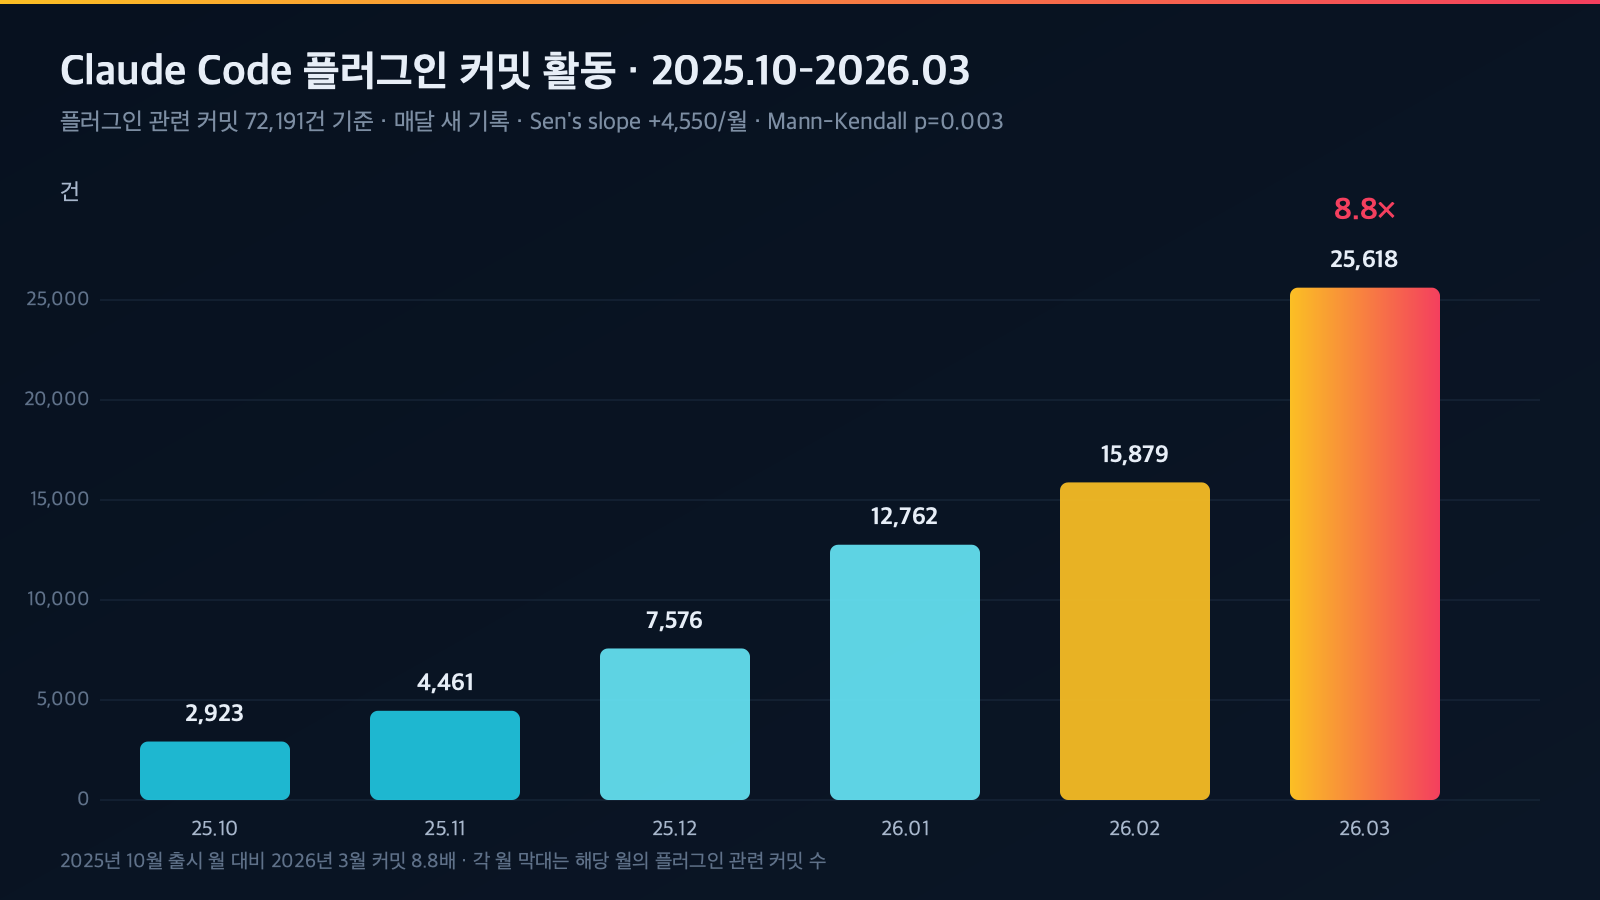
플러그인 관련 커밋은 6개월간 8.8배 늘었고 매달 새 기록을 세웠다. Sen's slope 추정 증가폭은 월 약 4,550건이다. 출처: arxiv.org/abs/2608.28497.
규모를 읽을 때는 구성 비율을 함께 봐야 한다. 플러그인 8,351개 중 소프트웨어 엔지니어링 작업을 표적으로 하는 것(코드 생성, 인프라, 디버그·분석, 버전 관리)이 61.3%였다. 컴포넌트 유형별로는 skills가 압도적이다. 출시 시 1,776개였던 skills 인스턴스가 2026년 3월까지 22배 증가해 39,287개에 달했고, 같은 기간 commands는 3.7배(10,238개), agents는 3.9배(6,500개) 증가하는 데 그쳤다. 2026년 3월 기준 skills는 나머지 모든 컴포넌트 유형을 합친 것(20,280개)보다 많다. 이름으로는 38.7%가 중복 등록돼 있어 집계기 수가 실제 공급 다양성을 과장한다는 점도 함께 봐야 한다.
커밋 라벨이 전통적 의미를 잃는 방식
연구진은 전체 커밋 77,773개에 Conventional Commits 분류를 적용했다. 1단계에서 정규식으로 접두어를 읽어 65.7%를 분류하고, 2단계에서 나머지를 GPT-5-mini로 분류했다. 각 단계는 385개 표본으로 사람 검증을 거쳤고 일치도는 각각 92%(κ=0.903)와 76.4%(κ=0.707)였다. 여기에 700개 커밋을 층화 표본추출해 두 명의 연구자가 직접 코딩하는 수동 분석을 얹었다(κ=0.671).
이 기반 위에서 드러난 것이 라벨과 실제 작업의 어긋남이다. docs로 분류된 커밋의 74%는 사람이 읽는 문서가 아니라 Claude가 런타임에 읽는 지침 파일(SKILL.md, agents/*.md)을 고쳤다. 연구진이 커밋이 실제로 하는 일을 기준으로 docs, ci, style을 재분류하자 docs 비중은 10.3%에서 1.7%로 떨어졌다. docs로 분류됐던 8,007개 중 3,353개는 fix로, 3,047개는 feat로, 279개는 chore로 옮겨갔다. 사람이 읽는 문서로 남은 것은 16%뿐이었다. 전통적 오픈소스 기준(8.1%)보다 높던 docs 비중이 실질 기준으로는 훨씬 낮아지는 역전이다.
perf도 다르다. 전통적 의미인 알고리즘·런타임 개선이 아니라 모델 등급 배정, 오케스트레이션 오버헤드, 프롬프트 토큰 절감이 주였다(48.0%가 AI 실행 관리, 30.0%가 프롬프트 최적화). style은 코드 포매팅을 넘어 지침 문구의 정밀도를 다루는 경우가 36.0%였다. refactor는 절반이 AI 대면 지침 텍스트를 다듬는 작업이었다. 라벨은 유지되지만 대상이 코드에서 자연어 지침으로 옮겨가는 유형과, docs처럼 라벨 자체가 다른 유형으로 재분류되는 유형이 나뉜다.
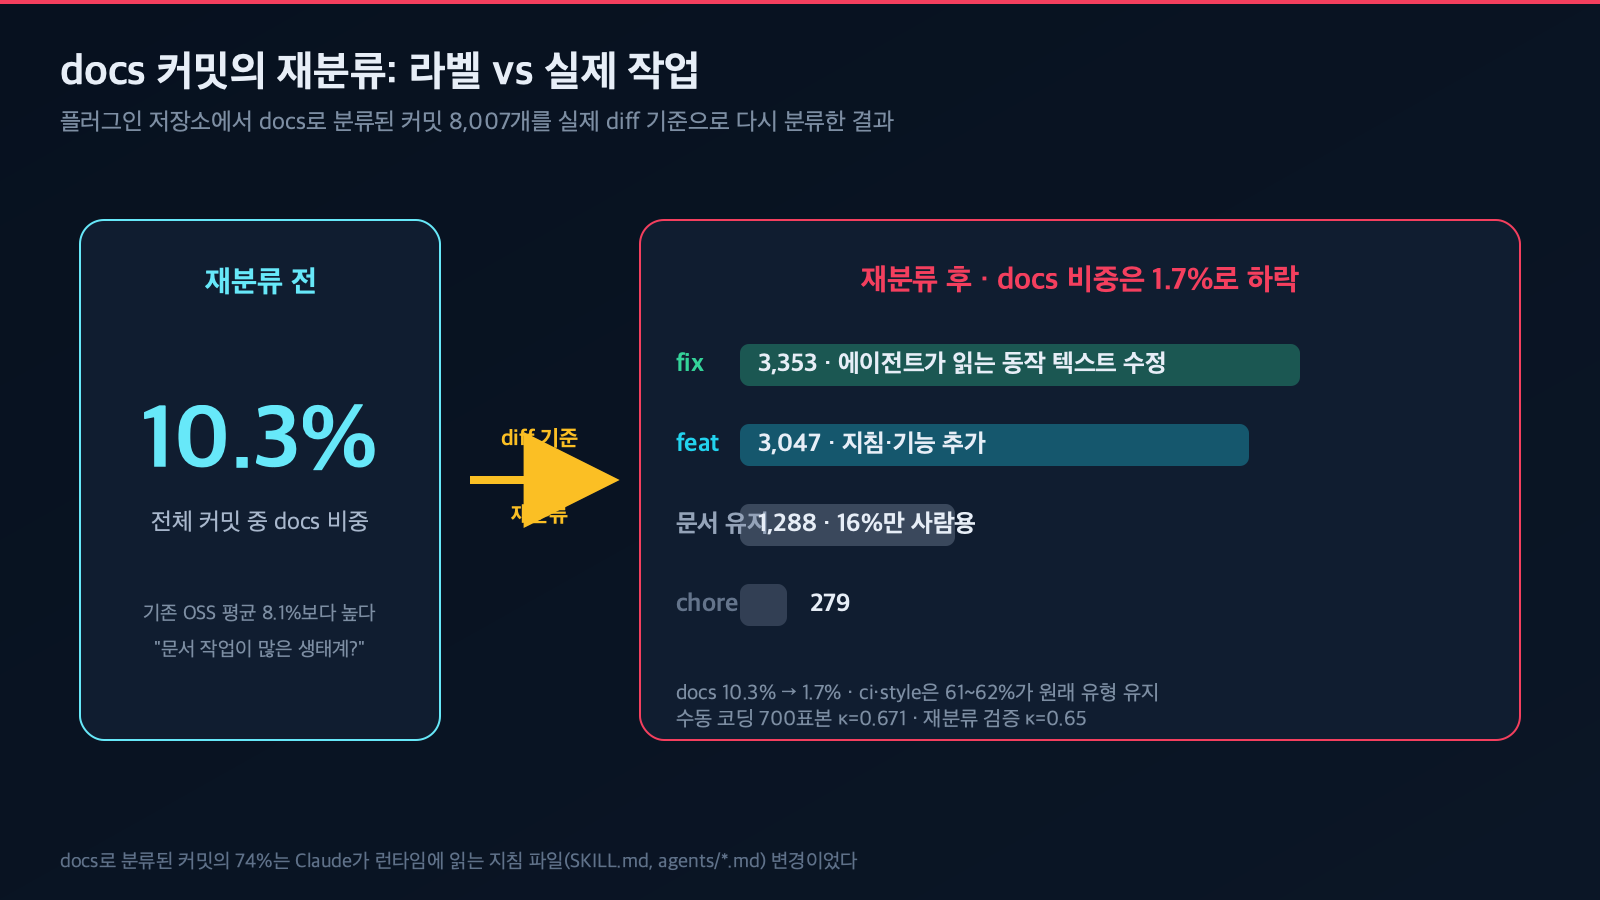
docs로 분류된 커밋의 74%는 런타임 지침 파일 변경이었다. diff 기준 재분류에서 docs 비중은 10.3%에서 1.7%로 떨어진다. 출처: arxiv.org/abs/2608.28497.
전통 소프트웨어와의 비교도 흥미롭다. 기능 추가를 뜻하는 feat이 전체의 39.6%로, 기존 오픈소스 연구의 17.2%보다 두 배 이상 높다. Markdown 기반 플러그인은 기능 하나를 추가하는 데 코드가 아니라 지침을 쓰면 되기 때문이다. fix(25.8%), chore(21.0%)와 합치면 전체의 86.5%다. chore 비중이 크다는 점은 초기 업로드 후 버려지는 일회성 산출물이 아니라 지속적으로 돌아와 유지보수하는 생태계라는 신호이기도 하다. 실제로 저장소당 플러그인 관련 커밋 중앙값은 13건이고, 커밋 하나뿐인 저장소는 6.0%였다.
한 가지 경계선도 정리돼 있다. feat, fix, style, refactor 네 유형은 전통 저장소에서 구조적으로 다른 변경을 가리키지만, 플러그인 저장소에서는 같은 지침 파일에 같은 텍스트 편집을 할 수 있다. 이 네 유형을 가르는 기준은 diff가 아니라 개발자 의도뿐이라는 분석이 이 어긋남의 본질을 잘 보여준다.
개발자 3명 중 1명꼴로 Claude와 함께 커밋한다
에이전트 기여 탐지는 기존 방법론(Robbes 등의 카탈로그)을 그대로 적용했다. 커밋 메시지의 Co-Authored-By 트레일러, 에이전트 이메일, 작성자 필드 패턴을 스캔하는 방식이다. 결과는 77,773개 커밋 중 35.5%에서 코딩 에이전트 흔적이 발견됐고, 그중 Claude가 34.9%로 사실상 전부였다. Copilot 0.4%, Cursor 0.1% 등 나머지 에이전트를 모두 합쳐도 0.5%에 못 미친다. Claude Code용 플러그인 생태계라는 표본 특성을 감안해야겠지만, 사실상 단일 에이전트 환경이다.
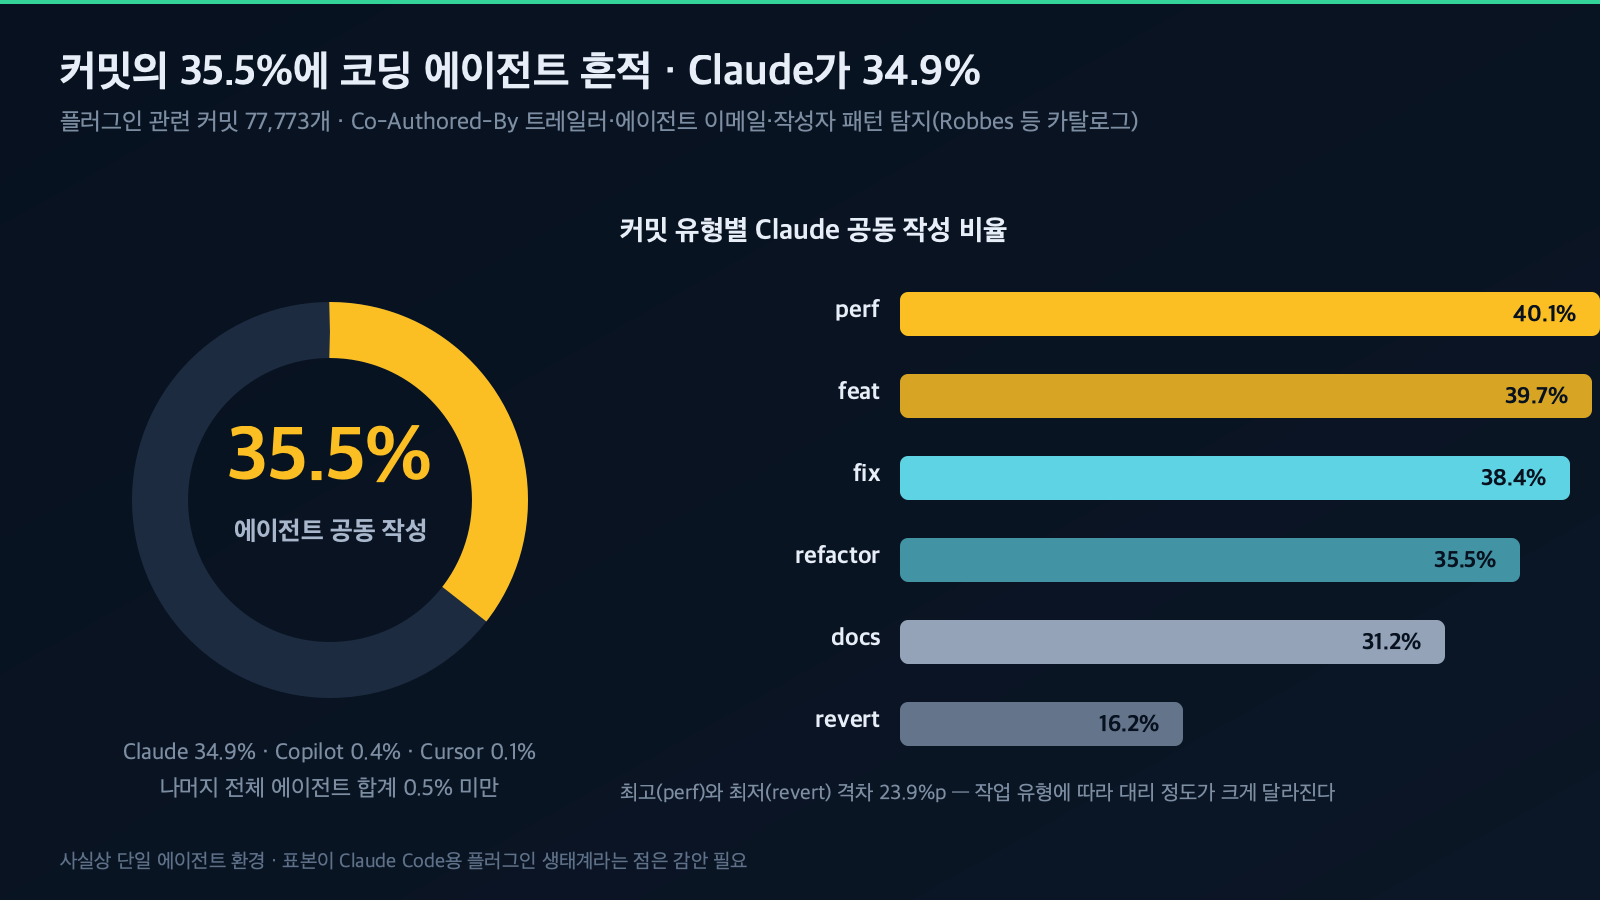
사실상 단일 에이전트 환경이다. 대리 정도는 perf 40.1%에서 revert 16.2%까지 작업 유형에 따라 23.9퍼센트포인트 갈린다. 출처: arxiv.org/abs/2608.28497.
세부 유형별로 보면 대리 패턴이 균일하지 않다. Claude 공동 작성 비율은 perf에서 40.1%로 가장 높았고 feat 39.7%, fix 38.4%가 뒤를 이었다. 반면 revert는 16.2%로 가장 낮았다. 되돌리기 작업은 사람이 직접 하는 경향이 있는 셈이다. 최고와 최저의 격차가 23.9퍼센트포인트에 달해, 어떤 작업을 에이전트에 맡길지가 작업 유형에 따라 달라진다는 점을 수치로 확인할 수 있다.
지침과 스크립트는 따로 놀지 않는다
RQ3의 공진화(co-evolution) 분석이 이 논문의 기술적 핵심이다. 연구진은 병합된 풀 리퀘스트 112,807개를 수집하고, 컴포넌트 유형 간 연관 규칙(Support, Confidence, Lift, 카이제곱 검정)을 적용했다. 분석 대상은 풀 리퀘스트가 10개를 넘는 748개 저장소의 다중 컴포넌트 플러그인, 즉 10,679개 플러그인 풀 리퀘스트다.
컴포넌트 수준에서는 agents와 commands 쌍만 우연을 넘어서는 결합을 보였다(Lift 1.40, p<0.05). 에이전트 정의가 커맨드 슬래시 이름을 출력 텍스트에 포함하고, 커맨드 지침이 특정 에이전트를 참조하는 구조라서 한쪽 이름을 바꾸면 다른 쪽 참조가 깨진다. skills는 다른 모든 컴포넌트와 자주 함께 바뀌었지만(다른 컴포넌트가 바뀐 풀 리퀘스트의 43.2~56.6%에서 skills도 변경) Lift가 0.59~0.78로 1 미만이어서, skills가 워낙 흔해서 같이 바뀌어 보일 뿐이라는 해석이다.
반면 skills 디렉터리 안에서는 상황이 정반대다. 스크립트(.py, .sh, .ts)와 Markdown 파일이 함께 바뀌는 비율이 신뢰도 55~64%에 달하고, Lift가 1.37~1.58로 모든 스크립트–Markdown 쌍에서 우연 수준을 넘었다. skills 안의 13,587개 풀 리퀘스트를 분석한 결과다. 스크립트와 지침 파일이 같이 바뀌는 323개 풀 리퀘스트 중 64개를 사람이 직접 읽고 분류한 결과 78%(50개)에 최소 하나의 기능적 결합이 있었다. 나머지 분류는 gpt-5-mini가 수행했고 사람 라벨과의 일치도는 κ=0.62였다.
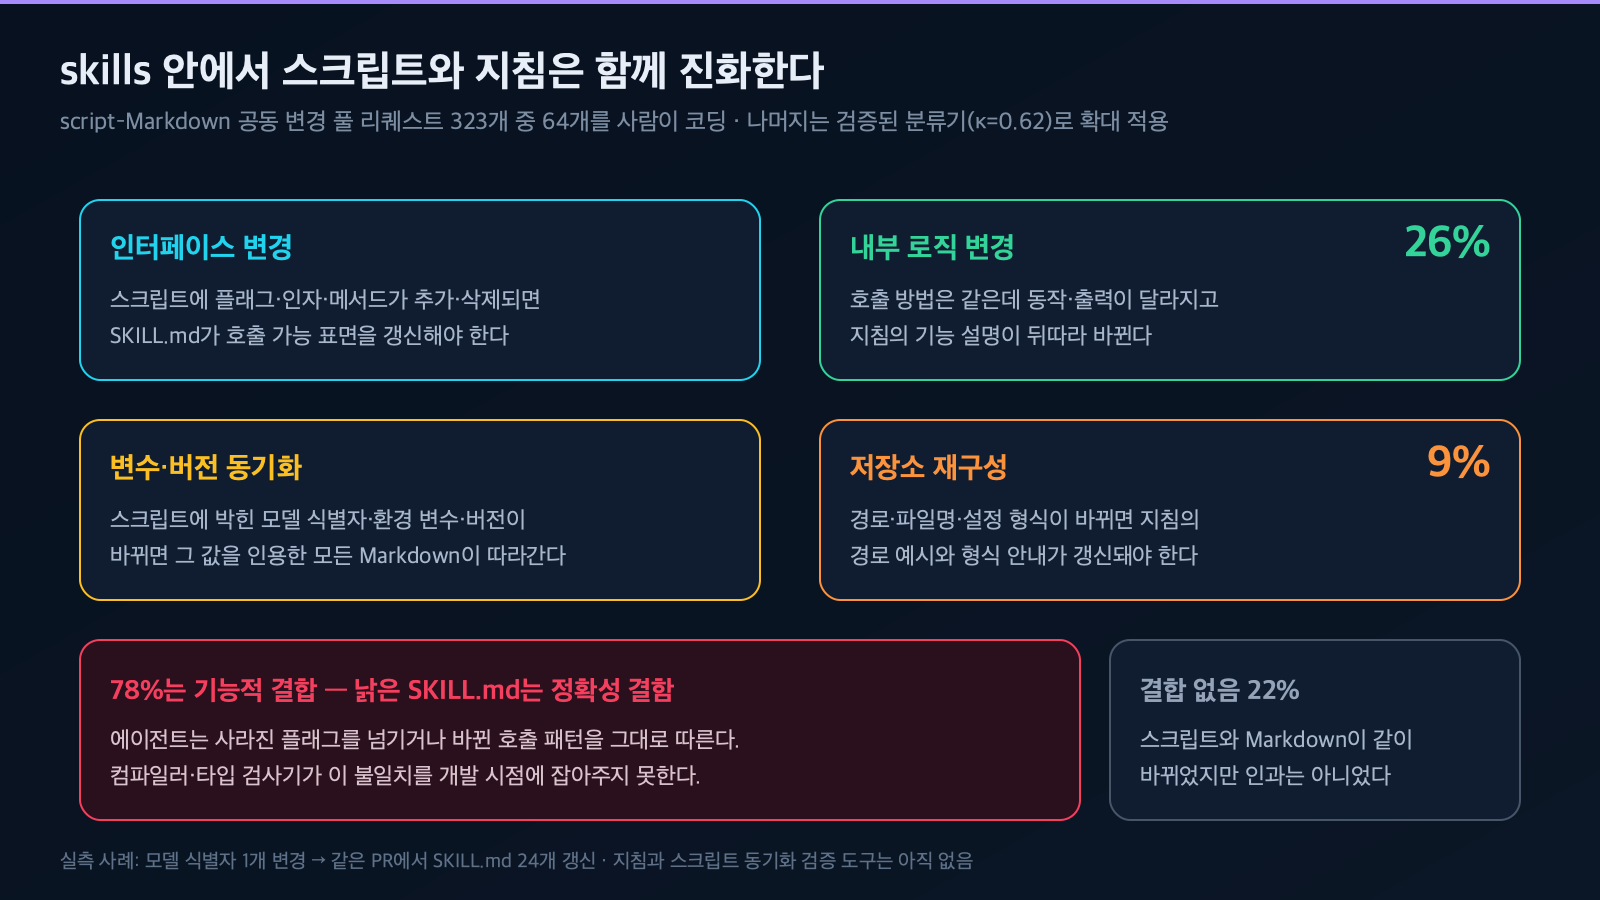
결합 사례 78%는 기능적 의존이었다. 컴파일러가 이 불일치를 잡아주지 않으므로 스크립트 diff와 지침 갱신을 같은 PR에 넣어야 한다. 출처: arxiv.org/abs/2608.28497.
결합은 네 가지 유형으로 정리된다. 인터페이스 변경(34%)은 스크립트에 플래그나 인자가 추가·삭제되면 SKILL.md가 호출 방법을 갱신해야 하는 경우다. 내부 로직 변경(26%)은 호출 방법은 같은데 스크립트의 동작·출력이 달라지고 지침의 설명이 뒤따르는 경우다. 변수·버전 동기화(13%)는 스크립트에 박힌 모델 식별자나 환경 변수가 바뀌면 그 값을 인용한 모든 Markdown이 따라가는 경우다. 실제 사례 중에는 모델 식별자 하나를 바꿨더니 같은 풀 리퀘스트에서 24개의 SKILL.md 파일을 고쳐야 했던 것도 있었다. 저장소 재구성(9%)은 경로나 설정 형식이 바뀌면 지침의 경로 예시를 갱신해야 하는 경우다. 이 네 유형은 스크립트 diff에서 구조적으로 예측 가능하다는 점에서 자동화 후보다.
이 의존성이 특별한 이유는 컴파일러가 없다는 데 있다. 전통적 문서 드리프트는 읽기 불편을 낳지만, SKILL.md가 낡으면 에이전트는 사라진 플래그를 넘기거나 바뀐 호출 패턴을 그대로 따른다. 런타임에서 잘못된 호출이 일어나도 개발 시점에 알려주는 타입 검사기나 정적 분석기가 없다. 논문은 이를 "정확성 결함인데도 이를 잡아줄 장치가 없는" 새로운 유지보수 의존성으로 규정한다. 기존 도구 중에 이 클래스를 다루는 것은 없다.
내 플러그인과 내 저장소에 적용하는 방법
이 논문을 플러그인 개발자 관점에서 읽으면 행동 지침이 몇 가지 나온다. 첫째, skills 안의 스크립트를 고치는 풀 리퀘스트라면 SKILL.md 갱신을 후속 커밋이 아니라 같은 풀 리퀘스트에 포함하라는 것이 저자들의 권고다. 78%가 기능적으로 결합돼 있으므로 뒤늦게 따라오는 지침 갱신은 그 사이의 기간만큼 에이전트를 잘못된 호출로 유도한다. 스크립트 diff를 네 결합 유형과 대조해 보는 체크리스트가 실무에서 바로 쓸 만하다.
둘째, agents와 commands는 이름 참조를 서로 품고 있으므로 어느 한쪽의 이름을 바꾸기 전에 상대 아티팩트의 모든 참조가 여전히 유효한지 확인해야 한다. 이 쌍은 유일하게 우연을 넘는 컴포넌트 간 결합(Lift 1.40)이고, 참조가 깨져도 병합 전에 경고해 주는 도구가 없다.
셋째, 커밋 통계나 기여 분석 도구를 이런 저장소에 그대로 적용하면 왜곡된 그림이 나온다. docs 커밋이 많다고 문서 관리를 잘하는 저장소가 아니고, feat 비중이 높다고 신규 개발만 하는 생태계가 아니다. 연구진도 "기존 오픈소스에서 학습된 커밋 분류기를 AI 네이티브 저장소에 직접 적용하면 오해를 낳는다"고 명시한다. 팀 차원에서 플러그인 활동을 추적한다면 지침 파일 변경을 별도 클래스로 다뤄야 한다.
넷째, 품질 관점에서 자연어 지침이 일급 소프트웨어 산출물이 된 세계에서는 지침과 코드의 동기화를 검증하는 자동화가 다음 과제다. 논문은 스크립트에서 호출 가능 인터페이스를 추출해 Markdown 지침의 매개변수명과 사용 예시가 동기화돼 있는지 검증하는 기법이 실현 가능하면서도 아직 없는 공백이라고 본다. 스크립트 하나의 식별자 변경이 수십 개 지침 파일로 전파되는 사례가 실측됐으므로, 이 공백은 개인 도구 제작자에게도 기회다.
이 논문을 읽을 때 유의할 제약도 있다. GitHub Code Search API 기반 수집이라 비공개·삭제된 저장소는 빠져 있고, 별 10개 이상 필터를 쓰지만 5개·25개 기준 재실행에서도 질적 결론은 유지됐다. 데이터 수집이 2026년 4월 2일 시점의 스냅샷이고 저장소 중앙값 나이가 80일에 불과해, 성장률 같은 추세는 이후 시기에 일반화된다는 보장이 없다. 결론도 Claude Code 마켓플레이스에 한정된 것이며 다른 에이전트 플랫폼(Cursor, Copilot, Gemini 등)에서 같은 패턴이 재현되는지는 검증되지 않았다. 분류 파이프라인의 상당 부분(LLM 분류, 자동 탐지 휴리스틱)을 사람 표본 검증로 감싸긴 했지만, κ 값이 완벽하지 않은 만큼 재분류 수치에는 불확실성이 남는다.
참고 자료
- https://arxiv.org/abs/2608.28497
- https://arxiv.org/html/2608.28497v1
- https://arxiv.org/pdf/2608.28497v1
- https://github.com/SAILResearch/agentic_plugin_marketplace


댓글
댓글 쓰기