코딩 에이전트 검색, LSP가 항상 grep보다 낫지 않은 이유
코딩 에이전트에 Language Server Protocol(LSP)을 연결하면 코드의 의미를 이해하니 검색도 더 정확하고 토큰도 절약될 것처럼 보인다. 정의와 참조를 구분하지 못하는 grep보다 IDE가 쓰는 언어 서버가 더 똑똑한 도구인 것은 사실이다. 그러나 더 정교한 도구가 모든 작업에서 더 효율적인 것은 아니다.
2026년 공개된 프리프린트 Does a Language Server Save Tokens for Coding Agents?는 이 통념을 “성공한 작업 하나에 몇 토큰이 들었는가”라는 지표로 시험했다. 결론은 단순한 LSP 승리가 아니었다. 파일 위치를 찾는 작업, 모든 호출 지점을 찾는 작업, 여러 파일을 고치는 작업에서 유리한 검색 방식이 달랐다.
이 연구를 실무에 적용할 때 중요한 질문은 “LSP를 쓸까 말까”가 아니다. 지금 작업의 실패 조건이 누락인지, 오탐인지, 문맥 낭비인지 먼저 구분하고 검색 도구를 라우팅하는 것이다.
토큰 절감은 성공률과 함께 봐야 한다
검색 결과가 짧으면 토큰은 줄어든다. 하지만 필요한 파일을 놓쳐 실패했다면 효율이 좋아진 것이 아니다. 연구는 성공한 실행의 입력·도구 결과·생성 토큰을 합친 tokens-to-success를 주 지표로 삼고, 성공률과 함께 비교했다.
실험의 기본 구조도 이를 분리하도록 설계됐다.
- A:
grep만 제공 - B: LSP만 제공
- C: 둘 다 제공하고 에이전트가 선택
- D: 두 도구를 제공하되 의미 검색을 먼저 쓰도록 강제
모델, 작업, 프롬프트, 에이전트 루프를 유지한 채 검색 도구 표면만 바꿨다. 다만 이 결과는 requests, remeda, hono 등 소수의 비교적 작은 저장소와 Claude 계열 모델을 사용한 예비 연구다. 방향을 참고할 수는 있어도 모든 언어와 대규모 모노레포에 같은 효과 크기가 재현된다고 단정할 수는 없다.
파일 위치 찾기에서는 grep이 더 쌌다
이슈 설명에 수정할 심볼 이름이 드러난 파일 위치 찾기 작업에서 Opus 4.8은 두 방식 모두 100% 성공했다. 평균 성공 토큰은 grep 920, LSP 971로 LSP가 약 6% 더 들었다. Sonnet 4.6에서는 LSP의 토큰 비용이 grep보다 118% 높았고, Haiku 4.5만 LSP를 썼을 때 26% 절감했다.
강한 모델은 grep 결과의 잡음을 비교적 적은 문맥으로 걸러냈지만, 약한 모델은 그 과정에서 더 오래 헤맸다. 의미 검색은 모델 성능과 관계없이 항상 절약을 만드는 기능이 아니라, 어휘 검색의 잡음을 처리하기 어려운 모델에는 보조 장치가 될 수 있다는 해석이 가능하다.
둘 다 제공했을 때의 행동도 흥미롭다. 파일 위치 찾기에서 의미 도구 사용률은 모델별로 0~6%였다. 에이전트는 LSP를 사용할 수 있어도 대부분 grep을 골랐다. 도구를 설치했다고 자동으로 그 도구를 잘 쓰게 되는 것은 아니다.
모든 참조를 찾을 때는 정확도에 값을 지불했다
“이 함수의 모든 호출 지점을 찾아라”처럼 참조 완전성이 중요한 작업에서는 결과가 달라졌다. Opus 4.8 기준으로 LSP의 평균 F1은 0.778, grep은 0.706이었다. LSP의 정밀도는 1.00으로, 잘못된 호출 지점을 보고하지 않았다. grep의 정밀도는 0.76이었다.
하지만 LSP의 평균 토큰은 1,347로 grep의 1,136보다 약 19% 많았다. 정확도 향상은 있었지만 토큰 절감은 아니었다. 가장 큰 이유는 인터페이스였다. 위치만 돌려주는 find_references는 path:line을 확인하기 위해 파일을 다시 열게 만들었다. 반면 grep은 일치한 줄의 내용을 바로 보여줘 추가 읽기를 줄였다.
이 차이는 LSP의 의미 정보가 나쁘다는 뜻이 아니다. 정확한 결과를 어떤 형태로 돌려주느냐도 토큰 비용의 일부라는 뜻이다. 에이전트용 LSP 도구를 설계한다면 참조 위치만 전달하지 말고, 짧은 주변 문맥과 심볼 종류를 함께 반환하는 편이 낫다.
참조 작업에서 의미 도구 사용률은 45~57%로 올라갔다. 같은 모델이 파일 위치 찾기에서는 거의 쓰지 않던 LSP를 “모든 참조” 과제에서는 절반가량 선택했다. grep 선호가 고정 습관이라기보다 과업에 따라 달라지는 정책이라는 근거다.
언어보다 중요한 것은 이름의 충돌 정도였다
LSP가 유리한지를 Python인지 TypeScript인지로만 나누기도 어렵다. 연구에서 TypeScript 저장소 remeda는 심볼 이름이 비교적 고유해 grep 정밀도가 1.00이었고 LSP의 F1 이득이 없었다. 반면 hono의 html, stream, parseAccept처럼 주석·문자열·비슷한 이름과 충돌하기 쉬운 대상에서는 LSP의 이득이 커졌다.
hono 전체 비교에서는 LSP가 F1을 0.245 높였고 토큰도 12% 줄였다. 언어나 타입 시스템 자체보다 검색어가 저장소 안에서 얼마나 많은 어휘적 오탐을 만드는가가 더 직접적인 라우팅 신호였다는 것이 연구의 실용적인 발견이다.
따라서 검색 전에 저렴한 grep을 한 번 실행해 결과 수와 잡음 정도를 보는 방법이 유용하다. 결과가 짧고 구별이 쉬우면 그대로 진행하고, 같은 이름이 주석·문자열·다른 심볼에 넓게 퍼져 있으면 LSP로 좁히는 방식이다.
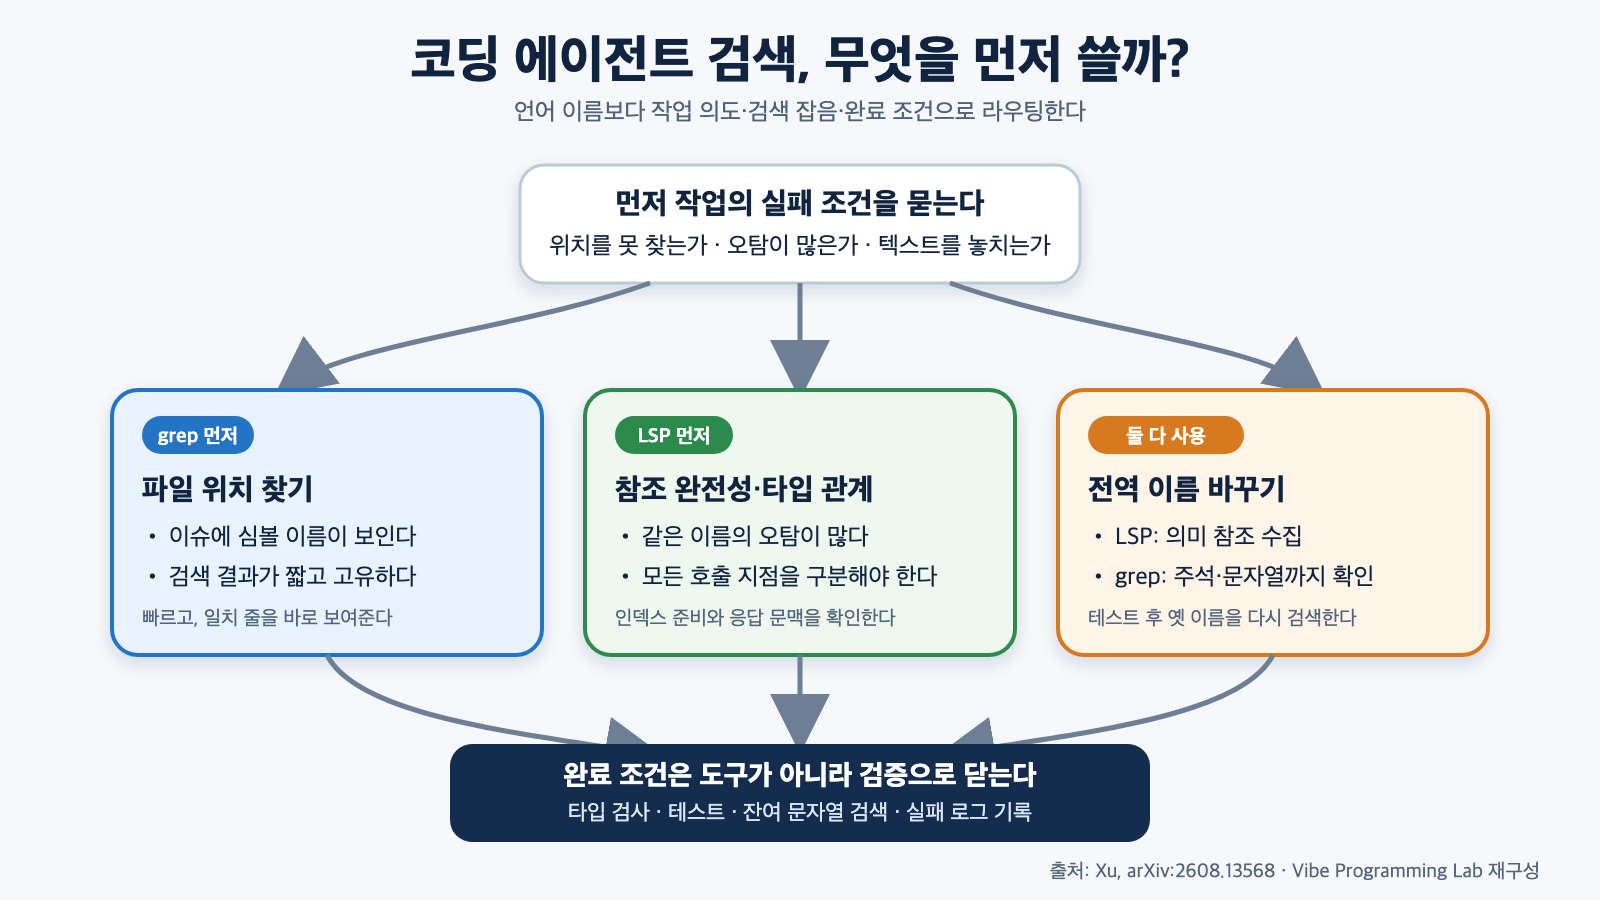
논문 결과를 바탕으로 정리한 검색 라우팅 규칙. 파일 위치 찾기는 grep, 참조 완전성은 LSP, 전역 이름 바꾸기는 두 도구를 함께 사용한다. 출처: arxiv.org/abs/2608.13568.
이름 바꾸기에는 두 검색을 겹쳐야 한다
여러 파일에 걸친 이름 바꾸기 실험은 의미 검색의 구조적 한계를 보여준다. grep만 쓴 실행은 pass@1 1.00이었지만, 위치만 반환하는 LSP는 0.67이었다. 참조 줄을 함께 반환하도록 개선한 LSP는 0.83까지 올랐고 후속 파일 읽기도 크게 줄었다.
그래도 grep을 따라잡지 못한 직접적인 실패 사례는 주석에 남은 옛 이름이었다. 언어 서버의 “참조”는 프로그램 의미상 연결된 코드 위치를 찾는다. 같은 구조적 한계는 문자열에도 적용된다. 이름 바꾸기의 완료 조건에는 문서 문자열, 설정 키, 테스트 픽스처, 주석처럼 의미 참조가 아닌 텍스트도 포함될 수 있다. 이 영역은 LSP가 일부러 제외하는 곳이다.
또 하나의 주의점은 인덱스 준비 상태다. 연구에서는 완전히 준비되지 않은 언어 서버가 정의 하나만 반환하고 교차 파일 참조를 놓치는 사례가 관찰됐다. 백엔드가 참조를 완전하게 해석하는지, 인덱스가 워밍됐는지 확인하지 않으면 정밀해 보이는 빈 결과를 믿게 된다.
실무에서는 이름 바꾸기를 다음 순서로 처리하는 편이 안전하다.
- LSP로 코드 심볼의 정의와 의미 참조를 수집한다.
grep또는ripgrep으로 동일 문자열의 전체 출현을 찾는다.- 주석·문자열·설정·테스트 데이터를 별도로 분류한다.
- 변경 후 타입 검사와 테스트를 실행한다.
- 마지막으로 옛 이름이 남았는지 다시 어휘 검색한다.
에이전트 검색 도구를 라우팅하는 간단한 규칙
파일 위치나 고유한 심볼을 찾을 때
grep을 먼저 쓴다. 이슈에 심볼 이름이 있고 검색 결과가 짧다면 LSP 호출과 인덱스 비용이 추가 이득을 만들지 못할 수 있다.
모든 호출 지점이나 타입 관계가 필요할 때
LSP를 먼저 고려한다. 특히 같은 이름의 오탐이 많을 때 정밀도 이득이 크다. 단, 반환값에 주변 코드가 포함되는지와 인덱스 준비 상태를 확인한다.
이름 바꾸기와 저장소 전역 수정일 때
둘을 함께 쓴다. LSP는 의미 참조를, grep은 주석·문자열·설정 등 어휘 출현을 책임지게 한다. 어느 한쪽의 결과만 완료 조건으로 삼지 않는다.
자동 라우터를 만든다면
도구 선택을 언어 이름에 고정하지 않는다. 작업 의도, grep 결과의 오탐 비율, 인덱스 준비 여부, LSP 응답에 포함된 문맥, 사용 모델이 잡음을 처리하는 비용을 입력으로 삼는다. 그리고 토큰만 보지 말고 성공률, F1, 누락된 참조, 후속 파일 읽기 횟수를 함께 기록한다.
결론
LSP는 grep의 상위 호환이 아니다. 둘은 서로 다른 실패를 줄이는 도구다. grep은 빠르고 전체 텍스트를 놓치지 않지만 잡음이 많고, LSP는 의미 참조를 정밀하게 찾지만 주석과 문자열을 보지 않으며 인덱스와 응답 형식에 민감하다.
코딩 에이전트에 더 많은 도구를 붙이는 것보다 중요한 것은 작업별 선택 기준을 만드는 일이다. 위치 찾기에는 어휘 검색, 참조 완전성에는 의미 검색, 저장소 전역 이름 바꾸기에는 두 검색의 교차 검증이라는 기본 규칙부터 시작할 수 있다. 이후 실제 저장소의 실패 로그를 모아 라우팅 조건을 조정해야 한다.


댓글
댓글 쓰기