에이전트 스킬을 바로 고치지 말아야 하는 이유: WikiSkill의 3계층 기억 설계
에이전트가 일을 잘못했을 때 가장 빠른 처방은 스킬 문서에 새 규칙을 한 줄 더 쓰는 것이다. 당장은 나아질 수 있다. 문제는 다음 반복에서 비슷한 실패가 나타났을 때다. 왜 그 규칙을 넣었는지, 전에 시도했다가 버린 수정은 무엇인지, 어느 작업에서는 통했지만 다른 작업에서는 깨졌는지가 스킬 하나에 뒤섞인다. 스킬은 점점 길어지고, 실패에서 얻은 근거는 흩어진다.
Google Research와 Virginia Tech 연구진이 8월 27일 공개한 WikiSkill은 이 문제를 "기억을 어디에 둘 것인가"라는 설계 문제로 다룬다. 실행 기록, 누적 지식, 실제 실행 지침을 각각 raw/, wiki/, skills/로 분리하고, 검증 점수가 오른 스킬 수정만 채택한다. 핵심은 스킬을 자동으로 많이 만드는 데 있지 않다. 실패 원인과 수정 이력을 스킬 바깥에 계속 보존해 다음 제안이 이전 시행착오를 다시 밟지 않게 하는 데 있다.
논문 수치는 흥미롭지만 그대로 제품 성능으로 읽으면 곤란하다. 연구진은 다섯 벤치마크와 다섯 모델에서 실험했고, 스킬 전체를 프롬프트에 직접 넣었다. 실제 운영에서 중요한 스킬 검색, 트리거 정확도, 장시간 작업은 평가하지 않았다. 공개 논문 v1에는 구현 저장소도 연결돼 있지 않아 아래 내용은 논문 표와 본문을 대조한 분석이며 독립 재현 결과가 아니다.
세 종류의 기억을 한 파일에 넣지 않는다
WikiSkill의 작업 공간은 역할이 다른 세 계층으로 나뉜다.
raw/는 실행 궤적을 원본 그대로 보관한다. 관찰, 도구 호출, 도구 출력, 최종 답을 포함하며 한번 기록한 뒤에는 바꾸지 않는다. 나중에 원인 분석이 틀렸다는 사실이 드러나도 원본 증거를 다시 볼 수 있어야 하기 때문이다.
wiki/는 원본을 읽고 정리한 지식층이다. 반복해서 나타난 실패 유형과 성공 전략을 개별 패턴 문서로 만들고, 제안한 스킬 수정의 diff, 검증 점수, 채택·거부 결과를 기록한다. 거부된 제안도 지우지 않는다. 같은 아이디어를 표현만 바꿔 다시 제안하는 일을 막는 장치다.
skills/에는 실행 에이전트가 실제로 따라야 할 절차만 남는다. 각 스킬에는 지침인 SKILL.md와 어떤 위키 패턴이 이 수정을 요구했는지 연결하는 PURPOSE.md가 있다. 증거와 이력은 위키에, 짧고 실행 가능한 규칙은 스킬에 둔다.
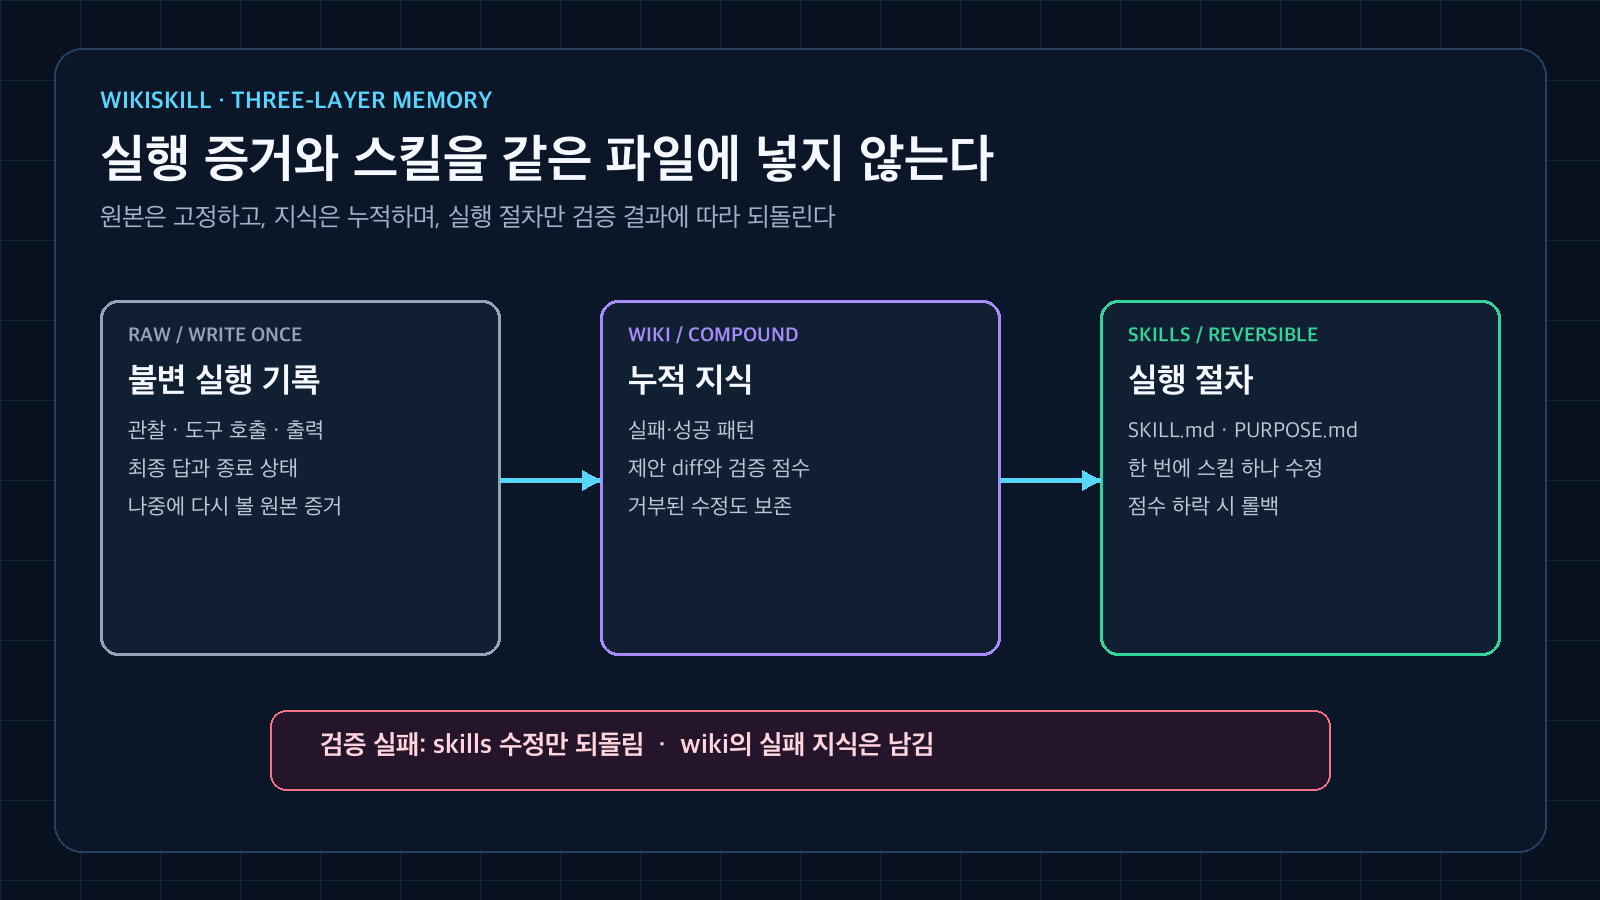
WikiSkill은 원본 실행 기록, 누적 패턴과 수정 이력, 실제 실행 스킬을 분리한다. 스킬 수정은 되돌려도 위키의 실패 지식은 보존한다. 출처: arxiv.org/abs/2608.27454.
작동 방식은 생성보다 검증에 가깝다
한 번의 진화 반복은 네 단계다. 먼저 추론 에이전트가 현재 스킬만 읽고 훈련 과제를 수행한다. 다음으로 Wiki Maintainer가 성공·실패 궤적 일부를 읽어 원인을 분석하고 기존 패턴에 근거를 더하거나 새 패턴을 만든다. Skill Proposer는 위키 색인, 과거 수정의 영향 기록, 최신 궤적을 보고 한 번에 스킬 하나만 고친다.
마지막 단계가 중요하다. 후보 스킬을 별도 검증 세트에서 평가해 기존 최고 점수보다 높을 때만 채택한다. 낮거나 같은 점수면 스킬 수정은 되돌린다. 그러나 그 수정안과 검증 결과는 위키에 남는다. 실행 지침은 되돌릴 수 있지만, 무엇이 실패했는지에 대한 지식은 되돌리지 않는 비대칭 구조다.
논문의 ALFWorld 사례가 이 차이를 잘 보여준다. 첫 반복에서 제안한 추상적인 목표 지향 스킬은 검증 점수를 높이지 못해 거부됐다. 위키는 그 거부와 반복 행동 패턴을 보존했다. 다음 제안은 "물건을 원래 위치로 돌려놓지 말라"는 구체 규칙으로 바뀌어 채택됐고, 이후 새 반복 오류가 쌓이자 "물건마다 같은 조작은 한 번만"이라는 규칙이 추가됐다.
평균 점수보다 봐야 할 두 가지 결과
Table 1에서 WikiSkill은 다섯 모델 모두 가장 높은 5개 벤치마크 평균을 기록했다. Qwen 계열만 보면 무스킬 대비 평균 점수 상승 폭은 4B에서 12.3%포인트, 9B에서 17.5%포인트, 27B에서 23.9%포인트였다. 9B 모델에 WikiSkill을 적용한 평균은 47.4%로, 스킬 없는 27B 모델의 39.4%보다 높았다.
그렇다고 "스킬만 있으면 작은 모델이 큰 모델을 이긴다"고 일반화할 수는 없다. 같은 표에서 Qwen 4B의 OfficeQA는 30.2%에서 28.5%로 낮아졌다. 긴 문서를 탐색하는 복잡한 절차를 작은 모델이 제대로 실행하지 못하고 기본 읽기 행동으로 돌아갔다는 것이 연구진의 분석이다. 좋은 절차를 발견하는 능력과 그 절차를 끝까지 수행하는 능력은 별개다.
모델 간 전이도 같은 경고를 준다. Qwen 27B가 만든 스프레드시트 스킬은 Qwen 9B를 24.3%에서 50.5%로 끌어올렸다. 반면 Qwen 4B가 만든 스킬을 Gemini 3.5 Flash에 적용하자 50.5%에서 18.1%로 떨어졌다. 작은 모델의 실행 실패를 피하려고 만든 한 줄 명령과 잘게 쪼갠 진단 절차가 더 강한 모델에는 행동을 제한하고 도구 호출 예산을 낭비했다.
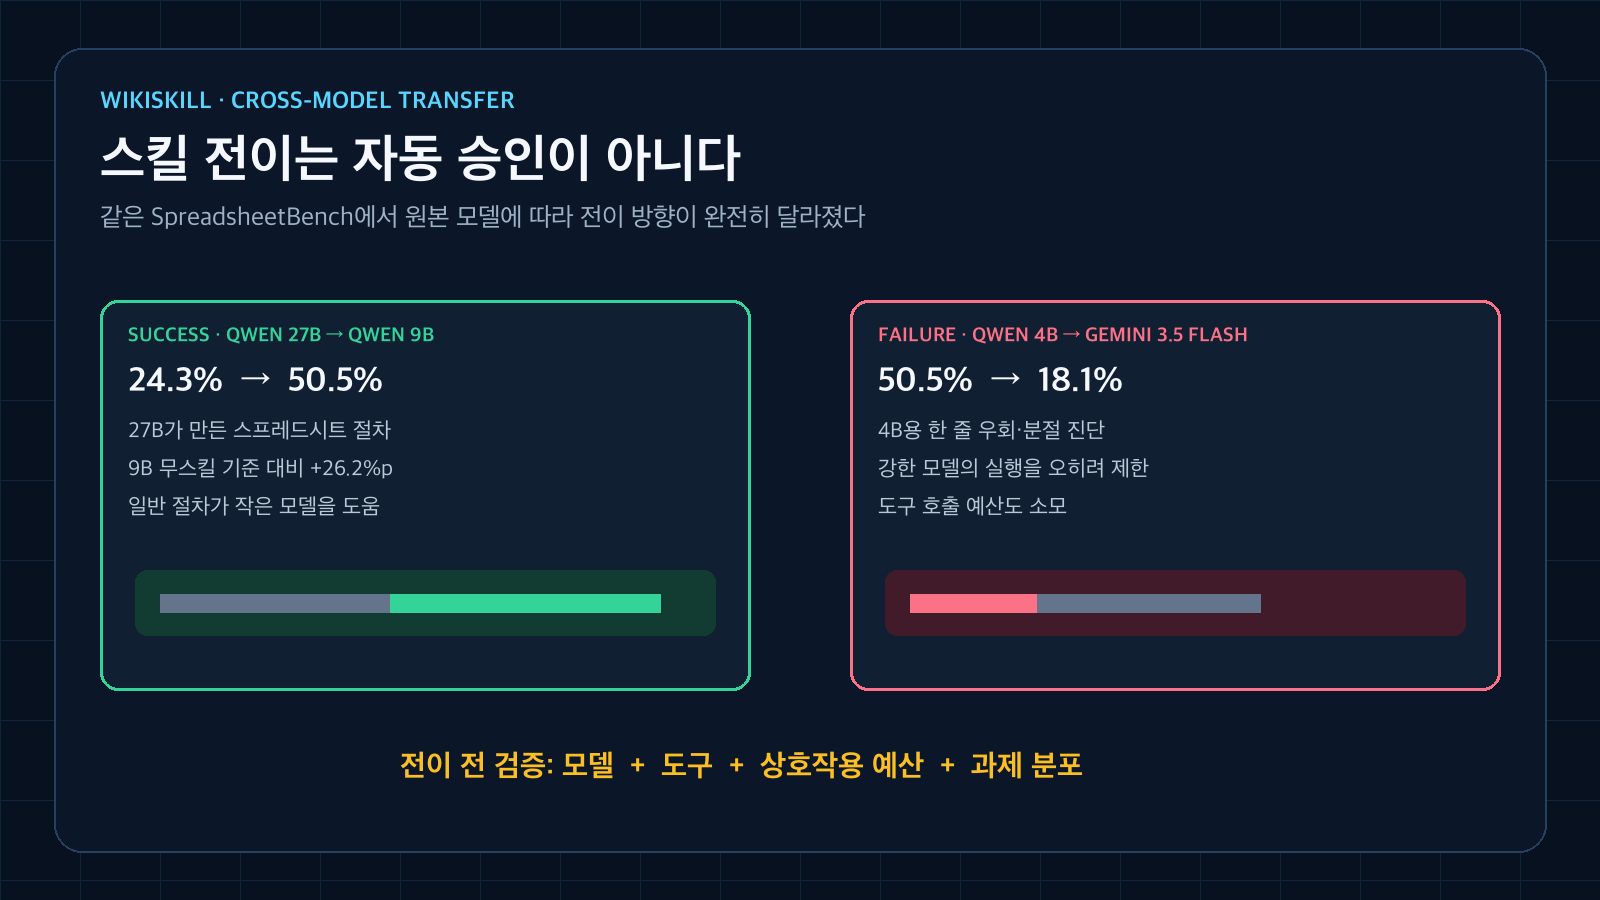
스킬 전이는 자동 승인이 아니다. 강한 원본 모델의 절차는 작은 모델을 도왔지만, 작은 모델용 우회 규칙은 더 강한 모델의 성능을 크게 낮춘 사례가 있었다. 출처: arxiv.org/abs/2608.27454.
위키는 실행 에이전트에게 보여주지 않았다
Table 3의 제거 실험은 단순한 "메모리가 많을수록 좋다"는 해석을 막는다. Skill Proposer에게 위키를 제공하되 실행 에이전트에는 제공하지 않은 기본 설정의 네 벤치마크 평균은 63.7%였다. 제안자에게도 위키를 주지 않으면 48.7%로 낮아졌다. 누적 지식이 다음 스킬 수정에 쓰였다는 근거다.
하지만 실행 에이전트까지 위키를 읽게 하자 평균은 60.9%로 내려갔다. 연구진은 실행 에이전트가 스킬 대신 위키의 해결 지식을 이용하면, 새 궤적이 스킬 자체의 부족함을 드러내지 못하기 때문이라고 본다. 쉽게 말해 시험 중에 해설지를 보여주면 답은 맞힐 수 있어도 교재의 결함은 찾기 어려워진다.
운영 시스템에서도 이 경계를 지킬 필요가 있다. 위키에는 실패한 명령, 민감한 도구 출력, 과거 권한 상태가 들어갈 수 있다. 실행 시점에 전부 주입하면 컨텍스트 비용뿐 아니라 오래된 지침과 프롬프트 인젝션 흔적까지 다시 활성화할 수 있다. 원본과 분석층은 개선 담당자만 읽고, 실행 에이전트에는 검증을 통과한 최소 절차만 전달하는 편이 안전하다.
논문이 아직 답하지 않은 것
첫째, 실험은 활성 스킬 전체를 프롬프트에 직접 넣어 스킬 검색 실패를 제거했다. 스킬이 수백 개로 늘어났을 때 어떤 스킬을 불러올지, 잘못된 트리거가 어떤 비용을 만드는지는 별도 문제다.
둘째, 후보 수정은 검증 점수가 즉시 올라야 채택된다. 지금 점수는 같지만 다음 개선의 기반이 되는 구조 변경은 거부될 수 있다. 반대로 작은 검증 세트에 맞춘 규칙이 우연히 통과할 가능성도 있으므로 반복 평가와 보류 구간이 필요하다.
셋째, 위키는 계속 누적되지만 자동 정리 장치가 없다. 오래된 환경에서만 맞았던 패턴, 서로 충돌하는 규칙, 중복 근거가 쌓이면 제안자도 잘못된 문맥을 읽는다. 보존과 활성 지식은 구분해야 한다.
넷째, 수백 단계 또는 여러 시간에 걸친 작업은 평가하지 않았다. 짧은 벤치마크에서 유효한 패턴 정리가 장기 작업의 상태 변화와 권한 만료까지 견딘다는 증거는 아직 없다.
실전에서는 작은 변경 관리 시스템으로 시작한다
처음부터 자동 진화 루프를 만들 필요는 없다. 현재 에이전트 로그를 세 영역으로 나누는 것부터 시작할 수 있다.
- 원본 실행 로그에는 실행 ID, 입력, 도구 호출, 출력 해시, 종료 상태를 변경 불가 형태로 남긴다.
- 패턴 문서에는 증거가 된 실행 ID, 관찰된 실패, 적용 범위, 반례, 제안할 완화를 적는다.
- 스킬 변경에는 패턴 ID, diff, 검증 세트, 이전·이후 점수, 승인자를 연결한다.
- 검증 점수가 나빠진 수정은 즉시 되돌리되 실패 기록은 삭제하지 않는다.
- 다른 모델이나 새 버전에 스킬을 옮길 때는 자체 검증을 다시 수행한다. 원본 모델에서 통과했다는 사실은 전이 승인이 아니다.
여기에 두 가지 운영 규칙을 더하면 좋다. 위키 문서는 실행 에이전트의 기본 컨텍스트에서 제외하고, 스킬은 길이보다 검증된 행동 단위로 제한한다. 또 정기적으로 패턴의 유효 기간과 환경 버전을 확인해 "보존은 하지만 현재 제안에는 쓰지 않는" 보관 상태를 둔다.
결론
WikiSkill에서 가져올 만한 부분은 자동 작성기가 아니라 변경 이력의 구조다. 실행 증거는 고정하고, 증거에서 뽑은 패턴은 누적하며, 실제 지침은 검증 결과에 따라 되돌릴 수 있게 만든다. 스킬과 기억을 같은 파일로 취급하지 않는 것이다.
논문 실험에서는 이 분리가 여러 모델과 과제에서 평균 성능을 높였고, 작은 모델이 더 큰 무스킬 모델을 넘는 사례도 만들었다. 동시에 모델 간 전이가 50.5%에서 18.1%로 무너진 사례와 작은 모델의 OfficeQA 하락도 있었다. 그러므로 스킬은 재사용 가능한 텍스트가 아니라 모델·도구·예산과 함께 검증해야 하는 실행 변경으로 봐야 한다.
참고 자료
- Tang et al., WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution (2026-08-27, v1)
- arXiv, WikiSkill HTML 본문


댓글
댓글 쓰기