평균 0.93번의 불필요한 호출: 에이전트가 도구를 안 쓰는 법을 못 배운 이유
계산기를 쓸 수 있다고 모든 문제에서 계산기를 켜야 하는 것은 아니다. 그런데 도구를 연결한 언어 모델은 이미 풀 수 있는 문제에서도 호출 버튼부터 누르는 경향을 보였다. 도구가 필요 없는 GSM8K 문제에서 모델들은 질의당 평균 0.93회 도구를 불렀다. 일부 집단은 도구를 열어 준 뒤 정확도까지 떨어졌다.
사전 공개 논문 「The Tool-Overuse Illusion」은 이 현상을 단순한 비용 낭비가 아니라, 도구가 필요한 때와 필요하지 않은 때를 구분하지 못하는 문제로 다룬다. 연구진은 수학 문제와 격리된 Python 실행기를 사용해 모델의 내부 지식, 호출 행동, 학습 보상을 나눠 살폈다. 이 글은 저자 수치를 그대로 재현했다고 주장하지 않는다. 실험 설계와 표를 읽고, 에이전트 운영에서 무엇을 따로 측정해야 하는지 정리한다.
쉬운 문제는 모델마다 달랐다
연구진은 먼저 도구 없이 각 문제를 여덟 번 풀게 했다. 정답률인 avg@8이 0.5 이상이면 그 모델의 simple, 0.5 미만이면 complex로 분류했다. 같은 문제라도 모델에 따라 난이도 구간이 달라진다. 여기서 “쉬운 문제”는 사람에게 쉬운 문제나 고정된 공통 집합이 아니다.
그다음 Python 실행기를 제공하고, 모델이 스스로 호출 여부를 정하게 했다. GSM8K의 simple 구간에서 범주 평균 정확도는 frontier 모델 93.20%에서 86.40%, RLVR 학습 모델 93.21%에서 89.92%, 오픈소스 기반 모델 95.75%에서 81.27%로 바뀌었다. 각각 6.80%p, 3.29%p, 14.48%p 하락이다. 다만 모든 개별 모델이 나빠진 것은 아니다. Claude-4.5와 SimpleTIR-7B처럼 해당 표에서 상승한 예도 있다.
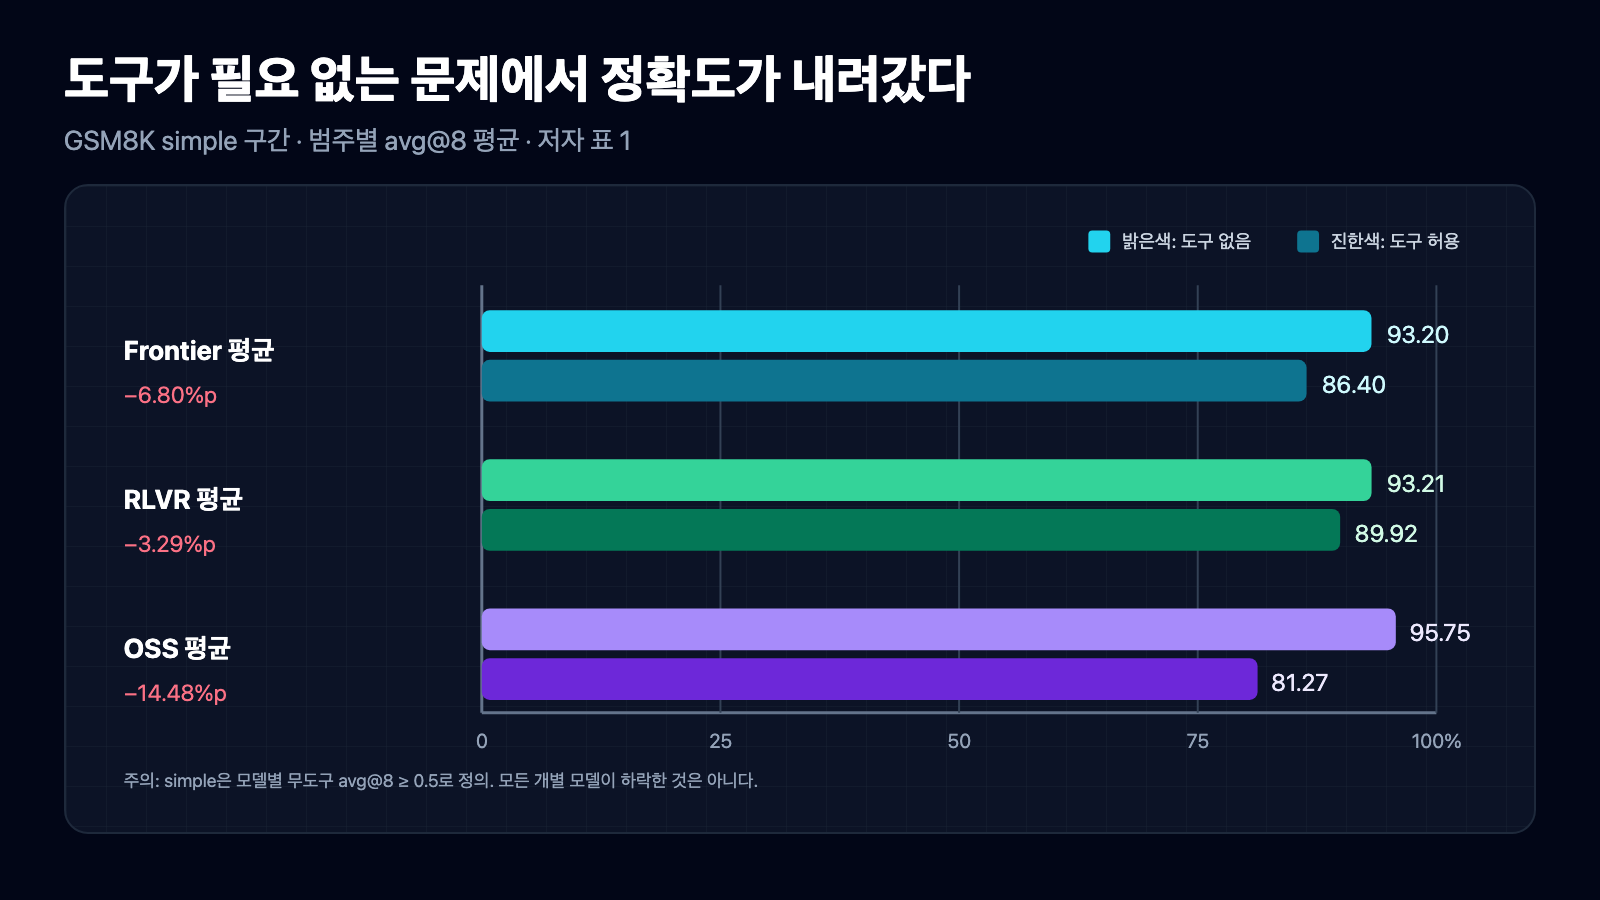
그림 1. 모델별 무도구 avg@8이 0.5 이상인 GSM8K 항목의 범주 평균. 모든 개별 모델이 하락한 것은 아니다. 출처: arxiv.org/html/2604.19749v1.
이 수치로 “도구를 쓰면 정확도가 떨어진다”고 결론 내리면 너무 멀리 간다. 같은 표의 complex 구간에서는 많은 모델이 큰 이득을 봤다. Gemini-3의 범주 내 수치는 11.91%에서 62.86%로 올랐다. 문제는 도구 자체가 아니라, 호출의 필요성을 가려내지 못한 채 늘 사용할 수 있게 만든 설정이다.
도구 선택과 도구 절제는 다른 능력이다
논문은 과사용을 두 종류로 나눈다. 하나는 내부 지식으로 풀 수 있는데도 호출하는 중복 사용이다. 다른 하나는 주어진 도구가 질문과 무관한데도 호출하는 무관 사용이다. 후자는 BFCL 방식의 조건으로 측정했다. 모든 도구가 무관할 때 frontier 모델의 평균 정답률은 80.2%, 오픈소스 모델은 62.5%였다. 저자 해석대로 뒤집으면 각각 19.8%, 37.5%의 오류가 남는다.
도구 목록에서 알맞은 함수를 고르는 것과, 아무 함수도 고르지 않는 것은 별개의 시험이다. 실제 제품에서도 이 구분이 꽤 중요하다. 웹 검색 결과를 한 번 더 읽는 일과 결제·삭제·배포 API를 한 번 더 호출하는 일은 비용도 복구 난이도도 다르다. 단순 호출 횟수만 세면 이 차이가 사라진다.
모델은 자기 지식의 경계를 잘 모른다
연구진은 내부 지식 가용성의 대리 지표로 도구 없는 avg@1024를 사용했다. 문제마다 1,024개의 확률적 답변을 생성해 정답 비율을 계산하고, 별도로 도구 사용 조건을 여덟 번 실행했다. Qwen3-8B은 avg@1024가 0.9보다 큰 구간에서도 질의당 평균 2.2회 도구를 호출했다. 반대로 지식 가용성이 매우 낮은 구간에서 호출을 하지 않는 모습도 관찰됐다.
저자들은 이를 “knowledge epistemic illusion”이라고 부른다. 이름은 강하지만 측정 범위는 좁게 읽어야 한다. avg@1024는 모델 내부를 직접 들여다본 값이 아니고, 최적 호출 임계값도 아니다. 1,024회 샘플에서 드러난 정답 가능성의 대리 지표다. 부록 역시 이 지표가 정확한 임계값을 정해 주지 못한다고 밝힌다.
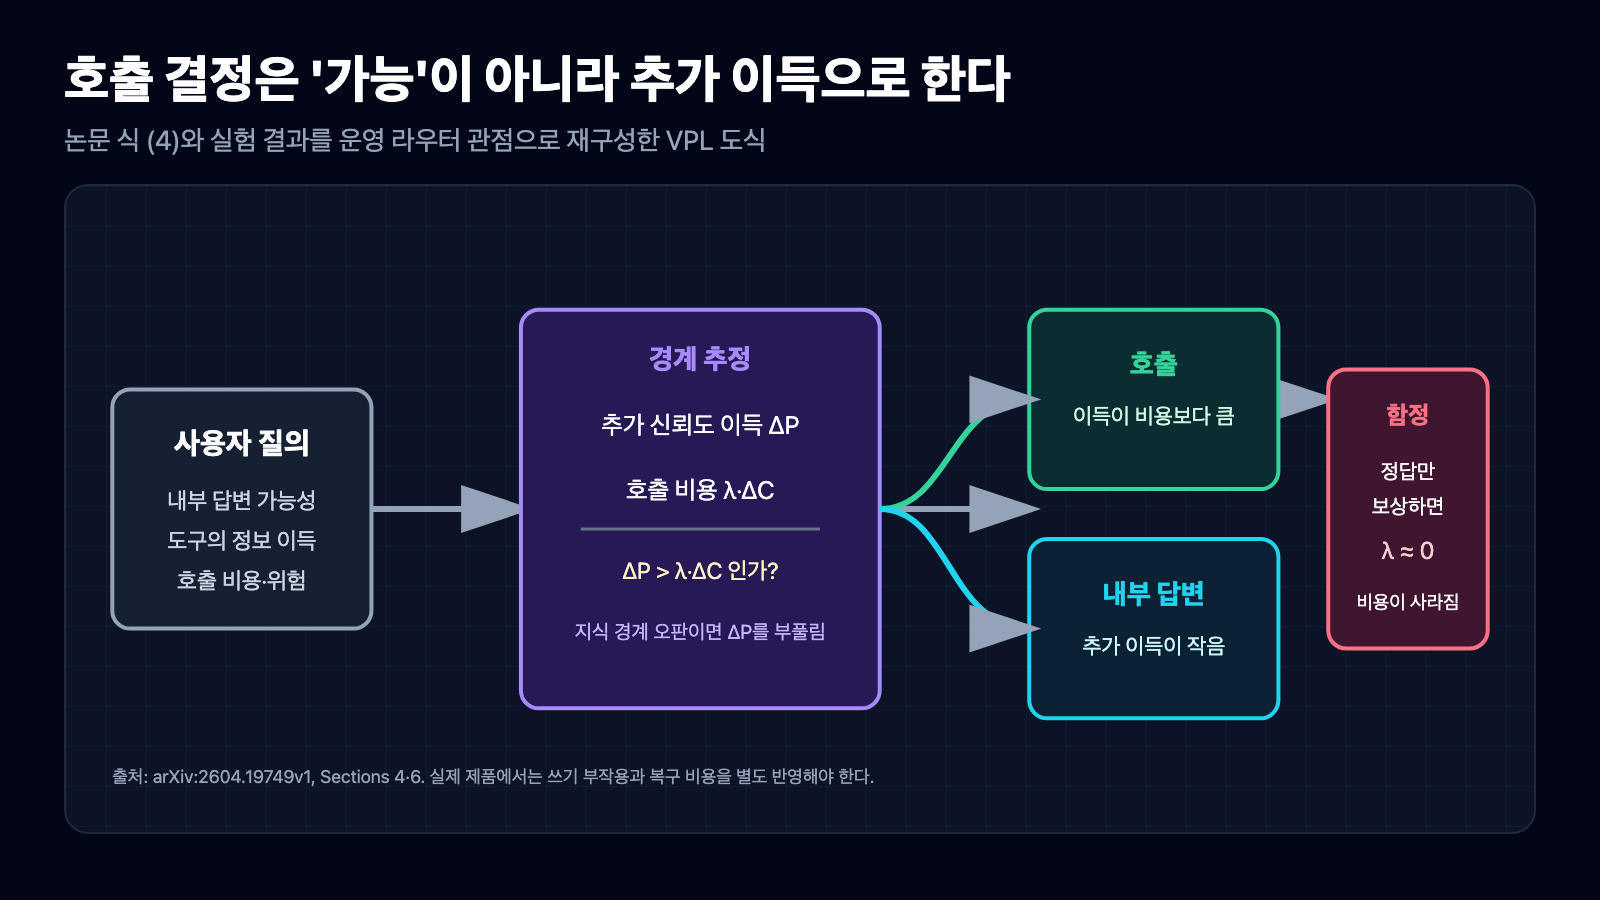
그림 2. 논문 식 (4)를 운영 라우터 관점으로 재구성한 도식. 쓰기 부작용과 복구 비용은 VPL의 실무 확장이다. 출처: arxiv.org/html/2604.19749v1.
그럼에도 운영상 질문은 선명하다. 라우터가 “이 모델은 이 문제를 풀 수 있는가”를 잘못 추정하면, 도구 허용 여부만으로는 행동을 통제할 수 없다. 모델의 답변 확신, 도구 호출, 실제 정확도, 도구가 준 정보 이득을 같은 항목 ID로 묶어 봐야 한다.
정답만 보상하면 호출 비용은 사라진다
논문의 두 번째 실험은 학습 보상에 초점을 맞춘다. 연구진이 ReTool 방식으로 Qwen2.5 3B·7B·32B 모델을 학습 과정을 추적했을 때, 7B 모델의 평균 도구 호출은 2.2회에서 6.8회로 늘었다. 최종 정답만 보상하면 도구를 한 번 더 쓰는 비용이 목적 함수에 거의 나타나지 않는다. 아주 작은 성공 확률 상승만 기대해도 호출 쪽이 유리해질 수 있다.
이를 확인하려고 연구진은 정답 보상 ±1에, 정답 궤적의 도구 호출당 0.05 패널티를 더한 balanced reward를 시험했다. 호출 수는 최대 16회로 제한했다. 7B 모델의 세 벤치마크 평가 평균 호출은 저자 집계 기준 5.1회에서 1.7회로 줄었다. 66.7% 감소다.
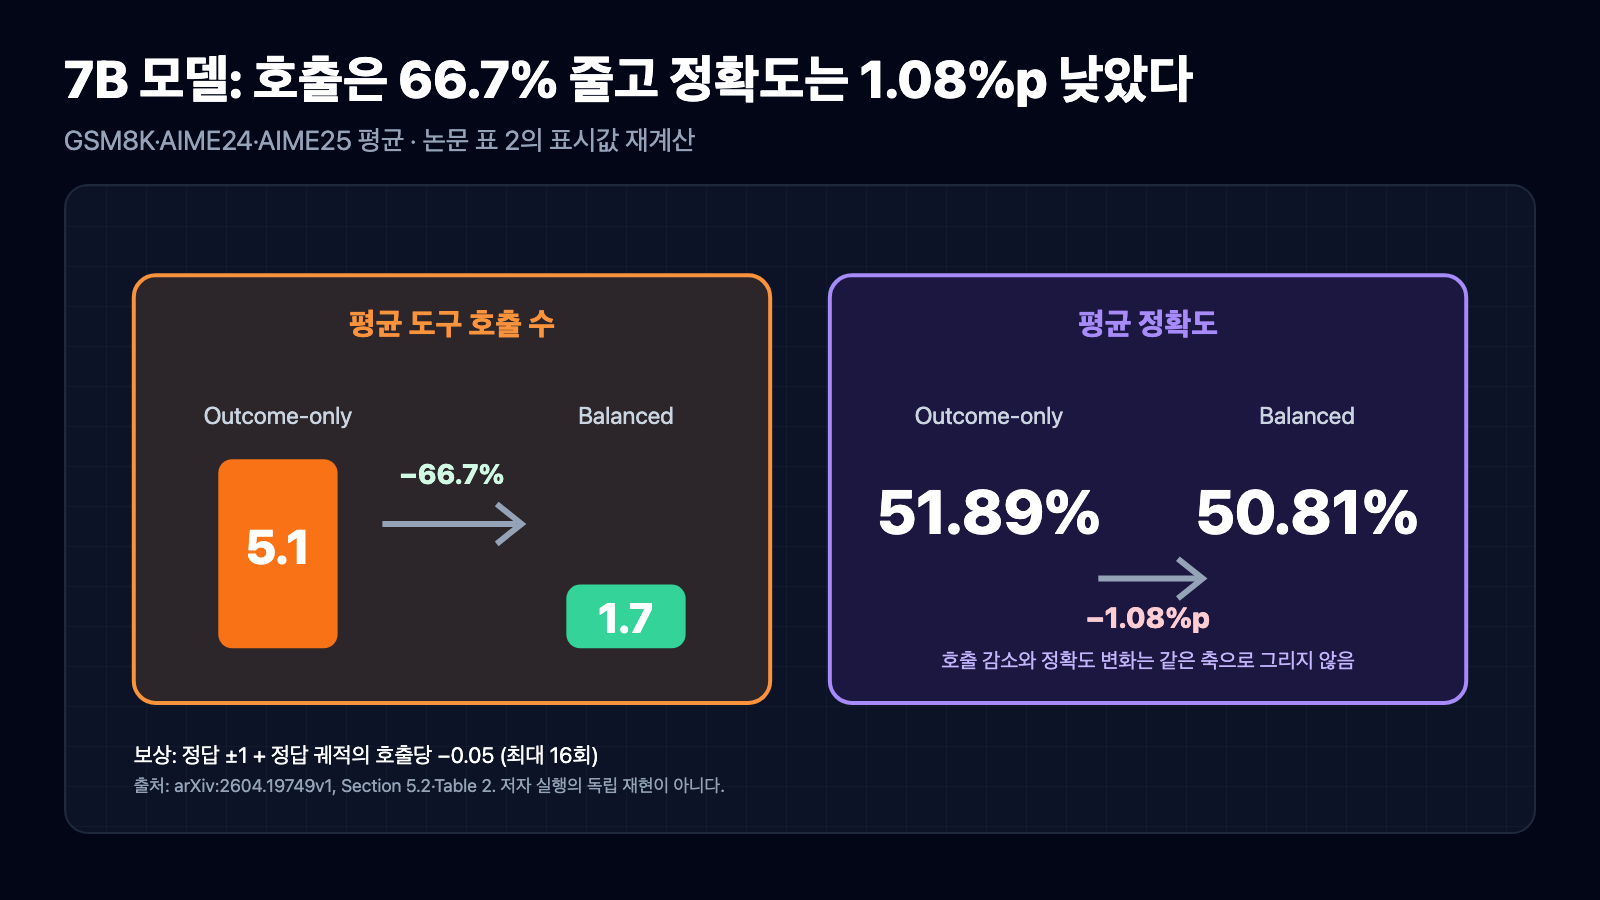
그림 3. 논문 표 2 표시값 재계산. 호출 수와 정확도는 단위가 달라 분리해 표시했다. 출처: arxiv.org/html/2604.19749v1.
정확도는 마법처럼 공짜로 유지된 것이 아니다. 표 2의 GSM8K·AIME24·AIME25 수치를 단순 평균하면 outcome-only 모델은 51.89%, balanced 모델은 50.81%로 약 1.08%p 낮다. 논문도 이를 평균 -1.1%로 적었다. 큰 정확도 붕괴 없이 호출을 줄였다는 해석은 가능하지만, “정확도 손실이 전혀 없다”는 문장보다는 이 숫자가 더 정확하다.
실무에서는 네 가지를 따로 기록한다
이 논문을 그대로 제품 정책으로 옮길 수는 없다. 실험 도구는 수학 문제용 Python 실행기였고, 검색·브라우저·사내 API·파일 변경은 다루지 않았다. 그래도 측정 틀은 쓸 만하다.
- 도구를 사용할 수 있는 상태와 도구가 필요한 상태를 분리한다. 라우터가
available만 보고 호출하게 두지 않는다. - 호출 전후의 정보 이득을 남긴다. 결과가 빈 값이거나 이미 알고 있던 내용이면 성공한 API 호출이어도 과사용 후보로 센다.
- 비용을 한 숫자로 뭉개지 않는다. 지연, 토큰, 호출 요금, 권한 범위, 부작용, 복구 비용을 나눠 기록한다.
- 무도구 대조군을 유지한다. 같은 항목을 도구 없음과 있음으로 반복 실행해 정확도와 호출 수를 함께 비교한다.
- 쓰기 도구에는 더 높은 문턱을 둔다. 조회 실패는 다시 읽으면 되지만, 중복 게시나 결제는 멱등 키와 원격 대조가 필요하다.
호출 수를 줄이는 것 자체가 목표가 되면 반대쪽 오류가 생긴다. 복잡한 문제에서 실제로 필요했던 도구까지 막을 수 있다. 운영 지표는 “호출이 적다”가 아니라 “추가 신뢰도 이득이 비용과 위험을 넘는 호출만 남았는가”에 가까워야 한다.
표를 읽을 때 남는 한계
저자 실험은 temperature 1.0, top-p 1.0의 확률 생성과 avg@8에 기반한다. 부록 G.1은 API 접근 실패로 최종 답을 계산하지 못한 일부 표본을 제거했다고 밝히지만, 제공된 본문만으로 정확한 제외 수와 모델별 영향을 재구성하기 어렵다. 논문 저장소나 원시 로그도 이 글의 조사 범위에서는 확인하지 못했다.
그래서 0.93회, 66.7%, 2.2회에서 6.8회 같은 값은 저자 설정에 묶인 결과다. 다른 모델, 한국어 업무, 검색 도구, 실제 운영 API에 그대로 대입하면 안 된다. 남는 결론은 더 소박하다. 에이전트를 평가할 때 정답만 보면, 불필요한 호출과 위험한 호출을 놓친다. 도구를 잘 고르는 능력만큼 아무것도 호출하지 않는 선택도 따로 시험해야 한다.
참고 자료와 작성 범위
이 글은 AI를 활용해 공개 논문을 분석하고, 원문의 수치와 한계를 대조해 독립적인 실무 해설과 자체 도식을 작성했습니다. 제품 사용 후기나 저자 실험의 독립 재현이 아닙니다. 도입한 운영 체크리스트의 효과를 직접 측정했다고 주장하지 않습니다.
표 2의 재계산을 직접 점검하기
2026-09-12 보강: 아래는 v1 표 2의 Qwen2.5-7B outcome/balanced 두 행에 표시된 값을 입력한 산술입니다. 열 순서는 GSM8K, AIME24, AIME25입니다. 표의 표시값을 확인하고 아래 Python 표준 라이브러리 계산을 별도로 실행했습니다. 모델 실행·재학습·원시 응답 재채점이 아닙니다.
from statistics import mean
outcome_accuracy = [92.34, 40.00, 23.33]
balanced_accuracy = [92.44, 35.83, 24.17]
outcome_calls = [2.2, 4.5, 8.6]
balanced_calls = [0.3, 2.3, 2.5]
print(f"accuracy: {mean(outcome_accuracy):.2f} -> {mean(balanced_accuracy):.2f}")
print(f"difference: {mean(balanced_accuracy)-mean(outcome_accuracy):.2f} percentage points")
print(f"calls: {mean(outcome_calls):.1f} -> {mean(balanced_calls):.1f}")
print(f"reduction: {(1-mean(balanced_calls)/mean(outcome_calls))*100:.1f}%")
accuracy: 51.89 -> 50.81
difference: -1.08 percentage points
calls: 5.1 -> 1.7
reduction: 66.7%세 벤치마크를 같은 가중치로 평균한 값이며 문항을 합친 pooled accuracy가 아닙니다. 각 열의 표본 수가 다르므로 두 집계는 서로 바꿔 쓸 수 없습니다. 반올림된 표 입력값을 재계산했기 때문에 원시 로그의 정확한 평균이나 유의성·신뢰구간을 복원할 수도 없습니다. 이 검산의 독립적인 가치는 정확도 변화와 호출 감소를 같은 단위처럼 섞거나, 감소한 호출만 보고 정확도 손실이 없다고 해석하는 오류를 막는 데 있습니다.


댓글
댓글 쓰기