에이전트 하나를 1억 토큰까지 붙잡아 두면: 3개 세션이 더 나았던 이유
오래 실행하면 계속 좋아지지만, 같은 속도로 좋아지지는 않는다
코딩 에이전트가 막힌 문제를 붙잡고 있을 때 선택지는 두 가지다. 현재 세션을 계속 이어 가거나, 새 세션을 열어 다른 접근을 시도할 수 있다. 대개는 "더 오래 생각하면 더 나아지겠지"라는 감각으로 첫 번째를 고른다. 그런데 9월 14일 공개된 논문 When Agents Slow Down은 이 선택을 토큰당 성능 향상으로 측정했다.
연구진은 Kimi Code, Codex, Claude Code, Gemini CLI를 네 종류의 개방형 벤치마크에 투입했다. 선택된 문제는 모두 14개였다. 각 에이전트-문제 조합마다 독립 세션 5개를 실행했고, 세션당 목표 예산은 입력과 출력을 합쳐 최대 1억 토큰이었다. 중간 제출물은 LLM 심판이 아니라 문제별 결정론적 평가기로 점수를 받았다.
결과를 한 문장으로 줄이면 이렇다. 긴 세션은 끝까지 더 좋은 해를 찾았지만, 추가 토큰이 만들어 내는 개선 폭은 점점 작아졌다. "성능이 멈췄다"와는 다르다. 연구진이 묻는 것은 더 나은 해를 찾았느냐가 아니라, 같은 토큰을 새 출발에 썼을 때보다 효율적이었느냐다.
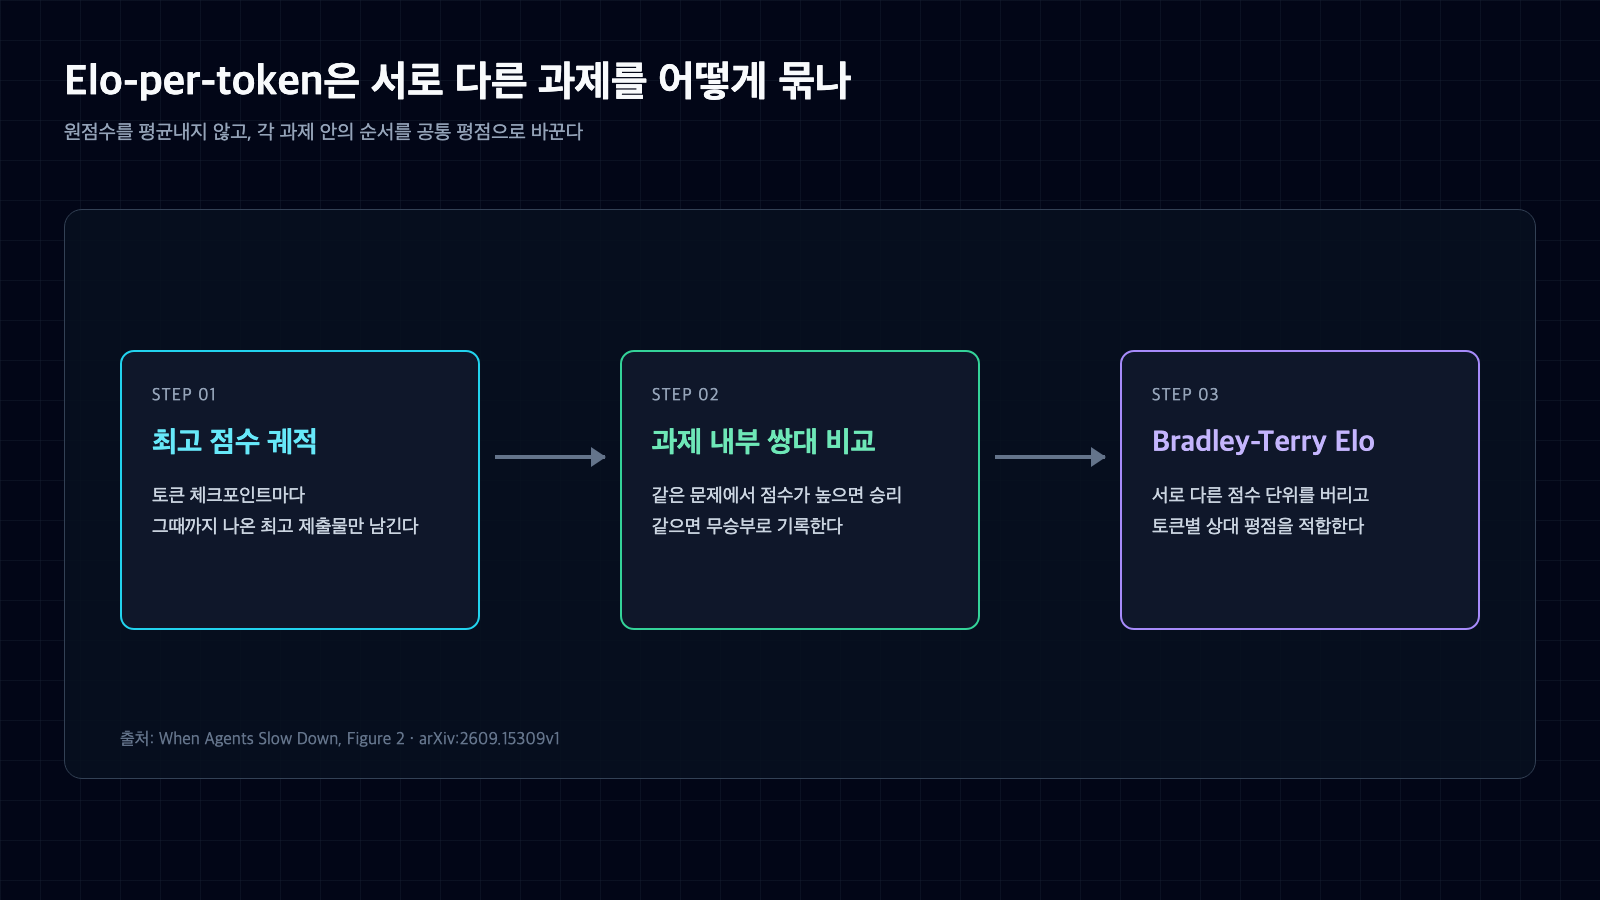
그림 1. 서로 다른 점수 단위를 평균내지 않고 과제 내부의 순서를 토큰별 상대 평점으로 바꾼다. 출처: arxiv.org/abs/2609.15309v1.
서로 다른 점수를 Elo로 묶은 방법
벤치마크마다 점수 단위가 다르다. GPU 커널은 기준 구현 대비 속도 향상으로 평가하고, 알고리즘 문제는 별도의 최적화 목적함수를 쓴다. 원점수 1점의 가치도 구간마다 같지 않다. 그래서 논문은 원점수를 그대로 평균내지 않았다.
먼저 각 세션에서 특정 토큰 시점까지 나온 최고 점수만 남겼다. 다음으로 같은 문제 안에서 서로 다른 에이전트, 세션, 토큰 체크포인트를 쌍대 비교했다. 점수가 높으면 승리, 같으면 무승부다. 마지막으로 Bradley-Terry 모형을 써서 이 순서를 Elo 평점으로 바꿨다. 이렇게 얻은 곡선이 Elo-per-token이다.
기준선은 독립 반복 샘플링이다. 한 문제를 독립적으로 여러 번 풀고 최고 결과만 고를 때, 예산을 10배 늘리면 이론상 400 Elo가 오른다. 이 400 Elo/decade가 긴 세션의 적응적 탐색이 새 출발보다 나은지 판단하는 비교선이 된다.
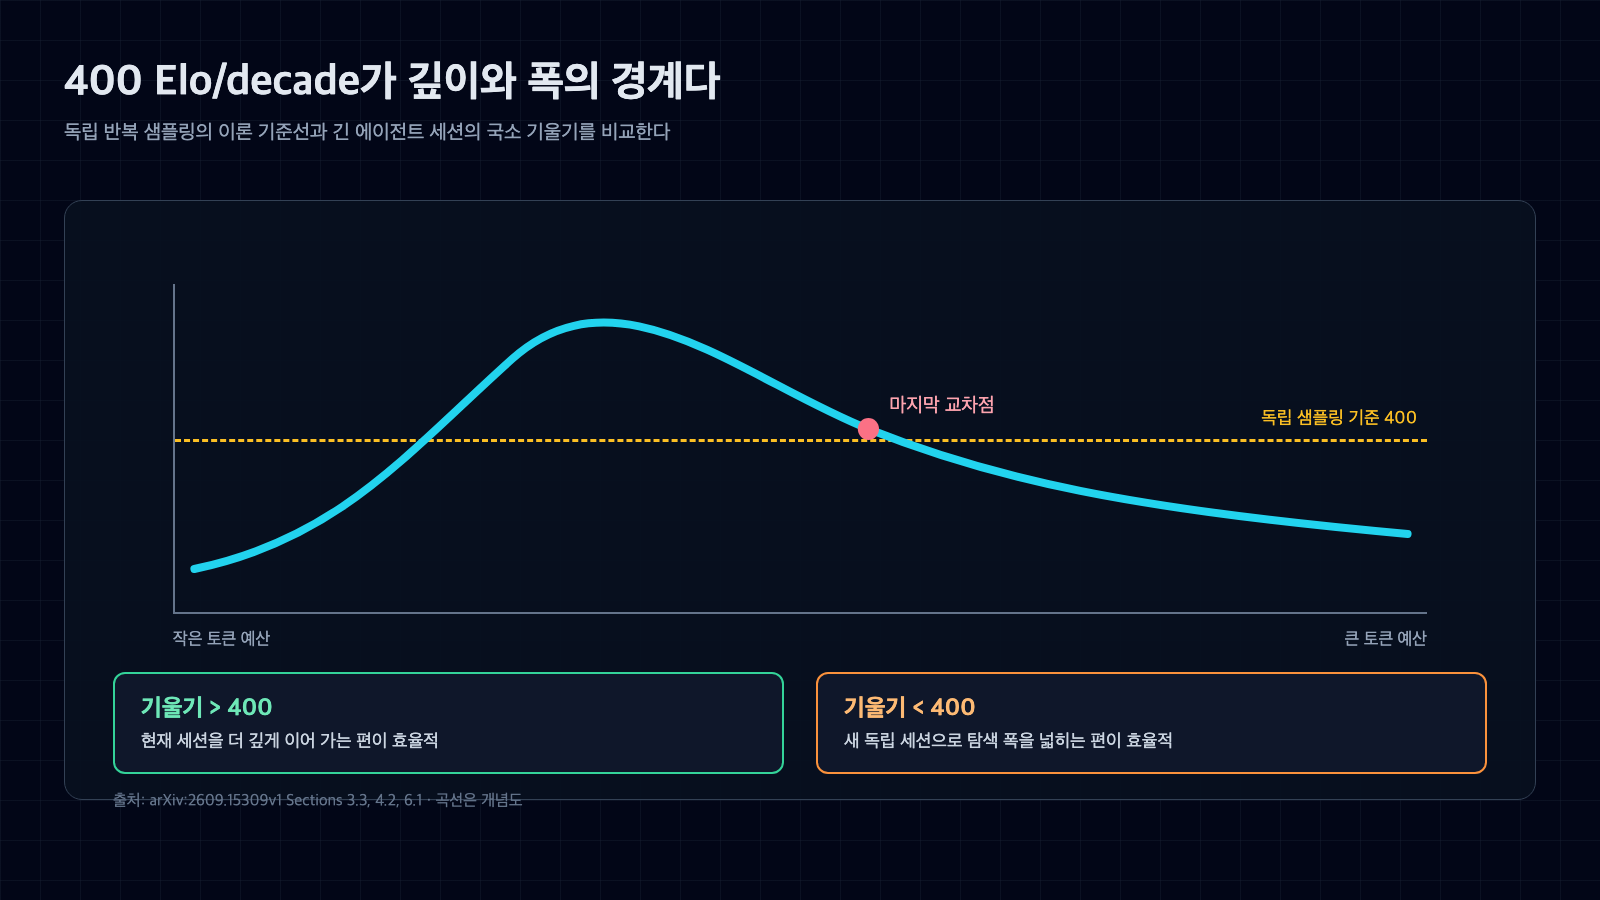
그림 2. 마지막 400 Elo/decade 교차점 뒤에는 한 세션을 연장하는 것보다 독립 세션을 늘리는 편이 토큰당 효율적이다. 출처: arxiv.org/abs/2609.15309v1.
초반에는 깊이가 이겼고, 뒤에서는 폭이 이겼다
네 에이전트 모두 측정 구간에서 토큰을 더 쓰면 최고 해의 Elo가 올랐다. 다만 pooled 결과에서 가장 큰 예산에 이르자 네 시스템의 국소 기울기가 모두 400 아래로 내려갔다. 초반에는 현재 문맥, 도구 결과, 수정 이력을 활용하는 긴 세션이 독립 샘플링보다 빨리 좋아졌다. 이후에는 같은 세션을 연장하는 것보다 새 세션을 여는 편이 토큰당 기대 향상이 컸다.
논문은 마지막으로 400 기준선을 통과하는 지점을 scaling inflection point라고 부른다. 이 값은 모델 전체에 붙는 고정 상수가 아니다. 에이전트와 과제에 따라 달라졌다. FrontierCS의 Polyomino Packing 과제에서 Kimi K2.7의 변곡점은 약 3,800만 토큰이었다. 반면 같은 에이전트의 FrontierCS 도메인 전체 곡선만 보고는 이 과제의 변곡점을 정확히 예측하지 못했다.
연구진이 제시한 설명은 "끈적한 분지" 가설이다. 세션 초기에 택한 알고리즘, 코드 구조, 상위 전략이 문맥이 길어질수록 버리기 어려워진다는 뜻이다. 현재 접근 안에서는 계속 개선할 수 있어도, 처음 선택한 접근 자체를 다시 고르는 일은 줄어든다. 다만 이것은 관찰 결과를 설명하기 위한 가설과 단순 모형이지, 실제 에이전트 내부에서 분지를 직접 측정한 결과는 아니다.
1억 토큰을 3개 세션으로 나눴을 때
Polyomino Packing 실험은 총 1억 토큰을 1, 2, 3, 4, 5, 10개 세션으로 나눠 비교했다. 3,800만 토큰 변곡점을 기준으로 계산하면 세 개 세션이 예측된다. 실제 공동 Elo 평점도 세 세션이 2,245로 가장 높았다. 한 세션은 1,981, 열 세션은 1,890이었다. 논문이 보고한 차이는 각각 +264 Elo와 +355 Elo다.
이 결과는 "항상 세 개를 실행하라"는 처방이 아니다. 한 세션은 작은 총예산에서 앞섰고, 지나치게 짧은 열 세션은 각 세션이 초기 적응의 이득을 충분히 누리지 못했다. MLS-Bench에서도 변곡점 기반의 중간 분할이 양 극단보다 나았지만, 최적 분할 수와 변곡점은 과제별 측정이 필요했다.
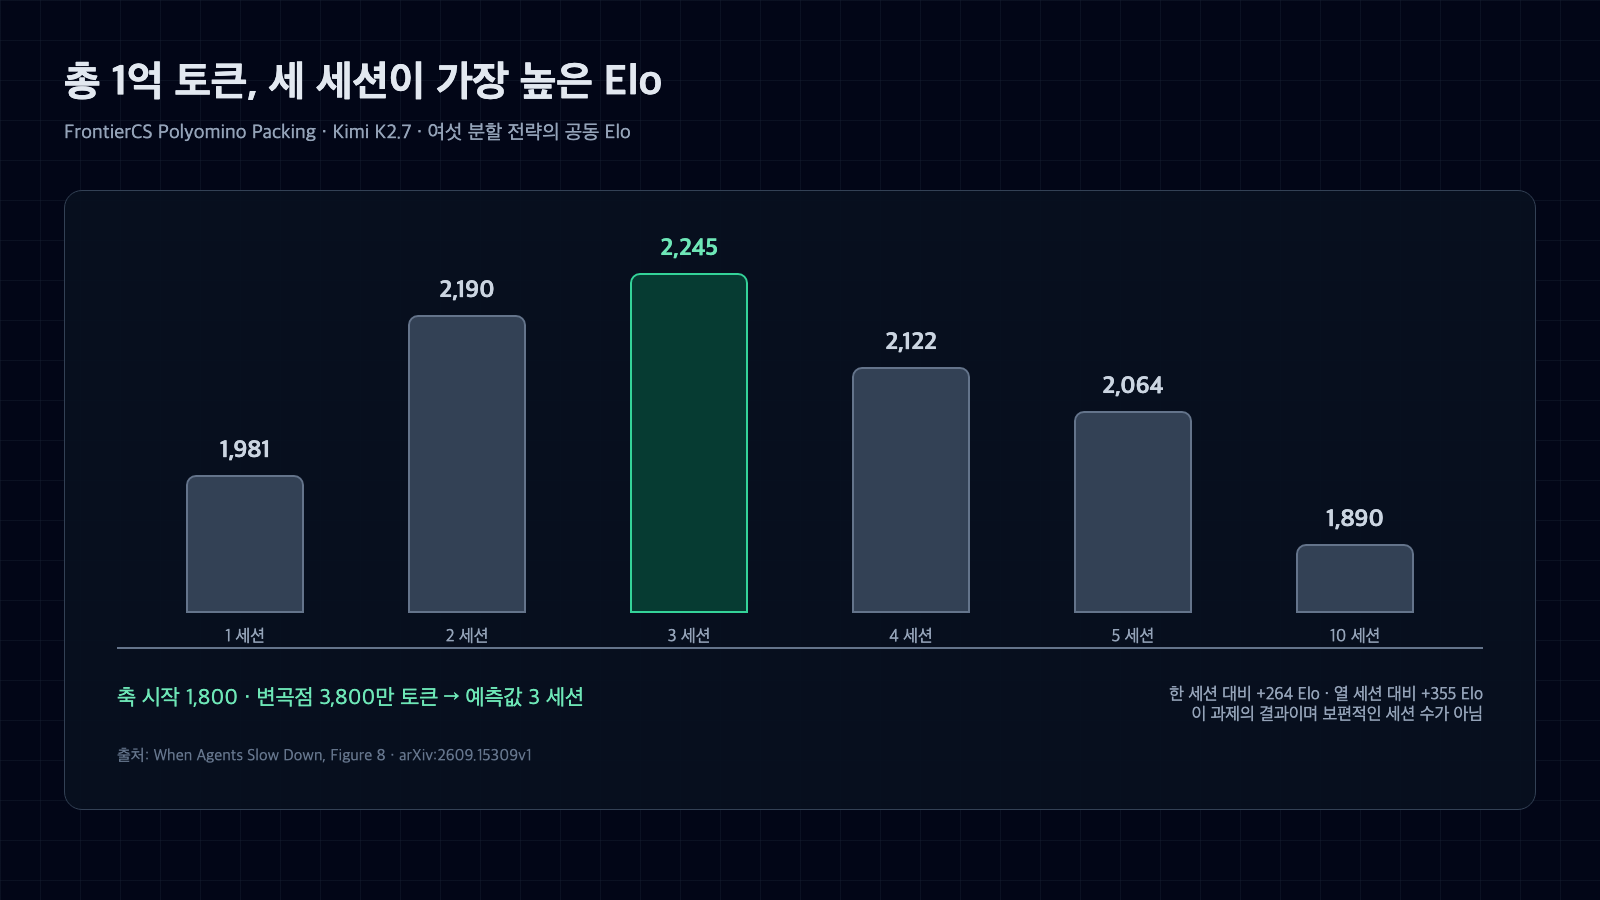
그림 3. Polyomino Packing 한 과제에서는 3,800만 토큰 변곡점이 예측한 세 세션 분할이 여섯 후보 중 가장 높았다. 출처: arxiv.org/abs/2609.15309v1.
운영에 옮기려면 점수와 비용을 함께 기록해야 한다
이 연구를 실제 에이전트 운영에 적용하려면 최종 성공 여부만 저장해서는 부족하다. 중간 제출 시각, 누적 토큰, 그때까지의 최고 점수를 같은 로그에 묶어야 한다. 점수가 다른 여러 과제를 합칠 때는 원점수 평균 대신 과제 내부 순위를 보존하는 집계가 필요하다. 세션을 나눌 때도 총 토큰과 평가 횟수를 같게 맞춰야 한다.
실용적인 운영 규칙은 단순하다. 초반에 현재 세션이 빠르게 개선되는 동안에는 깊이를 늘린다. 최근 체크포인트의 개선 기울기가 독립 재시작 기준보다 낮아지면, 남은 예산을 새 세션에 배분한다. 여러 세션에서는 마지막 출력이 아니라 전체 세션의 최고 검증 결과를 고른다. 여기서 중요한 단어는 "검증"이다. 자동 평가기가 없는 작업이라면 잘못된 답을 여러 개 만든 뒤 가장 그럴듯한 것을 고르는 오류가 생길 수 있다.
아직 독립 재현할 수 없는 부분
공개 저장소에는 실험 실행기, 수정된 Harbor, 과제 어댑터, Elo 분석 코드가 올라와 있다. 하지만 README는 원시 trial 로그, 집계 데이터, AtCoder 사람 데이터, FlashInfer 실행 결과가 별도로 공개될 예정이라고 명시한다. 따라서 이번 글은 논문의 수치와 공개 코드를 대조했지만, +264와 +355 Elo를 원시 로그에서 다시 계산하지는 못했다.
비용 축도 주의해서 읽어야 한다. 주 실험은 캐시된 입력을 포함한 입력+출력 토큰을 누적했다. 저자들은 문맥 창이 입력 크기를 제한하므로 장기적으로 곡선 모양은 유지된다고 설명한다. 그래도 API 비용, 실제 지연, 캐시 할인까지 한 숫자로 대체할 수는 없다. 사람 비교도 대부분 토큰과 벽시계를 서로 다른 축으로 맞춘 성장 모양 비교다. 같은 속도나 같은 비용의 정면 대결로 읽으면 과장이다.
그럼에도 운영상의 질문은 선명해졌다. 오래 실행할 수 있느냐보다, 언제 같은 세션이 새 출발보다 덜 효율적이 되는지를 측정해야 한다. 장기 에이전트의 성능표에는 최종 점수 하나가 아니라 토큰별 최고 점수 곡선과 재시작 기준점이 함께 있어야 한다.


댓글
댓글 쓰기