에이전트 로그 100개 중 읽을 가치 있는 82개를 고르는 법
에이전트가 하루에 수천 개의 대화와 도구 호출 기록을 남기면, 문제는 로그 수집보다 무엇을 먼저 읽을지 고르는 일로 옮겨간다. 무작위 표본은 공정하지만 중요한 실패를 많이 흘린다. 모든 궤적을 다른 LLM에게 평가시키면 비용이 다시 커진다.
DigitalOcean 연구진의 논문 "Signals"는 그 사이를 노린다. 대화와 실행 기록에서 값싼 규칙 기반 신호를 뽑아 검토 대상을 먼저 줄인다. 실험에서는 신호 기반 표본 100개 중 82개가 개발자에게 유용한 궤적으로 판정됐다. 무작위 표본은 54개, 대화가 긴 기록을 고르는 단순 휴리스틱은 74개였다.
점수가 아니라 검토 순서를 만든다
이 접근은 에이전트 품질을 한 숫자로 채점하지 않는다. 대신 "개발자가 개선 가설을 세울 만한 기록인가"를 묻는다. 실패뿐 아니라 잘 처리된 모범 사례도 표본에 남긴다.
이 구분이 중요하다. 사용자가 짧게 답했다고 해서 불만이라고 단정할 수 없고, 도구 호출이 한 번 실패했다고 에이전트의 판단이 틀렸다고 볼 수도 없다. 신호는 판결문이 아니라 검토 큐의 우선순위다.
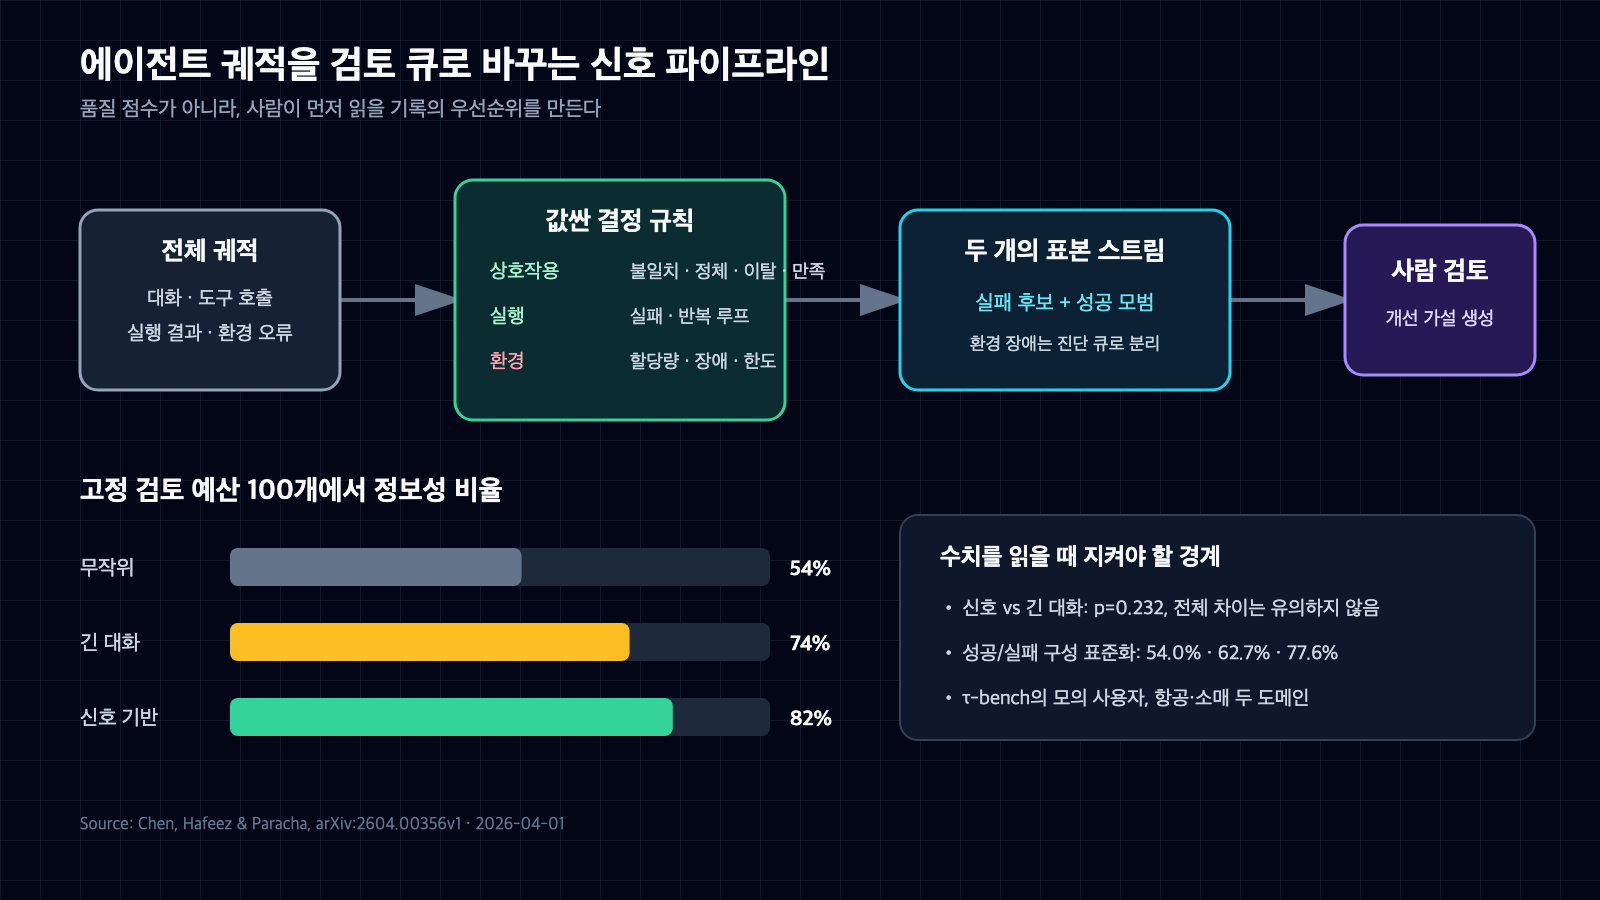
그림 1. 신호 기반 궤적 선별 과정과 고정된 100개 검토 예산에서의 정보성 비율. 신호는 품질 점수가 아니라 검토 우선순위다. 출처: arxiv.org/html/2604.00356.
세 층의 신호를 분리한다
논문은 신호를 세 묶음으로 나눈다. 상호작용 신호에는 의도 불일치, 대화 정체, 이탈, 만족이 들어간다. 실행 신호는 쓸모없는 도구 결과와 같은 실패, 같은 호출이나 전략을 반복하는 루프를 찾는다. 환경 신호는 속도 제한, API 장애, 컨텍스트 한도처럼 에이전트 밖의 제약을 표시한다.
환경 신호를 학습 데이터와 섞지 않는 판단이 특히 실무적이다. 외부 API가 멈춘 기록을 나쁜 행동의 예로 학습시키면, 서비스 장애와 에이전트 능력을 혼동할 수 있다. 이런 기록은 운영 진단에는 필요하지만 선호 학습의 감독 신호로는 부적절하다.
실험은 300개 궤적을 같은 기준으로 비교했다
연구진은 도구 사용 에이전트 벤치마크인 τ-bench의 과거 궤적을 사용했다. 항공과 소매 두 도메인에서 무작위, 10개 이상 사용자 메시지를 가진 긴 대화, 신호 기반 방식이 각각 100개씩을 골랐다. 세 명의 전문가가 출처 방식을 모르는 상태에서 300개를 섞어 독립적으로 판정했고, 세 명 중 두 명 이상이 동의하면 "개발자에게 유용"으로 집계했다.
전체 결과는 54%, 74%, 82%였다. 다만 신호와 긴 대화 휴리스틱의 차이는 통계적으로 유의하지 않았다(p=0.232). 반면 신호와 무작위의 차이는 p<0.001이었다. 82라는 숫자만 떼어 "항상 28%포인트 좋아진다"고 일반화하면 안 되는 이유다.
실패만 많이 고른 것이 아니었다
긴 대화 휴리스틱은 표본의 70%가 실패 궤적이었다. 무작위는 37%, 신호 기반은 52%였다. 실패는 보통 문제를 찾기 쉬우므로, 실패를 많이 담으면 정보성 비율도 자연히 올라간다.
연구진은 이 구성을 무작위 표본의 성공·실패 비율에 맞춰 다시 가중했다. 표준화한 정보성 비율은 무작위 54.0%, 긴 대화 62.7%, 신호 기반 77.6%였다. 성공한 궤적만 봐도 신호 방식은 66.7%가 유용했고, 긴 대화는 50.0%, 무작위는 41.3%였다. 최종 결과가 맞았지만 정책을 어겼거나 도구를 비효율적으로 쓴 사례를 찾는 데 차이가 났다.
1.52배 효율의 정확한 뜻
100개를 검토했을 때 신호 방식은 유용한 기록 82개, 무작위는 54개를 얻었다. 유용한 궤적 하나를 얻는 데 필요한 라벨 수는 각각 1.22개와 1.85개다. 논문이 말하는 1.52배 효율은 이 두 값의 비율이다.
이 수치는 전체 운영 비용 절감을 뜻하지 않는다. 신호 계산과 로그 정규화, 검토 UI, 규칙 유지보수 비용은 별도다. 또한 세 평가자의 정보성 판단에 대한 Gwet AC1은 0.477로 중간 수준이었다. "읽을 가치" 자체가 경계 사례에서 주관적이라는 뜻이다.
그대로 복사하면 놓치는 것
실험은 실제 사용자 트래픽이 아니라 LLM이 사용자를 흉내 낸 τ-bench 기록을 썼다. 항공과 소매 두 도메인뿐이라 다른 업무로의 일반화도 확인되지 않았다. 만족과 이탈 표현은 실제 사용자보다 단순할 수 있다.
규칙은 말투와 반복, 도구 오류를 잘 찾지만 조용한 사실 오류는 놓친다. 자연스러운 대화로 틀린 답을 내놓은 궤적은 별도 결과 검증기가 필요하다. 그래서 이 방법은 정답 검사나 도메인 정책 검증을 대체하지 않는다.
운영에 넣을 때의 최소 설계
- 원본 이벤트를 대화, 도구 호출, 환경 오류로 나눠 보존한다.
- 실패·루프 규칙에는 어떤 메시지와 호출이 걸렸는지 근거 위치를 남긴다.
- 실패 표본과 성공 모범 표본을 별도 스트림으로 뽑는다.
- 외부 장애와 할당량 초과는 학습 후보에서 제외하고 운영 큐로 보낸다.
- 주간 무작위 표본을 유지해 규칙이 보지 못하는 실패를 측정한다.
- 정보성 비율뿐 아니라 실제 수정으로 이어진 비율과 검토 시간을 함께 잰다.
처음부터 복잡한 판별 모델을 붙일 필요는 없다. 반복 호출, 빈 결과, 사용자의 재질문처럼 설명 가능한 규칙 몇 개로 시작하고, 무작위 표본과 비교해 누락을 확인하는 편이 낫다. 신호가 잘 고르는 기록과 계속 놓치는 기록이 보인 뒤에만 선택적 LLM 판별기를 추가해도 늦지 않다.
한계와 참고 자료
이 글은 AI를 활용해 공개 논문과 표를 읽고 재구성한 해설입니다. 연구진의 300개 주석을 독립적으로 다시 판정하거나 실제 운영 로그에서 재현하지 않았습니다. 수치는 논문 v1의 표와 설명을 따릅니다.


댓글
댓글 쓰기