에이전트 모델만 바꿨는데 기억 정확도가 13.28%p 떨어졌다: 메모리 이관의 네 함정
에이전트의 모델을 교체할 때 대화 기록과 벡터 데이터베이스를 그대로 두면 기억도 그대로일까. 9월 4일 공개된 「Does Your Agent's Memory Survive a Model Upgrade?」는 데이터베이스가 멀쩡히 열려도 답은 달라질 수 있다고 보고한다. 한 방향의 모델 교체에서는 자연어 메모를 물려받은 정확도가 13.28%포인트 떨어졌다. 반대 방향에서는 오히려 9.91%포인트 올랐다.
두 값을 평균내면 문제가 작아 보인다. 하지만 실제 배포는 평균 방향으로 일어나지 않는다. 기존 모델이 쓴 기억을 특정 새 모델이 읽는다. 어느 모델이 쓰고 어느 모델이 읽는지까지 고정해 시험해야 하는 이유다.
요약: 메모리는 파일보다 긴 호환성 계약이다
연구진은 48개의 합성 이력에 각각 160개 질문을 만들었다. 답은 무작위 코드라 모델이 사전학습 지식으로 맞히기 어렵고, LLM 심판 대신 exact match로 채점했다. Llama 3.1 8B Instruct와 Qwen2.5 7B Instruct 1M이 같은 이력을 네 형식으로 읽었다. 원문 전체를 넣는 LC-RAW, 약 512자 단위 chunk를 찾는 RAG, 모델이 압축한 자연어 NOTES, 고정 schema의 knowledge graph인 KG-fixed다.
이 구분은 실제 제품에도 가깝다. Anthropic의 공식 memory tool도 context window 밖의 file-based directory를 읽고 쓰며, storage backend와 persistence는 개발자가 관리한다고 설명한다. 저장 장치가 외부에 있다는 사실만으로 다음 모델이 같은 의미로 읽는다는 보장은 없다.
NOTES는 작성 모델과 읽기 모델의 조합에 민감했다. Qwen이 자기 메모를 읽을 때 정확도는 47.19%였지만 Llama가 쓴 메모를 물려받으면 33.91%로 내려갔다. 반대 방향에서는 Llama가 자기 메모를 읽은 37.62%보다 Qwen 메모를 읽은 47.53%가 높았다. KG-fixed의 writer swap 변화는 두 방향에서 -0.11%포인트와 +0.02%포인트에 그쳤다.
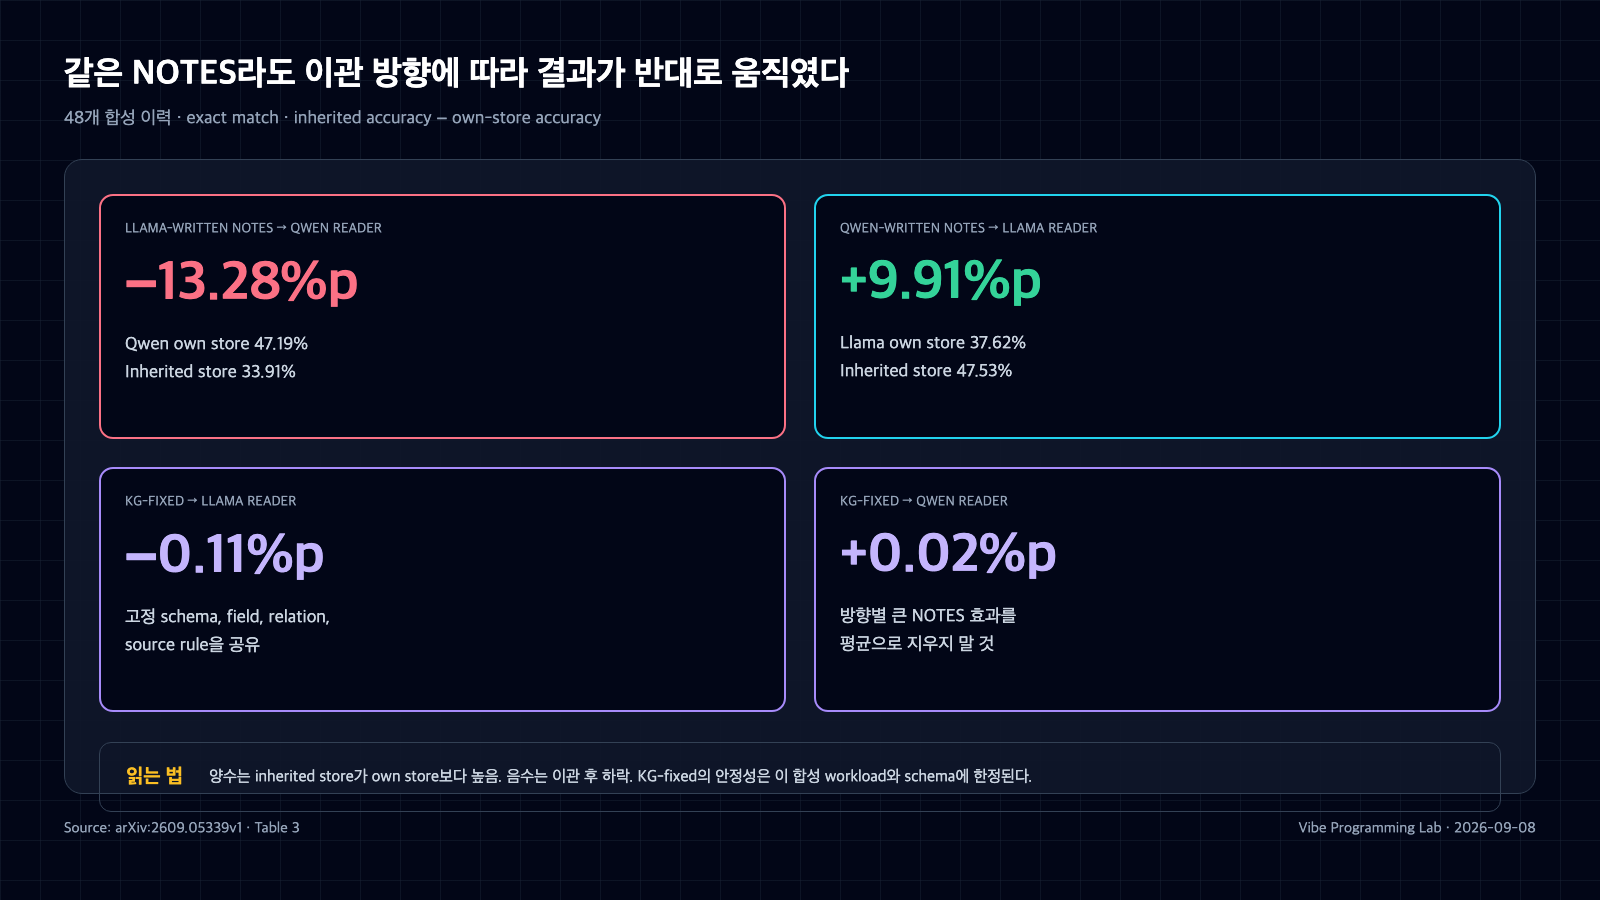
NOTES는 이관 방향에 따라 -13.28%포인트와 +9.91%포인트로 반대로 움직였다. KG-fixed 변화는 이 workload에서 -0.11과 +0.02%포인트였다. 출처: arxiv.org/html/2609.05339v1.
이 결과가 "지식 그래프가 언제나 자연어 메모보다 낫다"는 뜻은 아니다. 이 연구의 schema는 합성 workload의 event field에 맞았고, KG-fixed와 NOTES는 읽는 방식도 달랐다. 확인된 결론은 더 좁다. 자유형 요약문은 누가 썼는지에 따라 새 reader의 결과가 크게 달라질 수 있고, 방향을 합친 평균은 그 차이를 숨긴다.
설계: 어디서 잊었는지 세 구간으로 나눴다
틀린 답이 나왔다고 새 모델부터 탓하면 원인을 놓친다. 논문은 memory path를 저장, 검색, 읽기의 세 구간으로 나눴다. NOTES에는 원문을 제공했을 때와 저장된 note item만 제공했을 때를 비교했다. RAG에는 정상 검색 결과와 정답 chunk를 직접 제공한 결과를 비교했다.
NOTES의 전체 정확도 손실 0.584 가운데 0.467, 약 80%가 store construction에서 생겼다. 요약 모델이 처음 note를 만들 때 빠뜨린 정보가 대부분이었다. RAG는 반대였다. 전체 손실 0.450 중 0.364, 약 81%가 retrieval에서 생겼다. chunk 안에는 답이 남아 있었지만 top-8 검색이 그것을 reader에게 보내지 못했다.
따라서 같은 "기억 실패"라도 수리 지점이 다르다. NOTES는 새 reader prompt를 다듬기 전에 요약 단계의 coverage를 봐야 한다. RAG는 reader를 바꾸기 전에 chunking, embedding, ranking, query path를 검사해야 한다.
같은 1,024차원도 같은 벡터 공간은 아니다
embedding migration은 더 조용하게 실패했다. 연구진은 BAAI bge-large-en v1.0을 v1.5로 바꿨다. 두 모델 모두 1,024차원 벡터를 내므로 기존 index에 새 벡터를 섞어도 dimension 오류는 나지 않는다. 서비스는 계속 응답한다.
하지만 모든 chunk를 v1.5로 다시 embedding한 index는 기존 index보다 답 정확도가 11.90%포인트 올랐다. old와 new vector를 50 대 50으로 섞은 index의 개선은 4.96%포인트뿐이었다. full re-embedding이 만든 개선의 절반 이상을 놓친 셈이다. recall@k도 full re-embed 0.5998, mixed index 0.5208로 갈렸다.
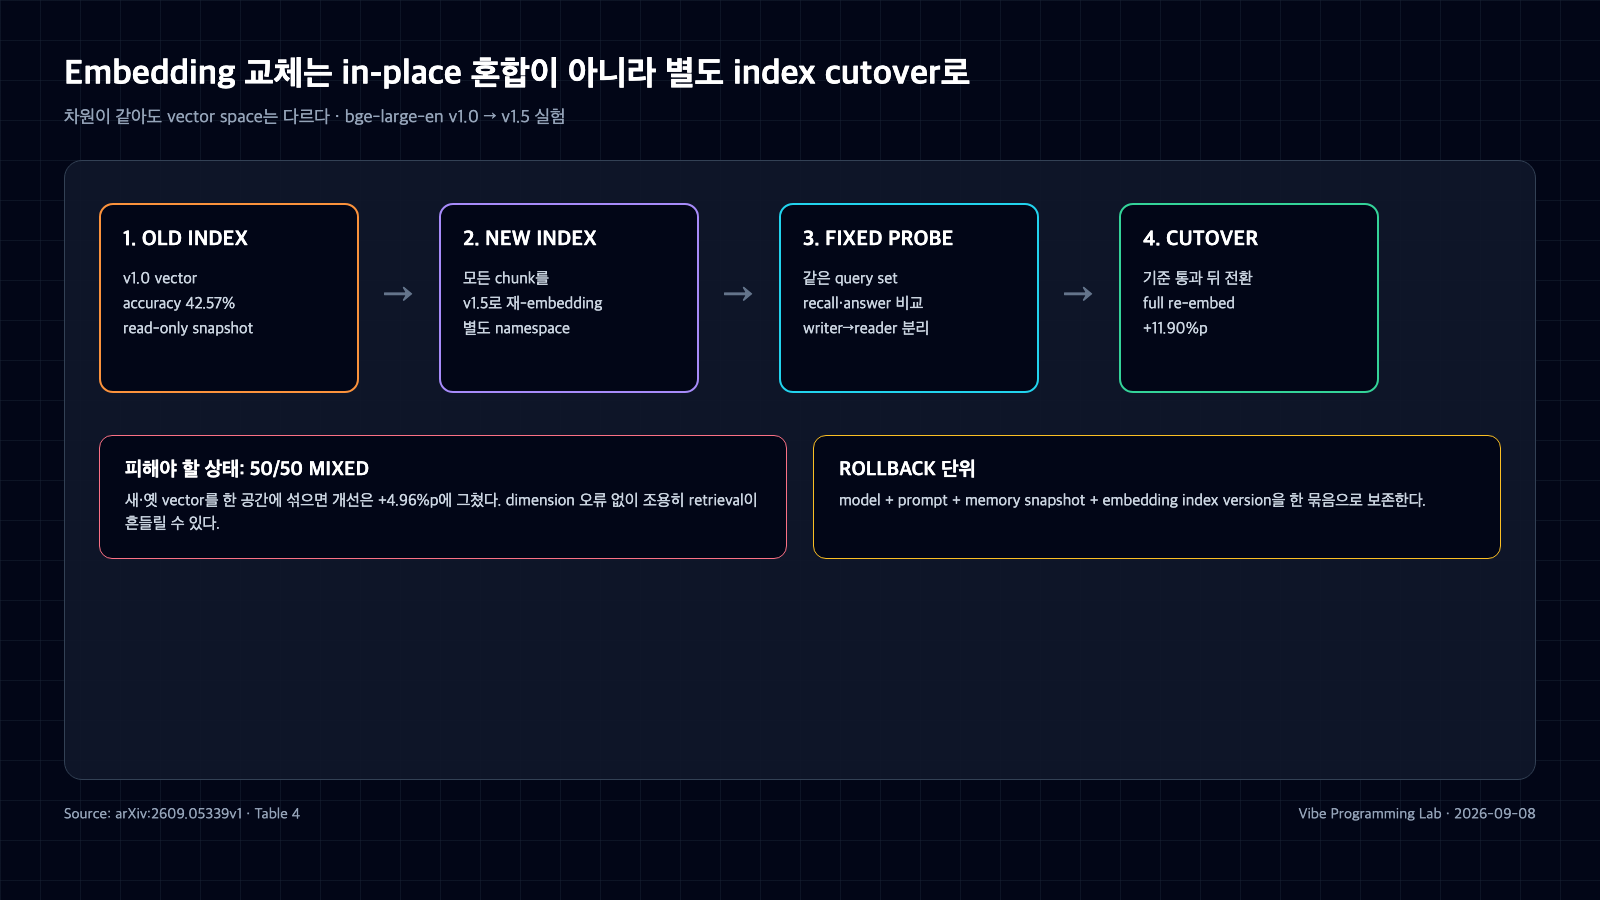
bge-large-en v1.0과 v1.5 벡터를 반씩 섞은 index는 +4.96%포인트 개선에 그쳤고, 전체 재임베딩은 +11.90%포인트 개선됐다. 출처: arxiv.org/html/2609.05339v1.
점진 이관이 필요하다면 서로 다른 embedding version을 한 검색 공간에 섞는 대신 index를 분리해야 한다. 새 index를 모두 채운 뒤 고정 probe로 old와 new를 비교하고, 통과한 시점에 traffic을 전환한다. Weaviate의 vectorizer migration 문서도 새 collection을 만들거나 target vector를 추가하는 방식으로 기존 vector와 새 vector의 경계를 관리한다.
원문을 버린 요약은 다시 써도 복구되지 않았다
연구진은 inherited memory를 새 모델용으로 고치는 네 방법도 비교했다. RAG 전체 re-embedding은 두 이관 방향의 48개 이력 모두에서 own-store 성능의 90%, 95%, 99% 목표를 달성했다. median 비용은 성공 이력 기준 약 0.013달러였다. KG-fixed schema rebuild도 90% 목표에서 양방향 모두 48개를 복구했다.
NOTES store만 새 문체로 다시 쓰는 방법은 달랐다. 두 방향, 세 budget, 48개 이력 가운데 90% 목표에 도달한 경우가 하나도 없었다. 이미 빠진 사실은 남은 요약문만 다시 다듬어도 생기지 않는다.
원시 이력을 보관한 경우에도 자동 복구가 보장되지는 않았다. Llama가 쓴 note를 Qwen이 원문에서 다시 만들 때는 34/48개가 90% 목표를 넘었다. Qwen에서 Llama로 가는 방향은 0/48이었다. Llama repair가 output token limit에 걸린 영향이 있어 모델 능력만의 깨끗한 비교는 아니다. 보관 원문은 복구 재료일 뿐, 실제 repair model과 budget을 시험해야 한다.
주의점: 합성 이력 두 모델의 결과다
48개 이력은 사실, 변경, 모순, alias, 다단계 관계를 exact match로 추적하도록 설계됐다. 원인 구간을 나누기 좋지만 실제 사용자 대화보다 단순하다. 두 open-weight 모델은 10B 미만이고, 모든 이력이 두 모델의 context window 안에 들어갔다. 주관적 선호, 수년치 대화, 여러 tool의 불완전한 기록으로 그대로 일반화할 수 없다.
RAG도 약 512자 event chunk, dense retrieval, cosine similarity, top-8, reranker 없음이라는 한 설정이다. 논문이 관측한 약 40% retrieval miss를 모든 RAG의 한계라고 부르면 안 된다. mixed index의 수치 역시 bge-large-en v1.0에서 v1.5로 바꾼 이 실험의 값이다.
원문 보관에는 개인정보와 보안 비용도 따른다. "나중에 고칠 수 있으니 전부 저장"은 안전한 기본값이 아니다. 암호화, 접근 제한, 삭제 기한, 사용자 동의가 먼저고, 보존이 허용된 범위 안에서만 복구용 source를 둬야 한다.
실전 적용: 모델 교체 전에 20개 probe부터 고정한다
먼저 memory record에 writer model, prompt version, schema version, embedding model, chunking 설정, 생성 시각을 남긴다. 답만 저장하지 말고 어떤 source event에서 파생됐는지도 연결한다. 그래야 정확도가 떨어졌을 때 store construction과 retrieval을 따로 추적할 수 있다.
그다음 실제 서비스의 중요한 기억 유형을 뽑아 작은 migration probe를 만든다. 논문 부록의 20-probe 검사는 다른 140개 질문의 정확도를 예측할 때 unseen history MAE 0.0945, unseen model pair MAE 0.1004를 보였다. 다만 다른 memory format으로 옮기면 평균 bias가 +0.0310으로 커졌다. probe는 같은 형식 안의 조기 경보로 쓰고, 전체 검증을 대신시키지 않는 편이 안전하다.
배포 순서는 dual-write보다 rebuild-and-cutover가 낫다. 새 embedding index를 별도 namespace에 완성하고, old/new 양쪽에 같은 query set을 실행한다. NOTES는 writer→reader 방향별로 평가한다. schema 기반 memory는 누락 필드와 conflict rule을 검증한다. 기준을 넘기기 전에는 old store를 지우지 않는다.
관측 지표도 최종 답 정확도 하나로 끝내지 않는다. 검색 단계에는 recall@k와 정답 근거가 실제 context에 들어왔는지를 남긴다. 저장 단계에는 필수 field coverage와 source event 연결률을 기록한다. 읽기 단계에는 정답 근거를 직접 넣었을 때의 upper bound를 둔다. 세 숫자가 있어야 "새 모델이 기억을 못 한다"는 한 문장을 저장 실패, 검색 실패, 해석 실패로 쪼갤 수 있다.
canary 이관에는 실패 예산을 미리 정한다. 예를 들어 핵심 probe에서 2%포인트 이상 떨어지거나 source 누락이 한 건이라도 나오면 자동 전환을 멈춘다. 새 index가 준비됐다는 운영 상태와 새 memory path가 품질 기준을 통과했다는 제품 상태를 같은 것으로 취급하지 않는다. 전환 뒤에도 일정 기간 두 경로의 결과와 근거 ID를 나란히 저장해야 rollback 판단이 빨라진다.
마지막으로 rollback 대상을 모델 binary만으로 잡지 않는다. model, prompt, memory snapshot, embedding index version을 한 묶음으로 되돌릴 수 있어야 한다. 모델만 이전 버전으로 돌리고 이미 섞인 index를 그대로 두면 장애 원인이 남는다. 에이전트의 기억은 데이터 파일이 아니라 작성자, 검색기, reader가 함께 지키는 호환성 계약이다.


댓글
댓글 쓰기