같은 모델 점수가 13.3%에서 38.3%로 뛴 이유: ARC-AGI-3 하네스의 기억 설계
낯선 퍼즐을 푸는 에이전트가 매 행동 뒤 자신의 추론을 잊는다면, 낮은 점수를 모델 탓으로만 돌려도 될까. OpenAI가 ARC-AGI-3 공개 과제에서 GPT-5.6 Sol을 다시 시험한 결과는 꽤 거슬리는 답을 내놓는다. 공식 하네스에서는 RHAE 점수가 13.3%였지만, 이전 추론을 유지하고 긴 문맥을 압축하도록 바꾼 Responses API 하네스에서는 38.3%가 됐다. 같은 모델인데 점수는 약 2.9배가 됐고 출력 토큰은 6분의 1 수준으로 줄었다.
이 숫자는 새 모델 발표가 아니다. 평가 프로그램이 에이전트의 기억을 어떻게 넘기고 오래된 문맥을 어떻게 정리하는지가 결과를 바꾼 사례다. 벤치마크 순위를 읽을 때 모델명 옆에 하네스 설정도 함께 적어야 하는 이유가 여기에 있다.
ARC-AGI-3는 정답만 맞히는 시험이 아니다
ARC-AGI-3는 지시문 없이 낯선 2차원 게임을 탐색하게 한다. 에이전트는 매 턴 화면을 텍스트 격자로 받고 행동을 선택한다. 점수인 RHAE(Relative Human Action Efficiency)는 완료한 레벨 수와 사람 기준 대비 행동 효율을 함께 본다. ARC Prize 방법론에 따르면 도구 호출, 내부 추론, 재시도처럼 환경을 바꾸지 않는 작업은 행동 수에 포함되지 않는다.
사람 기준도 단순 평균이 아니다. 각 게임을 처음 해보는 참가자 여러 명 가운데 레벨별 행동 수의 상위 중앙값을 기준으로 삼는다. OpenAI는 공개 플레이 로그로 평균 참가자 점수를 약 48%로 추정했다. 38.3%가 사람을 넘었다는 뜻은 아니며, 서로 다른 하네스의 상대 차이를 읽는 데 더 적합한 수치다.
공식 하네스에서는 두 종류의 기억이 사라졌다
OpenAI 분석에 따르면 공식 하네스는 행동이 끝날 때마다 비공개 추론 메시지를 버렸다. 모델은 이전 행동과 짧은 메모를 볼 수 있었지만, 왜 그 행동을 골랐는지와 어떤 규칙을 의심했는지는 이어받지 못했다. 다음 턴마다 게임을 다시 해석하는 비용이 생긴 셈이다.
문맥이 17만5천 자를 넘으면 오래된 메시지부터 잘라내는 rolling truncation도 썼다. 실행이 길어질수록 초기 관찰과 시행착오가 사라졌다. 규칙을 한 번 알아낸 뒤 여러 레벨에 적용해야 하는 과제에서는 이 손실이 단순한 토큰 절약이 아니라 학습 기록 삭제가 된다.
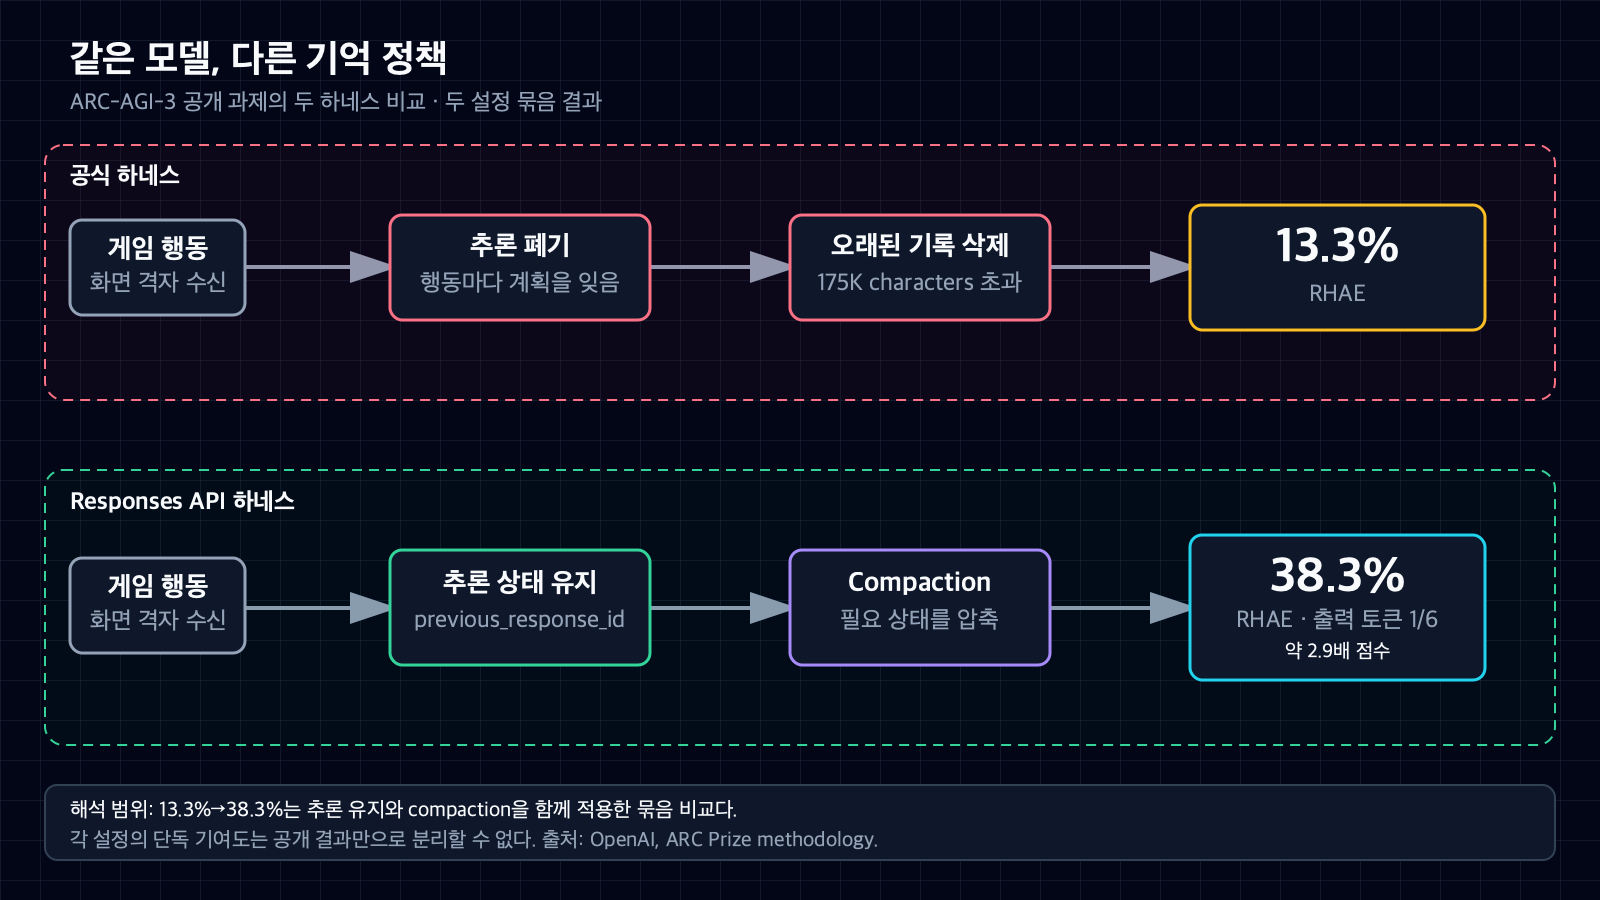
같은 GPT-5.6 Sol에서도 기억 정책이 달라지자 RHAE는 13.3%에서 38.3%로 올랐다. 두 설정을 함께 적용한 결과라 단독 기여도는 분리할 수 없다. 출처: openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores.
바뀐 것은 추론 유지와 compaction이었다
대체 하네스는 Responses API의 이전 응답 연결을 이용해 턴 사이 추론 상태를 유지했다. 모델이 직전 결론과 계획을 이어받으니 매 행동 전에 같은 규칙을 처음부터 다시 유도할 필요가 줄었다.
두 번째 변화는 오래된 내용을 통째로 버리는 대신 compaction으로 필요한 상태를 압축한 것이다. OpenAI 개발자 문서에서 server-side compaction은 설정한 토큰 임계치를 넘으면 실행되며, 다음 요청에 필요한 이전 상태와 추론을 사람이 읽기 위한 요약이 아닌 불투명한 압축 항목으로 넘긴다. previous_response_id를 쓰는 연결 방식에서는 클라이언트가 과거 항목을 임의로 잘라내지 말라고 문서에 적혀 있다.
그 결과 공개 과제 점수는 13.3%에서 38.3%로 올랐고 출력 토큰은 6배 줄었다. 긴 문맥을 더 많이 남겼는데 토큰이 줄어든 점이 흥미롭다. 기억을 유지하면 매 턴 재해석에 쓰는 추론이 줄고, compaction은 오래된 기록을 더 작은 상태로 넘긴다. 무작정 전체 대화를 붙이는 것과는 다른 접근이다.
이 결과로 두 설정의 기여도를 나눌 수는 없다
공개 글이 보여 주는 핵심 비교는 공식 하네스와 두 설정을 함께 적용한 하네스다. 추론 유지가 몇 점, compaction이 몇 점을 만들었는지 분리한 전체 ablation 표는 제공하지 않는다. 따라서 "compaction 하나로 25%포인트를 얻었다"고 말하면 근거를 넘는다.
또한 OpenAI가 자사 모델에 맞춘 하네스를 평가한 결과라는 점도 남는다. 공식 하네스는 모델별 특수 기능을 줄여 비교 가능성을 얻으려 했고, 제품 하네스는 실제 배포 성능을 끌어내려 했다. 어느 쪽이 유일하게 옳다기보다 질문이 다르다. 공통 하네스 점수는 동일 조건 비교에 가깝고, 최적화 하네스 점수는 특정 모델을 제대로 운용했을 때의 상한에 가깝다.
이번 수치와 6배 토큰 감소는 OpenAI의 공개 보고값이다. 이 글은 공식 ARC 방법론, 공개 사람 플레이 데이터셋 메타데이터, Responses API 문서를 대조했지만 두 하네스의 전체 실행 로그와 비용을 독립 재현하지는 않았다.
에이전트 평가에서는 기억 정책을 실험 변수로 남겨야 한다
첫째, 결과표에 모델명과 prompt만 쓰지 말고 상태 전달 방식을 적는다. 이전 응답 ID를 잇는지, 비공개 추론 항목을 유지하는지, 도구 결과를 어떤 형식으로 축약하는지가 필요하다.
둘째, 문맥 한도를 넘었을 때의 정책을 기록한다. 오래된 메시지 삭제, 최근 N턴 유지, 사람이 쓴 요약, 모델 기반 compaction은 서로 같은 처리가 아니다. 임계치도 함께 남겨야 재현 가능한 비교가 된다.
셋째, 점수와 토큰을 같이 본다. 이번 사례에서는 점수와 효율이 같은 방향으로 좋아졌지만 언제나 그렇지는 않다. 완료율, 행동 수, 입력·출력 토큰, 지연 시간, 실패 복구 횟수를 나누면 "더 많이 생각해서 오른 점수"와 "덜 잊어서 오른 점수"를 구별하기 쉬워진다.
넷째, 하네스 변경 전후에 작은 ablation을 둔다. 추론 유지 단독, compaction 단독, 둘의 조합을 같은 seed와 예산으로 돌려야 각 설정의 효과를 분리할 수 있다. 공급자가 조합 결과만 공개했다면 운영 참고 자료로는 쓸 수 있어도 독립적인 인과 결론으로 확대하지 않는 편이 안전하다.
실무 체크리스트
- 장기 작업에서 턴 사이에 보존해야 할 계획, 관찰, 미해결 가설을 먼저 정의한다.
- 대화가 길어질 때 삭제와 압축 중 무엇을 쓰는지, 발동 임계치는 얼마인지 기록한다.
- 재시도할 때 동일 상태를 이어받는지와 중복 행동이 생기는지 확인한다.
- 모델 비교 표에 API, 하네스 버전, prompt, 상태 전달, 문맥 정리 정책을 함께 적는다.
- 품질 점수와 입력·출력 토큰, 지연 시간, 행동 수를 별도 열로 관리한다.
- 제품 성능과 공통 벤치마크 성능을 같은 숫자로 섞지 않는다.
하네스는 모델 바깥의 배관처럼 보이지만, 장기 에이전트에게는 기억 장치의 일부다. 이번 결과가 말해 주는 범위도 그 정도가 정확하다. GPT-5.6 Sol이 갑자기 더 똑똑해진 것이 아니라, 이미 얻은 정보를 잃지 않도록 평가 환경이 바뀌었다.
이 글은 AI를 활용해 공개 자료를 정리하고 편집한 해설이다. 제품 사용 후기나 두 하네스의 독립 재현 보고서가 아니다.


댓글
댓글 쓰기