코딩 에이전트 하네스는 만능 설정이 아니었다: 176개 조건이 보여 준 설계의 조건부 효과
코딩 에이전트의 성능이 달라지면 보통 모델부터 의심합니다. 하지만 모델과 과제를 그대로 두고 계획 도구, 파일 편집 인터페이스, 대화 기록 압축 방식만 바꾸면 결과가 얼마나 달라질까요. 2026년 9월 17일 공개된 An Empirical Study of Harness Design for Coding Agents는 이 질문을 176개 조건으로 나눠 시험했습니다.
연구진은 Nemotron-3 30B·120B·550B와 Mistral Medium 3.5 128B를 SWE-Bench Verified 500개 과제와 Terminal-Bench 2.1의 89개 과제에 투입했습니다. 실행 루프와 안전장치는 고정한 채 세 요소만 바꿨습니다. 명시적 계획의 유무, 미리 정의한 파일 도구와 bash 전용 인터페이스의 차이, 그리고 다섯 단계 컨텍스트 관리 정책입니다.
결론은 "기능을 많이 넣을수록 좋다"가 아닙니다. 컨텍스트가 작을 때는 압축이 큰 차이를 만들었지만, 창이 넓어지면 효과가 줄었습니다. 계획은 약한 모델에서 성공률을 올리는 대신 비용을 늘렸고, 강한 모델에서는 성공률 변화가 작으면서 비용을 줄였습니다. 구조화 도구도 bash 숙련도가 낮은 모델에는 도움이 됐지만, bash를 잘 쓰는 모델에는 더 비싸고 느린 선택이 될 수 있었습니다.
같은 실행 루프에서 세 요소만 바꿨다
하네스는 모델을 실제 작업자로 만드는 소프트웨어 층입니다. 시스템 프롬프트를 조립하고, 도구 호출을 실행하며, 결과를 대화 기록에 붙이고, 컨텍스트가 길어졌을 때 무엇을 남길지 결정합니다. 연구진은 LangGraph 기반의 가벼운 하네스를 만들고 권한 검사, 읽기 전 쓰기 방지, 편집 후 진단, 반복 호출 감지는 모든 조건에서 동일하게 유지했습니다.
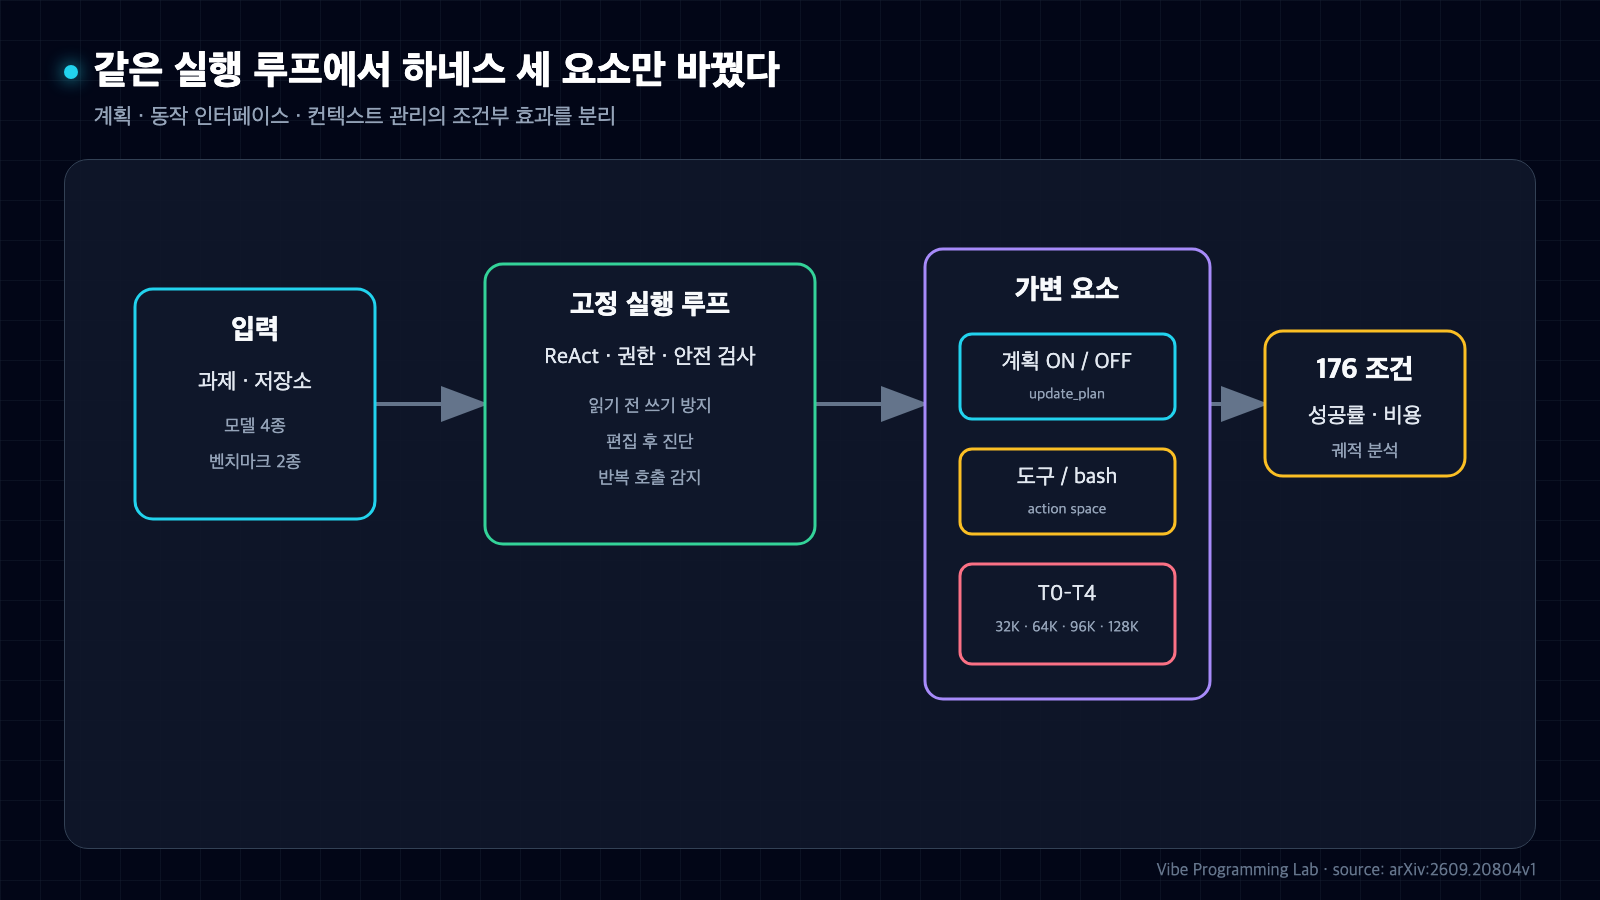
그림 1. 연구진은 실행 루프와 안전장치를 고정하고 계획·동작 인터페이스·컨텍스트 관리만 분리했다. 출처: arxiv.org/html/2609.20804v1.
계획 조건에서는 모델이 update_plan으로 진행 상황을 유지했고, 계획을 끈 조건에서는 관련 지시·도구·매 턴 주입을 모두 제거했습니다. 도구 조건은 read_file, edit_file, 검색, 웹 가져오기, bash가 있는 구조화 인터페이스와 bash 하나만 남긴 인터페이스를 비교했습니다. 따라서 결과는 "도구 개수" 하나의 효과가 아니라 지시문, 상태 추적, 읽기 전 쓰기 검사, 편집 후 진단까지 포함한 전체 인터페이스의 차이입니다.
컨텍스트 정책은 T0부터 T4까지 다섯 가지입니다. T0는 압축 없이 창을 넘으면 종료합니다. T1은 오래된 도구 출력을 짧은 표시로 바꿉니다. T2는 원문을 외부 저장소에 두고 recall_event로 되찾게 합니다. T3는 별도 모델 호출로 오래된 기록을 요약합니다. T4는 값싼 생략을 먼저 적용하고, 그래도 길면 요약하며, 원문 회수 경로도 둡니다.
컨텍스트 관리의 값은 창이 작을수록 컸다
32K 창에서 관리 정책 T1~T4의 평균 성공률은 T0보다 SWE-Bench에서 35.7%포인트, Terminal-Bench에서 9.5%포인트 높았습니다. 128K에서는 차이가 각각 2.7%포인트와 2.8%포인트로 줄었습니다. 모델이 갑자기 압축을 덜 필요로 하게 된 것이 아니라, 압축하지 않은 실행도 더 자주 창 안에 들어왔기 때문입니다.
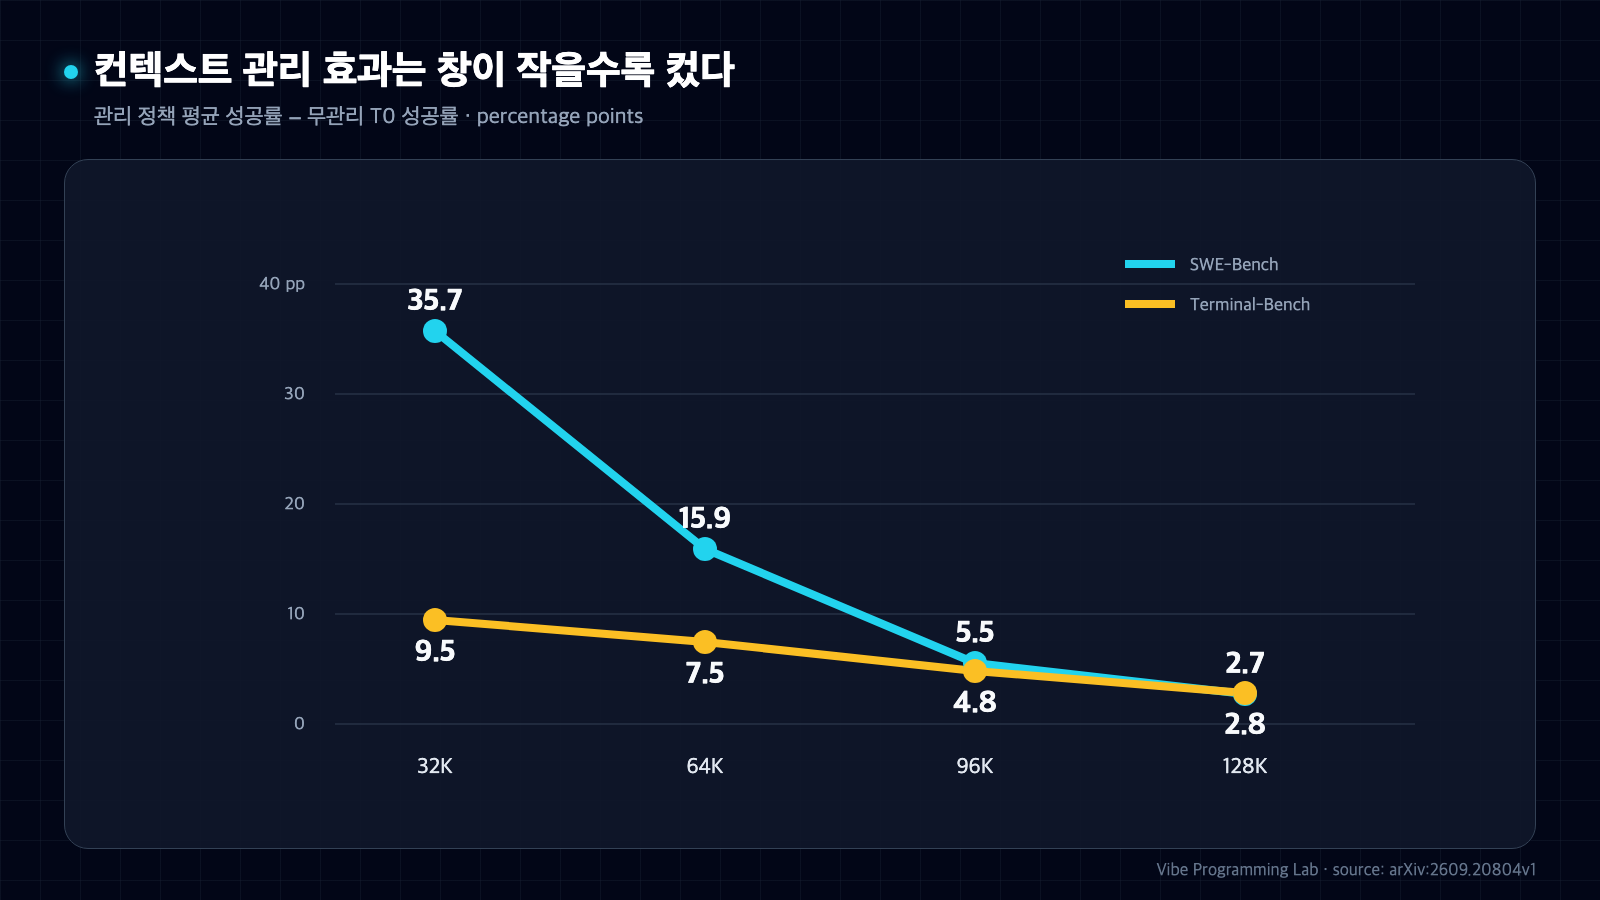
그림 2. 관리 정책의 평균 성공률 이득은 작은 컨텍스트 창에서 컸고 창이 커질수록 줄었다. 출처: arxiv.org/html/2609.20804v1.
T0의 컨텍스트 초과 종료율은 SWE-Bench에서 32K 78.7%에서 128K 8.7%로, Terminal-Bench에서는 61.0%에서 12.1%로 떨어졌습니다. 반면 관리 정책은 모든 창 크기에서 초과 종료가 0건이었습니다. 이 결과가 말하는 범위는 분명합니다. 압축은 작은 창에서 조기 종료를 막는 데 강하지만, 큰 창에서도 항상 정확도를 크게 높인다는 증거는 아닙니다.
다섯 정책 중 T4는 여덟 개 모델·벤치마크 조합 가운데 일곱 곳에서 관리 정책 최저 비용을 기록했습니다. 오래된 큰 출력을 먼저 규칙으로 줄였기 때문에 비싼 요약 호출까지 가는 횟수가 적었습니다. 성공률은 다른 관리 정책과 비슷했습니다. 비싼 지능형 압축을 첫 단계로 쓰기보다 결정적인 생략을 앞에 두는 편이 효율적이었다는 뜻입니다.
되찾을 수 있는 기억은 거의 호출되지 않았다
T2와 T1의 차이는 생략한 원문을 다시 읽을 수 있느냐입니다. 그 기능은 그럴듯하지만, 32개 대응 비교에서 T2는 T1보다 15개 조건에서 높고 14개에서 낮았으며 3개는 같았습니다. 동일 가중 평균 차이는 -0.36%포인트였습니다.
더 중요한 것은 실제 사용량입니다. T2와 T4를 합친 64개 조건 중 36개, 56.3%에서는 recall_event가 한 번도 호출되지 않았습니다. 과제당 평균 호출은 32K에서 0.540회였지만 64K 0.069회, 96K 0.011회, 128K 0.007회로 급감했습니다. 저장과 회수 장치를 추가하는 것만으로 모델이 적절한 순간에 그것을 쓰지는 않았습니다.
이 결과를 "장기 기억은 쓸모없다"로 넓히면 안 됩니다. 이 실험의 회수 대상은 하네스가 생략한 과거 도구 출력이며, 검색 정책도 recall_event(id)라는 특정 인터페이스입니다. 다른 메모리 표현이나 자동 검색은 별도 문제입니다. 여기서 확인된 것은 이 회수 장치가 생략 단독보다 정확도를 꾸준히 높이지 못했다는 사실입니다.
계획과 도구의 효과는 모델 능력에 따라 뒤집혔다
128K와 T4를 고정하고 계획만 끈 비교에서 Nemotron-3 30B는 계획을 사용할 때 SWE-Bench 성공률이 11.6%포인트, Terminal-Bench가 4.5%포인트 높았습니다. 약한 모델에서는 계획이 실행을 코드 수정 단계까지 이어 주는 발판이었습니다. 그 대가로 턴 수와 도구 호출, 입력 토큰, 비용이 늘었습니다.
반면 Nemotron-3 550B와 Mistral Medium 3.5에서는 계획이 두 벤치마크 모두 비용을 줄였습니다. SWE-Bench 비용은 각각 약 30%, 32% 감소했고 성공률은 2.0%포인트, 0.4%포인트 낮아졌습니다. 연구진의 궤적 분석에서는 줄어든 부분이 주로 편집 후 반복 검증이었습니다. 같은 계획 기능이 약한 모델에는 더 오래 일하게 하는 장치, 강한 모델에는 불필요한 후반 작업을 줄이는 장치로 작동한 셈입니다.
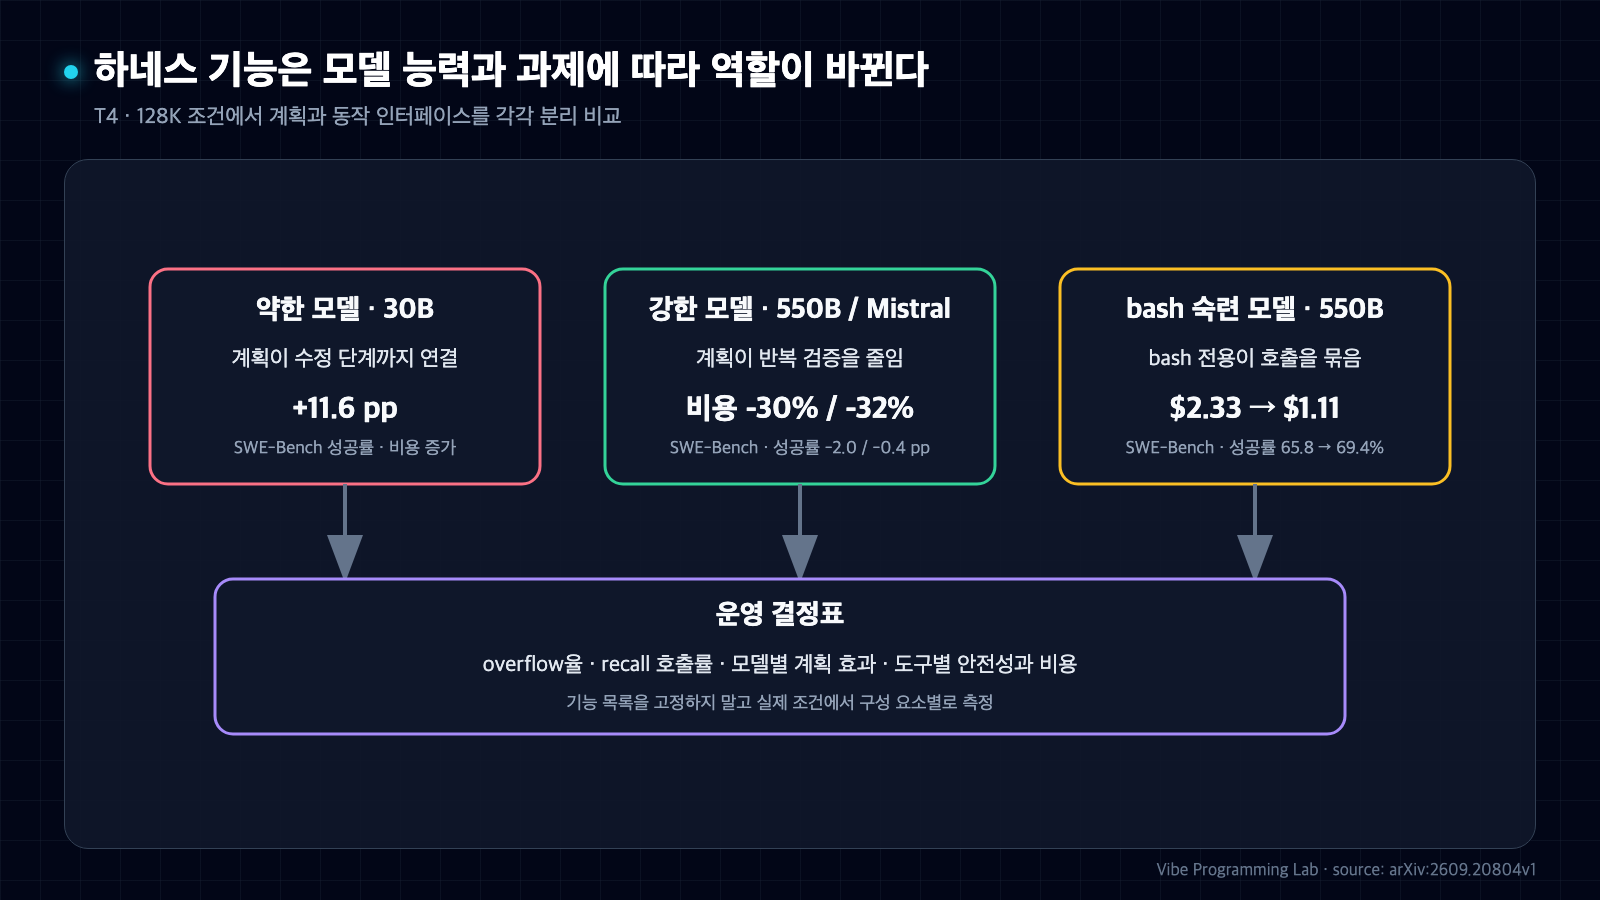
그림 3. 같은 기능도 모델 능력과 셸 숙련도에 따라 정확도 보조·비용 절감·호출 묶음이라는 다른 역할을 했다. 출처: arxiv.org/html/2609.20804v1.
구조화 도구도 조건부였습니다. SWE-Bench에서 bash 전용으로 바꾸자 30B는 25.2%에서 10.2%로 떨어졌고, Mistral은 68.6%에서 45.4%로 떨어졌습니다. 반면 550B는 65.8%에서 69.4%로 올랐고 비용은 과제당 2.33달러에서 1.11달러로 줄었습니다. Terminal-Bench에서도 550B는 bash 전용에서 44.94%에서 50.56%로 오르고 비용은 2.43달러에서 1.70달러로 줄었습니다. 셸 명령을 여러 작업으로 묶는 능력이 충분하면 도구 스키마가 오히려 호출 단위를 잘게 만들 수 있습니다.
운영에서는 기능 목록보다 조건표가 먼저다
이 연구를 제품 설정으로 옮길 때는 "최고의 하네스"를 찾기보다 조건표를 만드는 편이 낫습니다. 첫째, 실제 창 크기에서 context overflow가 얼마나 발생하는지 측정합니다. 초과가 거의 없다면 복잡한 요약 파이프라인의 정확도 이득은 작을 수 있습니다. 둘째, 생략한 정보를 되찾는 기능은 존재 여부가 아니라 호출률과 성공 기여도를 기록해야 합니다.
셋째, 계획 도구는 모델 등급별로 따로 평가해야 합니다. 약한 모델에서 성공률을 올린 설정이 강한 모델에서는 비용 최적화로 작동할 수 있고, 중간 모델에서는 과제에 따라 방향이 달라졌습니다. 넷째, 구조화 도구와 bash를 안전성·성공률·비용으로 나눠 봐야 합니다. bash 전용이 싸더라도 권한 경계, 경로 보호, 읽기 전 쓰기 검사 같은 안전장치까지 없애서는 안 됩니다.
실험의 숫자를 그대로 자기 환경의 예상값으로 쓰기도 어렵습니다. 모델은 네 개뿐이고, 세 모델은 같은 Nemotron 계열입니다. 모든 모델은 로컬 SGLang BF16, 온도 0, 최대 300스텝 조건에서 실행됐습니다. 계획과 도구 ablation은 128K·T4에서만 이뤄졌고 각 설정은 과제당 한 번 실행됐습니다. Terminal-Bench는 89개라 다수의 개별 비교가 보정된 유의성 문턱을 넘지 못했습니다. 비용도 2026년 8월 OpenRouter 가격으로 계산했으므로 이후 가격이나 자체 호스팅 환경에는 그대로 적용되지 않습니다.
실행 궤적의 단계 분류에는 GPT-5.5 judge가 쓰였습니다. 연구진은 200개 궤적의 15,610개 라벨을 세 명의 사람 판정과 대조해 전체 약 94.2% 일치율과 가중 Cohen의 카파 0.929를 보고했습니다. 높은 일치율은 분석을 지지하지만, 궤적 설명이 전부 규칙 기반 측정이라는 뜻은 아닙니다.
이번 연구에서 남는 질문
저자 저장소 링크는 논문 첫 버전에서 확인되지 않았습니다. 논문은 프롬프트와 도구 설명, 세부 표를 부록에 공개하지만, 독립 재실행 코드와 원시 궤적을 곧바로 내려받아 검증할 수 있는 형태는 아닙니다. 따라서 이 글의 수치는 논문 표와 본문을 교차 확인한 결과이며, 별도의 모델 재실행이나 독립 재채점 결과가 아닙니다.
그럼에도 설계 판단에 쓸 만한 기준은 분명합니다. 컨텍스트 관리는 작은 창에서 overflow를 막는 문제로, 계획은 모델 능력에 따른 실행 길이와 비용 문제로, 도구 인터페이스는 셸 숙련도와 안전 장치의 문제로 나눠 봐야 합니다. 하네스 기능을 한 묶음으로 비교하면 이 조건부 효과가 사라집니다. 구성 요소를 하나씩 떼어 같은 모델과 같은 과제에서 비교해야 어떤 기능이 실제로 값을 만드는지 알 수 있습니다.


댓글
댓글 쓰기