재시도 2번을 세 군데 넣었더니 요청은 18번이 됐다: AI 에이전트 재시도 예산 설계
AI 에이전트가 일시적인 429나 네트워크 오류를 견디게 하려고 재시도를 켜는 일은 자연스럽다. 출력 검증에 두 번, 모델 SDK에 두 번, HTTP 전송에 두 번을 각각 허용하면 얼핏 여섯 번쯤 시도할 것처럼 보인다. 실제 최악의 경우는 18번이다. 세 설정이 같은 카운터를 나눠 쓰지 않고 서로를 감싸기 때문이다.
Pydantic AI가 9월 1일 병합한 공식 재시도 가이드 보강은 이 문제를 일곱 층으로 정리했다. 이 변경은 기능 릴리스가 아니라 문서 PR #7966이다. 새 API가 생긴 것은 아니지만, 운영자가 비용과 지연을 계산하는 방식에는 꽤 직접적인 영향을 준다. 핵심은 "재시도 횟수"라는 한 숫자를 찾는 게 아니라, 어느 층이 무엇을 다시 실행하는지 따로 세는 것이다.
요약: 재시도는 합이 아니라 곱으로 쌓인다
가이드가 구분하는 층은 transport, provider SDK, durable execution, model fallback, tool, output, model-request hook이다. 아래쪽의 transport와 SDK는 같은 HTTP 요청을 다시 보낸다. 위쪽의 tool·output·hook은 모델에게 수정된 메시지를 보내므로 새로운 모델 요청을 만든다. durable execution은 모델 요청 단계 전체를 다시 실행하고, fallback은 같은 모델을 재호출하는 대신 다른 모델로 넘어간다.
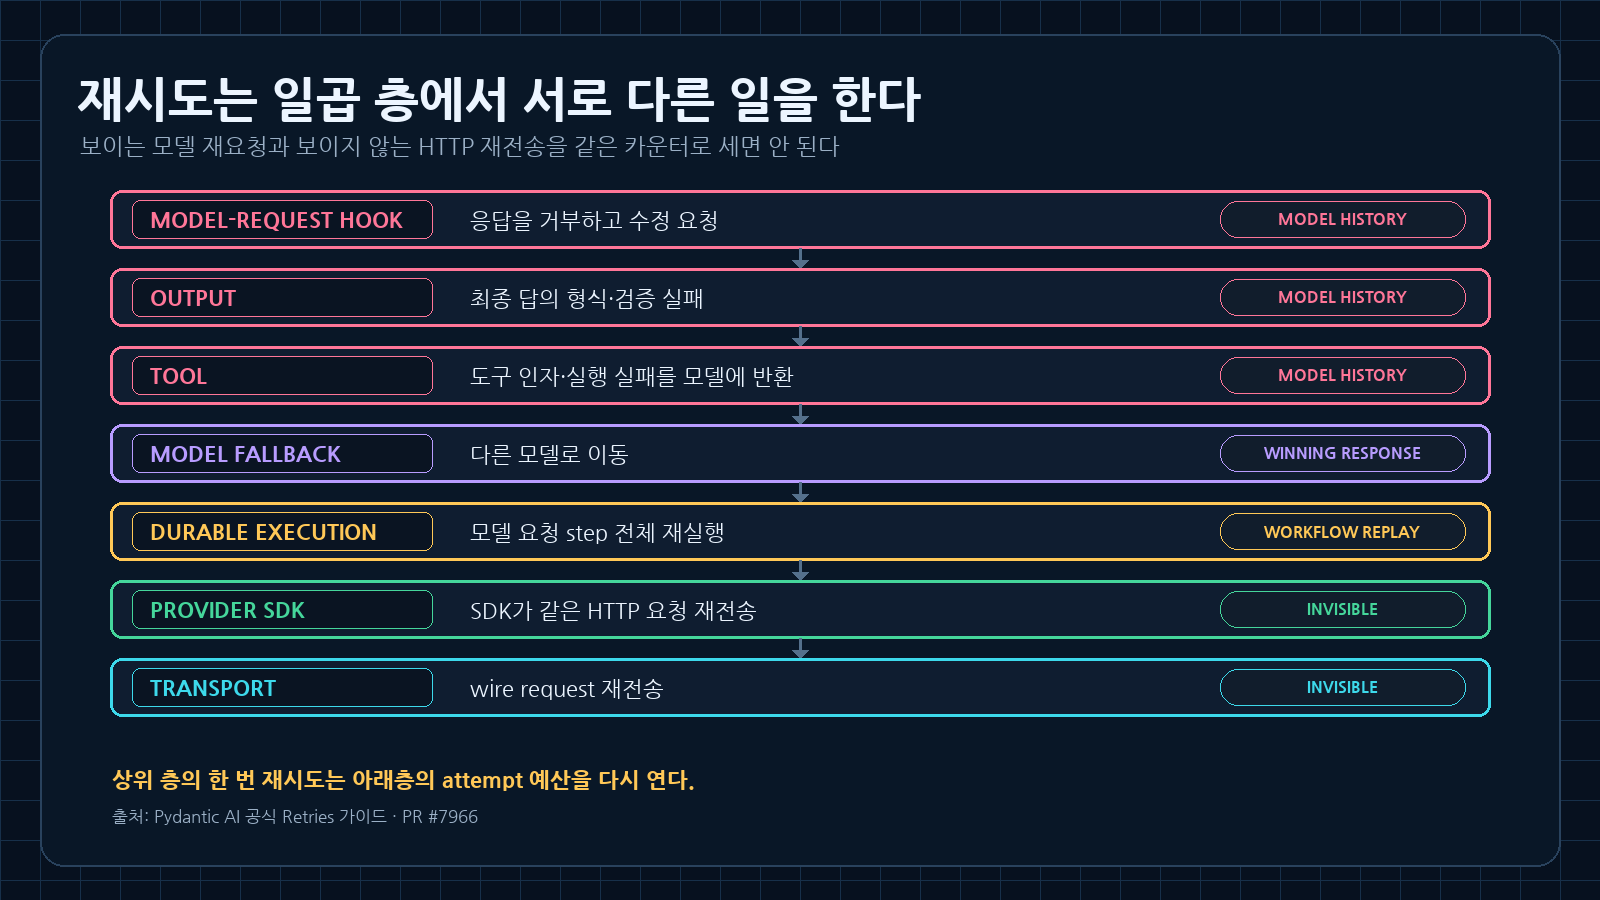
상위 agent 재시도는 새 모델 요청을 만들고, 하위 SDK·transport 재시도는 같은 요청을 모델에게 보이지 않게 재전송한다. 출처: ai.pydantic.dev/retries.
이 구분이 필요한 이유는 관찰 지점이 다르기 때문이다. 에이전트의 message history에는 tool·output·hook 재시도가 RetryPromptPart로 남지만, SDK와 transport의 내부 시도는 보이지 않는다. UsageLimits.request_limit도 모델 요청 수만 세며 그 아래에서 늘어난 wire request는 세지 않는다. 에이전트 로그에 요청이 세 번 보였다고 해서 네트워크 요청도 세 번이었다고 결론 내리면 안 된다.
3 × 3 × 2가 만들어 내는 18번
Pydantic AI 문서는 최악의 wire request 수를 N × M × K로 설명한다. N은 한 논리 호출에서 생기는 모델 요청 수다. 최초 요청뿐 아니라 성공한 도구 호출 뒤의 후속 모델 요청, tool·output 검증 실패가 만든 재요청도 여기에 들어간다. M은 provider SDK가 모델 요청 하나를 보내려 한 총 횟수다. K는 transport가 wire request 하나를 다시 보낸 총 횟수다.
문서의 예시는 retries={'output': 2}로 최종 답을 최대 세 번 요청하고, OpenAI SDK의 기본 max_retries=2로 요청마다 최대 세 번 시도하며, transport의 stop_after_attempt(2)로 각 시도를 최대 두 번 전송한다. 결과는 3 × 3 × 2 = 18이다. 여기서 이름도 주의해야 한다. OpenAI의 max_retries=2는 최초 시도에 재시도 두 번을 더해 총 세 번이고, Tenacity의 stop_after_attempt(2)는 총 시도 횟수가 두 번이다.
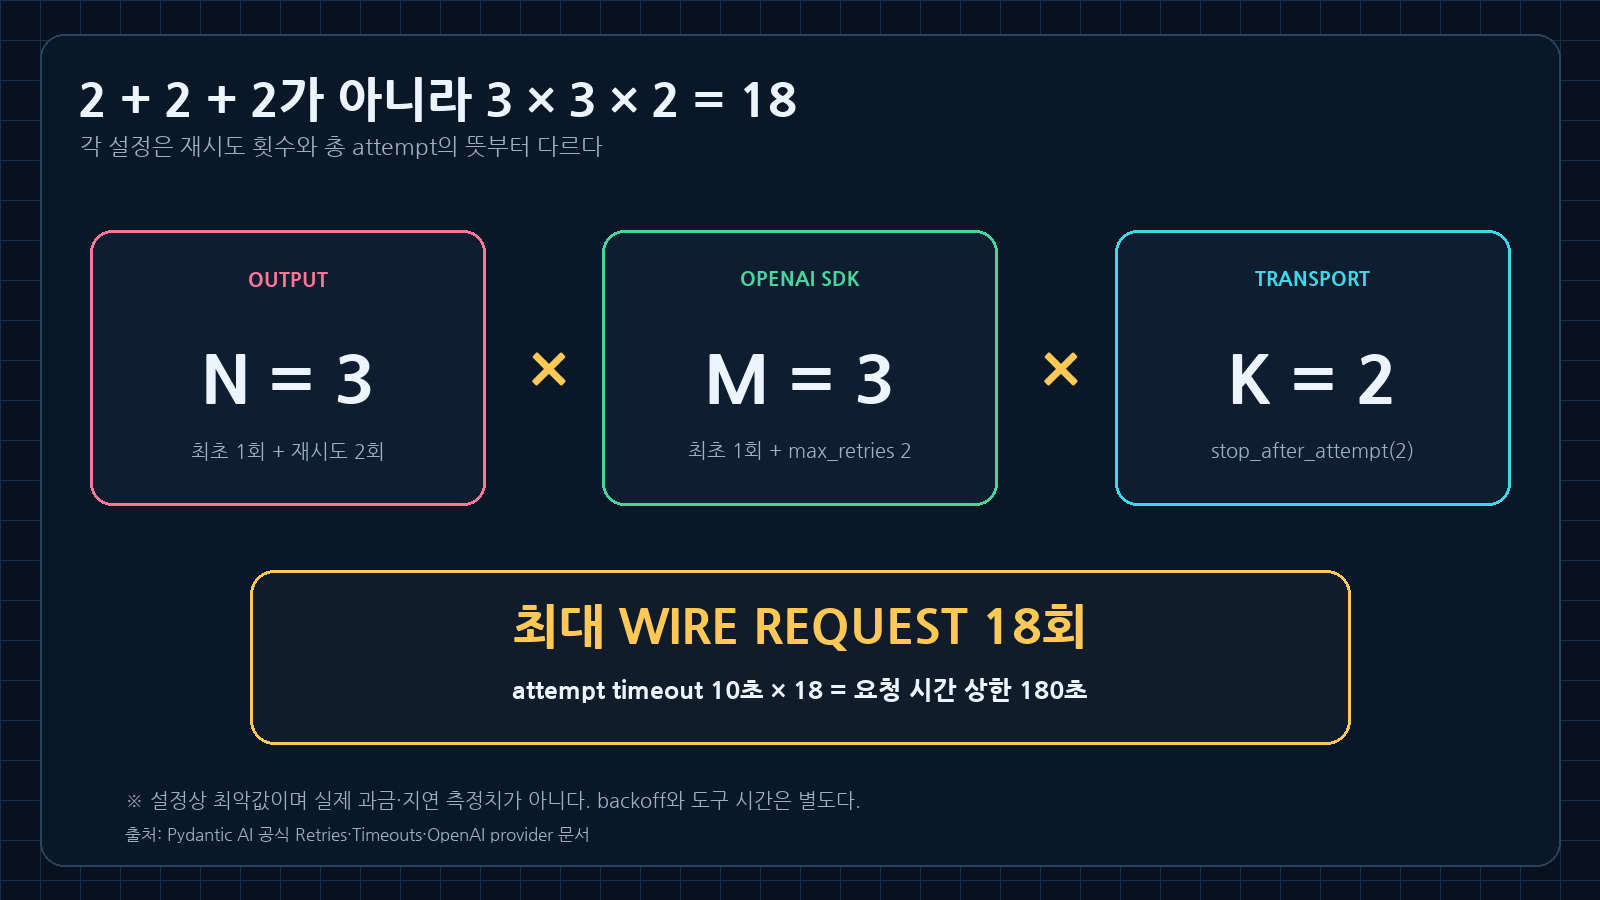
서로 독립된 retry budget은 더하지 않고 곱한다. 18회와 180초는 설정상 최악값이며 실제 과금·지연 측정치가 아니다. 출처: ai.pydantic.dev/retries.
모든 요청이 모델까지 도달해 과금된다는 뜻은 아니다. 연결 단계에서 실패한 요청은 토큰을 소비하지 않을 수 있다. 반대로 공급자가 요청을 처리한 뒤 응답만 유실되면 같은 입력이 다시 처리될 수 있다. 그래서 비용 상한과 side effect 위험은 단순 HTTP 상태 코드 집계보다 provider request ID, 모델 사용량, 도구의 멱등 키를 함께 봐야 한다.
timeout 10초가 전체 10초 제한은 아니다
같은 문서는 ModelSettings.timeout이 전체 실행 시간이 아니라 개별 model request attempt에 적용된다고 설명한다. 위의 18회 구성에서 각 attempt의 timeout이 10초라면 요청 시간만 최악 180초다. 여기에 지수 backoff와 Retry-After 대기, 도구 실행 시간까지 더해질 수 있다. 일부 모델 클래스는 이 설정을 provider client로 전달하지 않으므로 실제 적용 여부도 모델별 문서에서 확인해야 한다.
Pydantic AI에는 run 전체 wall-clock을 한 번에 제한하는 내장 설정이 없다. 공식 timeout 가이드는 Python 3.11 이상의 asyncio.timeout()이나 anyio.fail_after()로 agent.run() 바깥을 감싸는 방법을 안내한다. 다만 외부 timeout으로 취소했다고 원격 요청이나 동기 함수 도구가 즉시 멈춘다고 가정해서는 안 된다. 취소 뒤 상태를 조회하고, 재개할 수 있는 history와 이미 실행된 side effect를 따로 reconcile해야 한다.
Temporal 같은 durable execution을 얹으면 범위는 더 넓어진다. workflow engine이 model request step 전체를 다시 실행하므로 SDK와 transport 예산도 다시 시작한다. Pydantic AI 문서는 Temporal의 maximum_attempts=0을 기본 무제한으로 적고 있다. 장기 실행 에이전트에서는 workflow 재시도 상한과 provider 재시도를 별도 설정하지 않으면 일시 장애가 예상보다 긴 재실행으로 번질 수 있다.
tool 재시도는 네트워크 재전송과 다르다
도구 인자 검증 실패나 ModelRetry는 같은 HTTP 요청을 복제하지 않는다. 실패 이유를 담은 RetryPromptPart를 모델에게 보내 새 답을 요구한다. 따라서 지연과 토큰뿐 아니라 대화 상태도 바뀐다. 도구별 카운터는 도구 이름으로 나뉘고 성공하면 초기화된다. 기본 예산 1은 첫 실패 뒤 한 번 더 기회를 준다는 뜻이다.
여기에도 의외의 경계가 있다. 모델이 존재하지 않는 도구 이름을 만들면 그 이름에 별도 재시도 예산이 생긴다. 매번 다른 가짜 이름을 내놓는 모델은 이름별 카운터를 새로 받을 수 있다. 결국 run 전체는 UsageLimits나 바깥 deadline으로 한 번 더 묶어야 한다. 개별 도구의 retry 설정만으로 무한에 가까운 상호작용을 막았다고 생각하면 위험하다.
반대로 ToolFailed는 실패한 tool result를 기록하되 재시도 예산을 소비하지 않는다. 모델이 그 결과를 보고 다른 행동을 고를 수 있으므로, "다시 같은 도구를 불러라"와 "이 도구는 실패했다"를 구분할 때 쓸 수 있다. 일시 오류에는 제한된 ModelRetry, 반복해도 달라지지 않을 업무 오류에는 ToolFailed가 더 맞다.
실전 적용: 예산표를 코드 옆에 둔다
먼저 provider SDK 한 곳을 재시도의 주인으로 정한다. OpenAI client와 별도 retrying transport를 함께 쓴다면 SDK의 max_retries=0으로 끄고 transport에서 429·5xx·connection error와 Retry-After를 다루거나, 반대로 transport 재시도를 끄고 SDK 정책만 사용한다. 둘을 같이 유지해야 한다면 곱한 최악값을 명시한다.
다음으로 의미가 다른 실패를 분리한다. HTTP 429와 connection reset은 같은 요청을 다시 보내는 transport·SDK 영역이다. 잘못된 tool argument와 output schema 위반은 모델이 내용을 수정해야 하는 agent 영역이다. 공급자 장애 시 다른 모델로 넘어가는 fallback은 재시도 횟수에 섞지 말고, 출력 차이와 비용을 별도 평가한다.
운영 설정에는 최소 다섯 값을 함께 적는 편이 안전하다. 한 run의 model request 상한, SDK 총 attempt, transport 총 attempt, attempt별 timeout, run 전체 deadline이다. durable workflow를 쓴다면 step 최대 attempt도 추가한다. 배포 전 fault injection으로 429, timeout, 500, 잘못된 tool argument를 각각 넣고 실제 wire request 수와 총 시간을 측정한다.
마지막으로 쓰기 도구에는 멱등 키를 붙인다. 메일 전송, 결제, 게시, 티켓 생성처럼 서버가 처리한 뒤 응답만 사라질 수 있는 작업은 "timeout이 났으니 실패"로 볼 수 없다. 재시도 전에 원격 상태를 조회하고 같은 키의 결과가 있으면 기존 ID를 재사용해야 한다. 재시도 예산은 가용성을 높이는 장치이지 중복 side effect를 자동으로 막아 주는 장치가 아니다.
범위와 주의점
이번 근거의 중심은 Pydantic AI 공식 문서와 2026년 9월 1일 병합된 문서 PR이다. N × M × K는 설정상 가능한 상한을 설명하는 식이지, 모든 실행이 18회 네트워크 요청이나 180초 지연을 실제로 만든다는 측정 결과가 아니다. 오류 종류, SDK의 retryable 조건, backoff, 서버 처리 여부에 따라 실제 값은 작아진다.
provider SDK 기본값도 버전별로 달라질 수 있다. 이 글의 OpenAI 예시는 Pydantic AI 문서가 현재 명시한 기본 max_retries=2를 사용했다. Google, Anthropic, Groq, Cohere, Bedrock은 각 SDK의 설정과 기본 동작을 확인해야 한다. Pydantic AI v2.37.0 릴리스보다 PR #7966이 늦게 병합됐으므로, 이를 v2.37.0의 새 기능이라고 부르면 안 된다.
그래도 설계 원칙은 간단하다. 재시도 설정을 한 줄씩 보지 말고 호출 그래프로 그린다. 각 층의 총 attempt와 timeout을 곱해 최악값을 계산하고, run 바깥 deadline과 멱등성을 별도로 둔다. 실패를 견디려고 넣은 재시도가 비용 폭증과 중복 실행의 새 원인이 되지 않게 만드는 최소한의 계산이다.
참고 자료
- https://github.com/pydantic/pydantic-ai/pull/7966
- https://ai.pydantic.dev/retries/
- https://ai.pydantic.dev/models/http-request-retries/
- https://ai.pydantic.dev/models/openai/#custom-openai-client
- https://ai.pydantic.dev/timeouts/
- https://github.com/pydantic/pydantic-ai/releases/tag/v2.37.0


댓글
댓글 쓰기