2,226편을 에이전트로 다시 검증해보니: 논문 재현의 새 병목
논문을 읽는 속도보다 논문이 쌓이는 속도가 빠르다. ICML 2026 Open Reproductions 참가자들은 이 문제를 정면으로 시험했다. 1,221명이 각자 코딩 에이전트를 가져와 19일 동안 2,226편의 논문을 대상으로 6,816개 재현 로그북을 공개했다. 자동 심사기가 내린 주장 단위 판정은 35,908건이다.
이 숫자를 "AI가 논문 3분의 1을 검증했다"로만 읽으면 중요한 부분을 놓친다. 에이전트는 실험 규모를 키웠지만 잘못된 단위 비교, 너무 짧은 실행, 접근할 수 없는 데이터 때문에 스스로 틀리기도 했다. 결국 병목은 코드를 쓰는 시간에서 증거를 판정하고 반례를 다시 확인하는 시간으로 옮겨갔다.
40쪽 논문을 바로 재현하지 않았다
운영진은 ICML 2026 채택 논문 6,341편을 색인하고, 각 논문의 핵심 주장을 에이전트가 확인할 수 있는 단위로 추출했다. 참가자는 논문 하나를 고른 뒤 Claude Code, Codex, Cursor, OpenResearch 같은 도구로 코드 작성과 실험을 진행했다. 같은 논문을 여러 팀이 다시 다루는 것도 허용했다.
결과물은 성공 여부 한 줄이 아니었다. Trackio 로그북에 설명, 실행 코드, 산출물, 선택적으로 전체 에이전트 추적을 남겼다. 그다음 GLM-5.2 기반 Logbook Judge가 각 주장을 verified, falsified, toy, inconclusive로 분류했다. 로그북 작성자의 자기평가는 믿지 말라는 지침도 따로 줬다. 실험을 자동화하면서도 감사 흔적을 남기려 한 설계다.
공개 판정 35,908건을 다시 세어봤다
공개된 verdicts_final.json을 직접 집계하면 주장 판정은 정확히 35,908건이다. verified 17,167건(47.81%), falsified 1,699건(4.73%), toy 7,617건(21.21%), inconclusive 9,425건(26.25%)으로 합계가 맞는다. 이 비율은 서로 다른 로그북의 주장 판정 건수를 센 값이다. 고유 논문 성공률이나 학계 전체의 재현률로 바꾸어 말할 수는 없다.
공식 글의 논문 단위 집계에서는 조사된 논문 중 1,103편이 하나 이상의 주장을 검증했고, 496편은 하나 이상의 주장이 반박되거나 팀 사이 판정이 충돌했다. 242편은 같은 주장에 반대 결과가 나왔다. 또 502편은 축소된 toy 증거만 있었고 280편은 결론을 내리지 못했다. "재현 성공/실패" 두 칸만으로는 이 상태를 담기 어렵다.
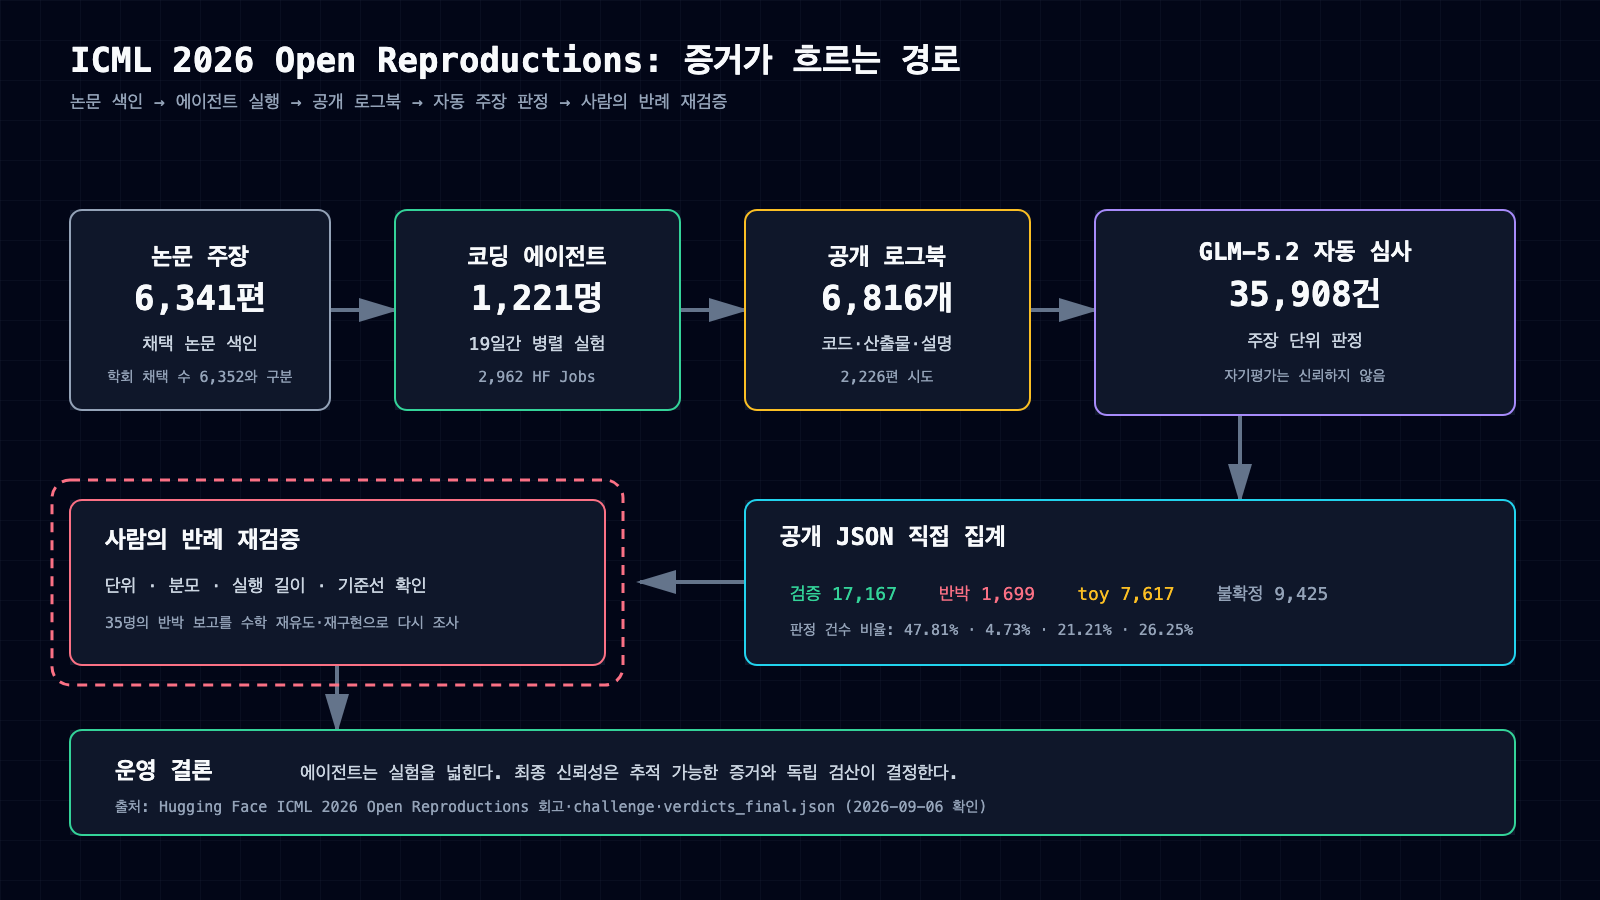
에이전트는 재현 실험의 폭을 넓혔지만, 자동 판정 뒤에도 단위·분모·실행 길이·기준선을 사람이 다시 확인해야 했다. 출처: huggingface.co/blog/icml-2026-open-reproductions.
반례보다 반례 검증이 더 어려웠다
참가자 35명이 무언가를 반박했다고 공식 보고했다. 운영진은 이 주장을 그대로 채택하지 않고 논문과 로그북을 다시 읽고, 수학을 다시 유도하거나 실험을 재구현했다. 이 두 번째 검토가 없었다면 재현 실험의 오류가 원 논문의 오류로 기록될 수 있었다.
실제로 한 로그북은 논문 방법이 기준선보다 두 배 느리다고 썼다. 원인은 궤적 하나의 시간과 50개 배치 시간을 비교한 산술 오류였다. 단위를 맞추자 같은 데이터가 오히려 논문의 8배 속도 향상을 뒷받침했다. 에이전트가 낸 반례도 독립적인 검산 대상이라는 뜻이다.
반대로 짧은 실험이 결함을 숨긴 사례도 있었다. Attention's forward pass and Frank-Wolfe의 반례는 224, 약 3,800, 6,416단계에서 처음 나타났다. 종료 시점을 짧게 잡은 실험은 주장을 검증한 것처럼 보였다. 실행 성공과 충분한 탐색 범위는 다른 조건이다.
자동 판정도 측정기의 일부다
35,908건의 판정은 공개됐지만 최종 심사기는 GLM-5.2 한 모델이다. 따라서 이 데이터에는 원 논문의 진위뿐 아니라 주장 추출 방식, 로그북 품질, 심사 프롬프트와 모델의 판단 특성도 함께 들어 있다. verified가 동료평가를 대체하지 않고, inconclusive가 논문의 오류를 뜻하지도 않는다.
자료 스냅샷도 구분해야 한다. 공식 글은 6,816개 공개 로그북과 2,226편 시도를 보고한다. 현재 내려받은 최종 판정 JSON에는 6,885개 로그북 키가 있다. 총 판정 수 35,908건은 공식 글과 일치하지만 레코드 수는 다르다. 마감 뒤 포함 범위나 필터가 달라졌을 가능성이 있으므로, 두 숫자를 억지로 하나로 맞추지 않았다. 또 공식 글은 채택 수를 한 곳에서는 6,352편, 실제 색인 수는 6,341편이라고 적는다. 여기서는 재현 시스템에 들어간 색인 수와 학회 전체 채택 수를 분리해 썼다.
사람은 실행자가 아니라 조사 설계자가 됐다
사람이 맡은 일은 결과를 눈으로 한 번 보는 정도가 아니었다. 어떤 주장을 확인할지 정하고, 데이터와 체크포인트가 없을 때 toy 실험의 범위를 제한하고, 장기 실행에서 반례가 나타날 시간을 정하고, 단위와 기준선을 검산해야 했다.
이미지 생성 양자화 연구 사례에서는 수치 지표만으로 결과물이 쓸 만한지 결정할 수 없었다. 참가자가 검토 UI를 만들고 사람이 128개 이미지 쌍을 판단한 뒤 에이전트가 주석의 일관성을 검사했다. 자동 실행과 사람 판정을 섞되, 누가 어떤 결정을 했는지 추적 가능하게 남긴 방식이다.
팀에서 재현 에이전트를 쓸 때 확인할 것
- 논문의 결론 전체가 아니라 수치와 조건이 명확한 주장부터 작업 단위로 만든다.
- 성공/실패 외에 축소 실험, 자료 부족, 판정 충돌 상태를 따로 둔다.
- 실행 환경, 코드, 데이터 버전, 명령, 로그와 산출물 해시를 함께 보관한다.
- 반례가 나온 경우 단위, 분모, 배치 크기, 시간 범위와 기준선을 사람이 다시 확인한다.
- 자동 심사 모델의 이름과 버전, 프롬프트, 판정 시각을 결과에 묶는다.
- 여러 팀이 같은 주장을 확인했을 때 일치율뿐 아니라 반대 판정의 원인도 조사한다.
- 최종 결론은 원 저자에게 전달하고 수정 버전이나 반론을 같은 기록에 연결한다.
이 작업은 규모 면에서 인상적이지만, ICML 2026 전체를 동일한 깊이로 독립 재현한 프로젝트는 아니다. 비공개 데이터와 체크포인트가 없는 논문은 toy 실험에 머물렀고, 공개 판정은 자동 심사기에 의존한다. 이 글은 공개된 Hugging Face 글, challenge 파일, 최종 판정 JSON을 AI로 정리하고 수치를 다시 집계한 해설이다. 개별 논문의 실험을 전부 재실행한 보고서나 제품 사용 후기가 아니다.


댓글
댓글 쓰기