오답 250개 중 모델 탓은 12개였다: 물리 벤치마크를 다시 채점한 결과
낮은 점수가 곧 낮은 능력은 아니다
AI 벤치마크 점수는 대개 한 줄로 소비된다. 47%면 부족하고 90%면 거의 해결됐다고 읽기 쉽다. 하지만 문제, 정답, 채점기 중 하나라도 잘못되면 점수는 모델 능력과 다른 것을 잰다. 모델이 좋아질수록 이 오차가 더 눈에 띈다. 실제 모델 오답이 줄어든 뒤에는 벤치마크 결함이 남은 실패의 큰 몫을 차지하기 때문이다.
9월 11일 공개된 논문 How Good Are Frontier Models at Physics?는 이 문제를 물리 벤치마크 여섯 개에서 조사했다. 연구진은 GPT-5.6-Sol, Claude Fable 5, Gemini 3.1 Pro의 답을 기존 절차로 채점한 다음, 물리 전공 교수와 대학원 연구자가 문제·참조 답안·모델 답·채점 결과를 다시 읽게 했다. 대상은 이미지 없이 텍스트로 풀 수 있고 최종 답을 검증할 수 있는 문항이었다.
결과는 꽤 크다. HLE-Physics에서 GPT-5.6-Sol High의 mean@4는 47.28%에서 78.66%로 올라갔다. CMT-Benchmark에서는 61.00%가 87.24%가 됐다. 모델을 다시 학습한 결과가 아니다. 잘못된 참조 답을 고치고, 모호한 문제를 수리하거나 제외하고, 동치인 답을 틀렸다고 처리한 채점 오류를 바로잡은 뒤 다시 계산한 값이다.
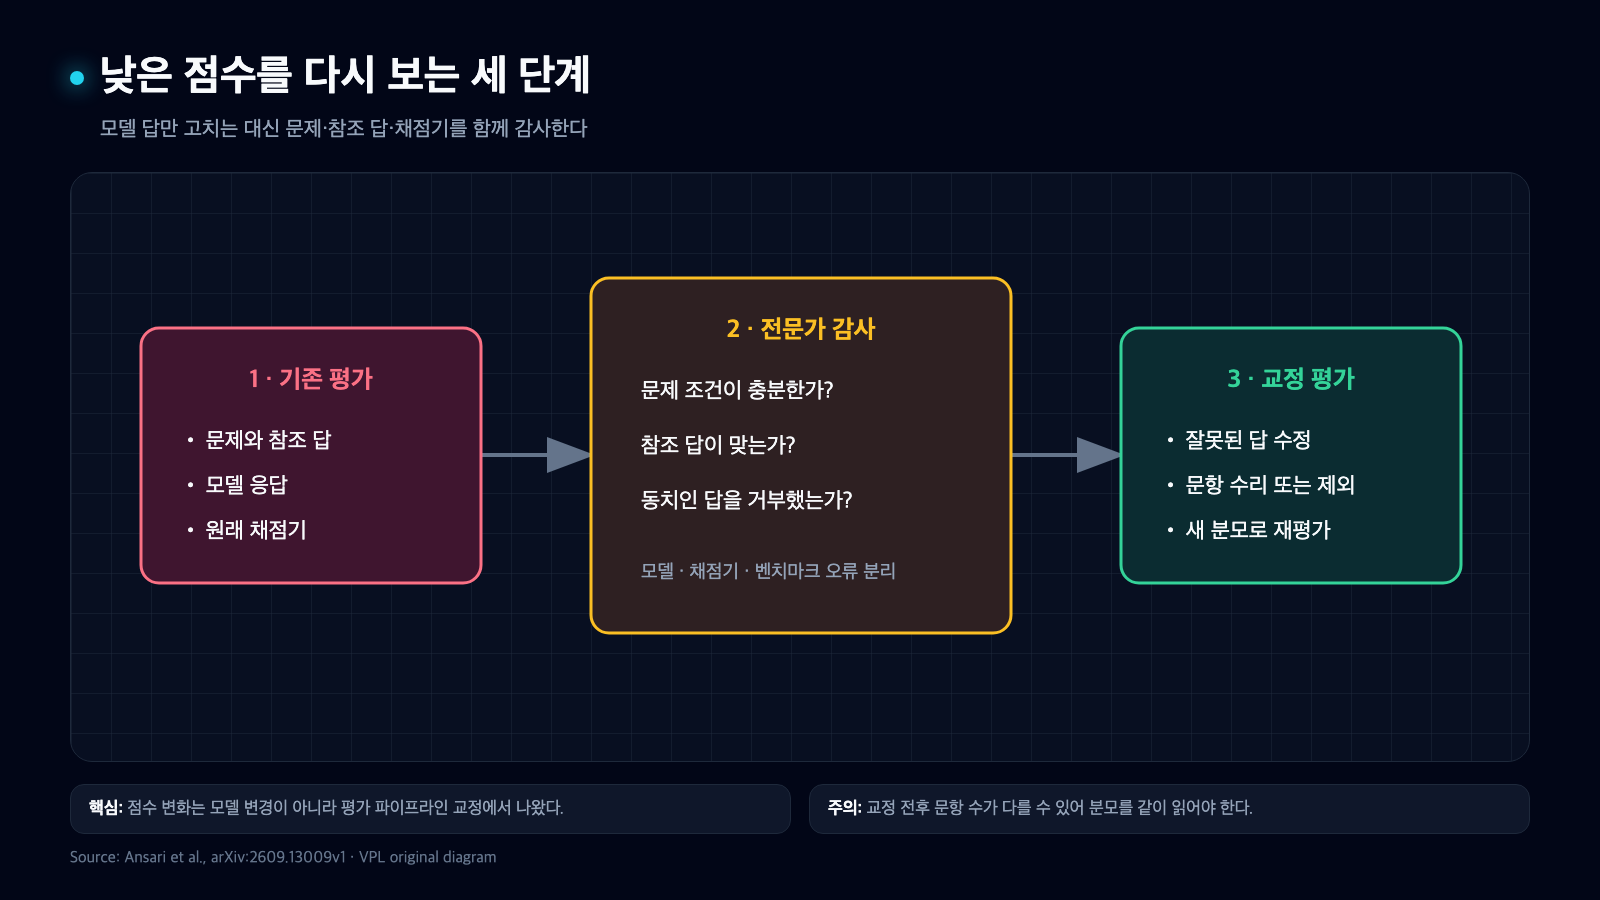
그림 1. 낮은 점수의 원인을 모델 답에만 두지 않고 문제, 참조 답, 채점기를 함께 감사한 절차다. 출처: arxiv.org/html/2609.13009v1#S2.
무엇이 틀렸는지 세 갈래로 나눴다
감사는 실패를 세 종류로 분류했다. 첫째는 모델 오류다. 문제와 참조 답이 맞는데 모델이 틀린 경우다. 둘째는 채점기 오류다. 모델 답이 수학적으로 맞지만 표현 형식이나 관례가 달라 채점기가 거부한 경우다. 셋째는 벤치마크 오류다. 문제 조건이 빠졌거나 모호하고, 참조 답이나 풀이가 잘못된 경우다.
PHYBench의 한 사례가 차이를 잘 보여 준다. 모델은 줄의 장력을 P/(3√6)으로 썼고 참조 답은 (√6/18)P였다. 두 식은 같다. 그런데 Expression Edit Distance 기반 채점은 0점을 줬다. 문자열이나 정규형 비교가 수학적 동치를 놓치면 모델의 물리 추론이 아니라 출력 형식을 벌점 준다.
연구진은 HLE-Physics, PHYBench, PRISM-Physics, UGPhysics에서 특정 수집 실행 중 거부된 250개 사례를 감사했다. 그중 143개(57.2%)는 벤치마크 오류, 95개(38.0%)는 채점기 오류, 12개(4.8%)는 모델 오류로 분류됐다. 이 비율을 전체 문제의 오류율로 읽으면 안 된다. 감사 집합은 GPT-5.6-Sol High가 수집 실행에서 실패한 문항만 의도적으로 모은 표본이다. 논문도 이 250개 집계를 교정 점수의 직접 재구성으로 쓰지 말라고 명시한다.
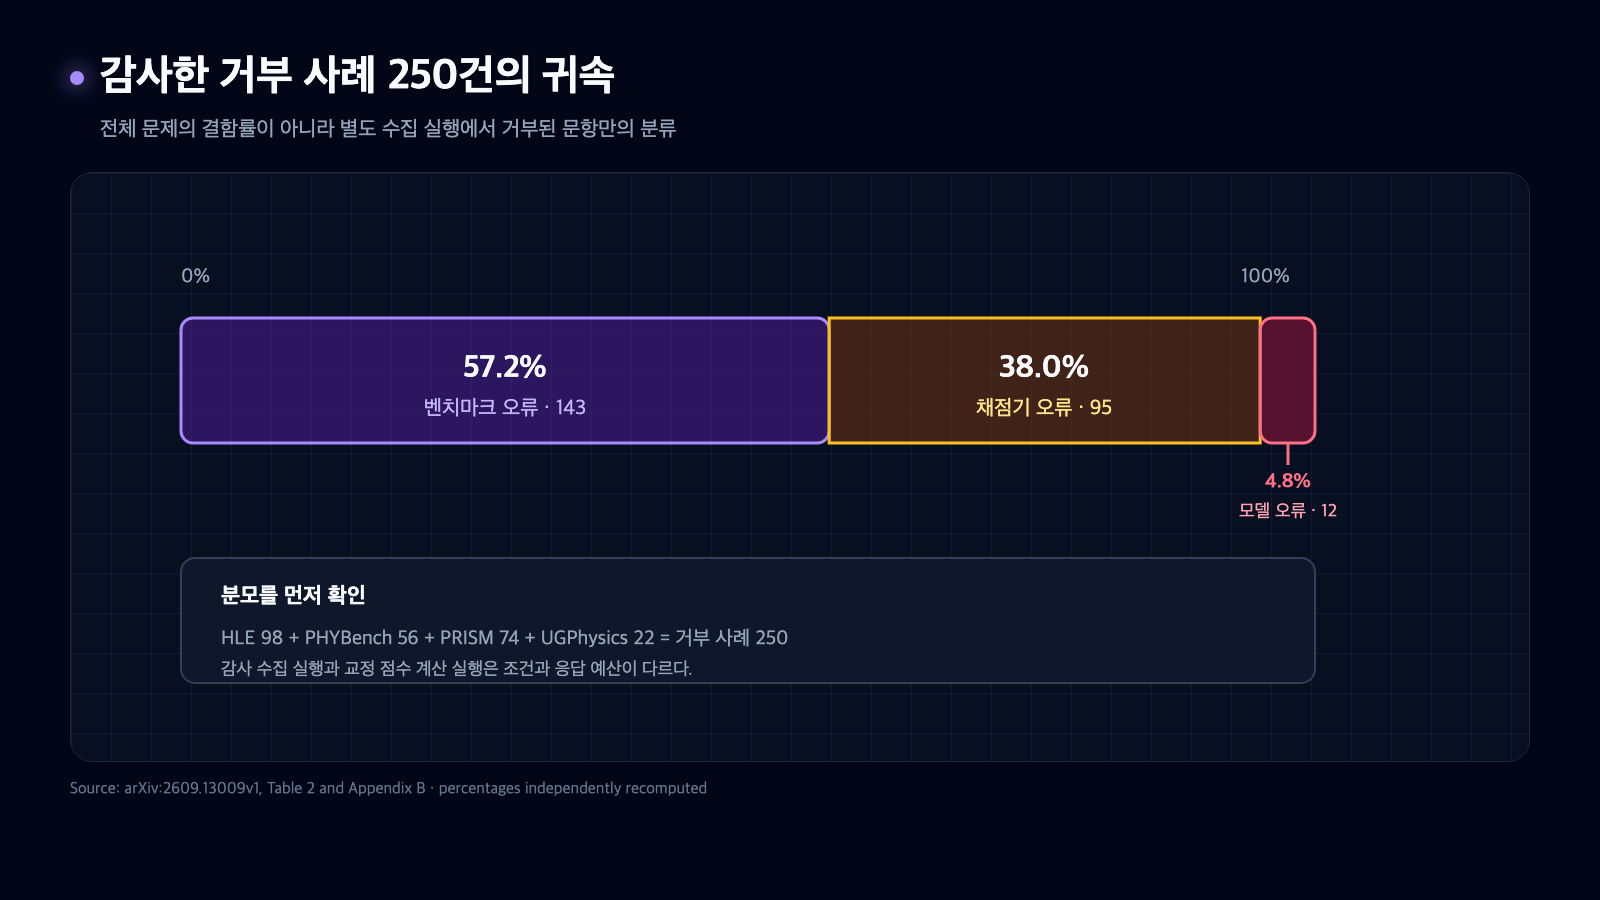
그림 2. 250개는 전체 문항이 아니라 별도 수집 실행에서 거부된 사례다. 논문도 이 집계를 교정 점수의 직접 재구성으로 쓰지 않는다. 출처: arxiv.org/html/2609.13009v1#S3.T2.
47.28%에서 78.66%로 오른 계산의 안쪽
HLE-Physics에는 물리 문항 230개가 있었다. 연구진은 멀티모달 문항 28개를 빼고 텍스트 문항 202개를 평가했다. 감사에서 벤치마크 오류로 분류된 86개를 제외한 116개가 교정 평가의 분모가 됐다. GPT-5.6-Sol High의 mean@4는 원래 202개에서 47.28%, 유지된 116개에서 78.66%였다. 같은 분모에서 채점표만 고친 단순한 전후 비교가 아니다.
다른 벤치마크도 분모가 바뀌었다. PHYBench는 공개 참조 답이 있는 100개 중 13개를 제외해 87개를 남겼다. PRISM-Physics는 이미지 의존 문항과 로딩 문제가 있는 문항을 먼저 제외한 뒤 100개를 뽑았고, 감사 후 74개가 남았다. UGPhysics는 영어 텍스트 문항 5,520개 중 100개를 무작위로 뽑아 82개를 유지했다.
CritPt는 비교가 더 까다롭다. 외부 리더보드의 GPT-5.6-Sol Max 점수는 70개 도전 과제에서 mean@5 32.29%였다. 논문 연구진은 56개를 감사해 19개를 수리하고 2개를 제외했으며, 남은 54개를 별도 참조 답으로 mean@4 평가해 87.50%를 얻었다. 모델, 시도 횟수, 문제 집합, 참조 답이 모두 완전히 같은 비교가 아니다. 숫자 폭은 눈에 띄지만 32.29→87.50을 한 개의 순수한 채점기 수정 효과로 해석하면 과장이다.
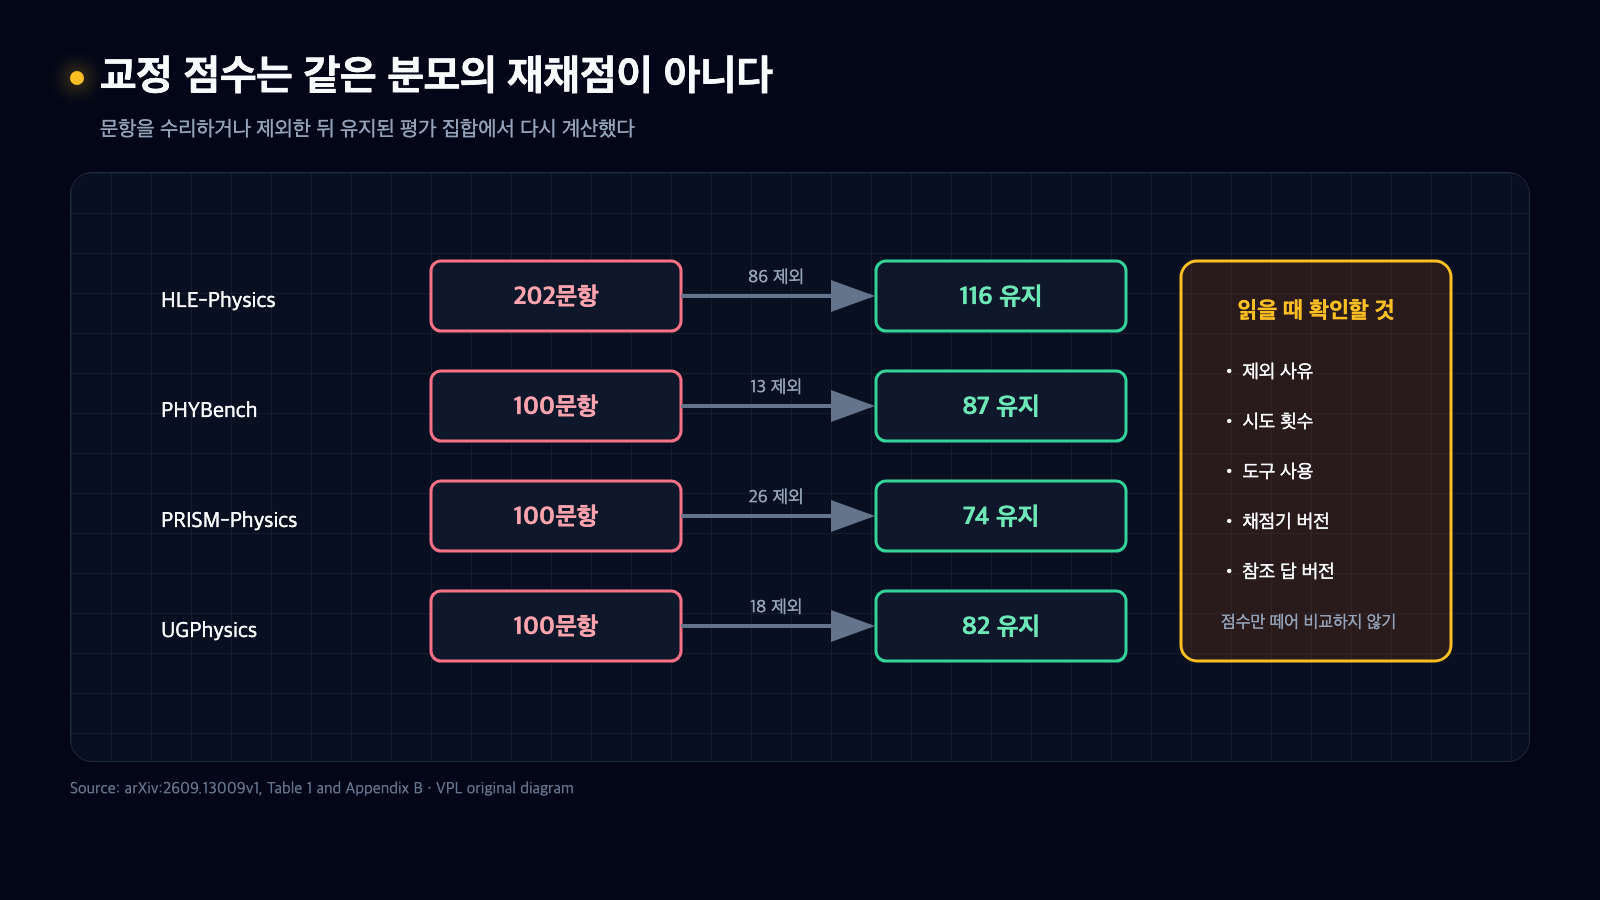
그림 3. 잘못된 문항을 제외한 교정 평가는 기존 점수와 분모가 같지 않으므로 제외 사유와 실행 조건을 함께 읽어야 한다. 출처: arxiv.org/html/2609.13009v1#A2.
사람 감사도 자동으로 정답이 되지는 않았다
네 개 감사 집합의 250문항 가운데 196개는 서로 다른 두 검토자가 읽었고 54개는 한 명만 읽었다. 이중 검토 196개에서 처음부터 같은 분류를 내린 경우는 140개, 불일치는 56개였다. 일치율은 71.43%, 불일치율은 28.57%다. 불일치 56개는 세 번째 검토로 정리했다.
이 숫자는 전문가 감사가 필요 없다는 뜻이 아니다. 오히려 "전문가가 봤다"는 문구 하나로 검증 강도를 대신할 수 없다는 뜻이다. 누가 어떤 문항을 몇 번 읽었는지, 의견 충돌을 어떻게 처리했는지까지 공개해야 감사 결과를 판단할 수 있다. 특히 불일치 56개 중 34개는 벤치마크 오류와 채점기 오류 사이의 충돌이었다. 모델 오류인지 아닌지는 같아도, 무엇을 고쳐야 하는지에 대한 진단은 달랐다.
CMT-Benchmark와 CritPt는 또 다른 절차를 썼다. 문항별 한 명의 분야 전문가가 먼저 자기 풀이 접근을 세우고, 문제와 참조 답을 검증한 뒤 수리 가능한 결함은 고쳤다. CritPt는 공식 참조 풀이가 공개되지 않아 감사자가 독립적으로 답을 만들었다. 이 과정은 기존 자동 채점보다 깊지만, 같은 문항을 여러 전문가가 독립적으로 다시 풀어 합의한 절차와는 다르다.
벤치마크를 운영할 때 바꿔야 할 것
첫째, 점수와 함께 분모를 저장해야 한다. 교정 전후 문항 수, 멀티모달·로딩 실패·모호한 문제의 제외 사유, 재평가 횟수를 남기지 않으면 개선 폭을 해석할 수 없다.
둘째, 채점기 실패와 모델 실패를 분리해야 한다. 수식 동치, 단위, 부호 관례, 집합 순서처럼 형식 변형이 많은 분야에서는 문자열 기반 규칙 하나로 최종 판정을 끝내기 어렵다. 규칙 기반 검사와 별도 판정기, 소규모 전문가 표본 감사를 함께 쓰고 서로 다른 결과를 기록하는 편이 낫다.
셋째, 평균 점수만으로 포화 여부를 말하지 않아야 한다. 이 논문은 닫힌 형태의 문제집형 물리 과제가 교정 뒤 높은 점수에 도달했다고 보고했다. 연구진 스스로 같은 에이전트 방식으로 열린 이론물리 문제를 완전히 푼 사례는 없었다고 적었다. 잘 정의된 최종답 문제를 푸는 능력과 연구 질문 설정, 새로운 가설, 장기 검증을 수행하는 능력은 같은 측정값이 아니다.
실무에서는 벤치마크 버전, 문제 집합 해시, 참조 답 버전, 채점기 버전, 시도 예산을 한 묶음으로 고정하고 결과를 비교해야 한다. 점수가 갑자기 뛰었을 때 모델 변경인지, 데이터 정리인지, 채점기 변경인지 분리할 수 있어야 한다. 이번 논문의 가장 쓸모 있는 부분도 "물리에서 AI가 거의 끝났다"는 큰 문장이 아니다. 모델이 좋아졌을 때 기존 평가 파이프라인의 결함이 측정 상한이 될 수 있다는 구체적인 경고다.


댓글
댓글 쓰기