평가 한 번에 2,829달러: AI 에이전트 eval이 새 컴퓨트 병목이 된 이유
모델을 훈련하는 데 돈이 많이 든다는 사실은 익숙하다. 그런데 이제는 만든 모델을 제대로 재는 비용도 작은 연구팀이 감당하기 어려운 수준으로 올라왔다. EvalEval Coalition이 정리한 공개 자료를 보면, Holistic Agent Leaderboard(HAL)는 모델 9개와 벤치마크 9개에서 21,730회 에이전트 실행을 돌리는 데 약 4만 달러를 썼다. 그중 GAIA 전체를 프런티어 모델과 특정 에이전트 구성으로 한 번 평가하는 비용은 캐시 적용 전 약 2,829달러까지 올라갔다.
문제는 비싼 모델 하나가 아니다. 같은 과제를 풀어도 모델, 에이전트 하네스, 토큰 예산이 바뀌면 비용이 크게 달라진다. 한 번의 점수로 신뢰도를 판단할 수 없어 반복 실행까지 더하면 가격은 다시 몇 배가 된다. eval을 학습 뒤에 붙는 마지막 체크로 취급하던 운영 방식부터 바꿔야 하는 이유다.
여기서 말하는 '평가 한 번'은 무엇인가
2,829달러는 질문 하나의 가격이 아니다. 한 모델과 한 에이전트 구성을 GAIA의 전체 과제에 통과시킨 비용 범위의 상단이다. HAL 집계에서 GAIA는 구성에 따라 약 7.80달러부터 2,829달러까지 벌어졌다. Online Mind2Web에서도 Browser-Use와 Claude Sonnet 4 조합은 정확도 40%에 1,577달러였지만, SeeAct와 GPT-5 Medium 조합은 42%에 171달러였다. 정확도 2%포인트 차이에 비용은 약 9배였다.
그러므로 리더보드의 한 행은 '모델 성능'만 나타내지 않는다. 실제 측정 대상은 모델 × 하네스 × 토큰 예산 × 과제 집합이다. 캐시와 API 단가, 재시도 정책도 결과에 붙는다. 모델 이름만 남기고 이 조건을 버리면 점수도 비용도 재현하기 어렵다.
정적 벤치마크에서 통하던 절약법이 약해졌다
정답 하나를 예측하는 정적 벤치마크는 대표 문항을 잘 고르면 크게 줄일 수 있었다. Flash-HELM 연구는 모델 순위를 거의 보존하면서 HELM 계산량을 100~200배 줄일 수 있다고 보고했다. tinyBenchmarks는 MMLU 14,000개 문항을 100개 기준 문항으로 압축해 약 2% 오차로 성능을 추정했다.
에이전트 평가는 다르다. 문항 하나가 여러 차례의 도구 호출과 환경 상태 변화로 이어지고, 같은 문항도 실행 경로가 달라진다. HAL 데이터를 사용한 최근 효율화 연구는 난이도 중간 구간의 과제를 고르는 방식으로 순위 충실도를 유지하면서 약 2~3.5배 절약했다. 쓸 만한 결과지만 정적 평가의 100~200배와는 거리가 멀다.
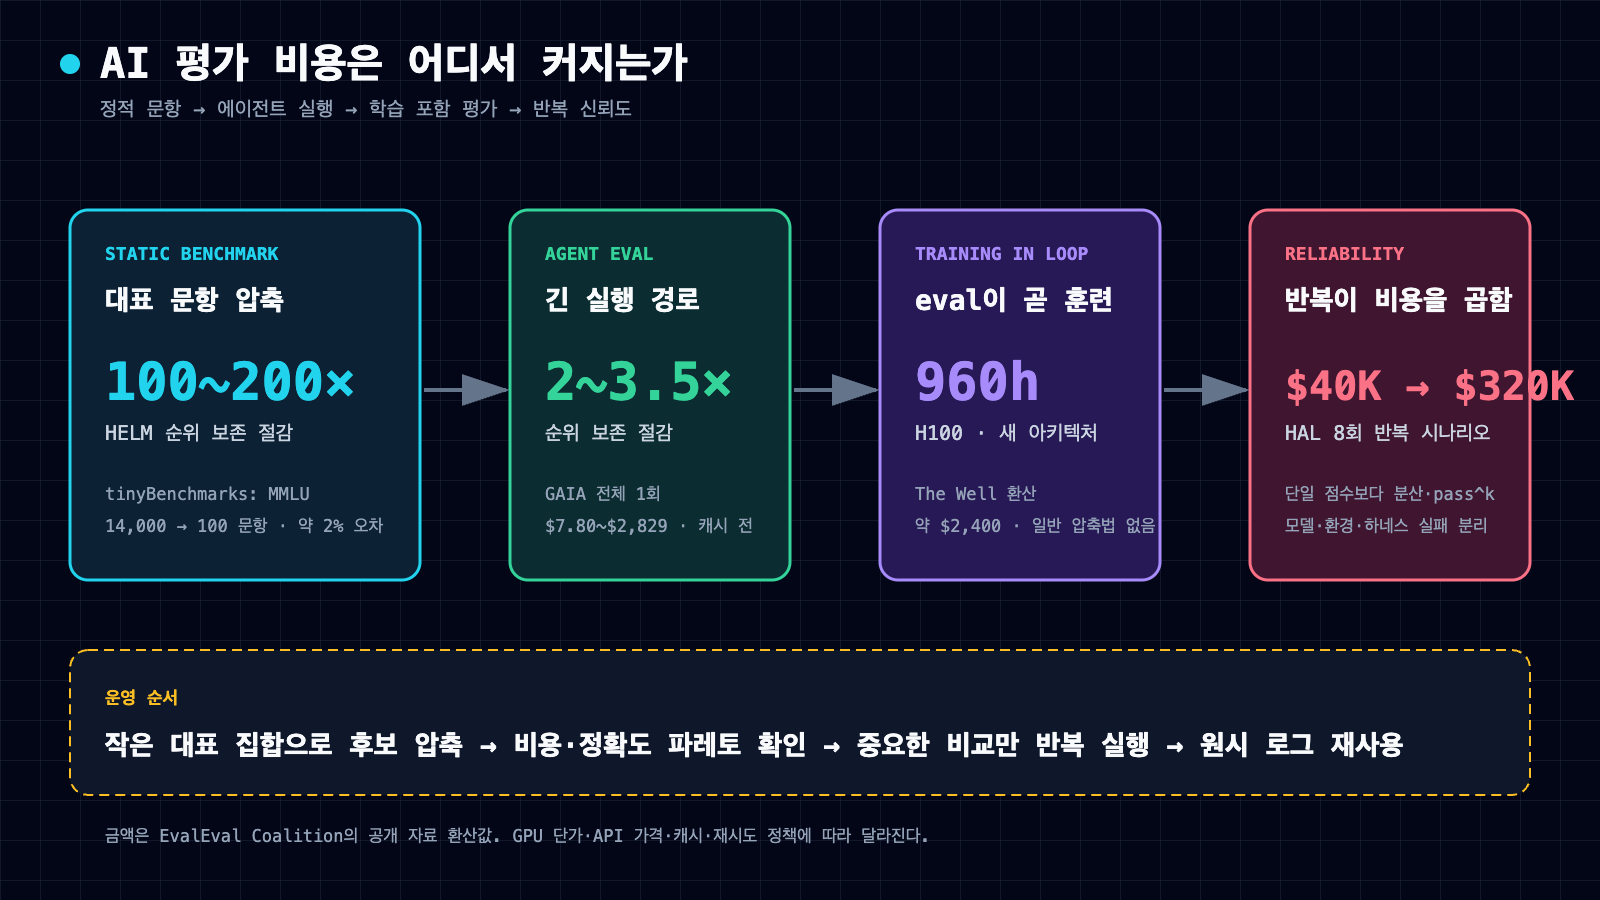
평가가 정적 문항에서 긴 에이전트 실행과 학습 포함 프로토콜로 이동할수록 압축 여지가 줄고, 반복 신뢰도 측정은 비용을 다시 곱한다. 출처: huggingface.co/blog/evaleval/eval-costs-bottleneck.
학습이 포함되면 eval 자체가 훈련 작업이 된다
Scientific ML과 연구 에이전트 벤치마크는 더 무겁다. The Well의 대표 프로토콜은 새 아키텍처 하나를 16개 데이터셋과 5개 학습률로 평가한다. 각 조합을 H100 한 장에서 12시간 훈련한다고 계산하면 960 H100시간, 원문의 환산 가정으로 약 2,400달러다. 네 아키텍처 전체 스윕은 3,840 H100시간, 약 9,600달러다.
MLE-Bench는 75개 Kaggle 대회에서 각 시도를 24시간 실행한다. 한 시드만 해도 GPU 1,800시간이 들고, 원문이 적용한 A10 시간당 1.50달러와 o1-preview API 비용을 더하면 약 5,500달러다. PaperBench 전체 프로토콜도 20편을 재현하고 채점하는 데 약 9,500달러로 추산됐다. 이런 평가는 문항을 읽고 답만 내는 작업이 아니라 모델 훈련, 실행 환경, 채점까지 포함한 작은 실험실에 가깝다.
신뢰도를 요구하면 비용은 다시 곱해진다
한 번 성공한 실행은 안정성을 보여주지 못한다. τ-bench 사례에서는 단일 실행 성공률 60%가 8회 연속 성공을 요구하는 pass^8 조건에서 25%로 떨어졌다. HAL식 4만 달러 평가를 각 조건에서 8회 반복한다고 단순 계산하면 32만 달러다. 이 수치는 새로운 측정 결과가 아니라 반복 횟수를 곱한 예산 시나리오다. 그럼에도 평균 점수만 보고 예산을 잡을 때 무엇을 빠뜨리는지 분명히 보여준다.
실패 원인도 분리해야 한다. HAL 관련 신뢰도 분석에서는 일부 벤치마크에서 환경 오류와 도구 호출 실패가 자주 나타났다. 이때 낮은 점수를 전부 모델 능력으로 돌리면 엉뚱한 결론을 낸다. 모델 실패, 하네스 실패, 환경 실패, 채점 실패를 서로 다른 상태로 기록해야 재실행할 대상을 정할 수 있다.
팀에서 eval 예산을 짤 때 확인할 것
- '한 번'의 단위를 먼저 고정한다. 문항 1개인지, 전체 벤치마크인지, 한 시드인지 적는다.
- 모델명과 함께 하네스 버전, 프롬프트, 토큰 상한, 캐시 정책, API 단가를 남긴다.
- 정확도만 순위에 올리지 말고 과제당 비용과 정확도-비용 파레토 전선을 같이 본다.
- 전체 스윕 전에 작은 대표 집합으로 후보를 거르고, 최종 후보에만 반복 실행 예산을 쓴다.
- 모델 오류와 도구·환경·채점 오류를 분리해 불필요한 재실행을 줄인다.
- 평균 점수 외에 분산, 반복 성공률, 실패 유형을 보고 필요한 시드 수를 정한다.
- 재사용할 수 있도록 문항별 출력, 도구 호출 로그, 채점 근거와 버전을 보관한다.
비용을 낮춘다고 한 번만 돌려도 된다는 뜻은 아니다. 먼저 평가 질문을 좁히고, 값싼 단계에서 후보를 거른 뒤, 중요한 비교에 반복 예산을 집중하는 편이 낫다. 다른 팀의 결과를 재사용할 때도 모델과 하네스 버전이 다르면 같은 측정으로 간주하지 않아야 한다.
2,829달러보다 중요한 숫자
가장 큰 비용 숫자는 눈에 띄지만, 실무에서 더 중요한 값은 같은 과제의 최소·최대 비용 차이와 반복 실행 뒤의 성공률이다. 비싼 구성이 더 정확하다는 보장도 없다. 비용을 숨긴 리더보드는 성능이 아니라 지출 능력까지 한 숫자에 섞는다.
다만 이 글의 금액은 서로 다른 논문과 공개 리더보드를 EvalEval 글이 공통 가정으로 환산한 값이다. GPU는 H100 시간당 2.50달러, A10 시간당 1.50달러를 적용했고, 일부 항목은 API와 채점 비용을 포함한다. 실제 클라우드 가격, 할인, 캐시 적중률, 재시도 횟수에 따라 달라질 수 있다. HAL의 2,829달러도 캐시 전 상단값이며 모든 GAIA 실행의 고정 가격이 아니다.
이 글은 공개 논문, 공식 리더보드와 EvalEval Coalition의 비용 정리를 AI로 대조해 작성한 해설이다. 벤치마크를 직접 유료로 다시 실행한 독립 재현 보고서나 제품 사용 후기가 아니다.


댓글
댓글 쓰기