데이터를 32번 반복하자 MoE가 dense 모델보다 뒤처졌다
같은 토큰 수라도 새 데이터의 양은 다르다
언어 모델 학습 예산을 말할 때 흔히 토큰 수를 먼저 본다. 하지만 16억 토큰을 한 번 읽은 학습과 1억 토큰을 16번 읽은 학습은 같은 16억 토큰 처리량이어도 정보량이 다르다. 새로 공개된 사전 논문 「Data Scarcity and Model Sparsity」는 이 차이가 dense Transformer보다 Mixture-of-Experts(MoE)에서 더 일찍, 더 크게 나타날 수 있다고 보고한다.
연구진은 총 학습 토큰을 활성 파라미터 수의 약 20배로 고정했다. 그 안에서 고유 토큰 수 U를 줄이고 반복 횟수 R을 늘렸다. 관계는 단순하다. 총 토큰 T가 고정돼 있을 때 R = T / U다. 처리량은 같지만 R이 커질수록 모델이 다시 보는 문장이 많아진다.
비교 대상은 활성 파라미터 8천만, 2억, 10억 규모의 dense와 MoE 모델이다. MoE는 전체 expert 중 일부만 토큰마다 활성화하므로 계산량을 유지하면서 전체 파라미터를 늘릴 수 있다. 이 연구의 가장 큰 MoE는 활성 10억, 전체 85억 파라미터다. 결과를 상용 초대형 모델 전체로 곧바로 확대하면 안 되는 이유도 여기에 있다.
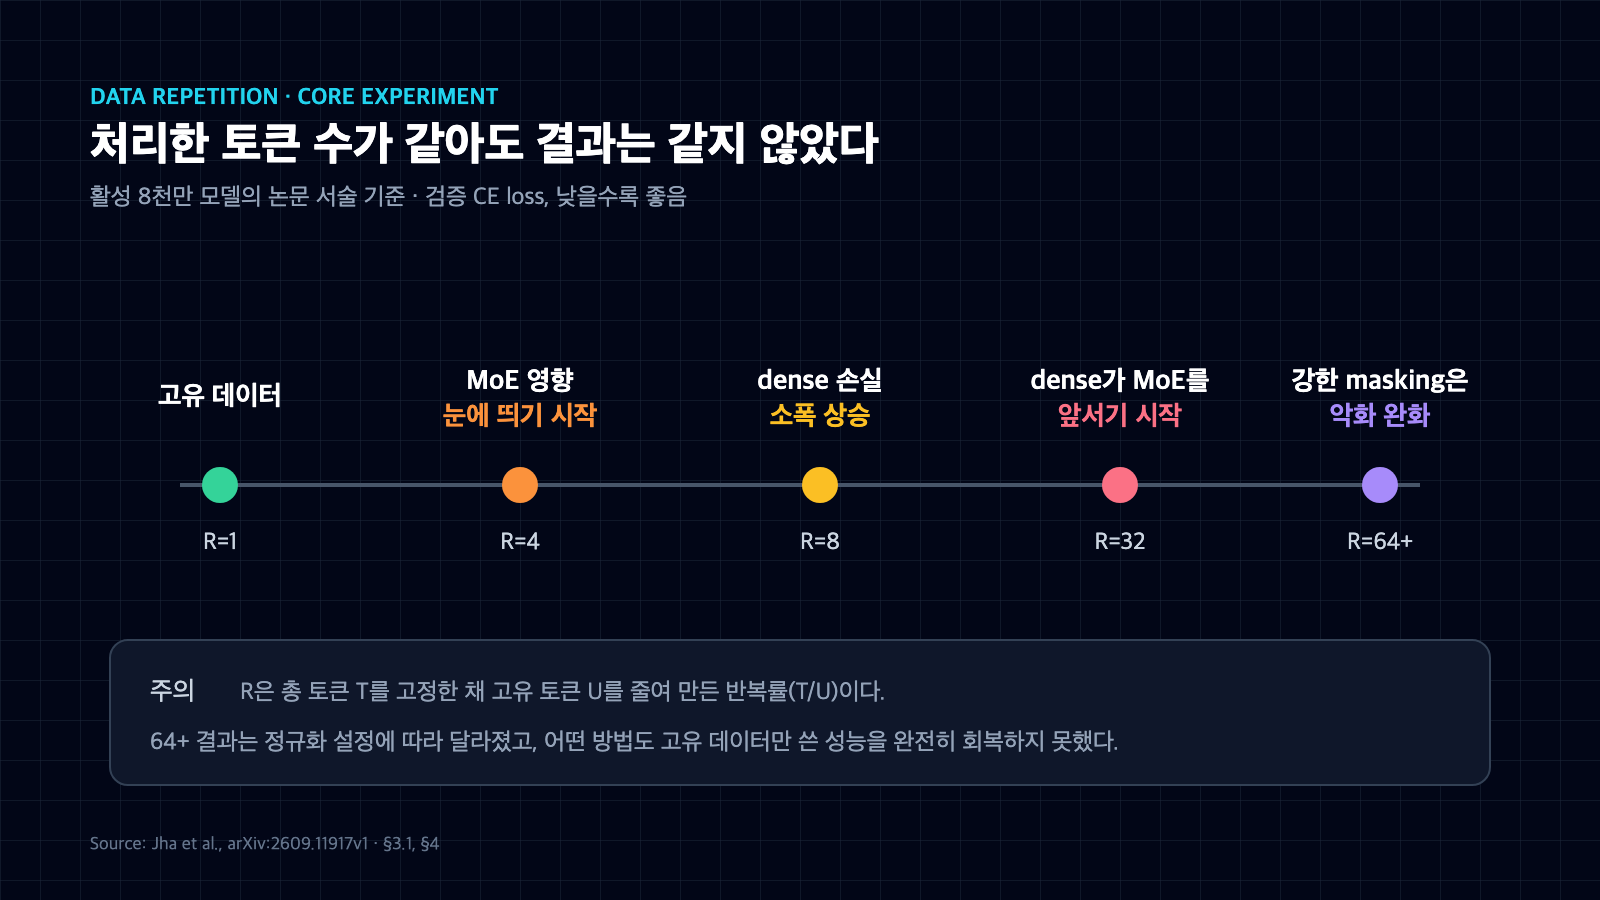
그림 1. 총 학습 토큰을 고정한 핵심 실험에서 MoE는 4회부터 영향을 보였고 32회에서는 dense가 앞섰다. 64회 이상 결과는 정규화 설정에 따라 달랐다. 출처: arxiv.org/html/2609.11917v1.
MoE는 4회부터 흔들리고 32회에서 순서가 뒤집혔다
논문의 핵심 비교에서 8천만 dense 모델은 8회 반복까지 검증 손실 변화가 작았다. MoE는 4회부터 눈에 띄게 나빠졌다. 16회까지는 MoE가 dense보다 나았지만, 32회에서는 dense가 MoE를 앞섰다. 학습 손실은 계속 낮아지는 동안 검증 손실은 올라갔다. 연구진은 이 엇갈림을 반복 데이터 암기의 증거로 해석한다.
한 그래프만 고른 결과도 아니다. 연구진은 웹 크롤(DCLM), 코드(StarCoder), 학술 텍스트(peS2o), 위키백과를 따로 학습했다. 네 영역 모두 16~32회 사이에 MoE의 이점이 사라지는 비슷한 패턴을 보였다. 품질 필터링도 문제를 없애지 못했다. DCLM의 강한 필터는 원시 280조 토큰 중 2.4%만 남기는데, 이 실험에서는 엄격히 거른 데이터를 32번 반복하는 것보다 고유한 비필터 데이터를 한 번 쓰는 편이 나았다.
다만 반복 횟수만으로 모든 학습을 판정할 수는 없다. 혼합 데이터 실험에서는 반복하지 않은 웹 데이터가 반복된 학술 데이터의 과적합을 누그러뜨렸다. 반면 반복된 코드와 웹의 조합에서는 같은 완화가 뚜렷하지 않았다. 저자들은 의미적으로 비슷한 비반복 데이터가 정규화 역할을 할 가능성을 제시했지만, 이는 후속 검증이 필요한 가설이다.
계산량을 정하는 값과 암기 용량을 정하는 값이 갈라진다
MoE의 장점은 한 토큰이 일부 expert만 통과한다는 데 있다. 활성 파라미터 수는 토큰당 계산량에 가깝고, 전체 파라미터 수는 모델이 저장할 수 있는 용량에 더 가깝다. 연구진은 활성 파라미터를 고정한 채 expert 수와 크기를 바꿨다. 반복 데이터에 대한 악화는 활성 파라미터보다 전체 파라미터가 커질수록 가팔라졌다.
이 결과는 학습 계획에서 토큰 / 활성 파라미터만 보면 부족하다는 뜻이다. 고유 토큰 수와 전체 파라미터 수를 함께 봐야 한다. 같은 계산 예산의 두 MoE라도 전체 expert 용량이 크고 고유 데이터가 적다면, 각 expert가 작은 데이터 조각을 오래 외울 여지가 커진다.
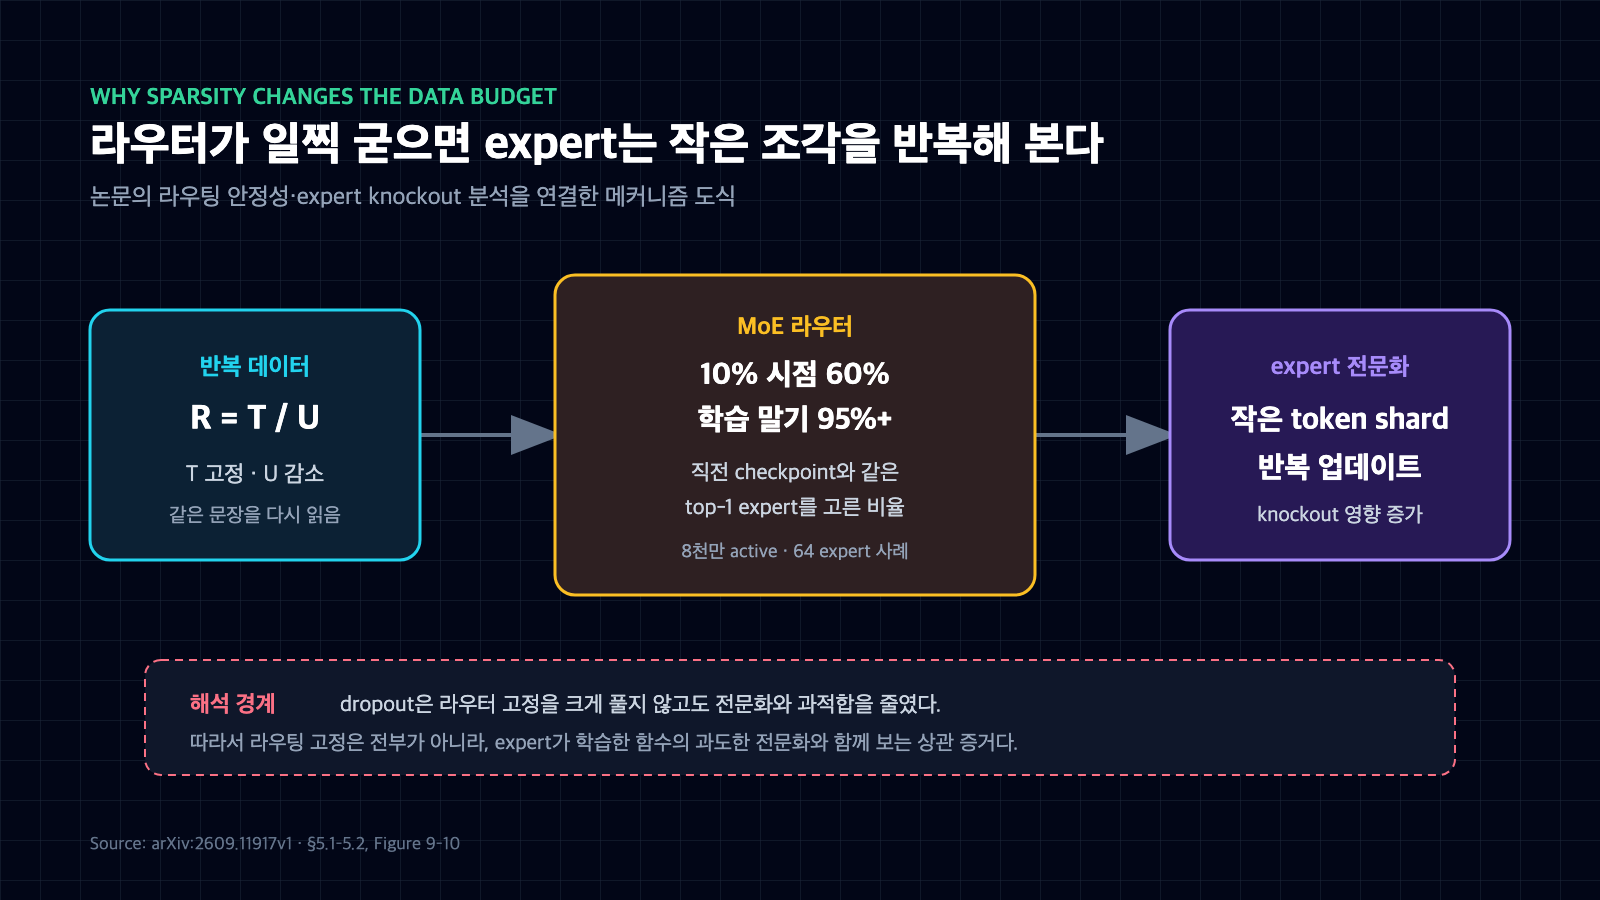
그림 2. 64-expert 8천만 모델 사례에서 top-1 라우팅 안정성은 학습 10퍼센트 시점 60퍼센트, 말기 95퍼센트 이상이었다. 라우팅 고정은 전문화와 함께 보는 상관 증거다. 출처: arxiv.org/html/2609.11917v1.
라우터는 학습 초반에 거의 굳었다
왜 sparse 모델이 반복에 더 민감했을까. 연구진은 고정된 검증 토큰 16,384개를 각 체크포인트에 넣고, 토큰의 1순위 expert가 직전 체크포인트와 같았는지 측정했다. 64개 expert를 쓴 8천만 모델에서 첫 체크포인트의 일치율은 무작위 수준인 약 1/64였다. 학습 10% 시점인 400 step에는 60%로 올라갔고, 마지막에는 95%를 넘었다.
라우팅이 일찍 고정되면 expert마다 받는 데이터 조각도 오래 고정된다. 고유 데이터가 적은 상황에서는 같은 expert가 같은 작은 조각을 반복해서 본다. 그렇다고 라우터 고정만 원인이라고 단정할 수는 없다. dropout은 라우팅 고정 정도를 크게 바꾸지 않으면서도 반복 과적합을 줄였다.
연구진은 그래서 expert 자체의 전문화도 따로 봤다. 추론 때 expert 하나의 출력을 0으로 만들고 검증 손실이 얼마나 늘어나는지 측정했다. 반복이 1회에서 32회로 늘자 expert 제거 영향은 16-expert 모델에서 1.1배, 128-expert 모델에서 2.3배 커졌다. 반복 학습이 expert 간 중복을 줄이고 특정 expert 의존을 키웠다는 해석과 맞는다. 이 수치는 인과관계를 단독으로 증명하는 실험이라기보다 메커니즘을 좁히는 상관 증거다.
무엇이 완화했고 무엇은 거의 바꾸지 못했나
연구진은 여러 정규화 방법을 같은 반복 설정에서 비교했다. residual dropout, FFN output masking, expert dropout, expert output masking은 높은 반복 구간의 검증 손실 악화를 줄였다. 강한 masking 계열 설정에서는 64회 넘게 반복해도 MoE가 dense보다 나았다.
반면 gradient clipping, 실험 범위의 AdamW weight decay, router jitter는 측정 변동을 넘어서는 효과를 보이지 못했다. 여기서 "효과 없음"은 일반 법칙이 아니다. 논문이 시험한 값과 모델 크기 안에서 뚜렷하지 않았다는 뜻이다. 강한 dropout은 반복이 적을 때 성능을 해쳤고, 어떤 방법도 고유 데이터만 쓴 학습 성능을 완전히 회복하지 못했다.
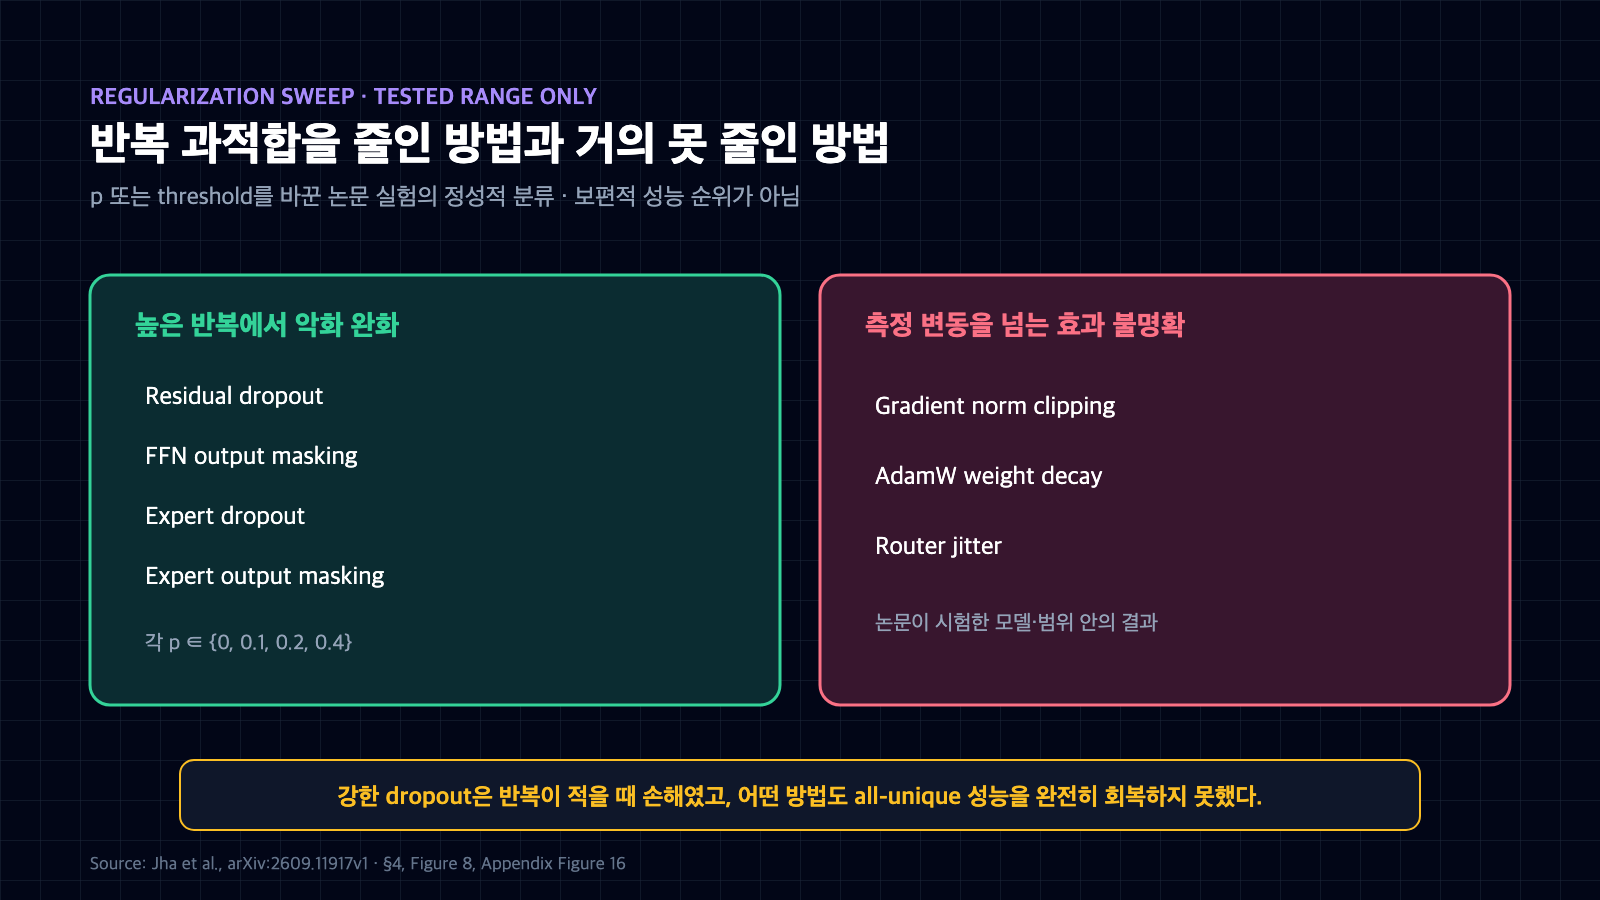
그림 3. 논문이 시험한 범위에서 output을 마스킹하는 정규화는 반복 과적합을 줄였지만, 어떤 방법도 all-unique 학습 성능을 완전히 회복하지 못했다. 출처: arxiv.org/html/2609.11917v1.
학습 계획에서 바로 확인할 네 가지
첫째, 총 토큰과 고유 토큰을 분리해 기록해야 한다. epoch 수나 repetition rate를 모델 전체뿐 아니라 데이터 영역별로 남기는 편이 낫다. 둘째, MoE 비교에서는 활성 파라미터와 전체 파라미터를 둘 다 써야 한다. FLOPs가 같다는 사실만으로 반복 데이터 위험까지 같아지지 않는다.
셋째, 학습 손실만 보고 중단 시점을 정하면 암기를 성과로 오해할 수 있다. 고유한 held-out 데이터의 손실과 영역별 downstream 결과를 함께 봐야 한다. 논문 부록의 다섯-seed 8천만 설정을 다시 계산하면, R=1에서 R=32로 갈 때 11개 언어모델 검증셋 평균 CE 증가는 dense 0.67(4.81→5.48), MoE 1.86(4.46→6.32)이었다. 같은 표의 반올림 평균 기준으로 MoE의 증가폭이 약 2.78배다. 넷째, 데이터가 부족하다고 바로 같은 묶음을 더 돌리기 전에 비반복 데이터 혼합과 output masking을 작은 규모에서 시험할 필요가 있다. 이 부록의 언어모델 검증 손실 표준편차는 평균 차이보다 작았다. 하지만 downstream 정확도는 대체로 chance 부근이어서 실제 응용 품질을 보여주는 근거로 쓰기 어렵다.
이번 결과의 범위는 연구진이 학습한 최대 활성 10억, 전체 85억 파라미터와 OLMoE 계열 데이터다. 공개 사전 논문 v1이며 저자 코드나 체크포인트 저장소는 논문에서 확인되지 않았다. 따라서 "모든 MoE는 데이터를 네 번 반복하면 실패한다"가 결론은 아니다. 더 정확한 결론은 이렇다. 희소 모델의 학습 예산에는 계산량뿐 아니라 고유 데이터와 전체 expert 용량의 비율이 들어가야 한다.


댓글
댓글 쓰기