3.5초짜리 AI 함수가 50.9초 훈련을 거치자 정확도가 22.4%에서 83.6%로 뛴 이유
원격 LLM을 매번 부르기에는 아깝지만 정규식으로 쓰기에는 애매한 일이 있다. "오늘 안에 서명이 필요한 메일은 즉시, 뉴스레터는 나중"처럼 사람에게는 쉬운 분류가 그렇다. 규칙이 늘어나면 예외가 쌓이고, 큰 모델을 호출하면 비용과 지연, 외부 서비스 의존성이 호출마다 따라온다.
9월 3일 공개된 논문 「Compile by Training」은 이 중간 지대를 작은 신경망 함수로 다룬다. 자연어로 함수 규격을 한 번 적으면 큰 teacher 모델이 훈련 예시를 만들고, 6억 파라미터 interpreter에 붙는 LoRA adapter를 그 작업에 맞게 학습한다. 완성된 .paw 파일은 teacher 없이 로컬에서 반복 실행한다. 연구진의 FuzzyBench-Hard 평가에서 빠른 1회 컴파일은 의미 정확도 22.4%였지만, 규격별 훈련을 추가한 방식은 83.6%를 기록했다. 대신 컴파일 시간은 3.5초에서 50.9초로 늘었다.
요약: 추론 비용을 없앤 것이 아니라 빌드 단계로 옮겼다
이 접근은 자연어를 곧바로 일반 프로그램 코드로 번역하지 않는다. 규격에서 입력·출력 예시를 합성하고, 그 예시로 작은 adapter의 가중치를 조정한다. 실행할 때는 원래 규격, run-time scaffold, adapter, 공용 interpreter를 결합한다. teacher API와 훈련용 GPU는 컴파일 때 필요하지만, 이후 새 입력은 teacher에게 보내지 않는다.
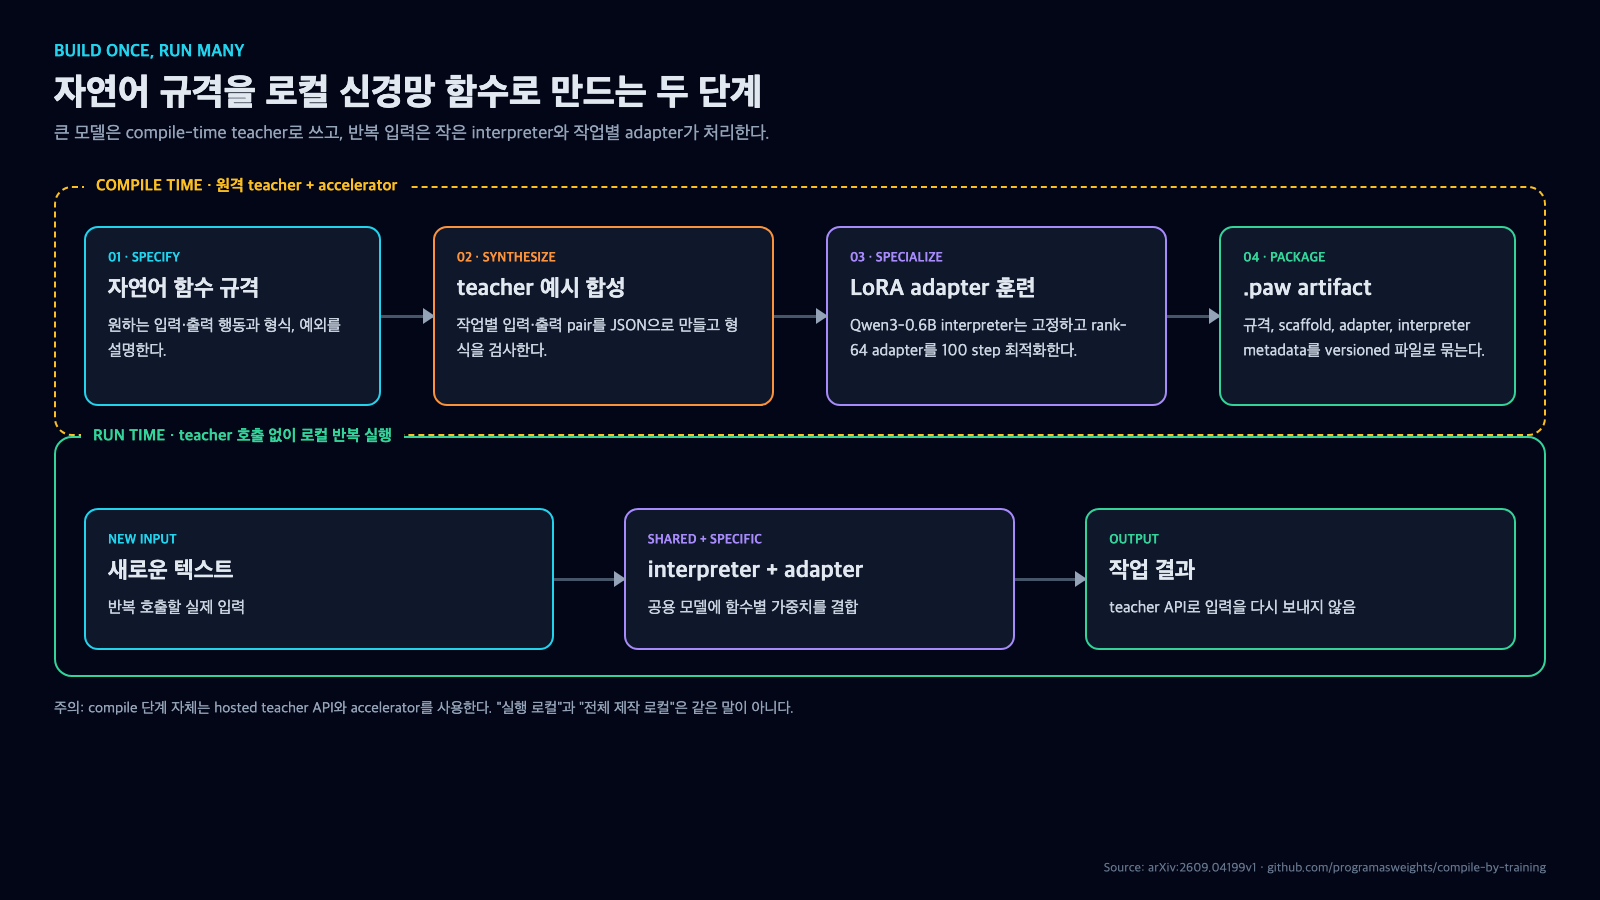
큰 모델과 accelerator는 compile 단계에 쓰고, 완성된 adapter와 공용 interpreter는 반복 입력을 로컬에서 처리한다. 출처: arxiv.org/html/2609.04199v1.
이 구분이 실무에서 중요하다. 원격 호출이 사라졌다고 해서 전체 과정이 로컬인 것은 아니다. 공개 구현의 컴파일 단계는 OpenAI API key와 accelerator를 요구한다. 반대로 완성된 함수의 반복 입력은 로컬 runtime에서 처리할 수 있다. 데이터 경계를 검토할 때는 "최종 실행이 로컬인가"와 "규격 및 합성 데이터가 컴파일 중 어디로 가는가"를 따로 물어야 한다.
산출물도 소스 코드와 조금 다르다. .paw에는 원래 규격, compiler가 만든 scaffold, LoRA adapter, interpreter metadata가 들어간다. 같은 interpreter를 여러 함수가 공유하므로 작업마다 모델 전체를 복제할 필요는 없다. 논문과 저장소의 공개 기본값은 quantized Qwen3-0.6B, LoRA rank 64와 alpha 16, 100개 학습 step이다.
작동 방식: 빠른 초안 위에 규격별 학습을 덧댄다
첫 단계는 기존 Program-as-Weights의 빠른 compiler다. 이 compiler가 자연어 규격에서 adapter 초기값과 실행 scaffold를 한 번에 예측한다. 수 초면 끝나지만 모든 함수에 비슷한 계산 예산을 쓰기 때문에 어려운 규격을 더 오래 다듬지 못한다.
그다음 teacher들이 규격을 따르는 입력·출력 쌍을 JSON으로 만든다. 공개 recipe는 GPT-5.4-mini 2,400쌍과 GPT-5.5 1,200쌍을 요청하며, accepted pair를 4,800개 목표 학습 예시로 구성한다. 논문에 보고된 서비스 설정은 2,400개 고유 pair를 6,400개 훈련 예시로 확장한 구성이며, 저장소의 현재 CLI 기본값과 논문 표의 표현이 완전히 같지는 않다. 재현할 때는 논문 숫자만 복사하지 말고 commit과 --print-config 출력을 함께 고정해야 한다.
합성 응답은 형식 검사를 통과한 뒤 훈련 queue로 들어간다. compiler는 모든 teacher 요청이 끝날 때까지 기다리지 않는다. 모델 로드와 예시 합성을 겹쳐 시작하고, 첫 batch에 필요한 예시가 모이면 훈련을 진행한다. teacher 응답이 느린 구간과 GPU 학습을 포개서 전체 critical path를 줄이는 구조다.
완성된 adapter와 scaffold는 하나의 versioned artifact가 된다. 논문의 웹 helper 사례에서는 30개 compiled program 가운데 28개를 실제 routing에 사용하고, 검색·cache·분기처럼 정확성이 필요한 부분은 일반 코드가 맡았다. 애매한 분류는 neural function에 주되 URL parsing, 권한 검사, 금액 계산까지 같은 함수에 넘기지 않는 분업이 더 안전하다.
22.4%와 83.6%를 읽을 때 빠뜨리면 안 되는 것
두 수치는 FuzzyBench 전체 평균이 아니다. 빠른 compiler가 exact match를 하나도 만들지 못했던 어려운 subset, FuzzyBench-Hard의 LLM Exact Match(LEM)다. LEM은 공백이나 JSON key 순서처럼 의미가 같은 형식 차이를 허용하도록 LLM judge가 판정한 비율이다. 연구진은 128개 수동 label과 비교해 선택한 GPT-5.5 grader의 정확도 0.977, Cohen's kappa 0.946을 보고했다.
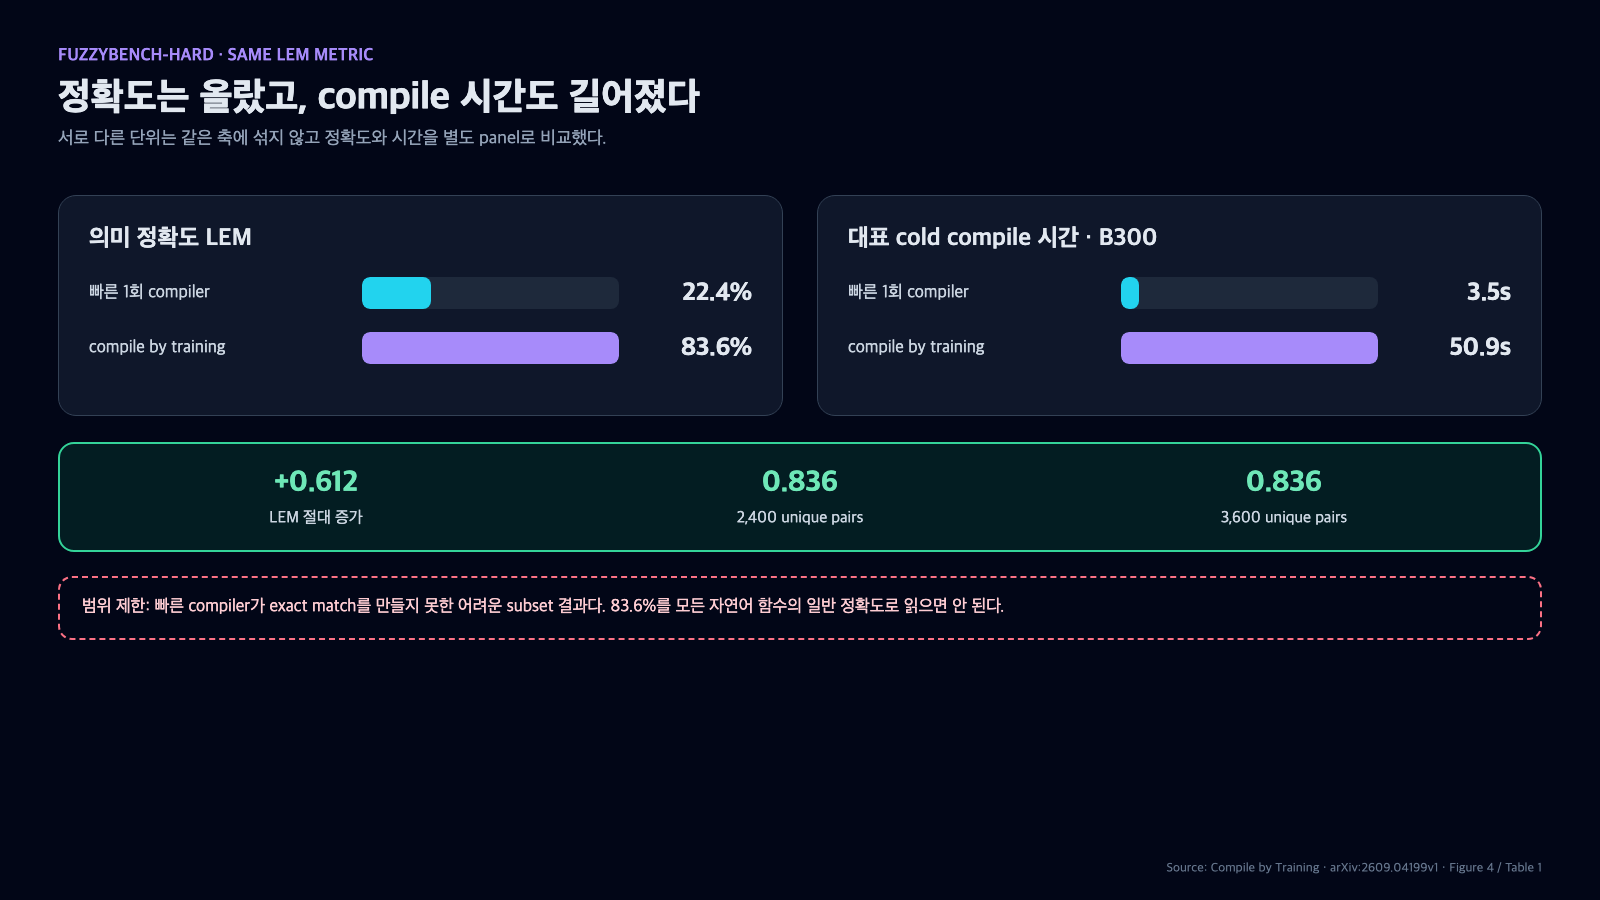
규격별 훈련은 같은 LEM 기준에서 절대 0.612를 더 얻었지만 대표 cold compile 시간은 3.5초에서 50.9초로 늘었다. 출처: arxiv.org/html/2609.04199v1.
따라서 83.6%를 "모든 자연어 함수에서 83.6% 정답"으로 일반화하면 안 된다. benchmark도 어려운 subset이고, 평가기 자체도 확정적 oracle이 아니다. 다만 같은 평가 규칙 아래에서 0.224에서 0.836으로 오른 절대 차이 0.612는 규격별 추가 계산이 빠른 초기 예측의 실패를 상당 부분 보완했다는 증거다.
대가도 분명하다. B300에서 대표 cold compile은 50.9초였고 H200은 68.2초, RTX GPU는 99.2초였다. 빠른 compiler의 3.5초보다 오래 걸린다. 논문은 teacher 합성과 훈련을 겹친 서비스 설계로 기다림을 줄였지만, 이 숫자는 2026년 5월 launch 측정이며 모든 사양과 queue 상태를 보장하는 SLA가 아니다.
데이터 양을 늘린 결과도 단순한 직선이 아니었다. 1,440개 고유 pair에서 LEM 0.821, 2,400개에서 0.836, 3,600개에서도 0.836, 7,200개에서 0.866이었다. 예시를 2,400개에서 3,600개로 늘린 구간은 평균 개선이 없었다. 더 많은 합성 데이터보다 teacher 구성과 규격의 모호성을 먼저 살펴야 할 이유다.
실전 적용: 반복 횟수보다 실패 비용부터 계산한다
이 방식이 맞는 첫 조건은 같은 fuzzy function을 여러 번 호출한다는 것이다. 분류 규칙이 자주 바뀌고 호출이 몇 번뿐이라면 1분짜리 compile과 artifact 관리가 오히려 부담이다. 반대로 입력이 많고 network latency나 외부 전송을 줄여야 하며, 결과를 tolerance 안에서 검증할 수 있다면 build-time 비용을 반복 호출에 나눌 수 있다.
두 번째 조건은 출력 검증 가능성이다. 로그 분류, 문의 routing, 문장 스타일 변환처럼 잘못된 결과를 보류하거나 사람이 고칠 수 있는 작업부터 시작한다. 결제 승인, access control, 데이터 삭제처럼 한 번의 오류가 큰 작업은 deterministic policy를 최종 관문으로 남긴다. 논문의 Avatar Director도 neural function이 만든 action DSL을 browser code가 parse하고 validate한 뒤 실행했다.
세 번째는 artifact provenance다. 자연어 규격 hash, teacher 이름과 예시 수, source commit, interpreter digest, adapter 설정, 평가 fixture를 함께 기록해야 한다. .paw 파일만 보관하면 어느 규격과 teacher에서 나왔는지, 현재 입력 분포에서도 쓸 수 있는지 판단하기 어렵다. compiler가 cache를 재사용한다면 cache key에 규격뿐 아니라 recipe와 teacher version이 들어가는지도 확인해야 한다.
배포 전에는 경계 사례를 직접 만든다. 학습 예시와 겹치지 않는 holdout, 비어 있는 입력, 매우 긴 입력, Unicode와 형식 오류를 포함한다. 평균 정확도 하나보다 오류가 어느 class에 몰리는지 보는 편이 낫다. 새 adapter가 기준을 못 넘으면 이전 artifact를 유지하고, 성공한 build만 canonical ID로 승격한다.
주의점: 공개 구현은 재현의 출발점이지 결과 복제는 아니다
저자 저장소의 compile.py와 README를 확인하고 commit 0401a7e에서 uv run compile.py --print-config를 실행했다. 공개 기본값의 interpreter, teacher 혼합, LoRA 설정, 학습 step은 코드와 출력에서 확인했다. 하지만 실제 compile은 실행하지 않았다. 기본 recipe는 OpenAI API key와 약 40GB accelerator memory를 요구하며, 이 글을 위해 유료 API 호출을 만들거나 사용자의 비밀값을 다루지 않았다.
논문도 합성 supervision이 teacher 오류를 물려받을 수 있다고 적는다. application 사례는 조합과 구조화 실행을 보여 주지만 체계적인 user study는 후속 과제로 남았다. 공개 저장소는 실행 스크립트를 제공하지만 논문의 FuzzyBench-Hard 전체 원시 결과를 이 조사에서 독립 재계산하지는 못했다.
그래서 이 연구의 실용적인 결론은 "프롬프트를 컴파일하면 API가 필요 없다"가 아니다. 반복되는 좁은 fuzzy function에서는 큰 모델의 역할을 매 호출의 답변자에서 build-time teacher로 옮길 수 있다. 그 선택이 이득인지는 함수의 수명, 호출량, 검증 가능성, compile provenance를 같이 봐야 한다.


댓글
댓글 쓰기