최고 모델도 44.4%: 코딩 전에 명세 결함을 찾는 능력은 왜 따로 재야 하나
코딩 에이전트 평가는 대개 요구사항이 이미 정답처럼 정리된 뒤 시작한다. 이슈와 테스트를 건네고, 에이전트가 올바른 패치를 만드는지 본다. 실제 개발에서는 순서가 자주 뒤집힌다. 구현 전에 제안서부터 읽고 빠진 제약, 모순, 애매한 표현을 찾아야 한다. 잘못된 명세를 빠르게 구현해도 결과는 잘못된 방향으로 더 빨리 간다.
사전 공개 논문 「SpecBench」는 이 앞단을 따로 시험했다. 가장 높은 점수를 받은 GPT-5.4의 정확도는 44.4%였다. 다만 이 숫자를 "실제 결함의 44.4%를 찾았다"고 그대로 옮기면 안 된다. 점수는 과거 RFC 토론에서 골라 만든 정답 집합, 예측 개수 제한, 핵심 항목 가중치, LLM 심판의 매칭을 거친 값이다. 무엇을 분모로 삼았는지부터 읽어야 한다.
코드를 고치는 시험과 명세를 의심하는 시험
SpecBench의 입력은 초기 RFC 제안서, 그 시점 직전의 코드베이스, 그리고 그보다 과거의 RFC 기록이다. 평가 대상은 Kubernetes, React, Rust, TVM, vLLM 다섯 생태계다. 에이전트는 제안 이후의 Git·GitHub 이력이나 인터넷을 볼 수 없다. 미래의 리뷰 답안을 검색하지 못하게 시점을 고정한 셈이다.
에이전트가 해야 할 일도 패치 작성이 아니다. 초기 제안에서 누락, 모호함, 불일치, 잘못된 가정을 찾아 목록으로 내야 한다. 논문은 이를 명세 수준 추론이라고 부른다. 구현 테스트가 "주어진 요구를 만족했나"를 묻는다면, 이 평가는 "그 요구부터 충분히 안전한가"를 묻는다.
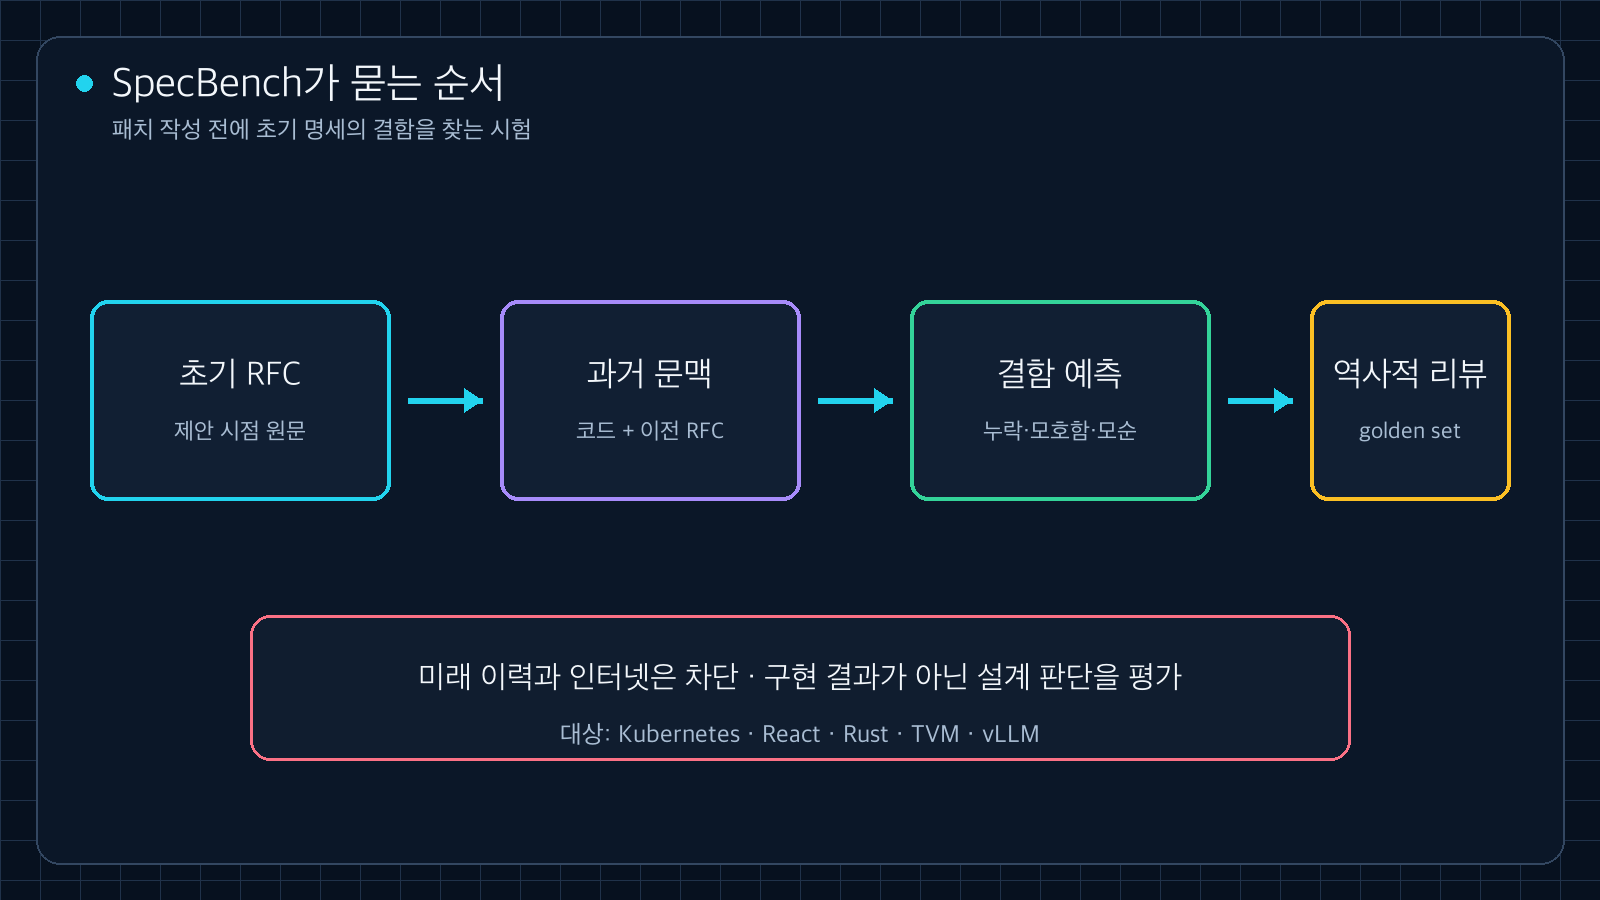
그림 1. SpecBench는 제안 이후의 이력을 차단하고 구현 결과가 아닌 초기 명세의 결함 발견을 평가한다. 출처: arxiv.org/html/2605.30314v1.
이 구분은 실무에서도 유용하다. 계획 모드가 길다고 명세 검토가 잘 된 것은 아니다. 에이전트가 파일 구조를 자세히 설명하면서도 롤백, 호환성, 권한 경계 같은 핵심 질문을 빼먹을 수 있다. 계획의 길이 대신 발견한 결함의 종류와 근거를 봐야 한다.
44.4%는 어떤 비교에서 나왔나
논문 그림 3의 전체 정확도는 GPT-5.4 44.4%, Claude Haiku 4.5 35.9%, Claude Sonnet 4.6 34.4%, Gemini 3 Flash 32.1%, GPT-5.1 Codex-mini 24.8%다. 같은 실행 환경의 기본 추론 설정을 사용했으며 Codex CLI 0.104.0, Claude Code CLI 2.1.12, Gemini CLI 0.24.0이 기록돼 있다.
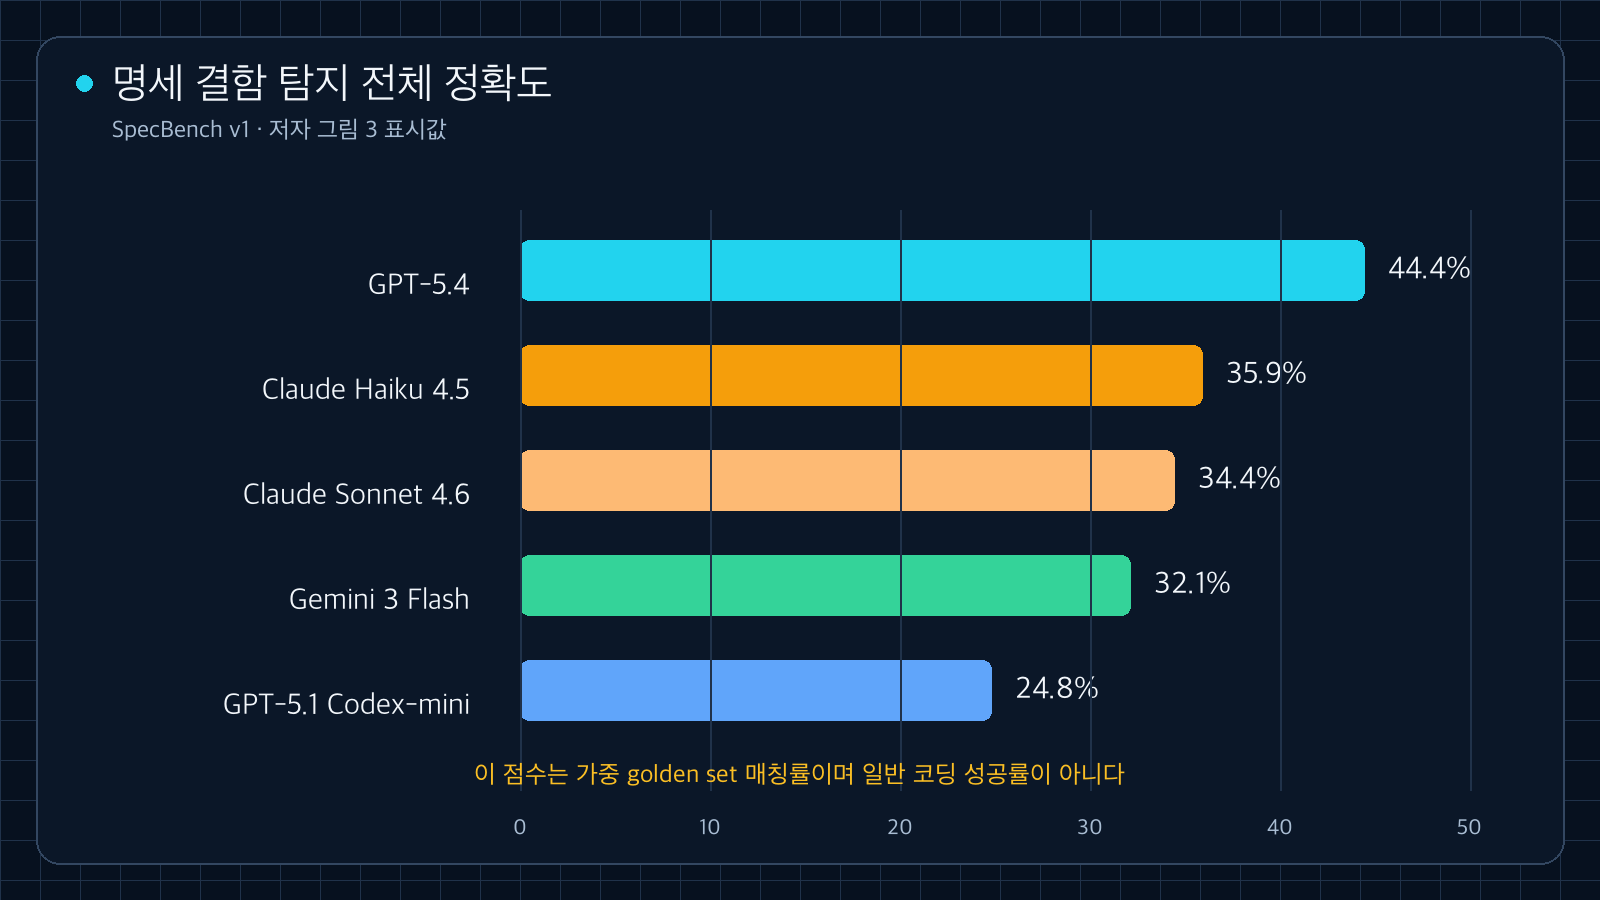
그림 2. SpecBench v1 전체 정확도. 일반 코딩 성공률이 아니라 가중 golden set 매칭률이다. 출처: arxiv.org/html/2605.30314v1.
수치가 낮다는 사실은 눈에 띄지만, 모델 순위를 일반 코딩 능력 순위로 읽으면 곤란하다. 이 시험은 실행 피드백 없이 과거 설계 토론의 결함을 찾아내는 좁은 능력을 잰다. 저장소별로도 양상이 달랐다. 논문은 1위 모델이 React와 vLLM에서 2위보다 각각 9.5%p, 8.6%p 앞섰다고 적지만, 모든 저장소에서 같은 간격을 보인 것은 아니다.
핵심 항목과 확장 항목의 차이도 크다. GPT-5.4는 핵심 49.8%, 확장 23.0%였다. 다른 모델도 모두 핵심 점수가 더 높았다. 합의가 큰 결함은 상대적으로 잘 찾았지만, 한두 리뷰어가 제기한 주변 조건까지 넓게 포착하는 데는 더 약했다는 뜻이다.
정답 집합은 역사적 리뷰를 압축한 것이다
연구진은 채택됐고 전문가 토론이 충분했던 RFC를 골랐다. 과거 기여자와 유지관리자가 실제 토론에서 지적한 결함을 추출한 뒤, LLM 전문가 패널이 5점 척도로 중요도를 매겼다. 평균 3점 이상이면서 3분의 2 이상이 동의한 항목을 core로 분류했고, 나머지는 extended로 뒀다. 점수에서는 core에 두 배 가중치를 줬다.
이 설계는 한 사람의 취향을 정답으로 고정하는 문제를 줄이지만 새 가정을 만든다. 3점, 3분의 2, 두 배라는 경계는 이 초기 버전의 휴리스틱이다. 사람 도메인 전문가가 금본위 라벨을 확정한 것도 아니다. 논문 자체가 다음 버전에서 인간 검증과 인간 기준선을 추가하겠다고 밝힌다.
또 채택된 RFC만 고른 표본은 치명적인 결함 때문에 거절되거나 장기 정체된 제안을 충분히 대표하지 못한다. "승인 과정에서 실제로 논의된 문제를 얼마나 되찾았나"에는 답할 수 있어도, "모든 위험한 설계를 얼마나 잘 막나"까지 증명하지는 않는다.
많이 말하면 유리한 문제를 어떻게 막았나
열린 질문에서는 결함 후보를 길게 늘어놓으면 우연히 정답과 겹칠 수 있다. SpecBench는 이를 막기 위해 예측 예산을 둔다. 정답 집합 크기를 |G|라 할 때 기본 상한은 ceil(1.25 × |G|)다. 정답이 10개면 최대 13개를 낼 수 있다. 정답 집합 밖의 주장은 오답으로 확정하지 않지만 점수도 주지 않는다.
문장 표현이 다른 두 결함을 같은 것으로 볼지도 문제다. 연구진은 예측과 정답을 대상(Subject), 결함 관계(Predicate), 영향(Impact)으로 분해했다. 그 뒤 GPT-5.4와 Sonnet 4.6이 각각 두 번 판단해 작업당 네 개 판정을 만들고, 네 번 중 세 번 이상 같은 매칭을 낸 경우만 인정했다.
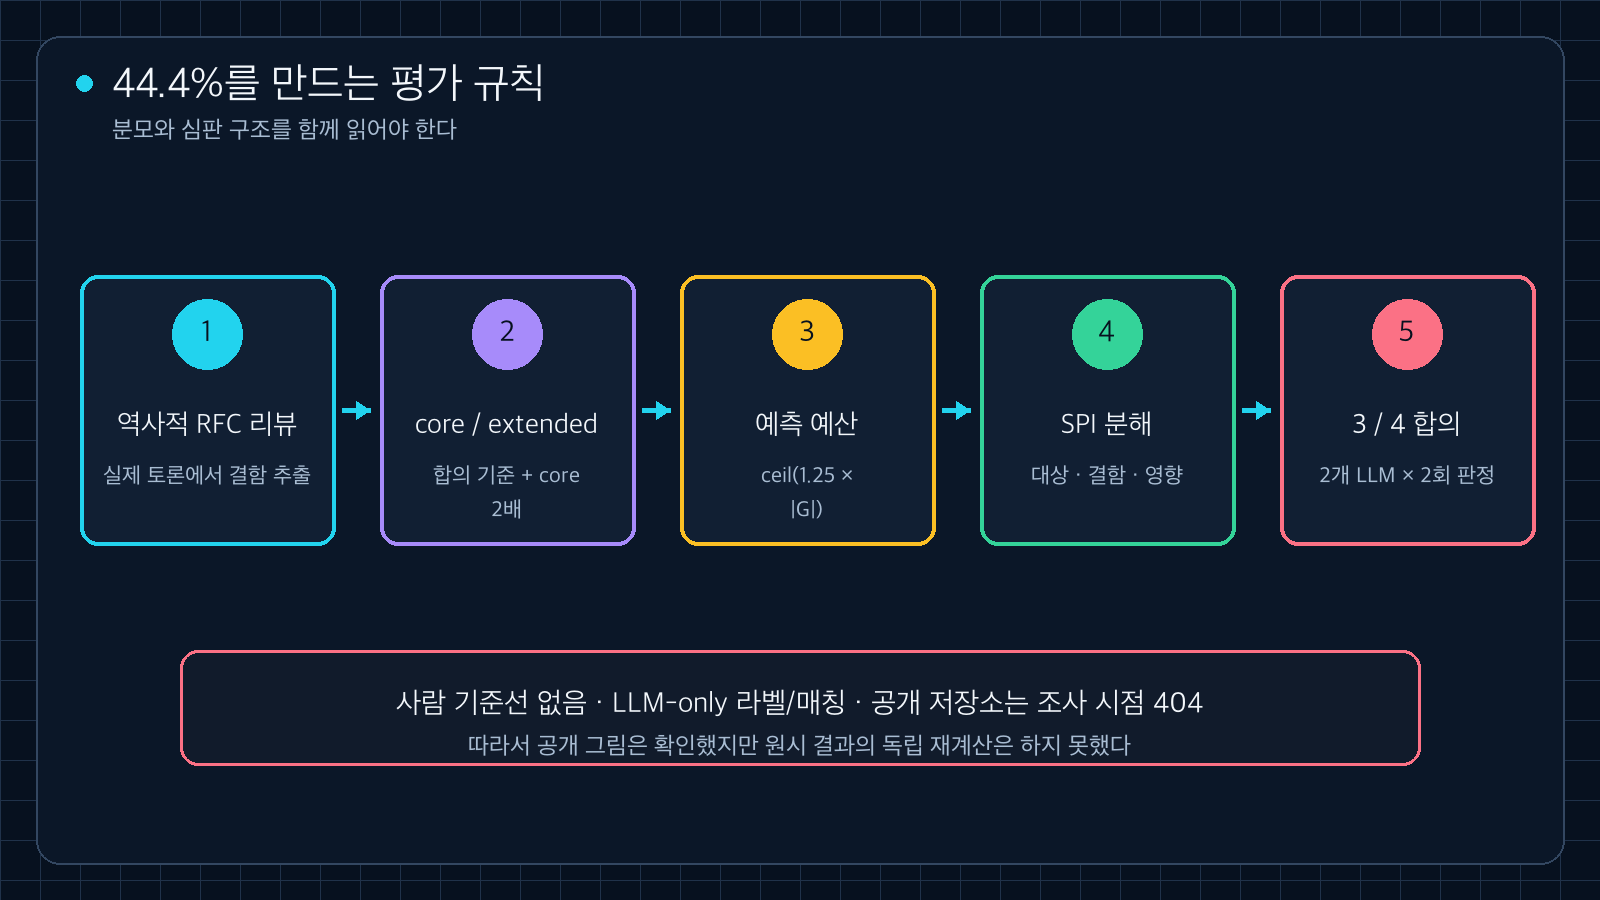
그림 3. 44.4%를 만드는 채점 파이프라인. 사람 기준선과 원시 결과 재계산은 이번 v1 검증 범위 밖이다. 출처: arxiv.org/html/2605.30314v1.
이 방식은 단순 문자열 비교보다 낫지만 독립적인 인간 재채점은 아니다. 평가받는 모델과 심판 모델이 겹치고, 심판 네 번도 두 모델에서 나온 반복 판정이다. 논문은 Jaccard 유사도로 판정 간 합의를 보고했으나, 합의가 곧 정답을 뜻하지는 않는다.
계획 모드에 붙일 수 있는 작은 검토 루프
이 논문을 제품 점수표처럼 복사할 필요는 없다. 대신 구현 전 검토를 별도 산출물로 만들 수 있다.
- 에이전트가 제안서의 목표와 수정 금지 영역을 한 문단으로 다시 쓰게 한다.
- 발견 항목마다 대상, 빠진 조건, 실패 영향을 분리해 적게 한다.
- 호환성, 보안, 성능, 데이터 마이그레이션, 롤백을 고정 질문으로 둔다.
- 근거가 코드인지 문서인지 과거 결정 기록인지 표시한다.
- 구현 전에 담당자가 핵심 결함과 참고 의견을 나눠 확인한다.
- 패치 테스트와 별개로 "명세가 바뀌어야 통과하는 검토"를 기록한다.
목표는 에이전트가 더 많은 걱정을 늘어놓게 하는 것이 아니다. 예측 예산처럼 검토 항목 수에 상한을 두고, 실패 영향과 근거가 약한 항목은 뒤로 보내는 편이 낫다. 긴 계획보다 수정 결정을 바꾸는 질문이 중요하다.
아직 재현할 수 없는 부분
이번 글에서는 arXiv v1 HTML·PDF와 공식 그림의 표시값을 대조했다. 논문이 공개 저장소로 안내한 github.com/kevins981/SpecBench는 조사 시점에 HTTP 404였고 git clone도 Repository not found로 끝났다. 그래서 원시 과제 수, 개별 예측, 제외 규칙, 집계 코드를 독립적으로 다시 실행하지 못했다.
현재 버전은 결함 발견만 평가한다. 발견한 문제를 수정된 명세로 바꾸는 능력, 그 명세가 실제 구현에서 더 나은 결과를 만드는지, 사람 전문가보다 잘하는지는 아직 결과가 없다. 44.4%는 이 제한된 v1 설계 안의 집계값이다.
그럼에도 질문 하나는 남는다. 코딩 에이전트가 패치를 잘 만든다는 증거만으로, 무엇을 만들어야 하는지까지 잘 판단한다고 볼 수 있는가. SpecBench의 답은 아직 "아니다"에 가깝다. 구현 성공률과 명세 검토 품질은 같은 점수표에 넣지 말고 따로 재는 편이 안전하다.
참고 자료와 작성 범위
- SpecBench arXiv 초록과 버전 메타데이터
- SpecBench HTML 전문
- 동일 v1 PDF
- 논문에 기재됐지만 조사 시점에 404였던 저장소
- Kubernetes Enhancement Proposals
- Rust RFC 저장소
이 글은 AI를 활용해 공개 논문의 설계와 수치를 대조하고, 실무용 검토 절차로 다시 쓴 해설입니다. 제품 후기나 저자 실험의 독립 재현이 아니며, 제안한 체크리스트의 효과를 직접 측정했다고 주장하지 않습니다.


댓글
댓글 쓰기