코딩 에이전트는 왜 본 기능의 59%를 놓쳤나: ProgramDistill이 보여 준 관찰의 병목
코딩 에이전트에게 잘 작동하는 웹 앱과 비어 있는 구현을 나란히 주면 어디까지 복원할 수 있을까요. 9월 14일 공개된 ProgramDistill은 이 질문을 이슈 설명이나 정답 테스트가 아니라 실제 브라우저 행동으로 측정합니다. 에이전트는 원본 앱의 소스 코드를 볼 수 없습니다. 화면을 조작해 동작을 알아내고, 현재 앱의 코드를 고친 뒤, 같은 행동을 다시 실행해 결과를 맞춰야 합니다.
결과는 단순한 모델 순위보다 흥미롭습니다. 가장 강한 모델도 전체 앱 재구성에서 원자 기능은 평균 58.98%, 여러 기능이 이어진 워크플로는 49.15%만 복원했습니다. 연구진이 실패 977건을 분류하자 59.2%는 구현을 틀린 것이 아니라 애초에 원본에서 그 행동을 관찰하지 않은 경우였습니다. 코딩 능력 못지않게 "무엇을 확인했는가"가 병목이 된 셈입니다.
실행 가능한 앱을 명세로 바꾸는 방법
ProgramDistill의 출발점은 문서가 불완전해도 작동 중인 프로그램에는 행동 명세가 남아 있다는 생각입니다. 버튼을 누른 뒤 어떤 화면이 열리는지, 저장한 값이 다시 열었을 때 남는지, 앞 단계의 상태가 다음 동작에 어떤 조건을 만드는지는 실행을 통해 확인할 수 있습니다.
연구진은 이 과정을 mine-craft-patch 세 단계로 자동화했습니다. 먼저 mining 에이전트가 앱을 탐색해 브라우저 행동과 성공 신호를 기록합니다. clean-state replay를 통과한 행동만 남깁니다. crafting 에이전트는 그 행동을 만드는 구현을 제거하되 앱 자체는 빌드되고 선행 기능은 살아 있도록 마스크를 만듭니다. 마지막으로 coding 에이전트가 참조 앱을 관찰하면서 빠진 기능을 복원합니다.
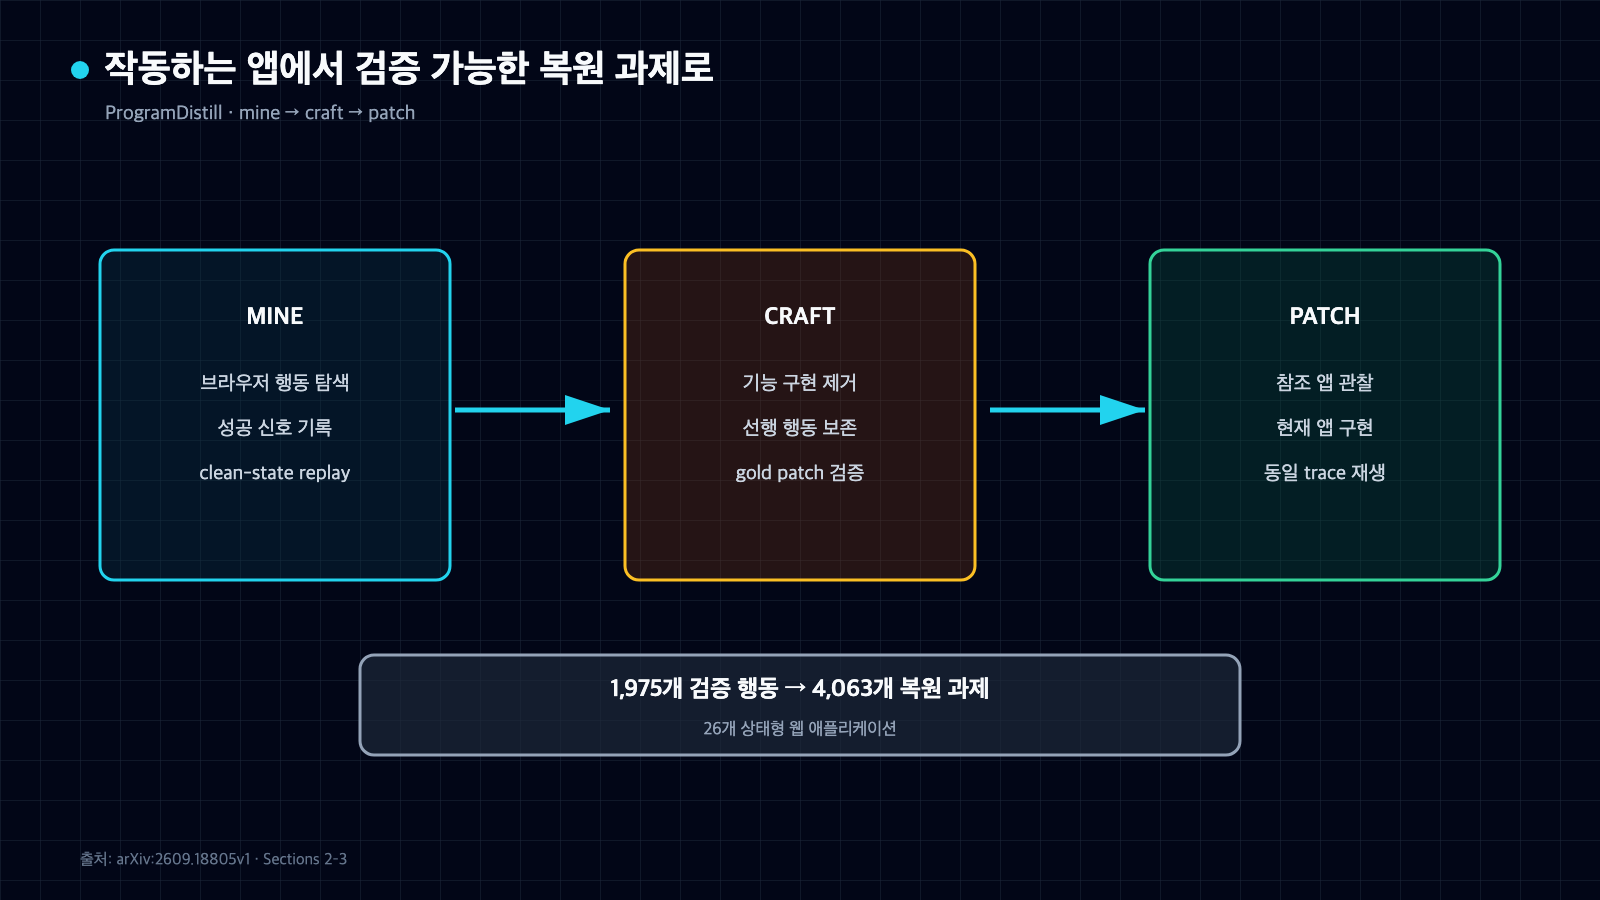
그림 1. 같은 replay가 원본, 마스크된 앱, 복원 결과를 차례로 검증한다. 출처: arxiv.org/html/2609.18805v1.
26개 앱에서 제안된 목표는 2,800개였습니다. 그중 2,350개가 상호작용 trace로 수집됐고, clean-state replay에 성공한 것은 2,165개, 최종 검증을 통과한 행동은 1,975개였습니다. 이 행동에서 원자 과제 2,862개와 누적 과제 1,201개, 합계 4,063개를 만들었습니다. 생성량만 보고 성공이라고 한 것이 아니라, 같은 초기 상태와 같은 앱 시각에서 다시 실행되는 행동만 벤치마크에 넣은 점이 중요합니다.
기능 하나와 연결된 워크플로는 다른 문제다
평가용 ProgramDistill-300은 깊이 1부터 8까지 300개 과제를 고르게 뽑았습니다. 깊이 1은 기능 하나를 복원하는 과제이고, 깊이가 커질수록 로그인, 객체 생성, 권한 변경, 이동, 편집처럼 선행 상태가 필요한 기능을 함께 복원해야 합니다.
최고 성능 모델인 GPT-6 Astra는 깊이 1에서 100%를 기록했지만 깊이 8에서는 64%로 떨어졌습니다. Claude Opus 5는 96%에서 32%, GPT-5.6 Sol은 92%에서 32%로 내려갔습니다. 단순히 prompt가 길어져서 생긴 현상으로만 보기도 어렵습니다. 논문의 context band 분석에서는 평균 prompt 크기가 비슷한 실행끼리 묶어도 깊이에 따라 성공률이 계속 하락했습니다.
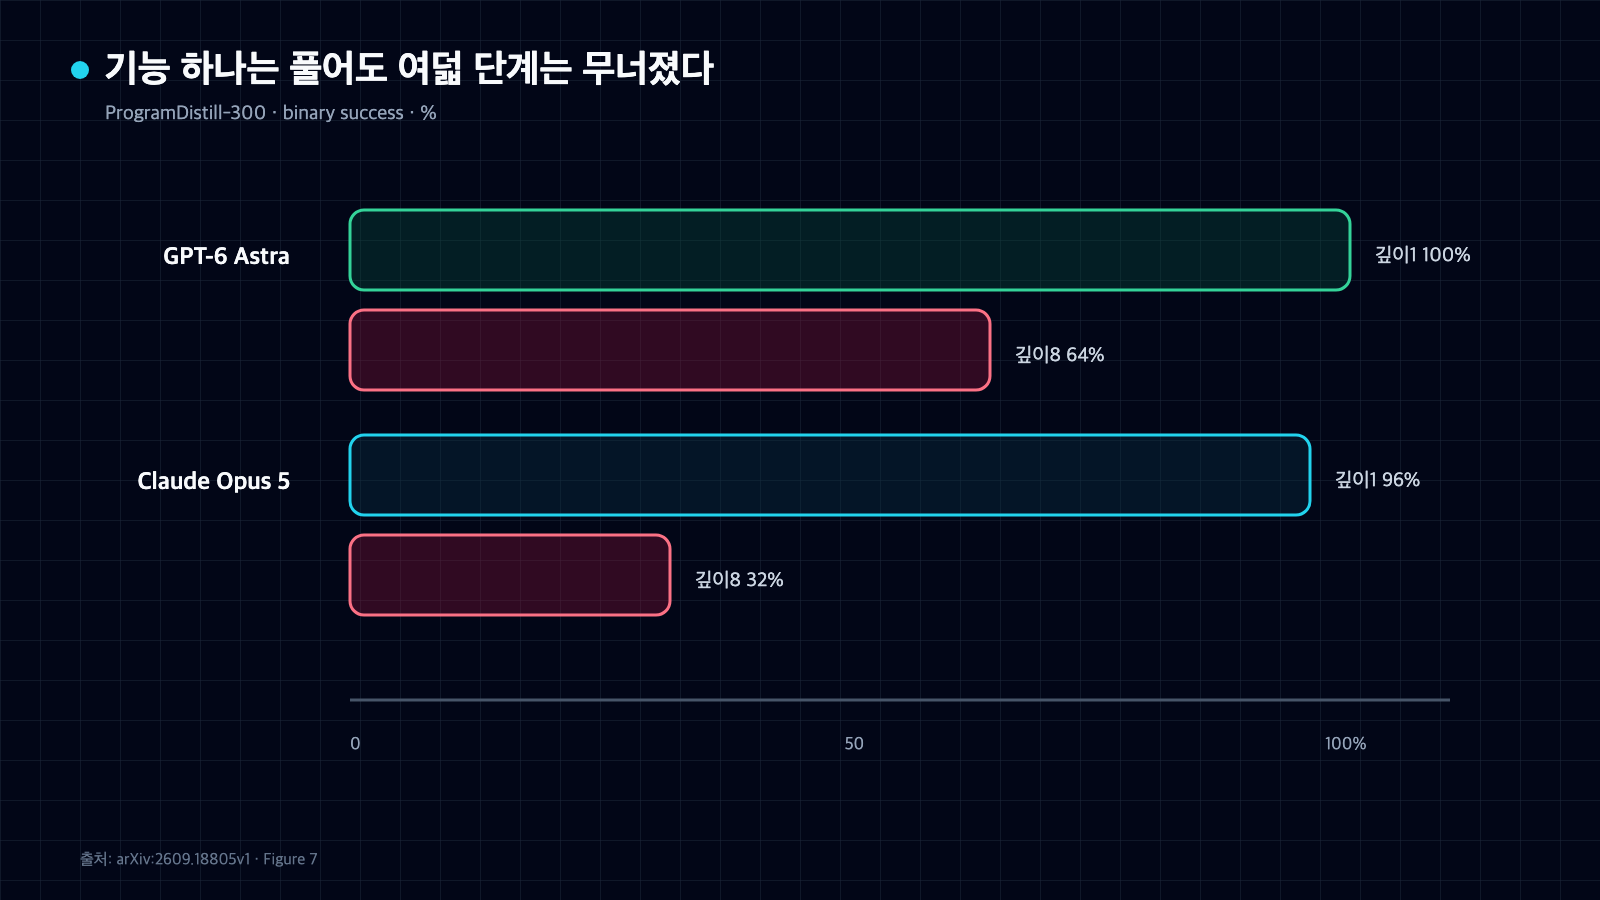
그림 2. 개별 기능 성공이 여덟 단계 누적 workflow 성공을 보장하지 않았다. 출처: arxiv.org/html/2609.18805v1.
깊이 1에서 8로 갈 때 복원할 코드 줄 수는 9.3배, 목표 행동의 브라우저 액션 수는 10.7배 늘었습니다. 그런데 목표 하나당 참조 앱 관찰은 평균 34.60회에서 8.46회로, 수정한 앱 관찰은 27.69회에서 6.81회로 줄었습니다. 해야 할 일은 늘었는데 기능 하나를 이해하고 재검증하는 데 쓴 비중은 약 75% 감소한 것입니다.
이 수치는 "더 오래 실행하면 해결된다"는 결론을 보장하지 않습니다. 다만 깊은 작업에서 에이전트가 검증 예산을 어디에 배분하는지 봐야 한다는 신호는 분명합니다. 전체 step 수가 늘어도 기능당 관찰이 줄면 마지막에 수정한 경로를 정확히 다시 밟지 못할 수 있습니다.
977건의 실패에서 드러난 네 가지 원인
전체 앱 재구성은 12개 상태형 웹 앱에서 세 모델로 평가했습니다. 원자 행동 테스트 590개와 누적 워크플로 테스트 413개를 썼고, 36개 실행에서 실패한 원자 행동 977건을 별도로 분류했습니다.
가장 큰 범주는 원본에서 행동을 보지 않은 경우로 59.2%였습니다. 관련 행동을 봤지만 구현하지 않은 경우는 1.8%, 화면에 보이는 형태를 잘못 구현한 경우는 11.1%, 상태·경로·결과가 틀린 경우는 27.9%였습니다. 후자의 세 범주를 합치면 40.8%입니다. 결국 실패는 탐색 누락과 복원 오류 두 축으로 나뉩니다.
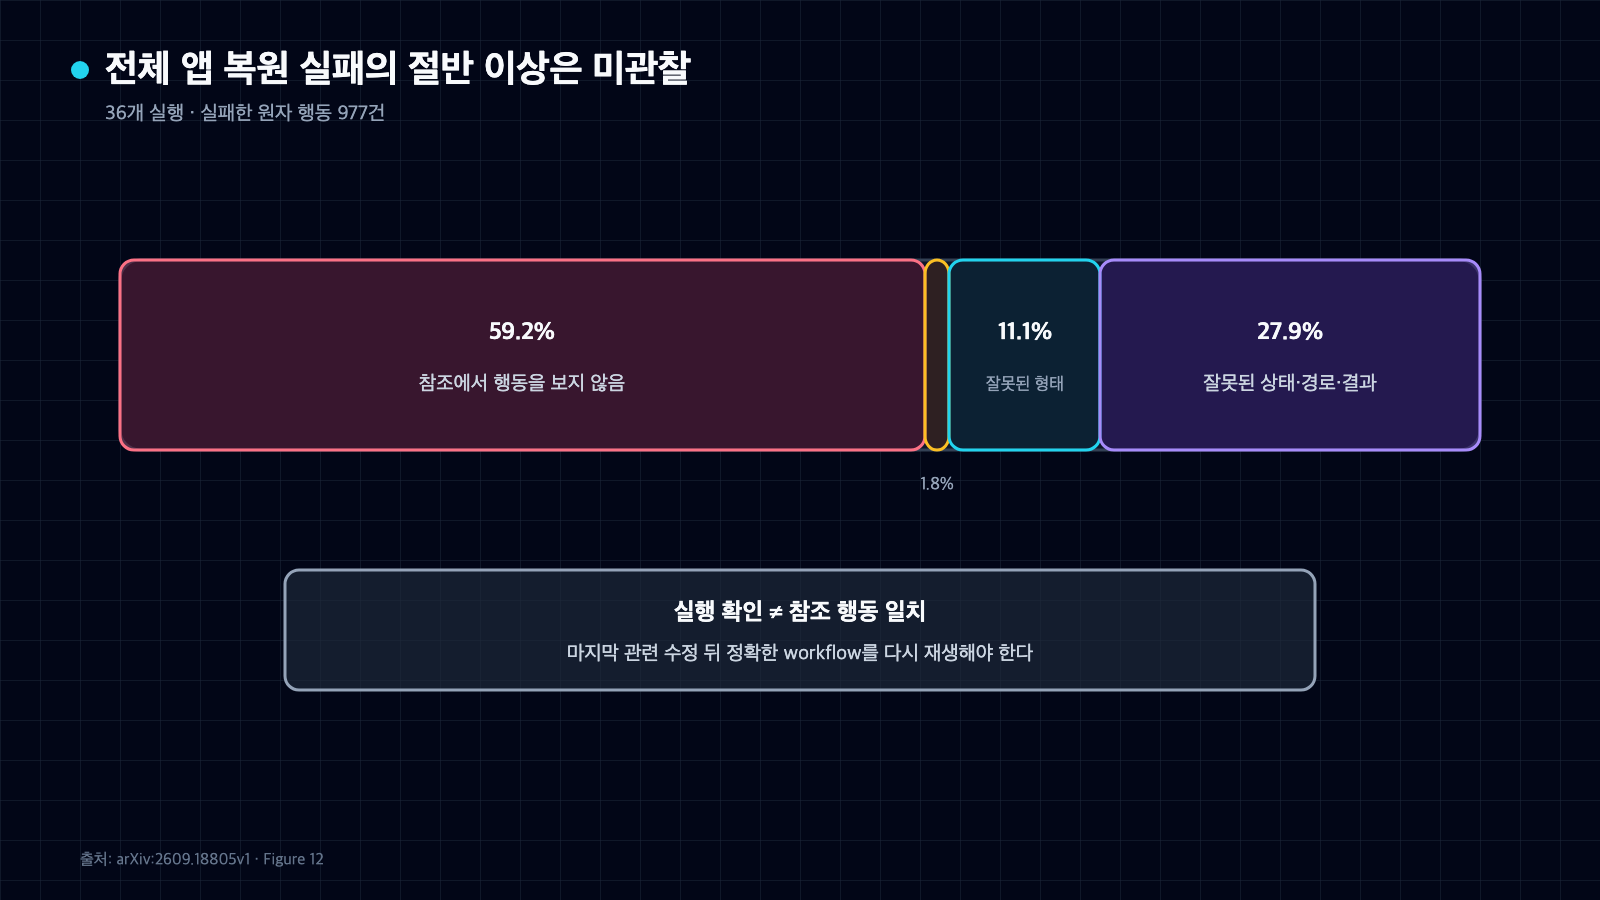
그림 3. 실패의 59.2%는 관련 행동을 참조 앱에서 보지 않은 경우였다. 출처: arxiv.org/html/2609.18805v1.
구체적인 실패 사례가 이 구분을 잘 보여 줍니다. Trello 복제 앱에서는 카드 drag 자체는 구현했지만 가운데에 놓았을 때 순서가 참조와 반대로 남았습니다. 이 에이전트는 마지막 관련 수정 뒤에 다른 보드 기능을 확인했을 뿐, 같은 drag 경로를 다시 재생하지 않았습니다. Reactive Resume에서는 자체 이력서 생성과 export는 확인했지만 외부 JSON Resume import schema 변환을 빠뜨려 렌더가 깨졌습니다. Baserow 사례는 화면 제목만 "Periodic trigger"로 바뀌고 실제 form은 database trigger 설정이 남았습니다. W&B 복제 앱은 report 편집기를 그렸지만 제목과 요약의 변경을 저장하지 못했습니다.
syntax check, HTTP 성공, 일부 텍스트 일치는 앱이 실행된다는 사실만 보여 줍니다. 참조와 같은 행동을 한다는 증거는 아닙니다. 최종 수정 뒤 정확한 행동 sequence를 다시 실행하고, 화면뿐 아니라 저장된 상태와 다음 단계 결과까지 비교해야 차이를 잡을 수 있습니다.
팀에서 바로 적용할 수 있는 검증 방식
ProgramDistill은 새 벤치마크이지만 실무 교훈은 낯설지 않습니다. 에이전트에게 "이 화면처럼 만들어 줘"라고 맡길 때는 결과 화면 한 장보다 행동 계약을 먼저 적는 편이 안전합니다.
- 기능마다 시작 상태, 행동 순서, 관찰할 결과를 묶습니다.
- 저장·이동·권한처럼 다음 단계에 영향을 주는 상태 전이를 별도 검증합니다.
- 코드가 바뀐 뒤에는 관련 workflow를 처음부터 다시 실행합니다.
- syntax, unit test, API 200과 브라우저 행동 일치를 서로 다른 gate로 둡니다.
- 긴 작업에서는 전체 step 수보다 기능당 관찰·재검증 횟수가 줄지 않는지 확인합니다.
참조 앱이 있다고 해서 복제 권한까지 생기는 것은 아닙니다. 논문도 공개·오픈소스 기반의 self-contained 앱으로 범위를 제한했고, 저작권이 있는 제품을 무단 복제하는 misuse 가능성을 명시했습니다. 실무에서는 자사 이전 버전, 승인된 prototype, 테스트 fixture처럼 권한이 분명한 참조만 써야 합니다.
이 결과를 어디까지 믿어야 하나
이 연구는 화면 screenshot 없이 visible text, 접근성 정보, 상호작용 요소를 구조화해 에이전트에게 제공했습니다. 픽셀 fidelity를 평가한 결과가 아닙니다. 외부 서비스와 nondeterministic state가 있는 실제 운영 앱, desktop·mobile 앱도 아직 범위 밖입니다. 과제 생성에는 GPT-5.6 Sol 하나를 사용했기 때문에 발견한 행동과 mask 품질이 construction model에 의존할 수 있습니다.
ProgramDistill의 replay verifier 자체가 모든 의미를 포착한다고 볼 수도 없습니다. selector 안정성, 관찰 품질, browser harness가 바뀌면 수집 가능한 행동과 측정 성능도 달라질 수 있습니다. 모델 숫자를 절대적인 개발 능력으로 읽기보다, reference-guided 작업에서 탐색과 검증이 어떻게 무너지는지 보는 진단 도구로 읽는 편이 맞습니다.
제가 이 논문에서 가장 눈여겨본 값은 84.3%라는 선두 점수보다 실패의 59.2%입니다. 구현 전에 보지 않은 기능은 잘 고칠 수도 없습니다. 코딩 에이전트를 긴 작업에 투입할수록 "많이 수정했는가"보다 "정확한 workflow를 보고, 마지막 변경 뒤 같은 workflow를 다시 확인했는가"를 기록해야 합니다.


댓글
댓글 쓰기