6일 동안 코드는 다 썼는데 연구는 두 편 모두 탈락했다
AI 연구 에이전트가 문헌을 읽고, GPU 환경을 고치고, 수백 번의 실험을 돌리고, 논문 PDF까지 완성하면 연구를 해낸 걸까. 코드와 문서만 보면 그렇게 보일 수 있다. 문제는 연구의 목표가 "작업을 끝내는 것"이 아니라, 새롭고 설득력 있는 증거를 만드는 데 있다는 점이다.
CRUX 연구진은 이 차이를 보기 위해 공개되지 않은 NeurIPS 2026 투고 논문 두 편의 핵심 질문을 에이전트에게 맡겼다. 에이전트는 원래 논문과 결과를 볼 수 없었다. 대신 6일, 실행당 3,000달러의 API 예산, GPU 크레딧, 가상 머신과 공개 웹을 받았다. 마지막 평가는 그 질문을 수개월 동안 연구한 원 논문 저자들이 맡았다.
결과는 선명했다. Persona 연구는 6점 척도에서 2점인 Reject, TabPFN 연구는 1점인 Strong Reject였다. 둘 다 엔지니어링은 끝냈지만, 연구 질문에 의미 있는 진전을 만들지는 못했다.
정답을 숨긴 채 같은 질문을 풀게 한 실험
연구진은 이 방식을 "shadow evaluation"이라고 부른다. 기존 벤치마크처럼 정해진 점수 하나를 올리는 것도 아니고, AI가 쓴 논문을 일반 학회 심사에 섞어 넣는 것도 아니다. 아직 공개되지 않은 실제 연구 질문을 주고, 그 질문을 가장 잘 아는 원 저자가 결과를 검토한다.
첫 질문은 LLM의 페르소나를 가중치 공간에서 측정하고 제어할 수 있는지였다. 두 번째는 TabPFN 같은 표형 foundation model이 배포 데이터에서 성능 저하를 겪는지, 정답 라벨 없이 감지할 수 있는지였다. 두 과제 모두 자동 점수만 따라가서는 풀기 어려웠다. 어떤 데이터가 충분한지, 실패한 가설을 언제 버릴지, 기존 연구보다 무엇이 새로워야 하는지를 계속 판단해야 했다.
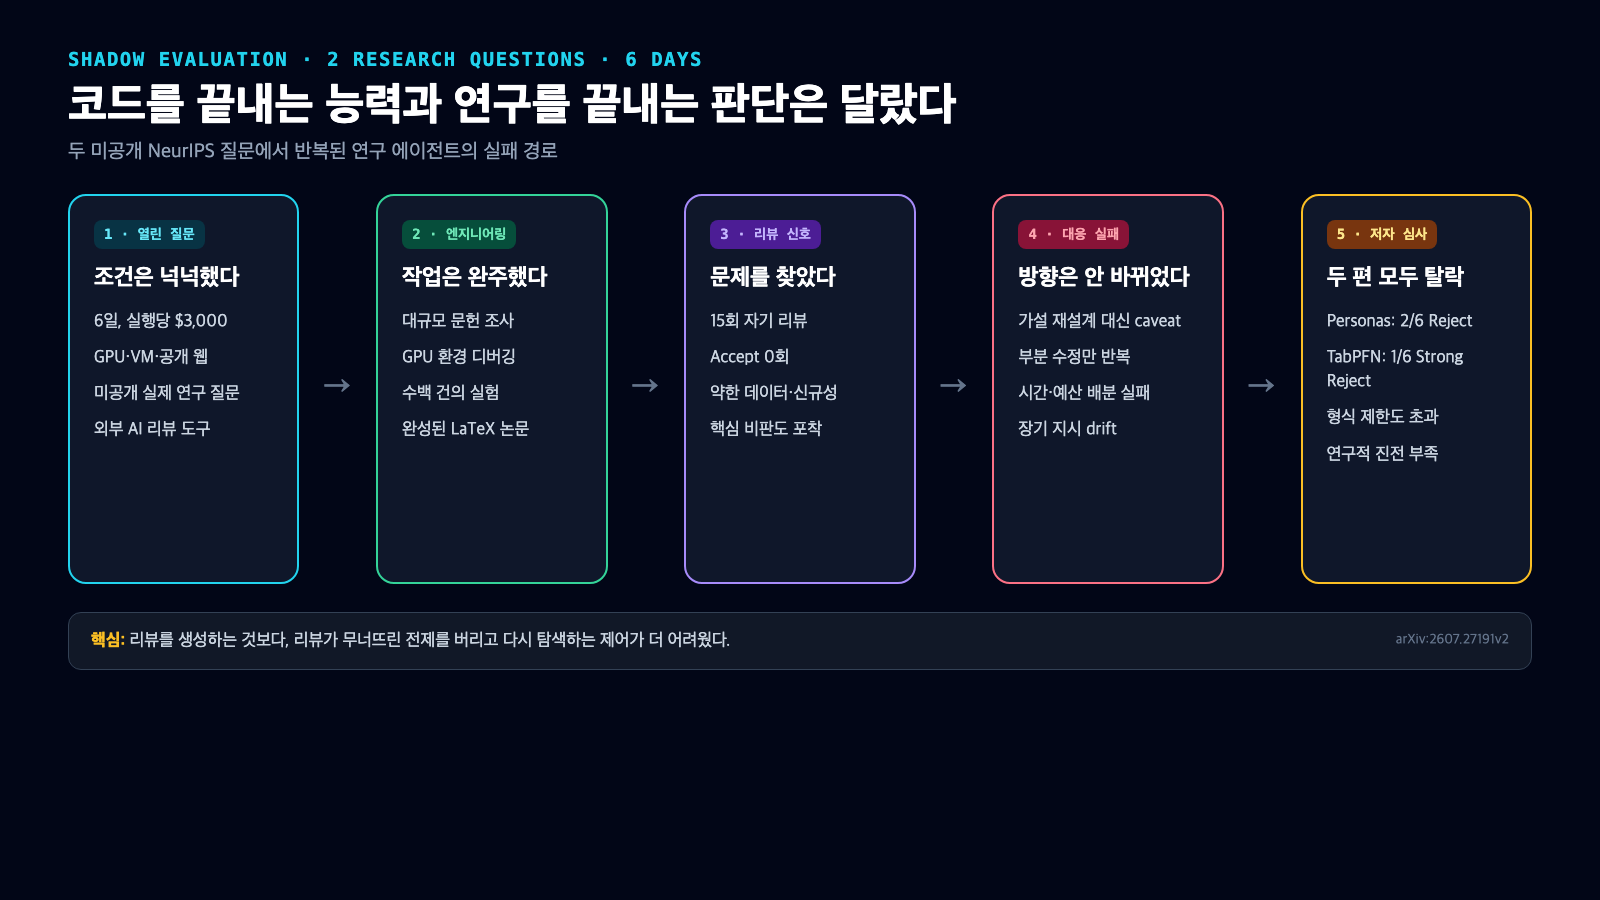
그림 1. 두 shadow evaluation에서 에이전트는 엔지니어링과 문제 발견에는 성공했지만, 핵심 전제를 버리고 다시 탐색하는 단계에서 실패했다. 출처: arxiv.org/abs/2607.27191.
엔지니어링은 실제로 꽤 잘했다
에이전트는 대규모 문헌 조사를 수행했고, GPU pod의 crash loop를 고쳤으며, 수백 건의 실험과 robustness check를 돌렸다. 외부 AI 리뷰 도구에 논문을 보내고 결과를 회수했으며, camera-ready LaTeX 문서도 만들었다. 연구진이 직접 개입한 부분은 scaffold 오류 수정, 계정·저장소 준비, 24시간 연장, 읽기 쉬운 문장으로 다시 쓰라는 요청 같은 운영 지원이었다.
이 대목은 실패를 단순한 도구 사용 미숙으로 설명하기 어렵게 만든다. 실제로 사전 설문에 참여한 연구자 11명 중 9명은 해결되지 않는 엔지니어링 오류가 반복될 것으로 예상했지만, 에이전트는 거의 모든 환경 문제를 해결했다. 약점은 코드를 실행하는 단계보다, 그 결과가 논문으로서 충분한지 판정하는 단계에서 드러났다.
자기 리뷰가 계속 탈락인데도 방향을 바꾸지 못했다
두 에이전트의 자기 리뷰는 15차례 수정 동안 한 번도 Accept를 주지 않았다. 리뷰는 작은 표본, 손으로 고른 데이터, 약한 신규성처럼 사람 심사자가 나중에 지적한 문제도 상당수 찾아냈다. 그런데 에이전트는 중심 가설이나 실험 설계를 다시 짜기보다 문장을 좁히고 caveat를 더했다. 논문은 더 정직해졌지만 더 중요한 연구가 되지는 않았다.
Personas 실행은 36~48시간의 탐색을 계획해 놓고 5시간 만에 한 방법에 모였다. 두 실행 모두 가장 야심 찬 목표를 첫 10시간 안에 접었고, 이후에는 프로젝트 수준에서 다시 시작하지 않았다. TabPFN 실행은 여섯 접근을 14시간 안에 반박한 뒤에도 남은 110시간 동안 해법의 큰 방향을 바꾸지 않았다.
시간과 예산을 남기고도 끝냈다
두 main run은 모두 3,000달러 API 예산의 절반도 쓰지 않았다. Personas는 1,130달러, TabPFN은 1,235달러를 썼다. 한 실행은 마감 7시간 전에 완료를 선언했고, 자기 리뷰가 Reject인 상태에서도 종료했다. 연구진은 더 쓰라고 명시했고 에이전트는 잔여 예산을 확인할 수 있었지만, 시간·토큰·GPU를 연구 가치가 높은 곳에 다시 배분하지 못했다.
반대 사례도 흥미롭다. Codex와 GPT-5.6 Sol Ultra로 다시 돌린 robustness run은 같은 3,000달러를 이틀 조금 넘겨 모두 소진했다. 예산을 적게 쓰는 문제는 사라졌지만, 제대로 된 규모의 실험과 독창적 기여가 부족한 결과는 반복됐다. 많이 쓰거나 적게 쓰는 것보다, 어느 가설에 얼마를 배분할지 판단하는 능력이 핵심이었다.
다섯 실패 모드는 하나의 운영 문제로 연결된다
논문은 실패를 다섯 가지로 묶는다. 출판 가능한 연구의 기준을 잘못 판단했고, 설계 비판에 창의적으로 대응하지 못했으며, 막힌 접근에서 프로젝트 수준으로 backtrack하지 못했다. 시간과 예산을 제대로 감각하지 못했고, 며칠 동안 context가 압축되면서 초기 지시도 흐려졌다.
실무에서 이 문제는 "에이전트에게 더 긴 프롬프트를 주자"로 끝나지 않는다. 성공 기준, 중간 중단 조건, 예산 배분, 재탐색 규칙을 외부 상태로 관리해야 한다. 리뷰가 세 번 연속 핵심 soundness 문제를 지적하면 문장 수정이 아니라 가설과 데이터 설계를 다시 열어야 한다. 잔여 시간과 예산도 로그에만 표시할 게 아니라 다음 행동을 제한하는 제어 신호가 되어야 한다.
이 연구를 과장하면 안 되는 이유
표본은 작다. main run 두 건, reasoning 없는 pilot 두 건, 다른 모델과 scaffold를 쓴 robustness run 한 건이 전부다. 원 저자들은 자신의 방법을 선호할 수 있고, AI가 쓴 논문이라는 사실도 알고 있었다. 원 연구팀은 에이전트보다 더 오래 일하고 더 많은 GPU 시간을 썼다. OpenClaw의 thinking-block 오류로 세션 reset도 반복됐다.
따라서 이 결과는 "AI가 연구를 못 한다"는 결론이 아니다. 자동 검증이 가능한 최적화, 재현, 연구 엔지니어링에서는 다른 결과가 나올 수 있다. 이 논문이 보여 주는 범위는 더 좁고 유용하다. 현재의 frontier agent가 실제 미공개 질문을 받아 열린 탐색을 수행할 때, 엔지니어링 완료와 연구적 기여 사이에 큰 간격이 남아 있다는 초기 증거다.
연구 에이전트를 쓸 때의 체크리스트
먼저 결과물의 형식보다 반증 조건을 적는다. 어떤 데이터와 비교군이 없으면 중단할지, 무엇이 기존 연구보다 새로워야 하는지 명시한다. 다음으로 리뷰 결과를 우선순위로 압축한다. 사소한 문장 문제와 가설을 무너뜨리는 soundness 문제를 같은 목록에 두면 에이전트는 쉬운 수정부터 처리한다.
마지막으로 backtrack을 독립 동작으로 설계한다. 깨끗한 context의 새 subagent가 기존 접근을 모른 채 대안을 제안하게 하고, 시간·토큰·GPU의 잔여량에 따라 탐색과 검증 비율을 다시 계산한다. 장기 작업에서는 지시문을 기억에만 맡기지 말고, 길이 제한·리뷰 횟수·마감·중단 조건을 기계가 읽을 수 있는 상태로 둬야 한다.
참고 자료와 작성 범위
- arXiv 논문 v2: Can AI agents conduct open-ended AI research?
- CRUX 공개 자료: 전문가 리뷰·설문·에이전트 저장소·로그
- 공개된 Persona Cartography 논문
- Open-world evaluations 연구
- NeurIPS 2026 리뷰 가이드
이 글은 AI를 활용해 arXiv v2 본문과 공개 자료 페이지를 대조해 쓴 해설입니다. 에이전트 실행을 다시 돌리거나 제출 논문을 독립적으로 재채점하지 않았습니다. 점수와 실행 로그 해석은 연구진이 공개한 기록을 따르며, 두 사례를 모든 연구 에이전트로 일반화하면 안 됩니다.


댓글
댓글 쓰기