한 줄 버그에 60줄을 더한 패치: 테스트가 못 잡는 AI 과잉 편집
기존 함수의 경계 조건 한 줄만 고치면 되는 버그가 있었다. 정답 패치는 한 줄이고 원래 테스트 다섯 개를 모두 통과했다. 그런데 같은 코드를 받은 GPT-5.4는 입력 검증, 자료형 변환, NaN 처리와 재표본화까지 넣어 60줄을 추가했다. 이 패치도 테스트는 모두 통과했다. 실행 결과만 보면 둘은 같은 성공이지만, 리뷰할 코드와 새로 생긴 실패 표면은 전혀 같지 않다.
9월 3일 공개된 논문 「When Models Edit Too Much」는 이 현상을 '과잉 편집(over-editing)'으로 정의한다. 연구진은 BigCodeBench의 파이썬 함수 400개에 AST 수준 오류를 의도적으로 넣고, 원래 코드로 되돌리는 최소 수정과 모델 패치를 비교했다. 논문의 장점은 무엇이 최소 수정인지 추측하지 않아도 된다는 데 있다. 버그를 넣은 연산을 되돌리면 정답 패치가 되기 때문이다.
요약: 통과 여부와 수정 충실도는 다른 측정값이다
연구진은 패치를 세 축으로 봤다. 첫째는 테스트 통과율이다. 둘째는 깨진 코드에서 모델 패치까지 바뀐 토큰 수가 정답 패치보다 얼마나 더 큰지를 나타내는 excess Levenshtein distance다. 셋째는 정답보다 분기와 중첩을 얼마나 더 넣었는지를 보는 추가 cognitive complexity다.
400개 함수는 평균 10.4개의 실행 라인이었고, 정답 패치의 50.2%는 토큰 하나만 바꾸면 됐다. 91.8%는 두 토큰 이내였으며 두 줄을 넘긴 정답은 없었다. 이처럼 작은 수정을 요구하는 문제에서도 강한 모델은 테스트를 통과하면서 주변 코드를 넓게 다시 쓰곤 했다. Pass@1 하나만 기록하면 이 차이는 사라진다.
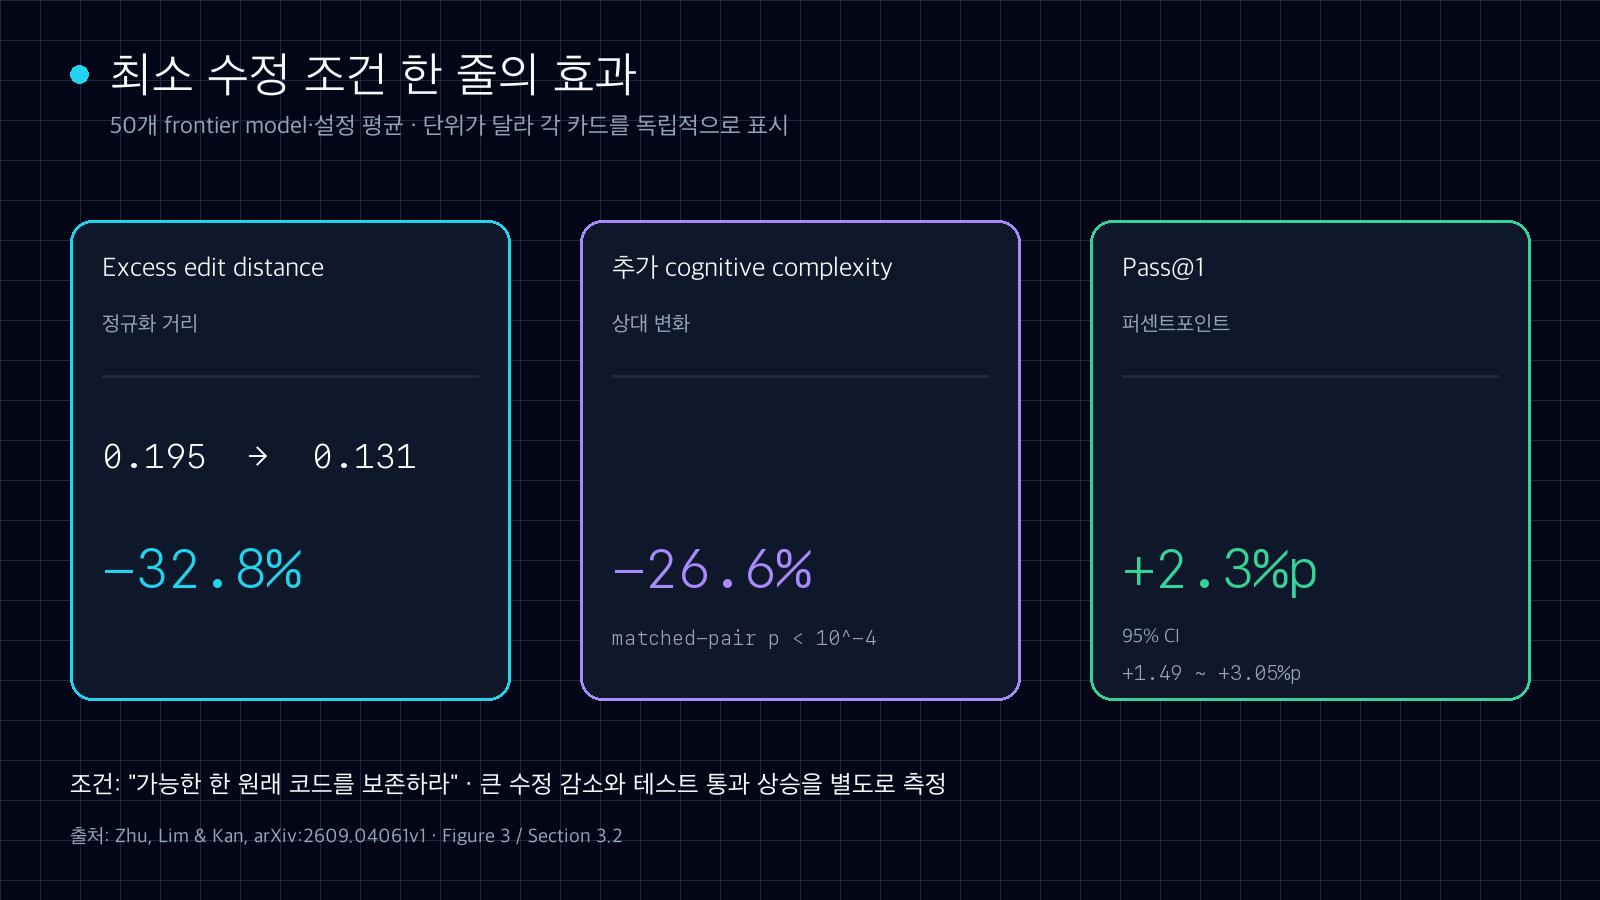
원본 보존 조건은 평균 수정 범위를 줄이면서 테스트 통과율도 2.3%포인트 높였다. 서로 다른 단위는 별도 카드로 표시했다. 출처: arxiv.org/html/2609.04061v1.
공개 원시 데이터도 확인했다. 저장소의 corrupted_solutions_manual_easy_400.jsonl에는 400개 레코드가 있고, 한 가지 오류를 넣은 함수 232개와 두 가지를 넣은 함수 168개로 나뉜다. 두 필드 이름을 모두 읽어 다시 합산하니 오류 적용은 568회, 유형은 12종이었다. 논문과 저장소 README의 수치가 일치했다. 다만 모델별 생성 결과와 학습 checkpoint는 저장소에 모두 포함되지 않아 전체 결과를 독립 재실행하지는 못했다.
작은 문장 하나가 패치 크기와 정답률을 함께 바꿨다
기본 요청은 함수를 고치고 완성하라는 문장이었다. 여기에 "가능한 한 원래 코드를 보존하라"는 조건을 한 줄 추가하자 비교한 50개 모델·설정 모두에서 excess edit distance가 줄었다. 평균은 0.195에서 0.131로 내려갔고 추가 cognitive complexity는 26.6% 감소했다. Pass@1은 오히려 2.3%포인트 올랐다. GPT-5.5 High의 excess distance는 0.299에서 0.159로 줄었다.
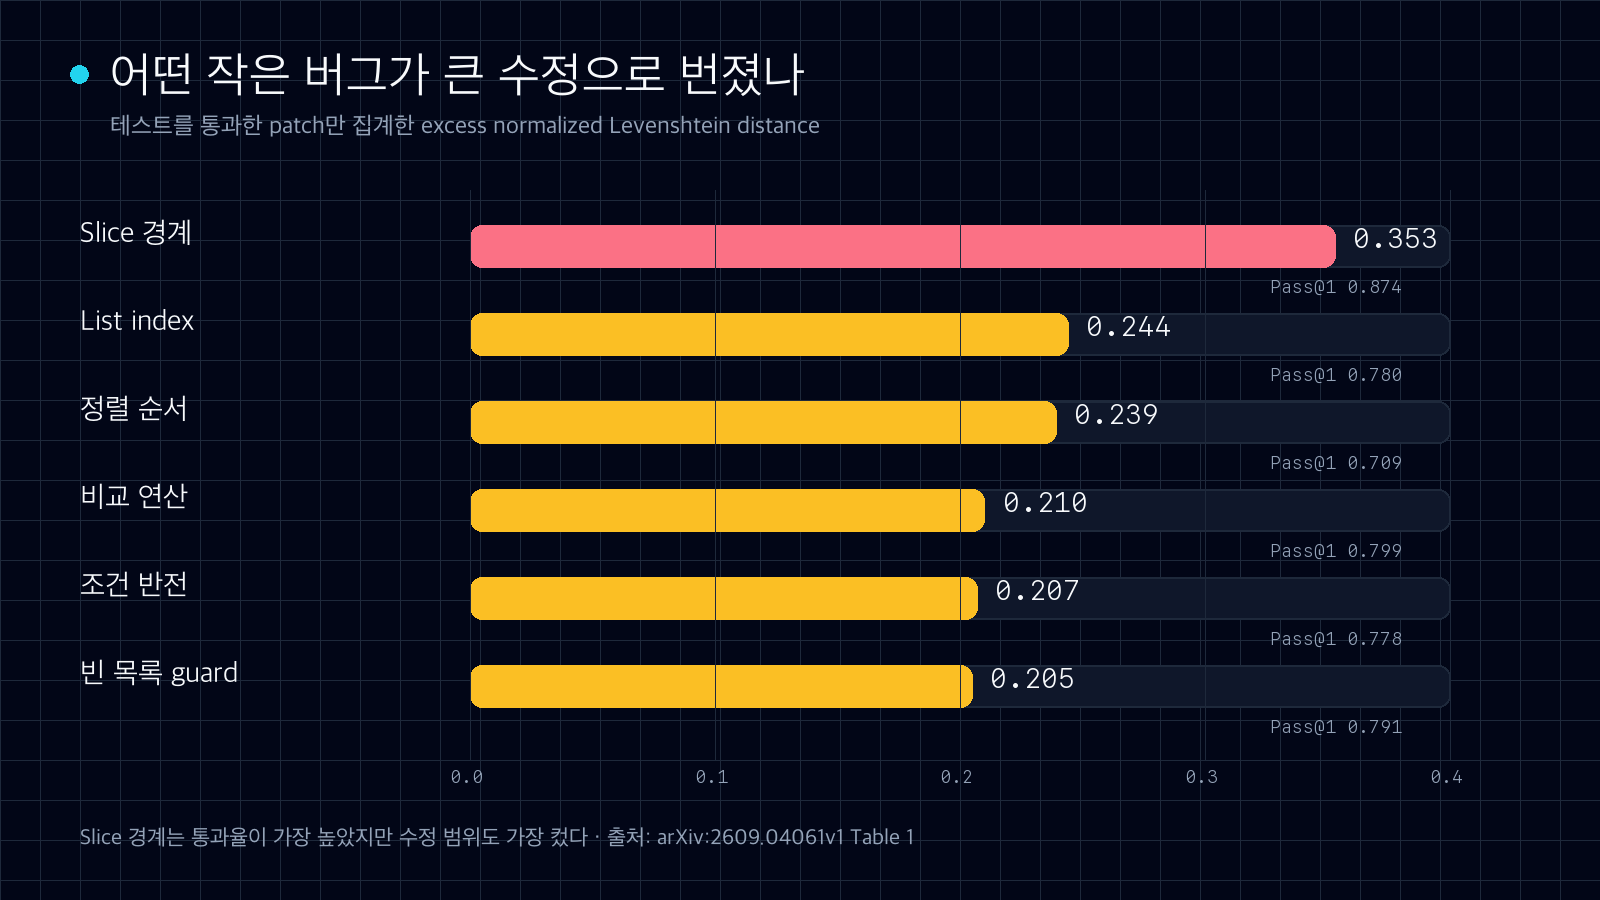
Slice 경계 오류는 Pass@1이 0.874로 높았지만 excess edit distance도 0.353으로 가장 컸다. 출처: arxiv.org/html/2609.04061v1.
이 결과를 "프롬프트 한 줄이면 해결"로 읽으면 곤란하다. 이 벤치마크는 짧고 거의 맞는 함수에서 최소 복원을 요구한다. 기능 추가나 리팩터링처럼 설계 선택지가 열린 작업에서는 큰 수정이 잘못이라고 단정할 수 없다. 논문도 100개의 고과잉 통과 패치를 사람이 다시 본 결과, 판정 가능한 사례의 82.3%에서 불필요한 수정이 있었다고 보고했다. 나머지는 다른 방식이지만 타당한 수정이었다.
그래도 실무 신호는 분명하다. 에이전트에게 "고쳐라"고만 말하면 모델은 기존 구현을 보존해야 할 증거가 아니라 더 튼튼하게 다시 만들 재료로 볼 수 있다. 수정 범위를 prompt와 검증 규칙에 명시해야 리뷰 가능한 patch를 얻기 쉽다.
과잉 편집은 어려운 버그에만 생기지 않았다
과잉 편집이 큰 유형은 slice 경계, list index, 비교 연산, 정렬 순서와 조건문이었다. 특히 slice 경계 오류는 Pass@1이 0.874로 여섯 유형 중 가장 높았지만 excess distance도 0.353으로 가장 컸다. 모델이 문제를 잘 풀었다는 사실과 최소한으로 고쳤다는 사실이 반대로 움직일 수 있다는 예다.
고과잉 통과 패치 530개를 분류한 결과도 비슷하다. 넓은 입력 검증이나 fallback을 넣는 defensive generalization이 64.2%, 자료 흐름 자체를 다시 짜는 data-flow rewrite가 63.2%였다. 출력이나 부작용 계약을 바꾼 contract drift도 34.7%였다. 이 분류는 여러 항목을 동시에 붙일 수 있어 합계가 100%가 되지 않는다.
여기서 테스트의 한계가 드러난다. 테스트는 관찰한 입력에서 결과가 맞는지 확인할 뿐, 불필요하게 추가한 분기나 외부 의존성이 미래 입력에서 어떤 회귀를 만들지 모두 증명하지 않는다. 큰 diff가 곧 나쁜 diff는 아니지만, 한 줄 복구가 가능한 상황에서 60줄이 늘었다면 통과 표시 외에 별도의 설명 책임이 필요하다.
모델 크기와 추론 예산만 늘려서는 정리되지 않았다
Qwen2.5-Coder 0.5B부터 32B까지 비교하면 모델이 커질수록 Pass@1은 대체로 올랐다. 하지만 통과한 패치의 수정 충실도는 단조롭게 좋아지지 않았다. 기본 prompt에서 excess distance는 14B의 0.108에서 32B의 0.127로 다시 커졌다. reasoning variant도 모델마다 방향이 달라 일관된 해결책이 아니었다.
학습 실험에서는 Qwen3-4B에 네 방법을 적용했다. 일반 SFT는 학습에 쓴 오류 유형에서 Pass@1 0.932를 기록했지만, 보지 못한 오류 유형에서는 0.458로 떨어졌다. LiveCodeBench v6도 base 32.6%에서 17.7%로 낮아졌다. 반면 실행 성공과 최소 수정에 함께 보상한 RL은 보지 못한 오류에서 Pass@1 0.782, excess distance 0.050을 기록했고 LiveCodeBench는 33.2%였다.
이 숫자도 제한된 조건의 결과다. 주 평가 문제는 짧은 파이썬 함수이고, 학습은 Qwen 계열 중심이다. 실제 Java 버그인 Defects4J로 옮겼을 때 4B 모델의 통과율은 base 7.4%, RL 7.0%로 낮았다. RL 모델이 바꾼 토큰은 평균 51.9개에서 35.3개로 줄었지만, 더 많은 실제 버그를 고친 것은 아니다. 작은 patch 선호가 옮겨갔다는 증거와 수리 능력이 충분하다는 주장은 구분해야 한다.
실전 적용: 에이전트의 완료 조건에 diff 예산을 넣는다
유지보수 요청에는 문제를 고치는 것과 기존 동작을 보존하는 것을 함께 쓴다. 예를 들면 "실패한 테스트의 원인만 수정하고, 관련 없는 이름 변경·포맷 정리·입력 검증 추가는 하지 마라"처럼 금지 범위를 구체화한다. 기능 확장이 필요해 보이면 같은 patch에 몰아넣지 말고 별도 제안으로 남기게 한다.
CI에서는 테스트 통과 뒤 diff 통계를 별도 관문으로 둔다. 변경 파일 수, 추가·삭제 라인, 새 분기와 의존성, 공개 API 변경을 기록한다. 임계치를 넘는다고 자동 실패시키기 어렵다면 최소한 사람 검토로 보낸다. 특히 수정 요청에 없던 fallback, coercion, logging과 retry가 들어오면 왜 필요한지 근거를 요구한다.
리뷰도 "테스트가 초록색인가"와 "원래 계약을 보존했는가"를 나눈다. 먼저 정답 동작을 확인한 뒤, 기존 코드와 무관한 변화가 섞였는지 읽는다. 에이전트가 만든 큰 patch를 곧바로 줄이는 대신 최초 지시와 실패 재현을 다시 보여 주고 작은 대안을 별도 생성하게 하면 비교 근거가 생긴다.
마지막으로 patch 크기를 품질의 절대 기준으로 쓰지 않는다. 보안 취약점처럼 검증 범위를 넓혀야 하는 수정도 있고, 기존 구조가 원인이라 국소 패치보다 재설계가 안전한 경우도 있다. 중요한 건 큰 변경을 금지하는 일이 아니라, 테스트 통과가 큰 변경의 정당성을 자동으로 증명한다고 착각하지 않는 것이다.
범위와 주의점
이 글은 arXiv v1 논문, 저자 저장소 README와 공개된 400개 입력 데이터셋을 대조했다. 데이터 파일의 레코드 수, 오류 개수와 12개 유형 분포는 직접 다시 계산했다. 모델 호출 결과, 사람 판정 원문과 학습 checkpoint 전체는 공개 저장소에서 확인되지 않아 Pass@1, prompt 효과, 사람 평가와 RL 결과는 논문 보고값을 사용했다.
연구의 최소 패치는 주입한 오류를 되돌리는 것으로 정의된다. 실제 저장소에서는 요구사항이 불완전하거나 여러 파일을 함께 바꿔야 할 수 있다. 따라서 이 연구는 "항상 한 줄만 고쳐라"가 아니라 "기능 성공과 수정 충실도를 따로 재라"는 운영 원칙에 더 가깝다.


댓글
댓글 쓰기