같은 요청인데 에이전트 경로가 75% 달라졌다: 4비트 양자화와 프리픽스 캐시의 숨은 상태
온도 0, 고정 시드, 배치 크기 1. 모델과 요청 순서까지 같다면 로컬 LLM 에이전트는 같은 행동을 반복할까. 9월 4일 공개된 논문 「Same Request, Different Answer」는 이 조건에서도 프리픽스 캐시 사용 여부에 따라 Qwen2.5-7B 에이전트의 경로가 F16에서 36.2%, Q4_K_M에서 75.0% 달라졌다고 보고한다.
평균 점수가 무너졌다는 이야기는 아니다. 개별 응답과 도구 호출 경로가 바뀌었지만, 별도 수학 문제 실험의 평균 정확도는 유의하게 나빠지지 않았다. 문제는 성능보다 재현성이다. 어제 기록한 실패를 같은 요청으로 다시 재생해도 서버가 앞서 처리한 요청과 캐시 상태가 다르면 다른 경로로 갈 수 있다.
요약: 요청만 저장해서는 실행을 재현할 수 없다
프리픽스 캐시는 여러 요청이 공유하는 앞부분의 key-value tensor를 다시 계산하지 않고 재사용한다. 에이전트는 대화와 도구 결과가 쌓일 때마다 긴 앞부분을 되보내므로 이 최적화의 이득이 크다. 하지만 캐시를 읽는 경로와 처음부터 다시 계산하는 경로는 부동소수점 연산 순서가 다르다. 작은 수치 차이가 경쟁하는 토큰의 순서를 바꾸면 첫 토큰 차이가 다음 도구 호출과 이후 대화 전체로 번진다.
연구자는 Berkeley Function Calling Leaderboard의 다중 턴 80개 episode를 두 번씩 실행했다. greedy decoding, seed 42, 직렬 요청, batch size 1을 고정했고 llama.cpp와 vLLM, 7B~14B 모델, 여러 weight format을 비교했다. 캐시를 끈 열 개 구성에서는 두 실행이 800개 episode 모두 bit-identical이었다. 관측된 차이가 일반적인 샘플링 잡음이 아니라 캐시 경로와 연관됐다고 판단할 수 있는 내부 대조군이다.
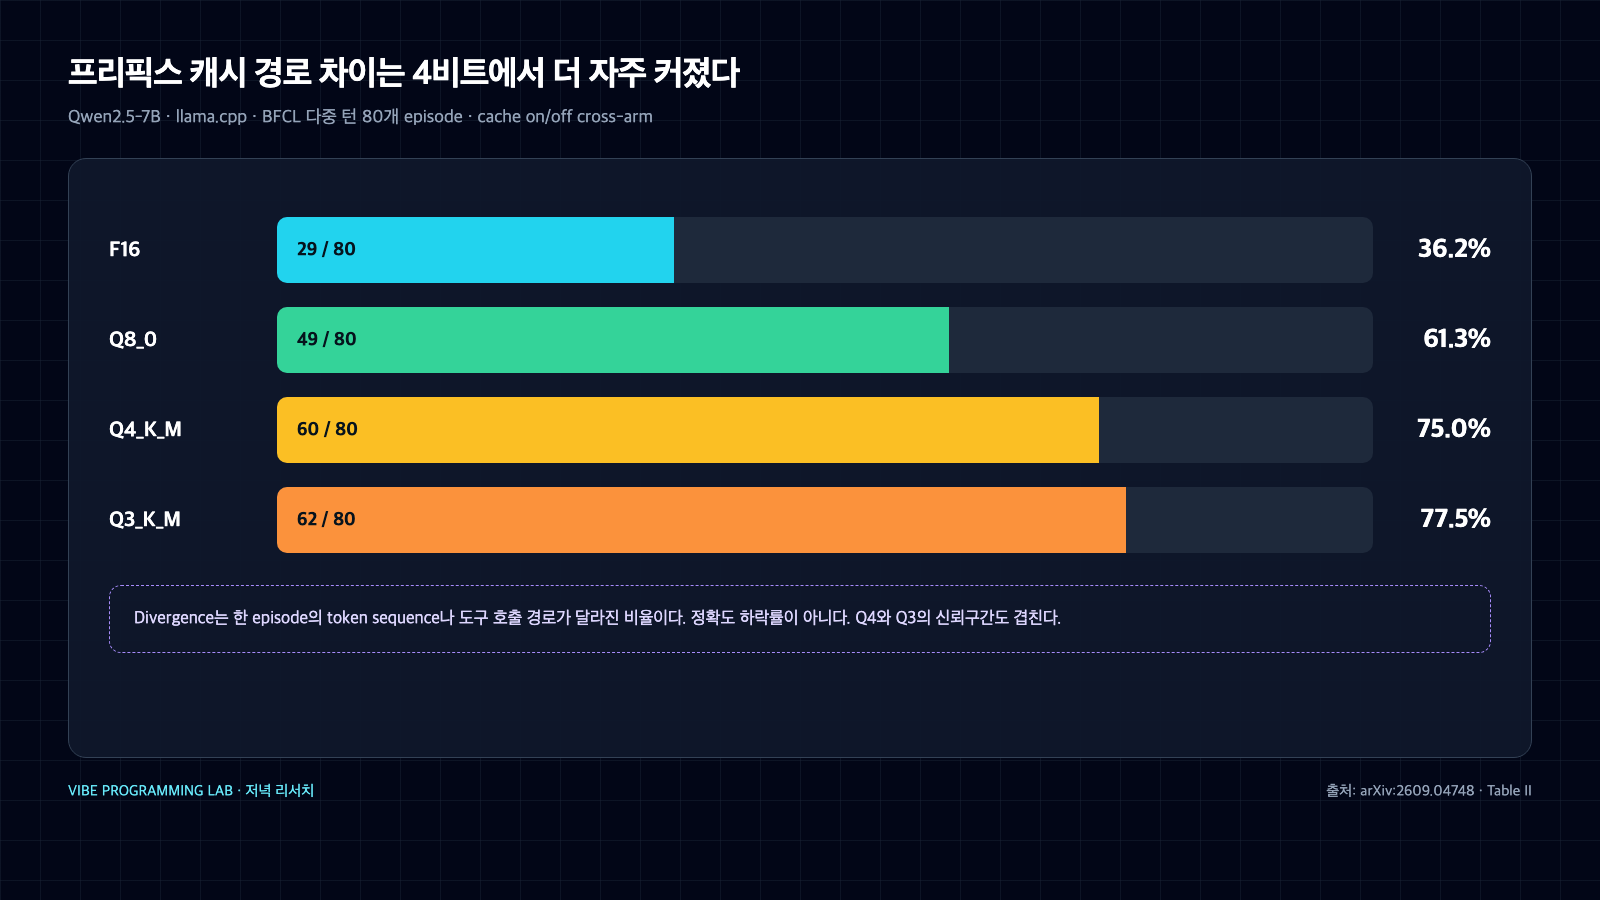
각 weight format에서 동일한 80개 episode의 cache-on과 cache-off 경로를 비교했다. divergence는 정확도 하락률이 아니며 Q4와 Q3의 신뢰구간은 겹친다. 출처: arxiv.org/html/2609.04748v1.
양자화가 원인은 아니지만 차이를 키웠다
llama.cpp에서 Qwen2.5-7B의 캐시 사용·미사용 경로를 비교한 결과, episode divergence는 F16 36.2%, Q8_0 61.3%, Q4_K_M 75.0%, Q3_K_M 77.5%였다. 각 지점의 분모는 80개다. 서버 수준 prompt cache를 끄고 일부 구성을 다시 측정해도 F16 40.0%, Q4_K_M 81.2%, Q3_K_M 77.5%로 방향이 유지됐다.
이 수치로 "4비트 모델은 정확도가 75% 떨어진다"고 말하면 틀린다. divergence는 두 경로가 한 번이라도 다른 token sequence나 도구 호출 궤적을 만들었다는 뜻이다. 옳고 그름을 직접 세는 지표가 아니다. F16에서도 36.2%가 달랐으므로 양자화가 현상을 만든 것도 아니다. 논문의 표현대로 양자화는 작은 수치 섭동이 토큰 결정 경계를 넘기 쉽게 만든 증폭 요인에 가깝다.
Q4_K_M과 Q3_K_M의 신뢰구간은 겹친다. 75.0%와 77.5%의 순서를 근거로 3비트가 4비트보다 항상 더 불안정하다고 결론 내릴 수 없다. 저자는 전체 ordered format 추세는 유의하다고 보고했지만, 가장 거친 두 설정 사이의 우열에는 의미를 두지 않았다.
같은 캐시 경로도 왜 실행마다 달라졌나
첫 실험에서 캐시를 켠 실행끼리 비교해도 구성에 따라 8.8~77.5%가 달랐다. 원인을 좁혀 보니 llama.cpp의 request-level prefix cache와 별도로 켜져 있던 host-memory prompt cache가 중요했다. 이 계층은 전체 대화 상태를 저장하고 정확한 identity가 아니라 공통 prefix 길이로 재사용 대상을 고른다. 서버가 앞서 처리한 트래픽이 다음 요청의 연산 경로를 바꾸는 셈이다.
Qwen2.5-7B Q4_K_M 80개 episode에서 이 server-level cache가 기본값일 때 반복 실행 divergence는 38.8%였다. 같은 설정에서 해당 계층만 끄자 1.2%로 줄었다. 차이는 37.5%p다. 중간에 cache-off 실행을 끼우면 기본값에서는 38.8%가 77.5%로 뛰었지만, 계층을 끈 상태에서는 실행 순서와 관계없이 1.2%였다.
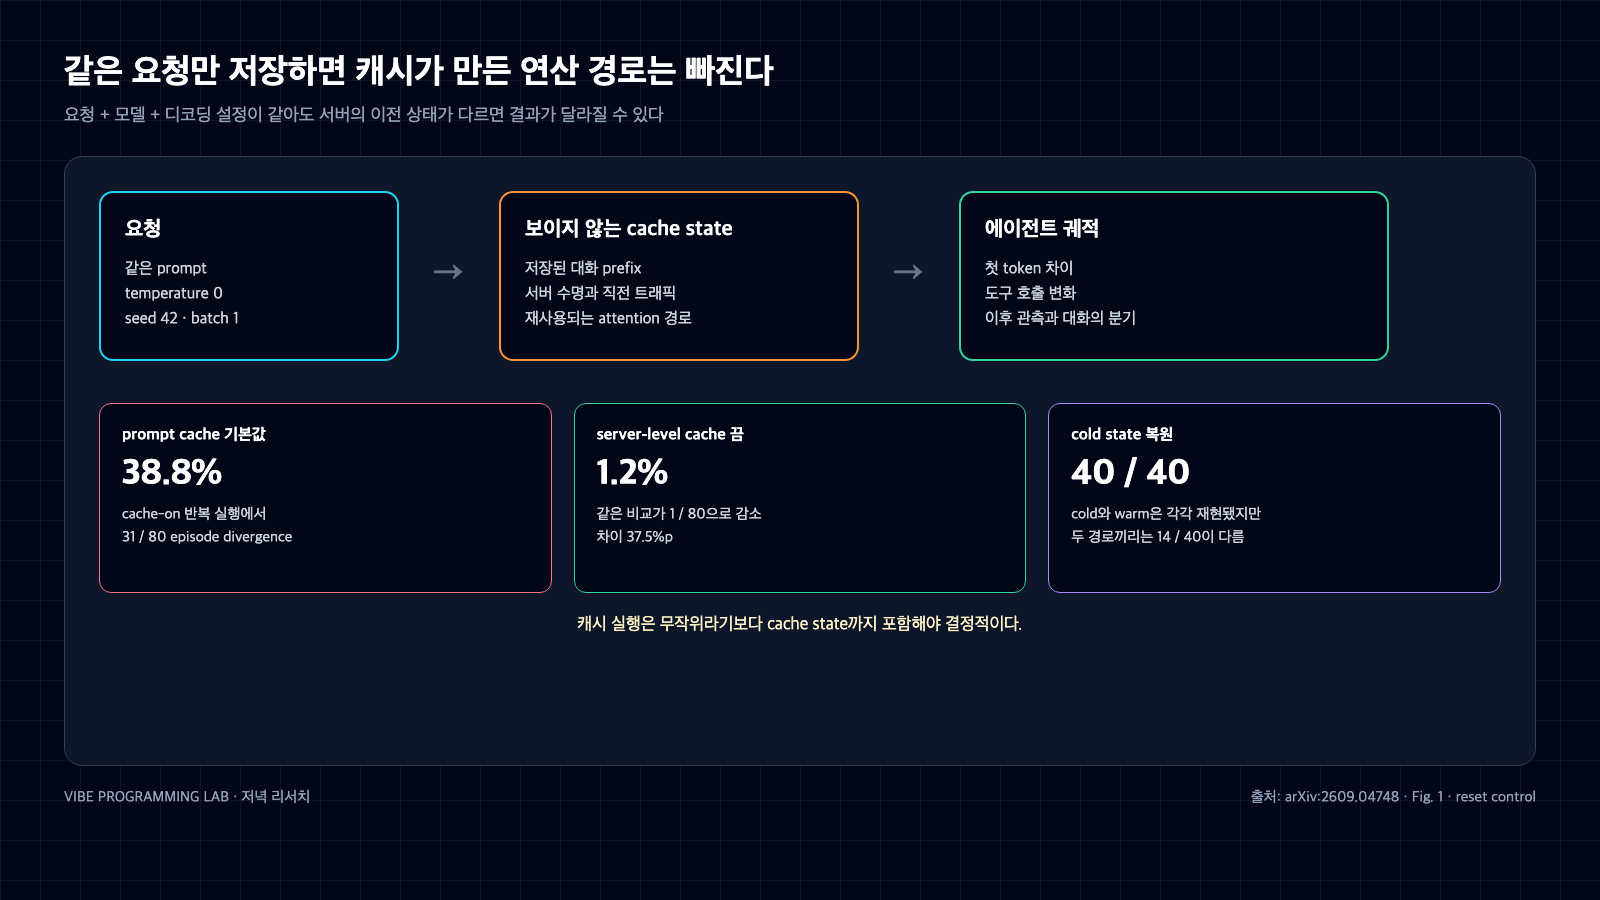
서버 수준 prompt cache를 끄자 반복 실행 차이는 38.8%에서 1.2%로 줄었다. cold state를 복원하면 cached와 recompute 경로는 각각 재현됐지만 서로는 14/40에서 달랐다. 출처: arxiv.org/html/2609.04748v1.
별도 reset control은 이 해석을 더 좁힌다. 40개 item마다 cold state를 다시 만들자 recompute 경로와 cached 경로는 각각 40/40으로 자기 자신을 재현했다. 그럼에도 두 경로끼리는 14/40에서 달랐다. 캐시 계산이 무작위라기보다, 요청에 기록되지 않은 cache state까지 입력의 일부라는 뜻이다.
평균 정확도는 같아도 디버깅은 어려워진다
단일 턴 GSM8K 실험에서는 각 item을 cold 두 번, warm 두 번 실행했다. Q4_K_M 500개에서 두 경로의 출력은 45.4% 달랐지만 정확도는 cold 453개, warm 459개였다. 전체 독립 item 1,300개에서 correctness flip은 20개였고, cached 쪽만 맞은 경우 13개와 recompute 쪽만 맞은 경우 7개가 섞였다. McNemar 검정의 p값은 0.26이었다.
따라서 이 연구는 캐시가 평균 정확도를 낮춘다는 근거를 주지 않는다. 오히려 평균이 비슷해서 더 찾기 어려운 문제를 보여준다. A/B 실험의 총점은 그대로인데 어떤 item이 맞고 틀리는지는 바뀔 수 있다. 에이전트 benchmark에서는 성공률이 1.2~18.8%로 바닥에 가까워 task success에 대한 결론을 내리지 않았고, 다중 턴 결과는 trajectory 변화로만 해석했다.
수학 문제 채점기도 처음에는 답 형식 때문에 흔들렸다. 수집 당시 scorer는 #### 숫자 형태만 받아 boxed 등 명확한 정답을 오답으로 처리했다. 응답 원문에서 답을 다시 추출하고 문자열 대신 숫자로 비교하자 정확도는 89~93%로 올라갔고, cache-attributable flip 수도 크게 줄었다. 이 수정 전 수치를 그대로 썼다면 캐시가 정확도에 방향성 있는 영향을 준다는 잘못된 결론이 나올 뻔했다.
실전 적용: 모델 버전만으로는 실행 기록이 부족하다
평가 manifest에는 모델 hash, quantization format, seed와 temperature뿐 아니라 serving engine과 version, prefix cache 활성화 여부, server-level prompt cache 설정을 넣어야 한다. 가능하면 응답별 cached token 수와 서버 시작 시각도 보존한다. 연구에 사용된 llama.cpp는 요청마다 cache exposure를 기록했지만 vLLM 0.11.0의 해당 endpoint는 필드를 비워 두어 engine log로 확인해야 했다.
재현이 필요한 회귀 test는 shared production server에서 바로 돌리지 않는 편이 낫다. 격리된 server process를 시작해 cache state를 초기화하고, test suite 안에서는 요청 순서를 고정한다. 캐시를 완전히 포기할 필요는 없다. 이 실험에서는 server-level prompt cache를 끄면서 request prefix cache를 유지해 반복 차이를 크게 줄였다. 다만 이 결과는 특정 llama.cpp build와 RTX 4090 환경의 측정이므로 자신의 stack에서 cold/warm paired test를 먼저 해야 한다.
실패 재생 도구도 request body만 저장해서는 모자란다. 당시 engine flags, server lifetime, 직전 cache state를 복원할 수 없다면 "동일 재실행"이 아니라 "동일 요청의 새 실행"이라고 기록하는 편이 정확하다. 같은 실패가 다시 나오지 않았다는 사실만으로 수정됐다고 판정해서도 안 된다. 먼저 cold와 warm 조건을 나눠 각각 반복해야 원인을 모델, 코드, 서빙 상태 중 어디에 둘지 좁힐 수 있다. A/B 실험은 두 arm을 번갈아 같은 fresh-state 조건에서 실행하거나, 최소한 순서와 cache exposure를 함께 남겨야 한다.
범위와 주의점
실험은 한 종류의 NVIDIA GPU에서 7B~14B 공개 모델을 단일 tenant로 돌렸다. frontier model, hosted API, multi-tenant eviction에는 결과를 일반화할 수 없다. 다중 턴 workload도 영어 BFCL 80개 episode다. divergence는 token ID가 다르면 의미가 같아도 차이로 센 엄격한 재현성 지표이며, 품질 저하율과 같지 않다.
또 논문은 첫 grid에서 server-level cache와 실행 순서가 얽힌 결함을 발견한 뒤 repair experiment를 추가했다. 공개 저장소의 raw log와 분석 pipeline을 직접 다시 실행해 핵심 grid의 count와 rate가 저장된 findings.json과 일치함을 확인했다. 다만 원 저자의 GPU 실험 전체를 새 hardware에서 재수행한 독립 재현은 아니다.
프리픽스 캐시는 여전히 쓸 만한 최적화다. 다만 캐시가 켜진 endpoint의 출력은 요청과 모델만의 함수가 아니다. 디버깅과 평가에서 repeatable이라는 말을 쓰려면 보이지 않던 cache state도 실험 조건으로 끌어올려야 한다.


댓글
댓글 쓰기