작은 모델이 데이터베이스 에이전트에서 막힌 이유: 실패 75.7%는 도구 호출 뒤였다
작은 로컬 언어 모델이 에이전트 작업에 실패하면 흔히 모델 크기부터 의심합니다. 추론 능력이 부족해서 tool loop를 이어 가지 못했다고 보는 겁니다. 2026년 9월 18일 공개된 What Stops a Small Language Model From Driving a Database Agent는 그 설명을 실제 제품 로그와 대조했습니다.
연구 대상은 오픈소스 SQL 클라이언트 LibreDB Studio의 read-only 데이터베이스 에이전트입니다. 연구진은 11일 동안 로컬에서 제공한 open-weight 모델 39개와 hosted control 1개를 여섯 가지 작업 표면에서 실행했습니다. 전체 기록은 8,199회 실행, 110,711개 ledger event, 거절된 tool call 14,008개입니다.
결과는 "작은 모델은 도구를 부르지 못한다"는 단순한 그림과 달랐습니다. 모델에 귀속한 agent-mode 실패 2,100건 중 1,590건, 75.7%는 적어도 한 번 도구를 호출한 뒤에 일어났습니다. 모델은 움직였지만 모델과 서버 사이의 경계에서 결과를 잃는 경우가 더 많았습니다.
실패 2,100건을 네 가지로 나눴다
논문은 실패를 capability, transport, clock, verification 네 범주로 분리했습니다. capability는 도구를 한 번도 호출하지 못한 경우입니다. transport는 도구를 썼지만 최종 산출물을 서버까지 전달하지 못한 경우, clock은 시간 제한에 걸린 경우, verification은 증거 요건을 충족하지 못한 경우입니다.
연구진이 채택한 clock-first 분류에서 transport는 761건(36.2%), clock은 542건(25.8%), verification은 434건(20.7%), capability는 363건(17.3%)이었습니다.
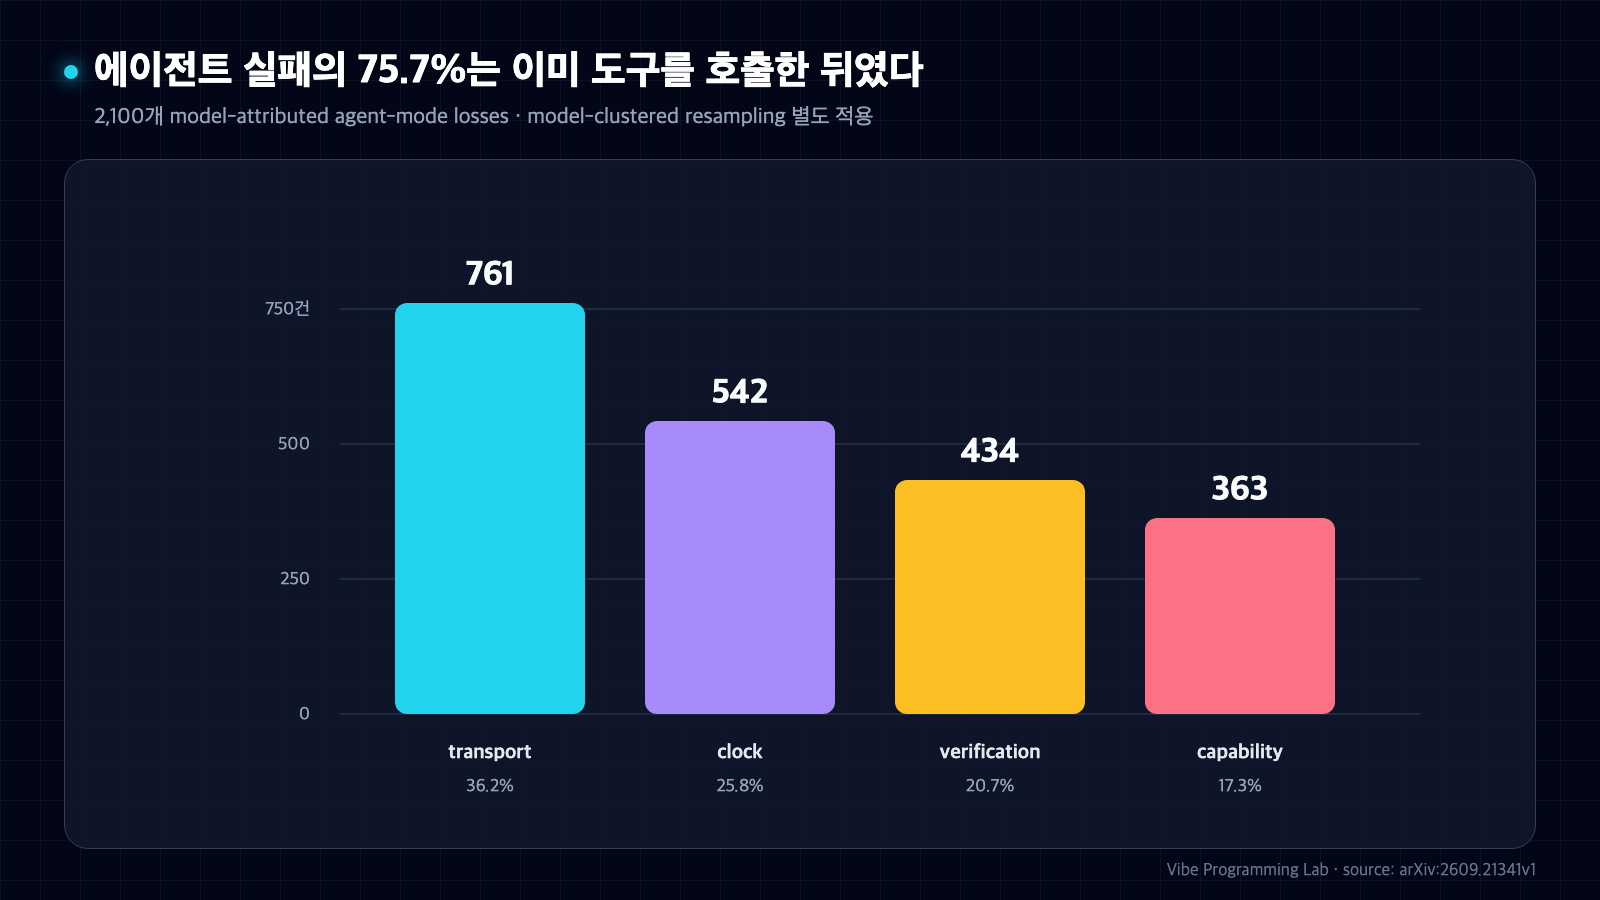
그림 1. 실패의 75.7%는 이미 도구를 호출한 실행에서 발생했다. 범주 순서는 이 corpus의 결과이며 모델 일반 법칙은 아니다. 출처: arxiv.org/html/2609.21341v1.
다만 이 순서를 모든 모델의 일반 법칙으로 읽으면 안 됩니다. run을 서로 독립이라고 보면 transport의 95% 구간은 34.2~38.3%로 좁지만, model 단위로 다시 표본을 뽑으면 22.0~49.1%로 넓어집니다. transport가 가장 큰 범주라는 순서는 model-clustered resampling의 74.5%에서만 유지됐습니다.
반면 "도구를 호출한 뒤 실패한 경우가 과반"이라는 75.7% 결과는 더 단단했습니다. 이 과반은 clustered resample의 99.7%와 실패가 20건 이상인 22개 모델 중 15개에서 유지됐습니다. 논문이 기대는 결론도 범주 순위가 아니라 이 engagement 결과입니다.
거절 코드는 있었지만 잘못된 인자는 열흘 동안 보이지 않았다
transport 실패를 조사하려면 모델이 어떤 argument를 보냈는지 알아야 합니다. 하지만 production ledger는 refusal code만 남겼고 모델 인자는 저장하지 않았습니다. 기록에는 "거절됨"만 있고 어떤 key와 shape가 거절을 만들었는지 없었습니다.
argument capture를 추가하자 실패가 몇 가지 기계적인 모양으로 모였습니다. text channel의 호출은 tool 이름보다 parse 가능한 JSON 형태를 우선해 인식했습니다. 한 tool은 특정 field를 요구했지만 그 값을 조합하는 sibling tool은 같은 field를 금지했습니다. 서버는 near-miss key를 오류 메시지로 알려 주면서도 실제 rename은 적용하지 않았습니다. 단일 객체와 1개짜리 목록의 차이도 그대로 실패가 됐습니다.
이건 모델이 SQL 문제를 이해했는지와 다른 층입니다. 내용이 맞아도 wire contract를 한 글자 다르게 해석하면 전체 실행은 실패합니다. refusal count만 모으면 모델 품질 문제처럼 보이고, argument shape까지 남겨야 protocol defect로 분리됩니다.
모델을 바꾸지 않고 서버 다섯 곳을 고쳤다
연구진은 모델, prompt, sampling setting을 그대로 두고 서버의 다섯 경계를 수정했습니다. tool 이름으로 호출을 인식하고, 의미가 명확한 field rename을 제한적으로 허용하고, 단일 객체를 1개짜리 목록으로 정규화했습니다. sibling tool이 소유한 field는 "삭제하라"고 하지 않고 어느 tool로 옮길지 알려 줬습니다.
같은 하드웨어와 과제를 다시 읽은 결과, 여섯 모델은 30개 cell 중 6개에서 21개를 더 통과했습니다. cogito:8b는 0/30에서 21/30, glm4:latest는 0/30에서 16/30, llama3.1:8b는 10/30에서 24/30으로 움직였습니다. 분모가 28인 deepseek-r1:8b도 18/28에서 24/28이 됐습니다.
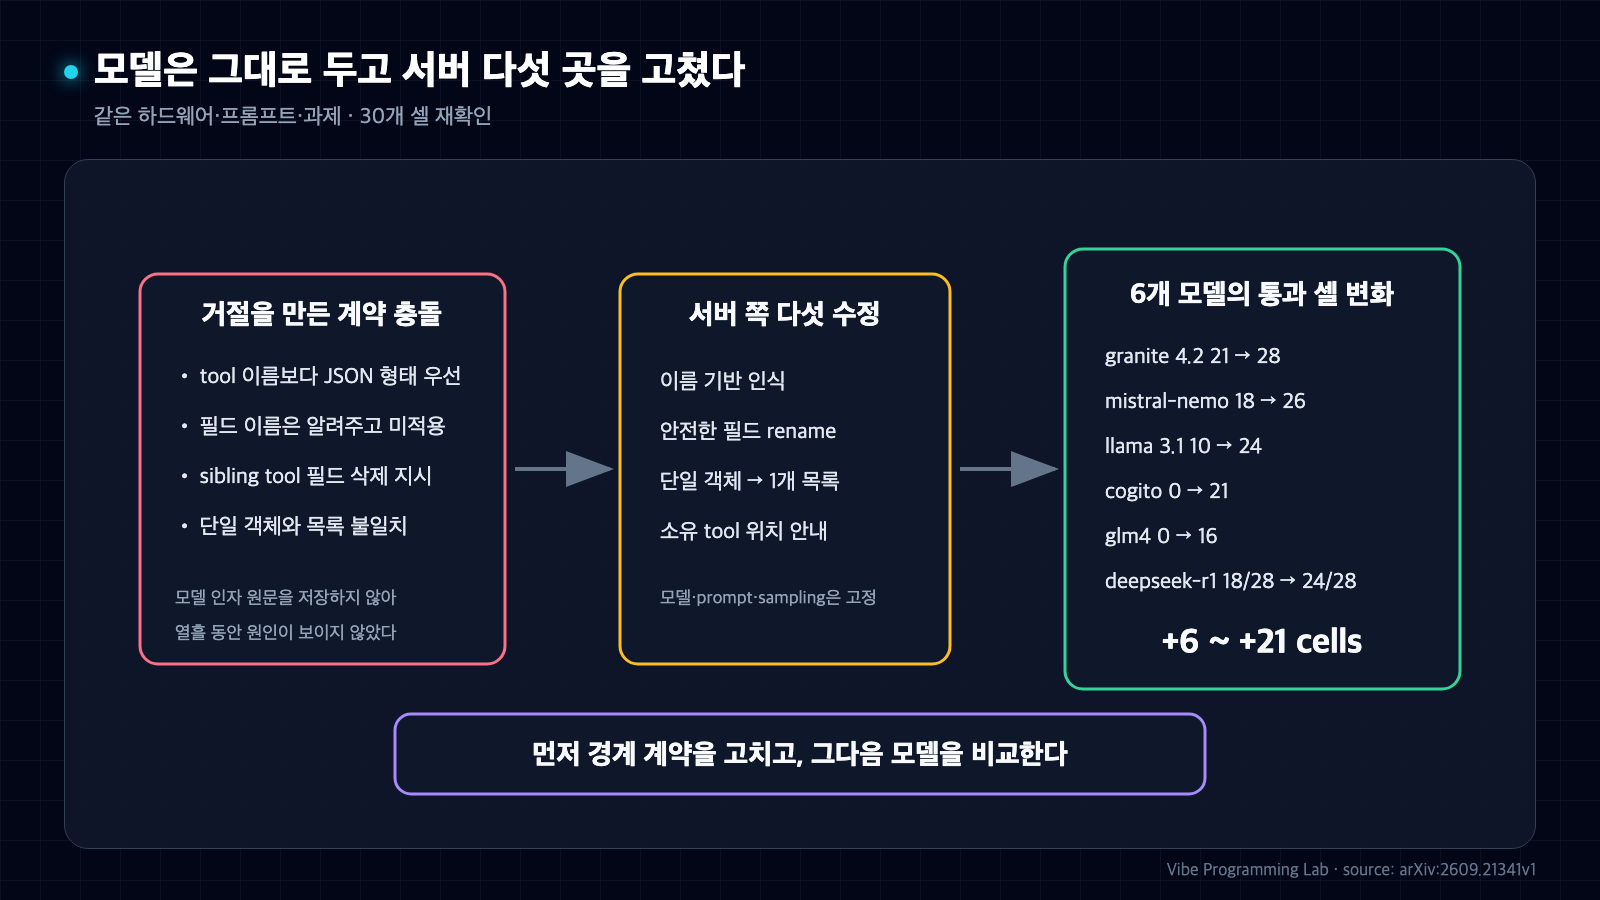
그림 2. 모델과 프롬프트를 바꾸지 않은 서버 수정 뒤 여섯 모델은 30개 셀 중 6개에서 21개를 더 통과했다. 출처: arxiv.org/html/2609.21341v1.
이 전후 값은 "작은 모델이면 모두 충분하다"는 증거가 아닙니다. 한 제품, 고정된 schema, 같은 여섯 작업 표면에서 server defect를 고친 결과입니다. 저자들은 평가 대상 소프트웨어의 기여자이기도 하므로, 이 자료는 독립 기관의 외부 benchmark가 아니라 개발팀이 공개한 production study로 읽어야 합니다. 그래도 모델 교체 전 protocol layer를 점검해야 한다는 운영 순서는 분명히 보여 줍니다. 모델 비교표가 사실은 harness 비교표일 수 있기 때문입니다.
7.1GB 모델이 메모리 51GB를 차지한 경우
연구가 드러낸 두 번째 경계는 serving 조건입니다. context length를 설정하지 않자 Ollama는 한 12B 모델의 advertised window인 262,144 token을 그대로 허용했습니다. disk에서 7.1GB인 모델이 64GB machine에서 resident memory 51GB를 차지했고, free memory는 6%까지 떨어졌습니다.
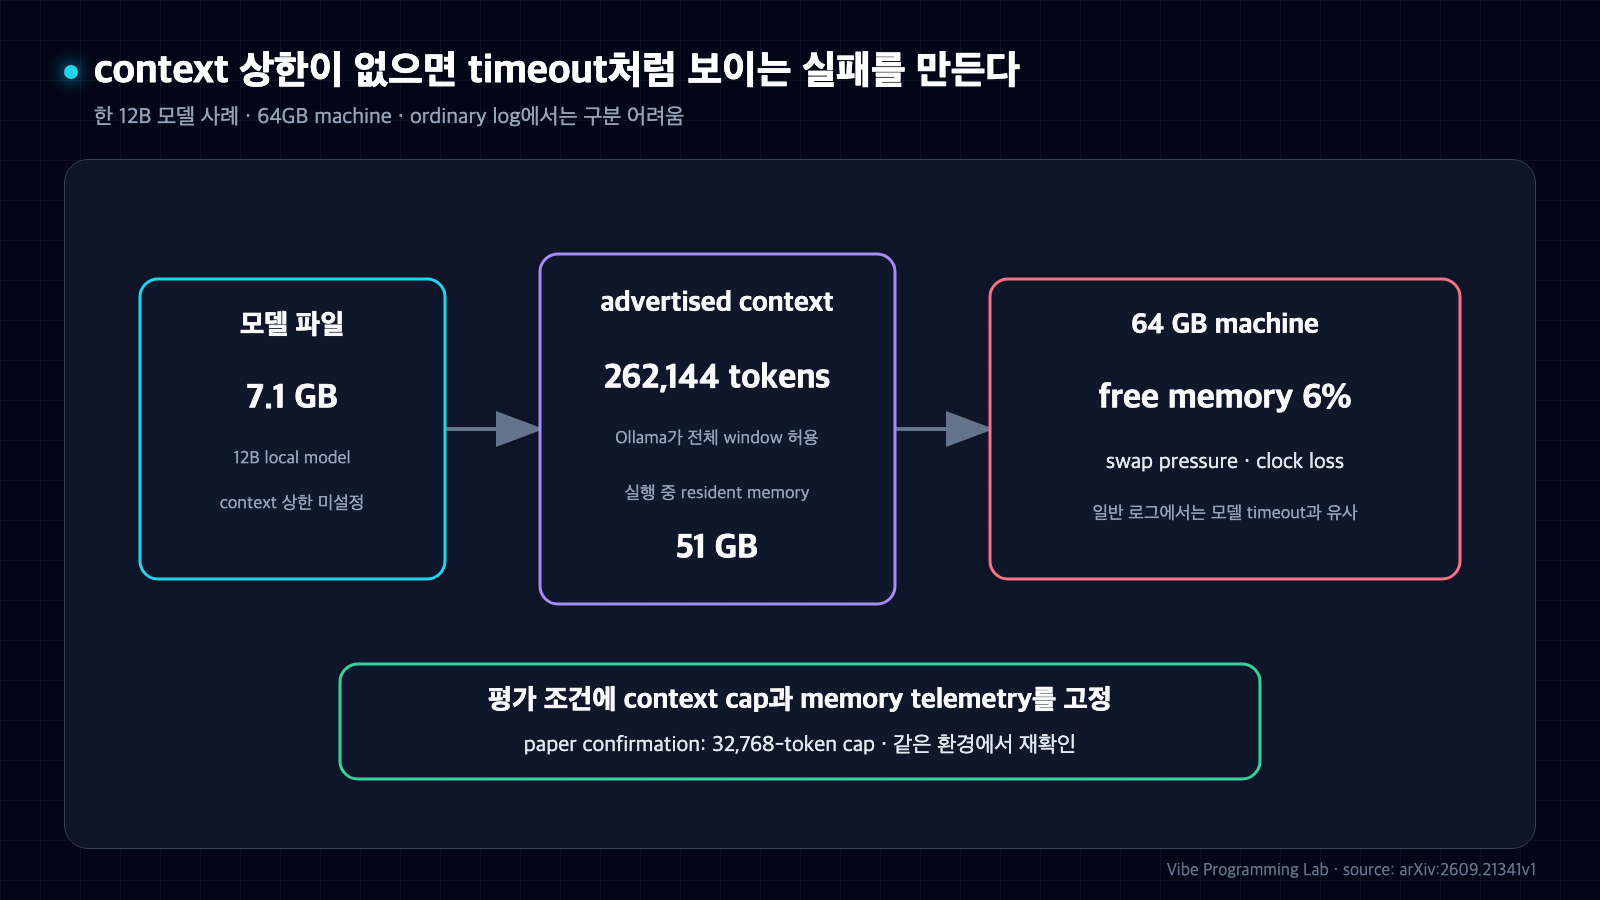
그림 3. context 상한과 memory telemetry를 고정하지 않으면 swap pressure가 모델 timeout처럼 기록될 수 있다. 출처: arxiv.org/html/2609.21341v1.
그 상태의 실행은 모델 능력 측정으로 쓰기 어렵습니다. swap pressure와 지연이 ordinary log에서는 모델 timeout처럼 보이기 때문입니다. 논문은 확인 실험에서 context를 32,768 token으로 제한했습니다. 중요한 건 32,768이 보편적인 정답이라는 뜻이 아니라, 비교할 때 context cap과 memory telemetry를 고정해야 한다는 점입니다.
실행되지 못한 예약 작업도 분모에서 분리해야 합니다. 논문의 before/after 표에서 deepseek-r1:8b는 예정한 30회 중 2회가 시작되지 않아 28회를 분모로 사용했습니다. 전체 corpus에서도 scheduled run 89개가 시작되지 않았습니다. process exit만으로 pass를 판단하지 않고, run identifier를 공개 dataset의 verdict와 다시 연결한 이유가 여기에 있습니다.
에이전트 하네스에서 먼저 남길 로그
이 연구를 운영 체크리스트로 바꾸면 로그의 해상도가 달라집니다.
- tool call을 거절할 때 code뿐 아니라 안전하게 정규화한 argument shape와 schema mismatch 위치를 남깁니다.
- "도구를 부르지 않음"과 "도구를 부른 뒤 전달 실패"를 다른 지표로 셉니다.
- timeout에는 model latency와 queue wait, swap pressure, server deadline을 한 값으로 섞지 않습니다.
- 모델별 run 수가 다르면 run-level 비율만 쓰지 않고 model-clustered uncertainty도 계산합니다.
- server contract를 고친 전후 실험에서는 모델, prompt, sampling, hardware, task를 고정합니다.
- context cap, resident memory, free memory, started/not-started 상태를 평가 조건에 포함합니다.
argument 전체를 무조건 저장하라는 뜻은 아닙니다. SQL, schema, user data에는 민감한 정보가 들어갈 수 있습니다. field name, type, shape, refusal path를 최소한으로 수집하고 값은 redaction하거나 hash-bound fixture에서만 보존하는 편이 안전합니다.
운영 대시보드도 성공률 한 줄보다 단계별 분해가 낫습니다. 시작 여부, 첫 도구 호출, 마지막으로 수락된 도구, 산출물 제출, verifier 판정, 종료 원인을 각각 남기면 같은 실패율에서도 손댈 위치가 달라집니다. 특히 process가 정상 종료했다는 사실과 사용자의 질문에 답했다는 판정은 별개입니다. 공개 dataset에서도 succeeded 상태가 pass를 뜻하지 않았고, 최종 outcome이 유일한 합격 기준이었습니다.
오늘 다른 글과 결론이 겹치지 않는 지점
오늘 아침 글은 Python 3.14 free-threaded 빌드에서 GIL 상태, C extension 호환성, shared state locking을 구분했습니다. 별도 공개 글은 장기 에이전트가 작업 깊이와 하위 목표가 늘 때 어디서 무너지는지를 다뤘습니다. 이번 글은 database tool contract와 serving memory가 작은 로컬 모델의 실패로 잘못 계산되는 경계를 봅니다.
결론은 "작은 모델도 충분하다"가 아닙니다. 먼저 모델이 도구를 전혀 쓰지 못한 실패와, 도구를 사용한 뒤 protocol·deadline·verification 경계에서 잃은 실패를 분리해야 합니다. 그다음 context와 memory 조건을 고정한 상태에서 모델을 비교해야 합니다. 이 순서를 거꾸로 하면 더 큰 모델을 올려도 server defect는 그대로 남습니다.


댓글
댓글 쓰기