과학 코드는 빨리 썼지만 검증은 더 무거워졌다: 8개 사례
코딩 에이전트가 연구용 소프트웨어를 며칠 만에 고쳐도, 그 결과를 바로 믿을 수는 없다. 과학 코드에서는 "실행된다"와 "과학적으로 맞다" 사이의 거리가 특히 멀다. 숫자 기본값 하나, 읽기 순서 하나, 허용 오차 하나가 논문의 결론을 바꿀 수 있기 때문이다.
OpenAI가 공개한 현장 보고서는 이 간극을 8개 프로젝트로 보여 준다. 유전체 파일 라이브러리의 패키징 정리부터 TensorFlow 백엔드 교체, Rust 재구현, GPU 기반 돌연변이 시뮬레이터까지 범위가 넓다. 다섯 프로젝트는 Codex만 썼고 세 프로젝트는 Codex와 Claude Code를 함께 썼다. 공통 결론은 단순하다. 구현 속도는 빨라졌지만, 병목은 사라지지 않았다. 검증 쪽으로 옮겨 갔다.
8개 프로젝트가 실제로 바꾼 것
가벼운 유지보수도 있었고, 코드베이스 전체를 갈아엎는 작업도 있었다. cyvcf2는 낡은 빌드·패키징 체계를 정리했다. MHCflurry는 공개된 모델 가중치와의 호환성을 유지하면서 TensorFlow/Keras 백엔드를 PyTorch로 옮겼다. 보고서 표에 따르면 이 변경은 약 1만 줄에 걸쳤고 MHCflurry 2.2.0으로 배포됐다.
성능 개선 폭은 더 눈에 띈다. HI.SIM은 네 작업으로 구성된 벤치마크에서 출력 바이트를 그대로 유지하면서 총 실행 시간을 30.97% 줄였다. hifiasm은 최적화 대상에서 25%, 별도의 실제 인간 시퀀싱 데이터에서 약 15% 빨라졌다. bayesm-rs는 단일 스레드에서 2.3~2.7배, 여덟 스레드에서 4.4~9.5배 빨랐다. RustQC는 일부 품질 관리 워크플로에서 최대 60배, 디스크 입출력은 최대 25배 줄였다고 보고됐다.
이 숫자를 한 줄짜리 "AI가 과학 코드를 60배 가속했다"로 묶으면 곤란하다. 프로젝트마다 기준선, 데이터, 하드웨어, 허용 오차가 다르다. 이 보고서는 동일 조건의 모델 벤치마크가 아니라 참여 팀이 직접 쓴 사례 모음이다.
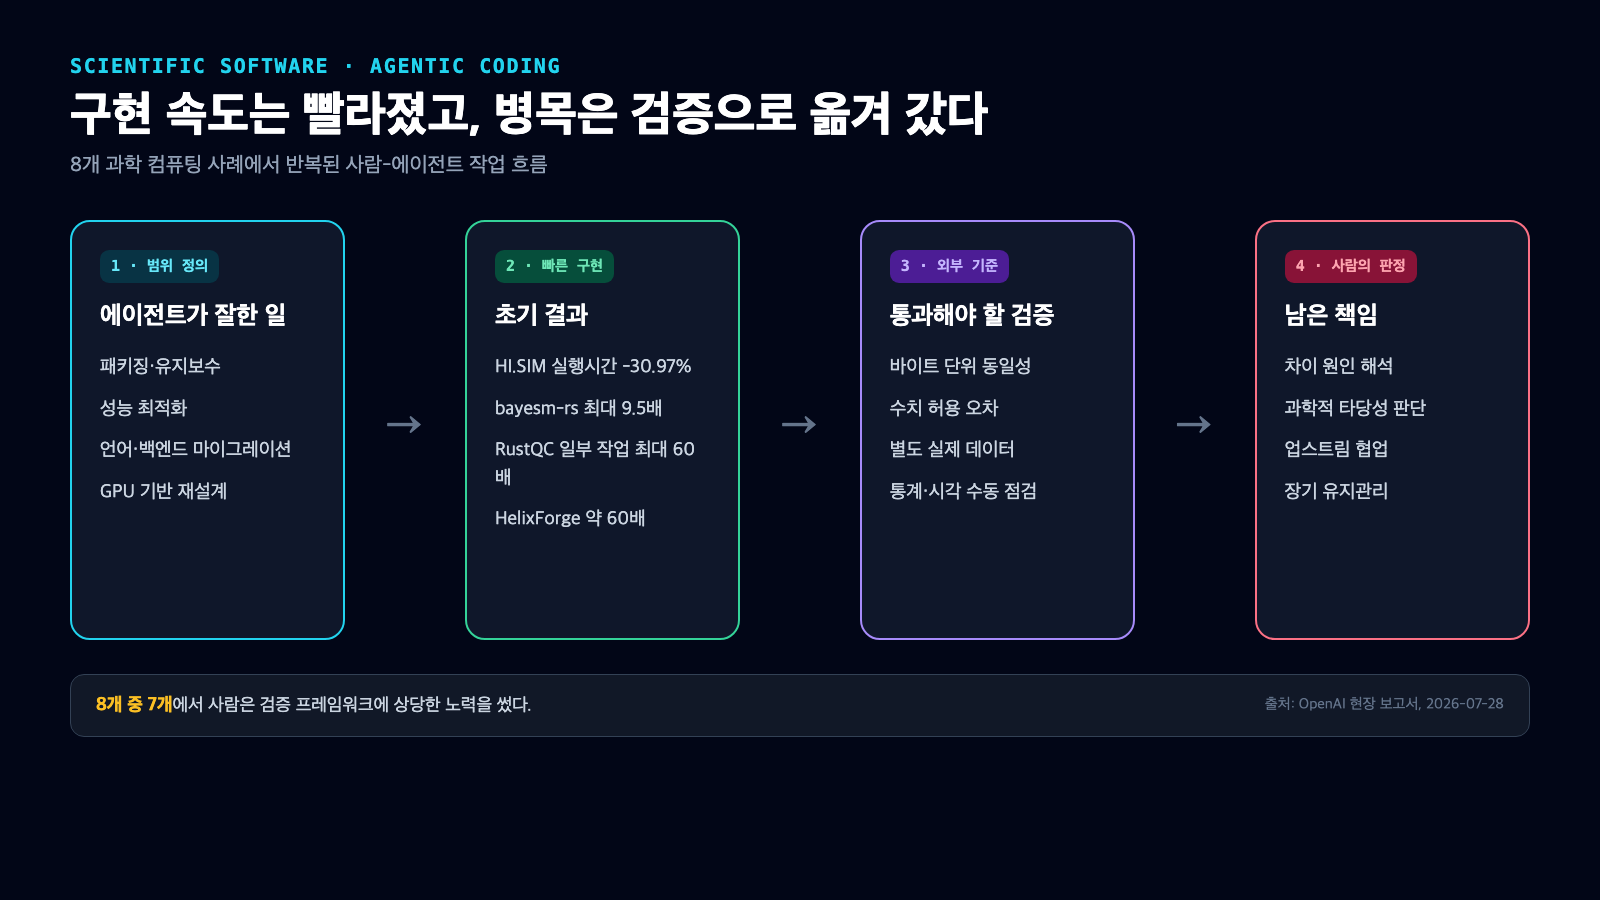
그림 1. 8개 사례에서 구현 속도는 빨라졌지만 사람의 일은 외부 기준 설계, 차이 해석, 과학적 판정과 유지관리로 이동했다. 출처: cdn.openai.com/pdf/scientific-computing-in-the-age-of-agentic-ai-an-exploratory-field-report.pdf.
마지막 10%가 가장 어려웠다
에이전트는 초기 구현을 빠르게 내놓았지만, 예외 처리와 작은 수치 차이를 정리하는 데 시간이 더 들었다. 보고서는 특히 "마지막 완성 단계"가 가장 많은 노력을 요구한 경우가 많았다고 적는다. 컴파일 성공이나 그럴듯한 출력은 약한 증거에 불과했다.
실제로 발견된 오류 유형도 전형적이다. 수치 기본값이 바뀌거나, 논리 흐름이 단순화되거나, 작은 합성 데이터에서는 보이지 않던 경계 조건이 실제 데이터에서 튀어나왔다. 에이전트가 자기 결과에 확신을 보였다는 사실은 검증 근거가 되지 않았다.
좋은 검증은 정답을 밖에 둔다
효과가 있었던 방법은 에이전트 바깥에 판정 기준을 두는 것이었다. HI.SIM은 기존 출력과 바이트 단위로 같아야 했다. MHCflurry는 공개 모델 가중치의 예측을 수치 허용 오차 안에서 재현해야 했다. hifiasm은 별도 데이터와 미리 정한 read-ordering 기준을 썼다. bayesm-rs는 기존 구현의 추정값과 수렴 진단을 비교했다.
시각화 도구 kuva처럼 자동 검사만으로 부족한 경우도 있었다. 기여자는 릴리스 전에 900개가 넘는 차트를 직접 눈으로 확인했다고 밝혔다. 테스트가 많다는 사실보다, 실패했을 때 무엇을 오답으로 볼지 먼저 정해 두는 일이 중요했다.
사람의 일은 구현에서 판정으로 이동했다
8개 중 HI.SIM을 제외한 모든 사례에서 사람은 검증 프레임워크를 만드는 데 상당한 시간을 썼다. 사람의 역할은 코드를 한 줄씩 작성하는 것보다 목표를 잘게 나누고, 수용 기준을 정하고, 차이를 해석하고, 배포 가능한 시점을 결정하는 쪽에 가까워졌다.
이 변화는 인력 절감과는 조금 다르다. 전문 지식이 필요 없어지는 게 아니라, 같은 전문가 시간이 다른 곳에 쓰인다. C나 CUDA 구현을 에이전트가 맡더라도 어떤 생물학적 결과가 맞는지, 어느 차이는 허용 가능한지, 새 구현을 기존 프로젝트에 합칠지는 사람이 결정해야 한다.
빠른 재구현은 유지보수 부채도 늘린다
코드를 다시 쓰는 비용이 낮아지면 비슷한 도구가 쉽게 늘어난다. 사용자가 여러 구현으로 흩어지면 비교 가능성과 유지보수 인력도 함께 분산된다. 성숙한 과학 소프트웨어에는 문서에 없는 관행, 호환성 요구, 사용자 신뢰가 쌓여 있다. 소스 코드를 새 언어로 옮겼다고 이 자산까지 복제되는 것은 아니다.
보고서는 가능한 경우 기존 유지관리자와 일찍 협력하라고 권한다. 실제로 MHCflurry와 cyvcf2 변경은 원래 프로젝트에 반영됐다. 별도 구현이 필요하다면 누가 버그를 고치고, 다음 데이터 형식을 지원하고, 결과 차이에 답할지부터 정해야 한다.
도입 전 체크리스트
첫째, 정답 판정 기준을 구현 전에 쓴다. 바이트 일치인지, 수치 허용 오차인지, 통계적 보정인지 구체적으로 정한다. 둘째, 작은 합성 데이터와 별도의 실제 데이터를 함께 둔다. 셋째, 기존 구현과 새 구현을 같은 입력으로 비교하고 차이를 저장한다. 넷째, 성능 수치는 하드웨어·스레드 수·데이터 규모와 함께 기록한다. 다섯째, 업스트림 반영 또는 장기 관리 주체를 릴리스 전에 정한다.
코딩 에이전트의 장점은 분명하다. 예전에는 시도조차 비쌌던 최적화와 마이그레이션을 작은 팀도 시작할 수 있다. 다만 과학 코드에서 진짜 완료 조건은 커밋이나 데모가 아니다. 독립적인 기준으로 결과를 설명하고, 다음 버전까지 책임질 수 있어야 한다.
참고 자료와 작성 범위
이 글은 AI를 활용해 OpenAI의 한국어 소개 글과 현장 보고서 PDF를 대조해 쓴 해설입니다. 8개 프로젝트를 독립적으로 다시 실행하거나 성능 수치를 재측정하지 않았습니다. 보고서의 수치는 참여 팀이 제시한 사례 결과이며, 통제된 공통 벤치마크로 해석하면 안 됩니다.


댓글
댓글 쓰기