최대 80배 빨라졌지만 CUDA Graph만의 공은 아니었다: GPU-CFR의 정적 실행 계획
1. GPU가 느린 문제가 아니라, GPU에 일을 건네는 방식이 느렸다
GPU는 큰 행렬 계산에 강하지만 작은 연산을 수십 번씩 호출하는 프로그램에서는 이야기가 달라진다. 커널 하나가 몇 마이크로초 만에 끝나면 실제 계산보다 파이썬 프레임워크의 디스패치와 커널 실행 요청이 더 비싸질 수 있다. GPU를 썼는데도 CPU 구현보다 느린 결과가 나오는 이유다.
2026년 9월 10일 처음 제출된 Boning Li와 Longbo Huang의 프리프린트 GPU-CFR는 이 문제를 반사실적 후회 최소화(Counterfactual Regret Minimization, CFR)에서 다룬다. CFR는 포커 같은 불완전정보 게임의 전략을 반복해서 갱신하는 알고리즘이다. 한 번의 반복은 게임 트리를 앞뒤로 훑으면서 도달 확률, 가치, 후회값을 계산한다. 트리는 불규칙하지만 같은 게임을 푸는 동안 구조는 바뀌지 않는다.
논문 제목의 80배는 모든 CFR 문제나 모든 GPU에서 보장되는 수치가 아니다. 한 대의 NVIDIA A100 80GB에서 동일 가속기를 사용한 Kim과 Sandholm의 GPU 기준선과 여덟 게임을 비교한 결과다. 논문은 GPU-CFR의 그래프 재생 경로가 기준선보다 29.8~80.4배 빨랐고 중앙값은 44.1배였다고 보고한다. 공개 표의 반올림된 밀리초 값을 다시 나누면 약 29.76~80.15배다. 논문 §10은 본문 배수를 반올림 전 중앙값에서 만들기 때문에 표를 다시 나눈 값과 마지막 자리가 다를 수 있다고 설명한다. 이 글은 원문의 보고값과 표 기반 재계산을 구분한다.
2. 매번 트리를 해석하지 않고 한 번 실행 계획으로 바꿨다
일반적인 트리 인터페이스는 각 노드의 종류와 자식, 정보 집합을 반복 중에 계속 묻는다. 이런 구조는 게임을 작성하기 쉽지만 GPU에는 잘 맞지 않는다. 작은 gather, multiply, scatter 연산이 긴 호출 목록으로 이어지고, 매 반복마다 같은 인덱스를 다시 해석한다.
GPU-CFR는 첫 반복 전에 게임을 평평한 배열과 깊이별 실행 블록으로 컴파일한다. 엣지, 정보 집합, 부모와 자식의 인덱스를 미리 만들고, 같은 깊이에서 처리할 항목을 한 번에 묶는다. 확률 노드의 고정 계산은 가능한 부분을 미리 접고, 두 플레이어의 도달 확률은 분리된 버퍼에 둔다. 이후 반복에서 달라지는 것은 전략, 도달 확률, 후회값 같은 수치 상태뿐이다.
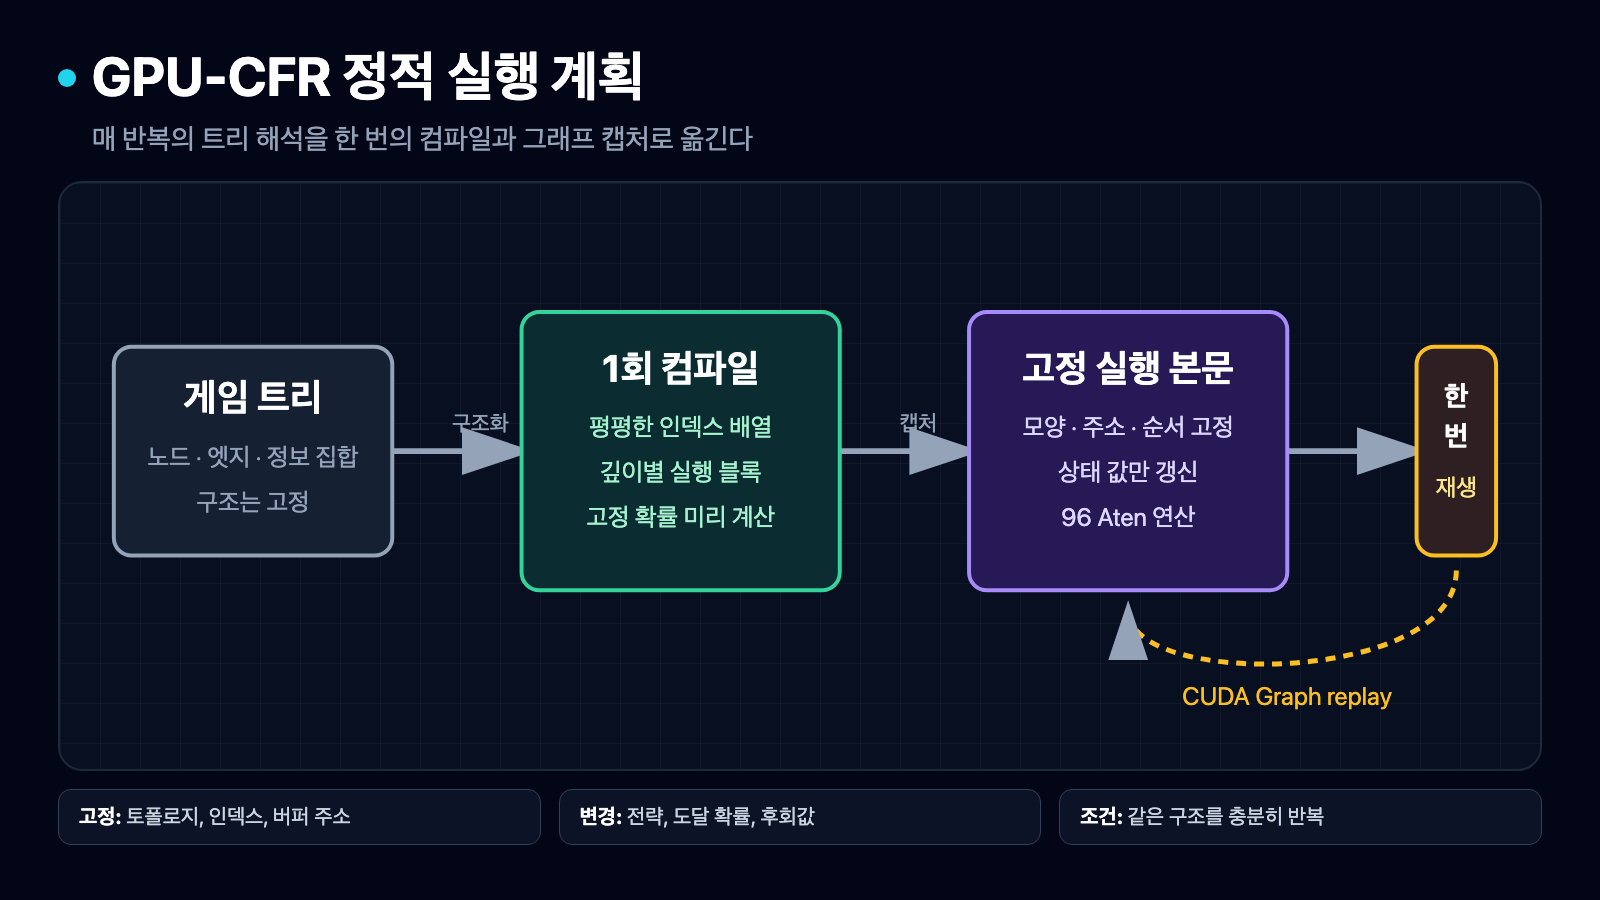
GPU-CFR의 실행 흐름. 토폴로지와 주소는 고정하고 전략·도달 확률·후회값만 반복 갱신한다. 출처: arxiv.org/html/2609.11923v1.
이 표현 변화가 중요한 이유는 CUDA Graph를 쓸 조건도 함께 만들기 때문이다. 텐서 모양, 인덱스, 버퍼 주소, 연산 순서가 고정되면 첫 실행을 캡처한 뒤 전체 반복을 하나의 그래프로 재생할 수 있다. 반대로 입력 모양이나 제어 흐름이 매번 바뀌는 프로그램에 그래프 재생만 붙인다고 같은 이득이 생기지는 않는다.
3. HUNL turn에서는 연산 1,742개가 96개로 줄었다
논문의 표 2에서 HUNL turn 하위 게임은 정보 집합 83,040개와 상태 433,610개를 가진다. 참조 구현은 반복당 PyTorch/Aten 연산 1,742개를 발행하지만 정적 데이터플로는 96개를 사용한다. 18.1배 감소다. 이 개수는 머신 부하와 무관하게 재현되는 구조적 지표라서, 시간 측정과 별도로 최적화가 어디서 왔는지 보여 준다.
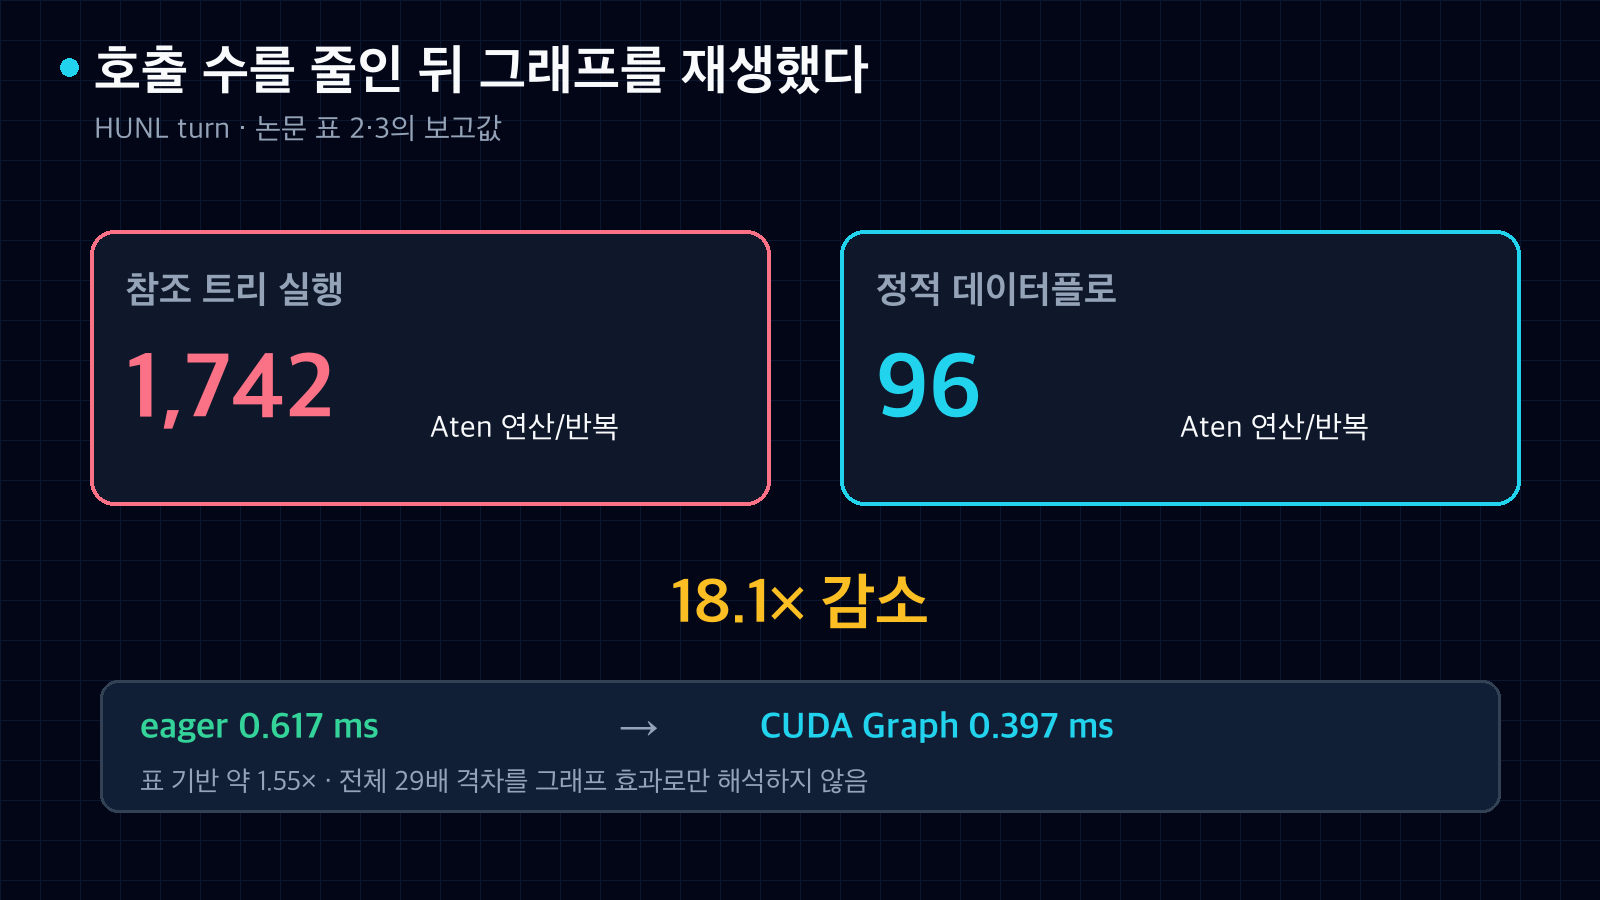
HUNL turn의 구조적 연산 수와 실행 시간. 전체 속도 차이는 정적 표현과 그래프 재생을 함께 반영한다. 출처: arxiv.org/html/2609.11923v1.
같은 HUNL turn에서 정적 데이터플로를 즉시 실행하는 eager 경로는 반복당 0.617ms, CUDA Graph 재생은 0.397ms로 보고됐다. 표의 값으로는 그래프 재생이 eager보다 약 1.55배 빠르다. 같은 A100의 Kim 기준선 11.893ms와 비교하면 약 29.96배다. 즉 29배 전체를 CUDA Graph 하나의 효과로 부르면 설명이 틀어진다. 긴 격차의 상당 부분은 트리를 정적 실행 계획으로 바꾼 데서 생겼고, 그래프 재생은 남은 디스패치 비용을 더 줄였다.
논문 전체 여덟 게임에서도 eager 정적 경로는 동일 GPU 기준선보다 17.4~23.5배 빠르고, 그래프 재생이 이를 29.8~80.4배로 늘렸다고 보고한다. CPU 여덟 스레드에서 같은 정적 표현을 실행해도 동일 A100 기준선보다 2.2~51.1배 빨랐다는 결과가 이 해석을 보강한다. 물론 CPU와 GPU의 장비 비용이나 전력, 구현 언어까지 같다는 뜻은 아니다. 여기서 확인할 수 있는 것은 표현과 디스패치의 분리다.
4. 작은 게임에서는 여전히 CPU가 이겼다
GPU 최적화 사례를 볼 때 가장 먼저 찾을 숫자는 최고 배수가 아니라 손익분기점이다. 가장 작은 Kuhn 게임은 정보 집합이 54개뿐이다. GPU-CFR 그래프 경로는 반복당 0.113ms였지만 단일 스레드 LiteEFG는 0.008ms였다. 표의 반올림 값만 놓고 보면 CPU 구현이 약 14배 빠르다. GPU에는 그래프 재생 자체의 고정 바닥 비용이 있기 때문이다.
반면 HUNL turn에서 LiteEFG는 102.160ms, GPU-CFR 그래프 경로는 0.397ms다. 표 기반 비율은 약 257.33배이며 논문은 이를 258배로 요약한다. 같은 코드 경로가 작은 게임에서 지고 큰 게임에서 크게 이긴다. “GPU가 빠르다”보다 “고정 비용을 채울 만큼 넓은 동일 연산을 반복하는가”가 더 정확한 질문이다.
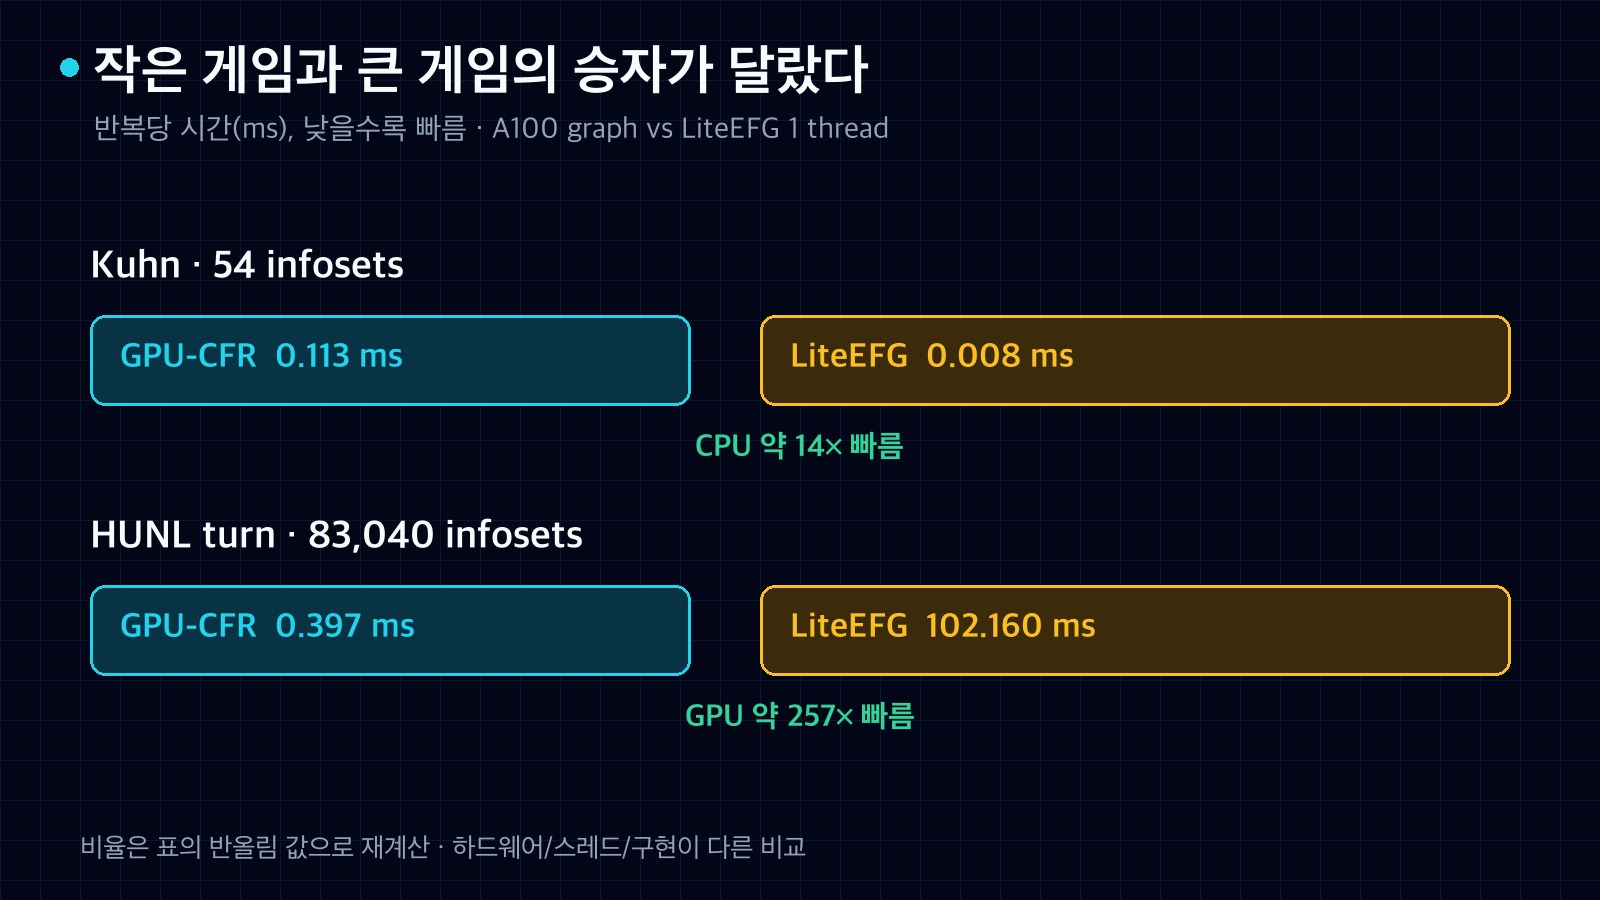
표 3의 반올림된 반복당 시간 재계산. 작은 문제의 GPU 고정 비용과 큰 문제의 배치 이득이 뒤집힌다. 출처: arxiv.org/html/2609.11923v1.
이 결과를 일반 애플리케이션에 옮길 때도 세 조건을 먼저 확인할 수 있다. 첫째, 토폴로지와 텐서 모양이 여러 번 재사용되는가. 둘째, 작은 연산 호출이 실제 커널 시간보다 많은가. 셋째, 컴파일과 그래프 캡처 비용을 갚을 만큼 반복하는가. 요청마다 그래프가 달라지는 동적 에이전트 흐름이나 짧게 한 번 실행하고 끝나는 작업은 이 사례와 조건이 다르다.
5. 속도 수치는 잘 정리됐지만 공개 코드만으로 전부 재현되지는 않는다
논문의 측정 환경은 A100 80GB PCIe 한 대, Intel Xeon Gold 6348 두 개, Linux 5.4, PyTorch 1.13.1+cu117, CUDA 11.7, Python 3.9.16이다. 각 셀은 부하가 낮은 독립 프로세스에서 반복됐고 표에는 중앙값이 실렸다. 그래프와 eager, 컴파일된 CPU 경로는 셀당 20개 독립 프로세스, 외부 기준선은 10개를 사용했다고 공개 저장소 README가 설명한다. steady-state 시간과 트리 구축·워밍업·캡처 시간도 분리했다.
하지만 저장소의 재현 범위에는 큰 제한이 있다. 고정 커밋 27fecde601fcaef745556eeb09a9c9dfe281e023을 확인해 보니 핵심 모듈 114개는 Python 소스가 아니라 CPython 3.9용 Linux x86-64 ELF 확장으로 배포됐다. Triton 커널 한 파일만 런타임 JIT 때문에 소스로 남아 있다. README는 NoRegret 기준선용 드라이버 두 개와 gpugt 드라이버가 포함되지 않았고, 참조 단계 타이밍 드라이버도 없어 전체 최적화 사다리를 패키지만으로 재현할 수 없다고 적는다. 저장소 최상위에서 라이선스 파일도 확인하지 못했다.
이 작업 환경은 macOS ARM이며 A100도 없다. 따라서 논문의 GPU 성능을 독립 실행했다고 주장하지 않는다. 이 글에서 독립적으로 수행한 일은 고정 커밋과 바이너리 형식 확인, 공개 표의 비율 재계산, HTML·PDF·README의 방법과 범위 대조다. 저장소 README에는 저자 측의 축소 재측정이 표 3의 그래프 경로 중앙값과 약 1% 이내였다고 적혀 있지만, 이것도 독립 제3자 재현 결과는 아니다.
6. 실무에서 가져갈 것은 “캡처”보다 “고정 가능한 것 찾기”다
GPU-CFR의 설계 순서는 유용하다. 먼저 반복마다 변하지 않는 토폴로지, 인덱스, 메모리 주소를 찾는다. 그다음 불규칙한 탐색을 넓은 배열 연산으로 바꾸고, 구조적 지표인 호출 수가 실제로 줄었는지 확인한다. 마지막에 CUDA Graph 같은 재생 기능으로 남은 실행 요청 비용을 줄인다. 그래프 캡처부터 시도하는 것보다 병목의 층을 구분하기 쉽다.
성능 보고도 같은 순서로 읽는 편이 낫다. 최종 배수 하나만 보면 하드웨어 효과, 표현 변화, 프레임워크 디스패치 감소가 섞인다. eager 대 graph, 같은 표현의 CPU 경로, 작은 게임의 역전 사례를 함께 봐야 어떤 조건에서 이득이 남는지 알 수 있다. 이 논문의 가장 흥미로운 대목은 “GPU에서 80배”라는 숫자보다, 매번 해석하던 문제를 한 번 컴파일할 수 있는 실행 계획으로 바꾼 데 있다.


댓글
댓글 쓰기