그럴듯한 추론 문장이 실제로 중요한 단계는 아니었다: 노이즈 상한보다 9배 낮은 LLM 심판
연쇄 사고(chain-of-thought)를 읽으면 모델이 왜 답을 골랐는지 알 수 있을 것 같다. "다시 확인해 보자" 같은 문장은 특히 중요해 보인다. 하지만 같은 뜻으로 보이는 두 문장이 결과에 미친 영향은 전혀 다를 수 있다. 한 단계는 없어도 답이 그대로이고, 다른 단계는 정답에 도달할 확률을 크게 바꾼다.
9월 3일 공개된 논문 「Legibility is Not Interpretability」는 이 차이를 문장의 그럴듯함이 아니라 이후 행동 변화로 측정했다. 각 추론 단계까지의 문맥에서 답변을 약 50번 다시 생성하고, 그 단계가 최종 답에 도달할 확률을 얼마나 바꿨는지 계산한다. 연구진은 이를 강화학습의 advantage에 빗대어 단계 중요도로 정의했다. 결론은 불편하다. 큰 LLM 심판도 중요한 단계를 무작위 기준보다 잘 찾았지만, 측정 잡음이 허용하는 상한에는 한참 못 미쳤다. 정답 응답의 핵심 단계는 오답 응답보다 더 찾기 어려웠다.
요약: 읽을 수 있다는 것과 원인을 안다는 것은 다르다
추론 문장은 사람이 읽을 수 있다. 그렇다고 그 문장이 모델의 최종 행동을 실제로 바꾼 지점인지 텍스트만 보고 확정할 수는 없다. 논문의 예시에서 비슷한 두 자기 점검 문장 중 하나는 정답 확률을 바꾸지 않았고, 다른 하나는 좌표 부호 오류를 발견하면서 약 52%에서 94%로 올렸다.
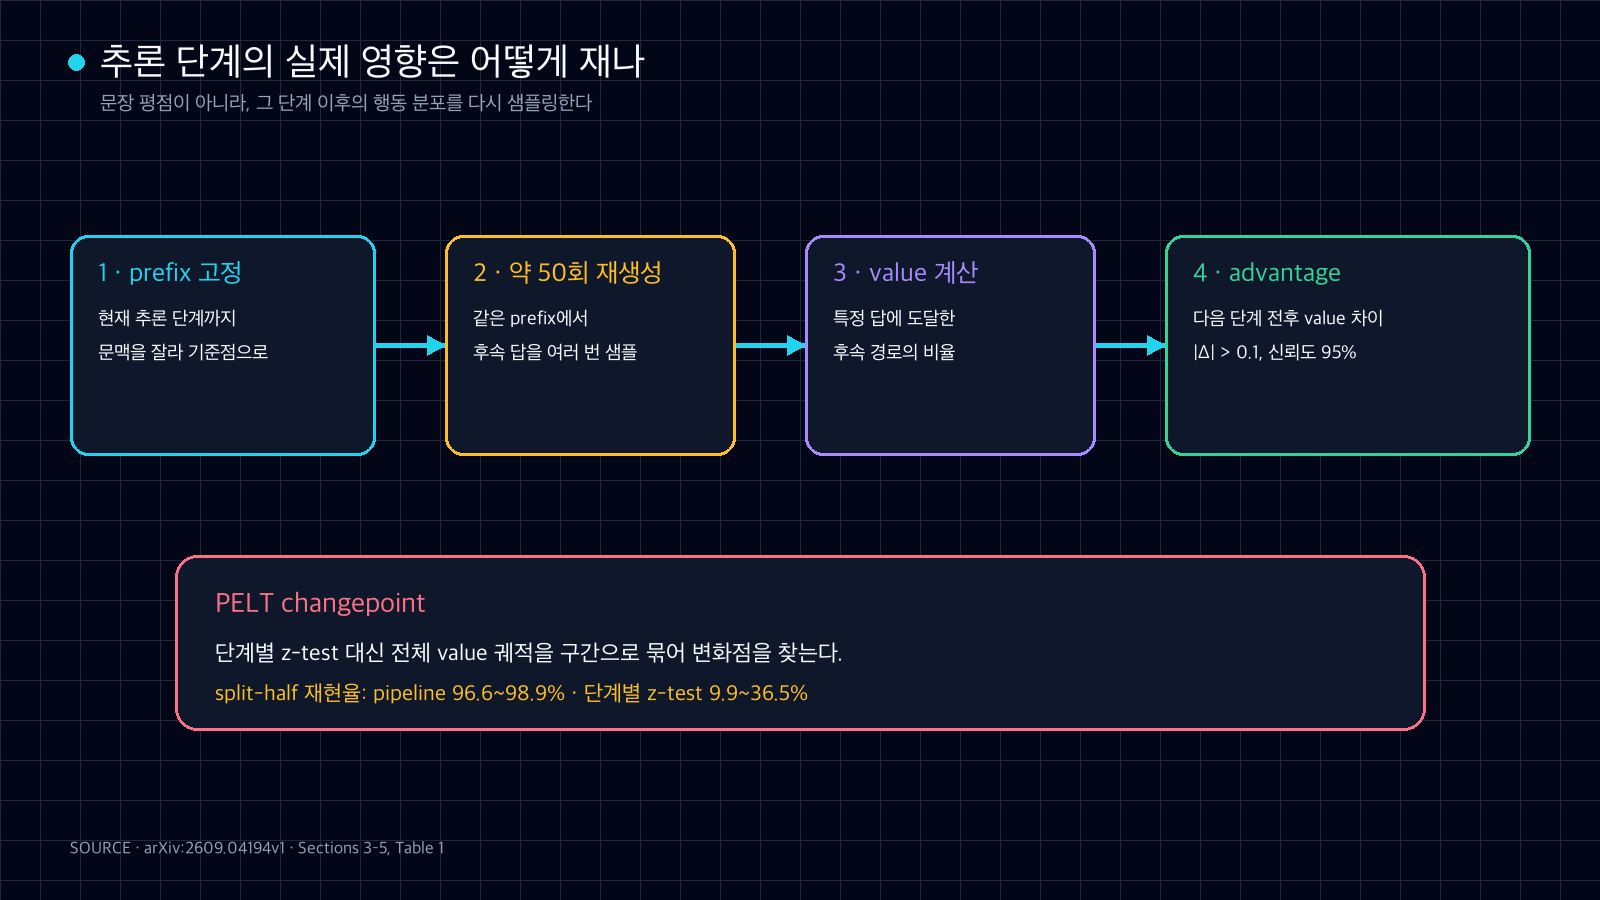
문장 자체를 평가하지 않고 각 추론 단계 뒤에서 후속 경로를 다시 생성해 최종 답 분포가 얼마나 달라지는지 측정한다. 출처: arxiv.org/html/2609.04194v1.
연구진은 이 차이를 개입에 가까운 방식으로 재구성했다. 추론을 두 줄 바꿈 기준으로 단계화하고, 각 prefix 뒤에서 여러 continuation을 샘플링한다. 다음 단계가 포함됐을 때 특정 답에 도달하는 비율이 달라지면 그 차이가 self-advantage다. 절댓값이 0.1보다 크고, 앞뒤 구간의 베타 사후분포가 그 변화를 95% 이상 지지할 때 consequential step으로 표시했다. 단순히 문장을 읽고 "중요해 보인다"고 채점한 label과는 출발점이 다르다.
측정 방식: 한 문장을 50개의 이후 경로로 시험했다
주요 수학 실험은 AIME 2024·2025·2026, AMC 2023, MATH-500, GSM8K에서 각각 30문제를 골랐다. Qwen3 1.7B·4B·8B의 thinking mode를 끄고 문제마다 응답 10개를 만들었다. 논문 표현대로 모델별 180문제, 1,800개 응답이다. 각 추론 단계에서는 약 50개의 후속 답을 다시 생성했다. Qwen3 1.7B의 thinking mode 실험은 AIME 2024·2025와 GSM8K로 범위를 줄였고, 계산량 때문에 긴 응답의 꼬리도 제외했다.
50번 샘플링한 비율은 그 자체로 흔들린다. 연구진은 단계별 차이를 바로 검정하는 대신, 전체 value 궤적을 구간별 상수로 보고 PELT changepoint를 찾았다. 공개된 교차 검증 표에서 이 pipeline의 split-half 재현율은 네 설정에서 96.6~98.9%였다. 단계마다 z-test를 적용한 방식은 9.9~36.5%였다. 선택된 효과가 다른 절반에서도 유지되는 비율도 pipeline은 0.93~0.98, z-test는 0.15~0.59였다.
이 수치는 "논문이 진짜 중요한 단계를 완벽하게 알아냈다"는 뜻이 아니다. Monte Carlo label에도 잡음이 있으므로 연구진은 rollout을 반으로 나눈 값으로 보수적 noise ceiling을 따로 계산했다. 이후의 LLM 심판과 critic은 1.0이 아니라 이 상한과 비교해야 한다.
결과: 오답의 실수는 보이지만 정답의 전환점은 흐렸다
텍스트만 보는 심판은 Qwen3 1.7B·8B·32B와 Qwen3.6 27B였다. 가장 좋은 기성 심판도 self-advantage PR-AUC에서 in-distribution noise ceiling보다 9배, out-of-distribution ceiling보다 6배 낮았다. 모델을 크게 만든다고 실제 중요도가 그대로 드러난 것은 아니다.
연구진이 같은 backbone에 회귀 head를 붙여 critic으로 미세조정하자 오답 응답은 나아졌다. PR-AUC는 ID에서 0.28~0.30, OOD에서 0.18~0.32로, 약 0.6인 보수적 상한의 절반 수준까지 갔다. 정답 응답은 ID 0.065~0.10에 그쳤다. 대응하는 상한 0.51~0.64의 10~20% 수준이다.
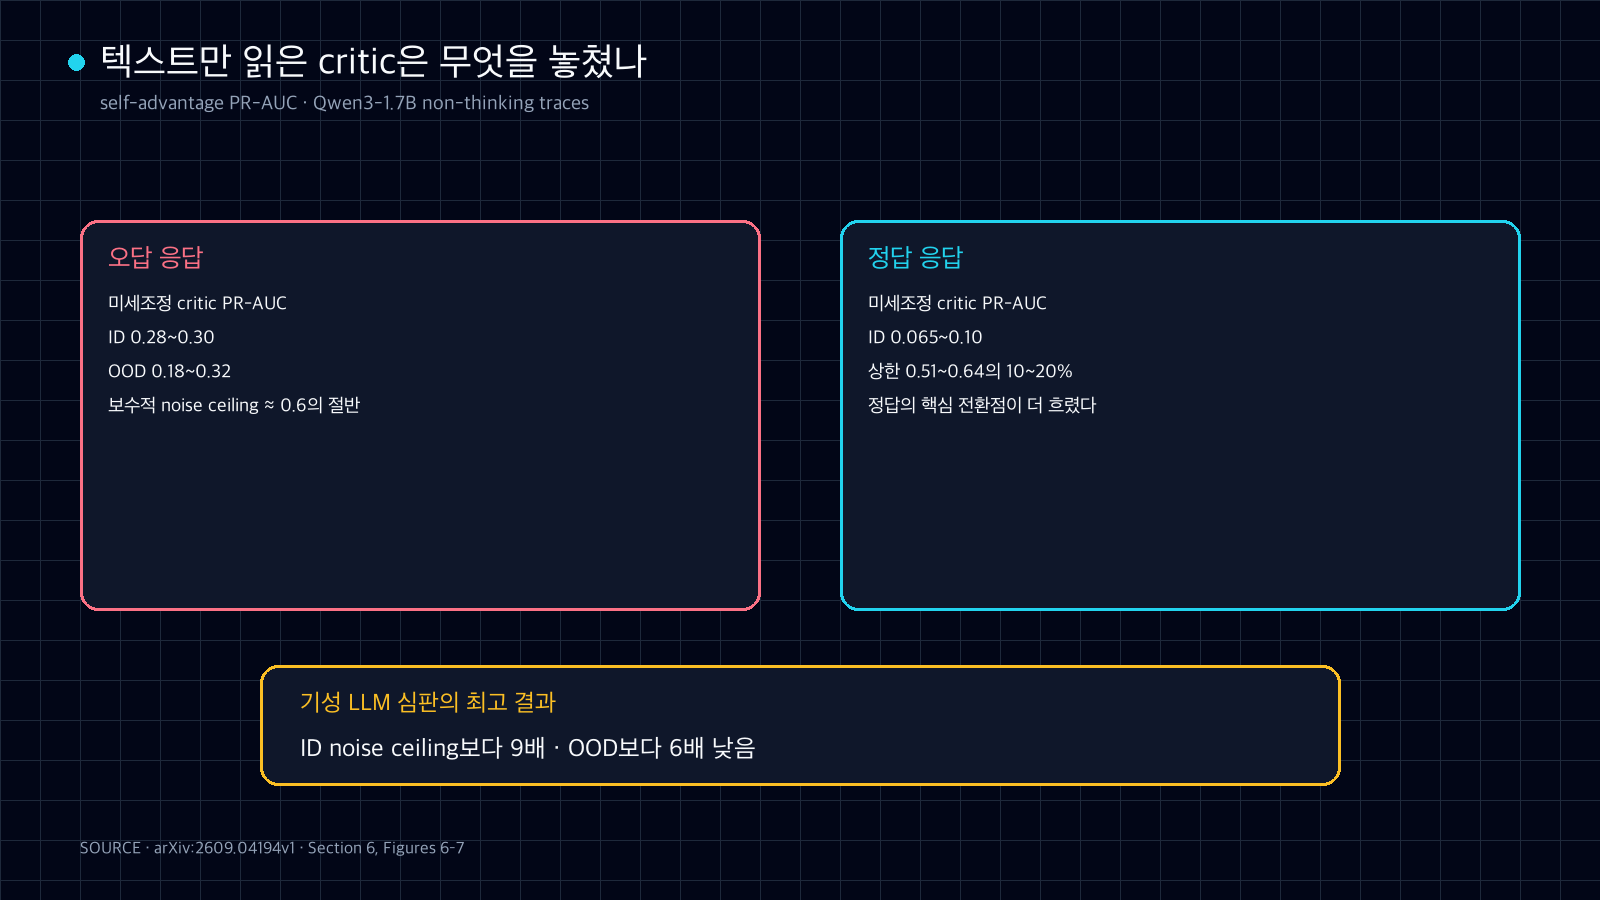
오답 응답의 중요한 단계는 일부 찾았지만 정답 응답의 핵심 단계는 보수적 noise ceiling의 10~20% 수준에 머물렀다. 출처: arxiv.org/html/2609.04194v1.
검토 예산을 아주 작게 잡으면 제한적인 용도는 있었다. 오답 응답에서 critic이 상위 0.5%로 고른 단계의 precision은 ID 0.55~0.60, OOD 0.55~0.72였다. 하지만 정답 응답에서는 ID 0.08~0.16, OOD 0.18~0.29로 떨어졌다. "틀린 풀이에서 수상한 몇 줄 찾기"와 "맞은 풀이에서 답을 만든 핵심 줄 찾기"는 같은 문제가 아니다.
왜 정답 쪽이 더 어려웠을까
논문은 오답 응답의 높은 점수 일부가 쉬운 proxy일 수 있다고 경고한다. 오답 모델은 마지막에 갑자기 잘못된 답을 내놓는 경우가 있고, final answer emission은 텍스트에서도 찾기 쉽다. 반면 정답 풀이의 중요한 단계는 이미 맞는 방향으로 진행되는 문장들 사이에 섞여 있다. 읽기 좋은 설명과 행동을 바꾼 순간이 일치하지 않을 수 있다.
또 하나의 관찰은 thinking과 scale의 효과였다. value 궤적을 여섯 유형으로 나누면, thinking을 켰을 때 처음부터 value가 높은 응답이 24%에서 61%로 늘었다. 모델 크기를 키운 비교에서는 25%에서 39%로 늘었다. 중간에 극적으로 회복한 응답이 많아진 것보다, 첫 단계부터 사실상 풀린 문제가 늘어난 쪽이 주된 변화였다. 길어진 추론에서 눈에 띄는 전환 문장을 찾는 것만으로 성능 향상을 설명하기 어려운 이유다.
Scruples 100개 예시에 외부 힌트를 넣은 별도 실험도 같은 경계를 보여 줬다. 기본 응답은 58%가 consequential step을 하나 이상 포함했지만, 힌트를 준 응답은 15%뿐이었다. 힌트가 답의 방향을 거의 결정하면 이후 추론 문장은 길어도 행동에 새 정보를 더하지 않을 수 있다.
실전 적용: process reward에는 행동 근거가 더 필요하다
추론 단계 평가기를 만들 때 문장 품질 label만으로 충분하다고 가정하면 안 된다. 설명이 논리적이고 자기 점검 표현이 있다는 사실은 유용한 신호지만, 그 단계가 결과를 바꿨다는 증거는 아니다. 최소한 일부 표본에는 prefix resampling, 대체 continuation, 삭제·교체 실험처럼 행동 차이를 관찰하는 label을 섞는 편이 낫다.
운영 비용도 크다. 공개 데이터 설명에 따르면 원시 실험 산출물은 약 3.15TB이며, 단계마다 약 50개의 rollout을 저장한다. 모든 production trace에 그대로 적용하기보다는 실패가 비싼 작업, critic의 신뢰도를 보정할 audit set, 새 모델 버전 비교에 제한적으로 쓰는 편이 현실적이다. 먼저 텍스트 critic으로 후보를 좁히고, 작은 표본만 rollout으로 확인하는 2단계 감사가 비용과 근거를 타협하는 방법이다.
정답과 오답도 분리해 보고해야 한다. 이 논문에서는 오답 단계 탐지가 훨씬 쉬웠다. 전체 평균 하나로 합치면 critic이 정답의 핵심 근거까지 읽어냈다는 인상을 줄 수 있다. 모델 크기, thinking mode, 데이터 난이도, 최종 답의 정오를 나눠 calibration curve와 precision-at-budget을 확인해야 한다.
범위와 주의점
이 연구의 중심은 수학 추론과 Qwen3 계열이다. code agent, tool use, 긴 대화, 다른 언어의 추론에 같은 수치가 유지된다고 볼 근거는 없다. 단계 경계도 두 줄 바꿈에 의존하며, thinking trace의 완만한 변화는 구간별 상수라는 changepoint 가정과 덜 맞을 수 있다. 부록은 thinking trace에서 ramp 형태가 더 자주 나타났다고 보고한다.
공개 Hugging Face 데이터셋과 README는 확인했지만, 논문에 연결된 GitHub 저장소는 조사 시점에 HTTP 404를 반환했다. 데이터셋은 일반 load_dataset 형식이 아닌 3.15TB 규모의 중첩 CSV·JSON 실험 저장소다. 이 조사에서는 전체 데이터를 내려받아 PR-AUC와 changepoint label을 재계산하지 않았다. 따라서 수치는 논문 표와 공개 데이터 설명을 대조한 결과이며 독립 재현 결과로 표현하지 않는다.
이 논문이 말하는 바는 연쇄 사고가 무가치하다는 것이 아니다. 읽기 가능한 추론은 디버깅 단서를 준다. 다만 그 텍스트가 실제 원인인지 확인하려면, 문장 자체가 아니라 그 문장 전후에서 모델의 행동이 어떻게 달라지는지까지 봐야 한다.


댓글
댓글 쓰기