임베딩 중간 상태를 절반 줄여도 검색 점수는 99.53% 유지됐다: FastE의 압축 타이밍
검색용 문서 임베딩을 만들 때 긴 입력을 처음부터 끝까지 같은 길이로 계산해야 할까. 9월 8일 공개된 FastE 논문은 계산 중간에 입력 토큰의 숨은 상태 일부를 버리는 방법을 제안한다. 핵심은 무엇을 버릴지뿐 아니라 언제 버릴지다. 너무 일찍 줄이면 마지막 임베딩이 필요한 정보를 충분히 받지 못한다.
저자들은 Qwen3-Embedding-0.6B의 NarrativeQA 실험에서 prefix 상태를 50% 제거했을 때 기존 nDCG@10의 99.53%를 유지하고, 문서 임베딩 생성의 종단간 처리 속도가 1.363배였다고 보고한다. 검색 정확도가 99.53%라는 뜻은 아니다. 기존 검색 순위 점수에 대한 비율이며, 이 글은 논문 수치를 대조한 해설이다. 모델 추론을 직접 재현한 사용기로 읽으면 안 된다.
요약: 문장을 자르는 대신 계산 중간을 줄인다
FastE는 입력 문서 앞뒤를 잘라 토크나이저에 넣는 전처리 기법이 아니다. 처음에는 전체 입력을 모델에 통과시킨다. 마지막 위치의 readout 토큰이 앞선 입력을 읽고, 그 상태가 최종 문서 임베딩이 되는 구조를 대상으로 한다. 앞쪽 입력 위치의 층별 표현이 논문에서 말하는 prefix 상태다.
방법은 학습을 추가로 하지 않는다. Qwen의 공식 저장소 예제도 마지막 유효 토큰 상태를 뽑는 last_token_pool을 사용한다. 이 모델 인터페이스의 확인과 FastE의 속도 결과 검증은 별개다. 초반 층에서는 전체 상태를 유지하고, 이후 readout 상태와 prefix 평균 표현 사이의 코사인 유사도를 감시한다. 배치 평균 유사도가 정해진 임계값을 처음 넘으면 압축한다. 남길 상태는 readout이 보내는 attention 점수로 고른다. 하나의 신호가 압축 시점을, 다른 신호가 보존 대상을 담당한다.
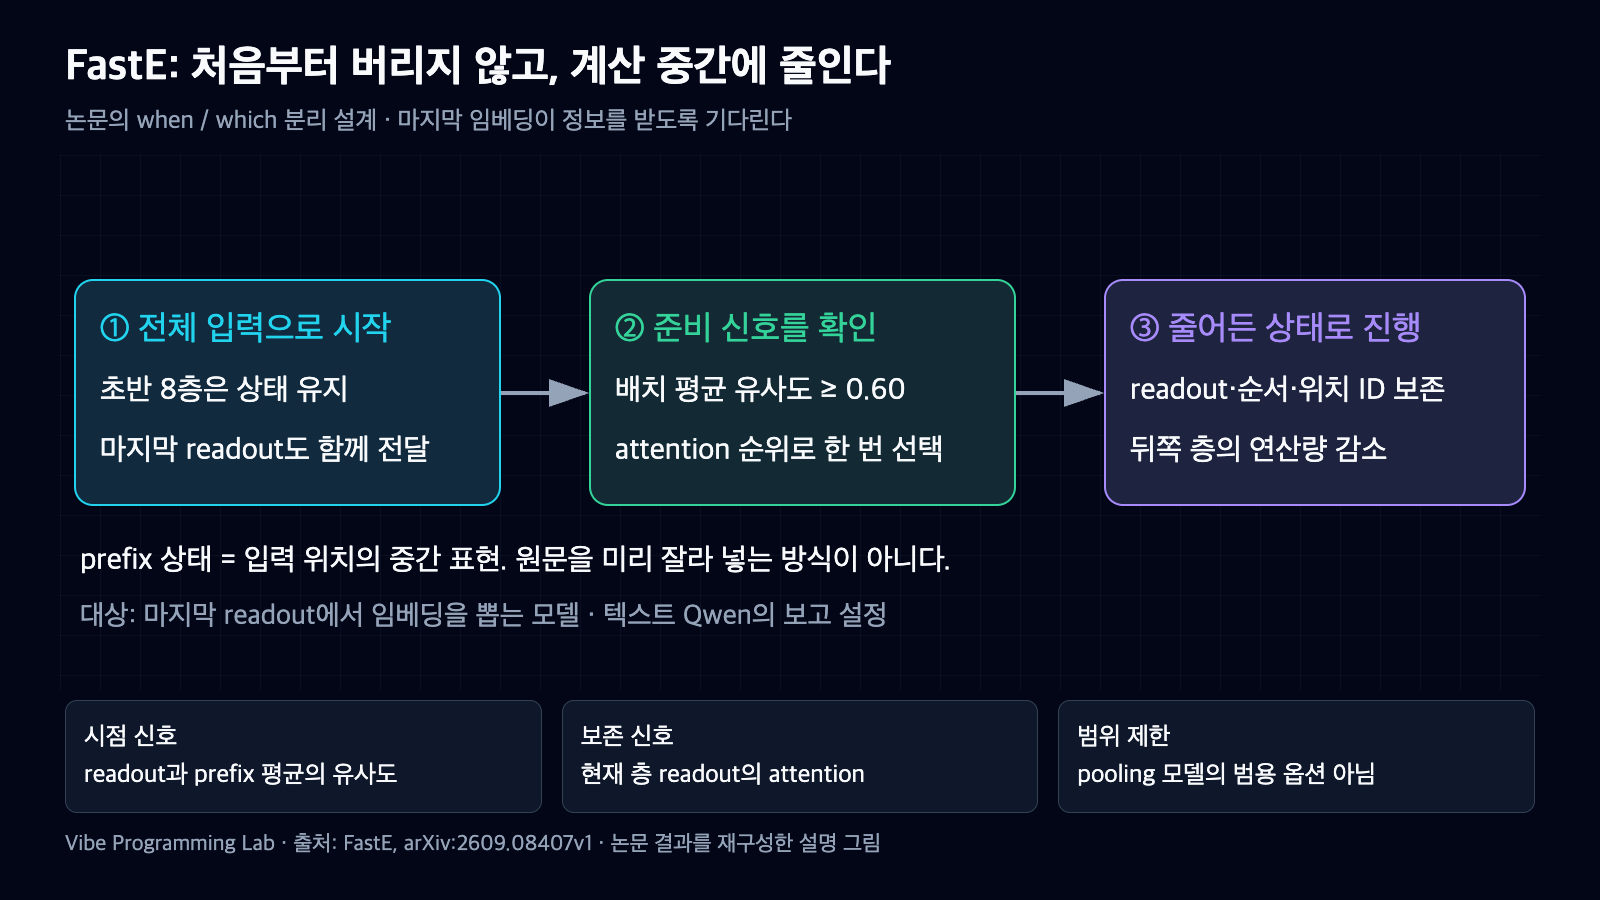
텍스트 Qwen의 warm-up 8·임계값 0.60 설정. 압축 시점과 남길 상태를 고르는 신호가 다르며 readout·원래 순서·위치 ID는 보존한다. 출처: arxiv.org/html/2609.08407v1.
이 설계가 중요한 이유는 입력 정보를 깊은 층까지 전달한 뒤 계산량을 줄이기 때문이다. 앞에서부터 일정 비율을 자르는 방법과 같지 않다. 생성 모델이 다음 토큰을 출력하기 위해 과거 KV 캐시를 줄이는 작업과도 구분해야 한다. 여기서 주된 대상은 한 번의 순전파로 벡터 하나를 만드는 임베딩 추론이다.
작동 방식: 기다렸다가 한 번만 고른다
논문의 텍스트 Qwen 설정은 warm-up 깊이 8, 유사도 임계값 0.60을 사용한다. 이 조합은 NarrativeQA 검증 분할에서 선택한 뒤 보고된 텍스트 과제에 고정했다. 압축 비율은 별도 설정이다. 임계값이 높아졌다고 자동으로 더 적은 토큰을 버리는 것이 아니라, 같은 예산으로 줄이는 시점이 달라진다.
압축 시점에는 현재 층의 Q/K 투영으로 readout이 각 prefix 상태에 보내는 attention 점수를 구한다. 높은 점수를 받은 상태를 목표 개수만큼 남기고, readout 자체는 보존한다. 살아남은 상태의 원래 순서와 위치 ID도 유지한다. 이후 층들은 짧아진 상태열을 처리하며 반복해서 제거 대상을 다시 고르지 않는다.
임계값을 끝내 넘지 않는 배치에는 마지막 transformer 블록 직전의 압축 경로가 있다. 이때는 남은 계산이 적어 절감 효과도 제한된다. 따라서 임계값을 높이면 언제나 품질과 속도를 함께 얻는다고 생각하면 곤란하다. 어느 깊이까지 전체 정보를 전달할지와 뒤에 얼마나 많은 연산을 남겨 둘지가 맞물린다.
40.11% 연산 절감과 1.363배 속도는 다른 수치다
Table 5의 0.6B·50% 제거 조건에서 nDCG@10은 Full Forward의 0.45395에서 0.45181로 바뀐다. 이를 기준 점수로 나눈 값이 약 99.53% 유지율이다. nDCG는 상위 검색 결과의 순위 품질을 보는 지표다. 모델이 질문의 99.53%를 맞혔다는 해석이나 생성 답변의 사실성이 보장된다는 해석은 성립하지 않는다.
같은 조건의 decoder-backbone FLOPs 감소율은 40.11%다. 그러나 실측 GPU-forward 속도는 1.540배, 문서 인코딩 E2E 속도는 1.363배다. FLOPs 계산에는 투영·attention·MLP 연산을 넣지만 정규화, RoPE, 임베딩, 압축 제어 등의 모든 비용을 넣는 것은 아니다. 반면 시간 측정에는 alignment 검사와 점수 계산, Top-K 선택의 부담이 포함된다.
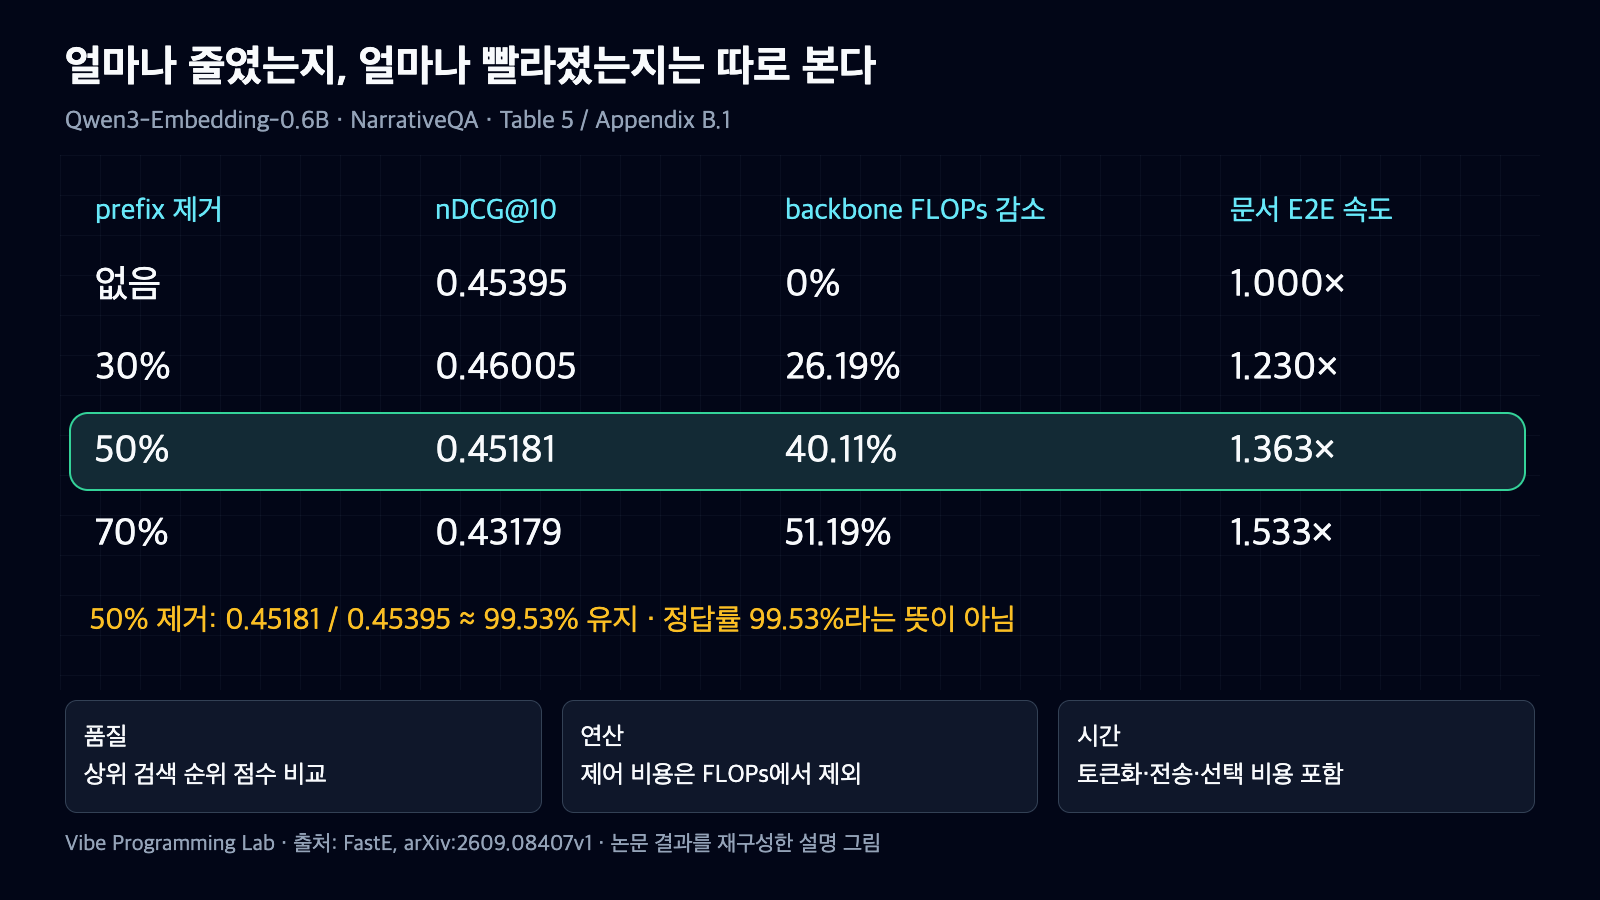
Table 5의 50% 제거 조건은 nDCG@10 0.45181, FLOPs 40.11% 감소, 문서 E2E 1.363배다. 99.53%는 Full Forward 검색 점수 대비 유지율이며 정답률이 아니다. 출처: arxiv.org/html/2609.08407v1.
Appendix B.1은 E2E에 토큰화, CPU에서 GPU로의 전송, 압축, 임베딩 출력을 포함한다고 명시한다. 검색 서비스 전체의 응답 시간이 아니다. 주요 Qwen 실험은 A100 한 장, 길이순 배치, 배치 크기 4, 최대 길이 5,000 설정이며, 문서 처리 대상은 NarrativeQA 문서 355개다. 저자들은 다섯 번의 실행을 보고한다.
70% 제거로 가면 0.6B의 E2E 속도는 1.533배지만 점수는 0.43179로 낮아진다. 더 빠른 설정을 고르는 순간 품질 예산도 함께 바뀐다. 표의 paired-run 속도비는 표시된 평균 시간을 단순히 나눈 값과 꼭 같지 않다는 부록 주석도 있다. 숫자들이 어긋나 보인다고 임의로 속도비를 고쳐 쓰지 않았다.
무엇을 버리느냐만큼 언제 버리느냐가 중요했다
Table 6은 70%라는 제거 비율과 attention 순위 방식을 고정하고 시작 깊이만 비교한다. 고정 L9는 FLOPs를 55.55% 줄이지만 nDCG@10이 0.40351이다. 동적 방식은 0.43179와 51.19% 절감을 기록한다. 가장 일찍 줄인 조건이 계산은 적지만 점수도 더 많이 잃었다.
동적 방식은 품질이 가장 높았던 고정 L12 조건보다도 높은 점수와 더 큰 FLOPs 절감을 보였다. 그렇다고 매 배치의 최적 층을 찾아냈다는 증거는 아니다. Appendix B.8에서 깊이와 길이를 통제한 alignment와 표현 왜곡의 부분 상관은 −0.190이다. 저자들도 이 신호를 정확도 최적점을 알아내는 판정기가 아니라 깊이에 따른 압축 준비 상태의 휴리스틱으로 해석한다.
보존 대상을 고르는 방법도 결과에 영향을 준다. Table 7에서 같은 동적 시작 조건에 무작위 순위를 쓰면 nDCG@10은 0.1426, 위치만 사용하는 방식은 0.05006이다. 다만 이 비교는 해당 모델과 데이터, 70% 제거 조건 안에서 읽어야 한다. 모든 임베딩 모델에 같은 차이가 생긴다고 확대할 수 없다.
적용 범위와 재현성: 바로 켜는 범용 옵션은 아니다
FastE는 마지막 readout 상태에서 벡터를 뽑는 모델을 대상으로 한다. 여러 토큰을 평균내는 pooling 모델에는 다른 신호가 필요하다고 저자들이 한계에 적었다. Qwen3-VL의 임계값은 0.70, E5-Mistral은 0.40이다. 텍스트 Qwen의 0.60을 모든 모델에 복사해서 쓰는 계약이 아니다.
배치 평균 신호를 쓰므로 배치 구성도 기록해야 한다. 부록은 길이순으로 정렬한 배치 크기 1~16에서 비교적 안정적인 결과를 제시하지만, 임의로 섞은 배치에 대한 불변성을 증명하지는 않는다. 이미지 검색으로의 확장 결과도 일부 과제에서 확인한 수준이며, 영상이나 모든 멀티모달 모델의 결과는 아니다.
또 하나의 경계는 공개 산출물이다. 이번에 확인한 arXiv v1 본문과 초록 페이지에서는 FastE의 저자 소유 구현·원시 실행 로그로 이어지는 링크를 찾지 못했다. 따라서 이 글의 검증은 논문 본문·표·부록의 대조와 표시 수치 재계산까지다. 공개 코드로 보고된 속도를 재현했다고 주장하지 않는다. 논문이 제시한 방법을 구현하는 일과 저자의 실험을 같은 환경에서 다시 실행하는 일은 구분해야 한다.
실전 적용: 먼저 문서 인코딩의 품질 예산을 정한다
검색 시스템에 적용을 검토한다면 readout 기반 모델인지부터 확인한다. 그다음 실제 문서 길이 분포와 질의 집합을 고정하고 Full Forward 기준을 남긴다. 압축 설정은 기존 벡터와 섞어 무작정 운영하기보다 별도 인덱스에서 비교하는 편이 안전하다. 이 절차는 논문이 검증한 배포 처방이 아니라, 실험 경계를 지키기 위한 운영 제안이다.
비교표에는 nDCG@10 같은 순위 지표와 함께 문서 인코딩 시간, 최대 메모리, 제거 비율, trigger 깊이 분포를 적는다. 인덱스 갱신 주기가 병목인 서비스와 사용자 질의 응답이 병목인 서비스는 얻는 효과가 다르다. 벡터 생성이 빨라져도 데이터베이스 검색이나 후속 생성 시간이 그대로라면 전체 지연 개선은 작을 수 있다.
초기 후보는 공격적인 70%보다 30%와 50% 제거 조건부터 점검할 만하다. 다만 특정 비율을 기본값으로 권하는 것은 아니다. 중요한 문서 유형의 검색 누락이 허용 범위를 넘으면 그 설정은 버려야 한다. 평균 유지율이 좋아도 실제로 찾아야 할 드문 문서를 잃으면 검색 제품에는 손해다. FastE가 보여준 실용적인 질문은 단순하다. 같은 정보를 매 층에 계속 운반하는 비용을, 내 검색 품질 예산 안에서 어디까지 줄일 수 있는가.


댓글
댓글 쓰기