코딩 에이전트 A/B 테스트, 113개 중 22개만 한 번 실행에 버텼다
코딩 에이전트의 프롬프트나 스킬을 고칠 때마다 전체 벤치마크를 다시 돌리기는 어렵습니다. 비용이 크고, 결과가 나올 때쯤 다음 수정이 이미 들어가 있기 때문입니다. 그렇다고 임의로 몇 문제만 골라 한 번씩 실행하면 우연을 개선으로 착각하기 쉽습니다.
2026년 9월 17일 공개된 DeltaSelect: Affordable A/B Testing for Coding Agents는 이 사이를 파고듭니다. 과거 반복 실행에서 전체 점수의 움직임을 비교적 잘 따라간 과제를 찾고, 정해 둔 예산 안에서 고정된 소수 과제만 골라 baseline과 candidate를 비교합니다. 목적은 모델 순위표를 만드는 일이 아닙니다. 한 팀이 같은 개발 주기 안에서 "이번 변경을 유지할까"를 더 자주 판단하는 데 있습니다.
한 번 실행해도 신호가 남는 과제는 많지 않았다
연구가 사용한 DeepSWE v1.1 스냅샷에는 18개 모델, 50개 모델·추론 강도 조합, 113개 과제의 반복 실행이 들어 있습니다. 원시 trial은 22,586개였고, 그중 22,417개를 분석에 사용했습니다. 제외된 169개는 값을 채워 넣지 않았습니다.
각 과제는 조합별로 네 번 실행돼 있었습니다. 연구자는 그 네 번 중 하나만 뽑는 과정을 조합마다 수행하고, 그 결과가 전체 DeepSWE 점수와 얼마나 같이 움직이는지 계산했습니다. 이 재표본 추출을 과제마다 10,000번 반복한 뒤 Pearson 상관계수 분포의 5백분위수를 보수적인 순위값으로 삼았습니다.
결과는 생각보다 좁았습니다. 113개 중 22개, 19.5%만 5백분위 상관계수 0.50 이상이었습니다. 0.70을 넘은 과제는 두 개뿐이었습니다. 중앙 과제의 5백분위 상관계수는 0.321이었습니다. 과제 하나를 한 번 실행한 결과가 전체 벤치마크 변화를 안정적으로 대신해 주는 경우는 소수였다는 뜻입니다.
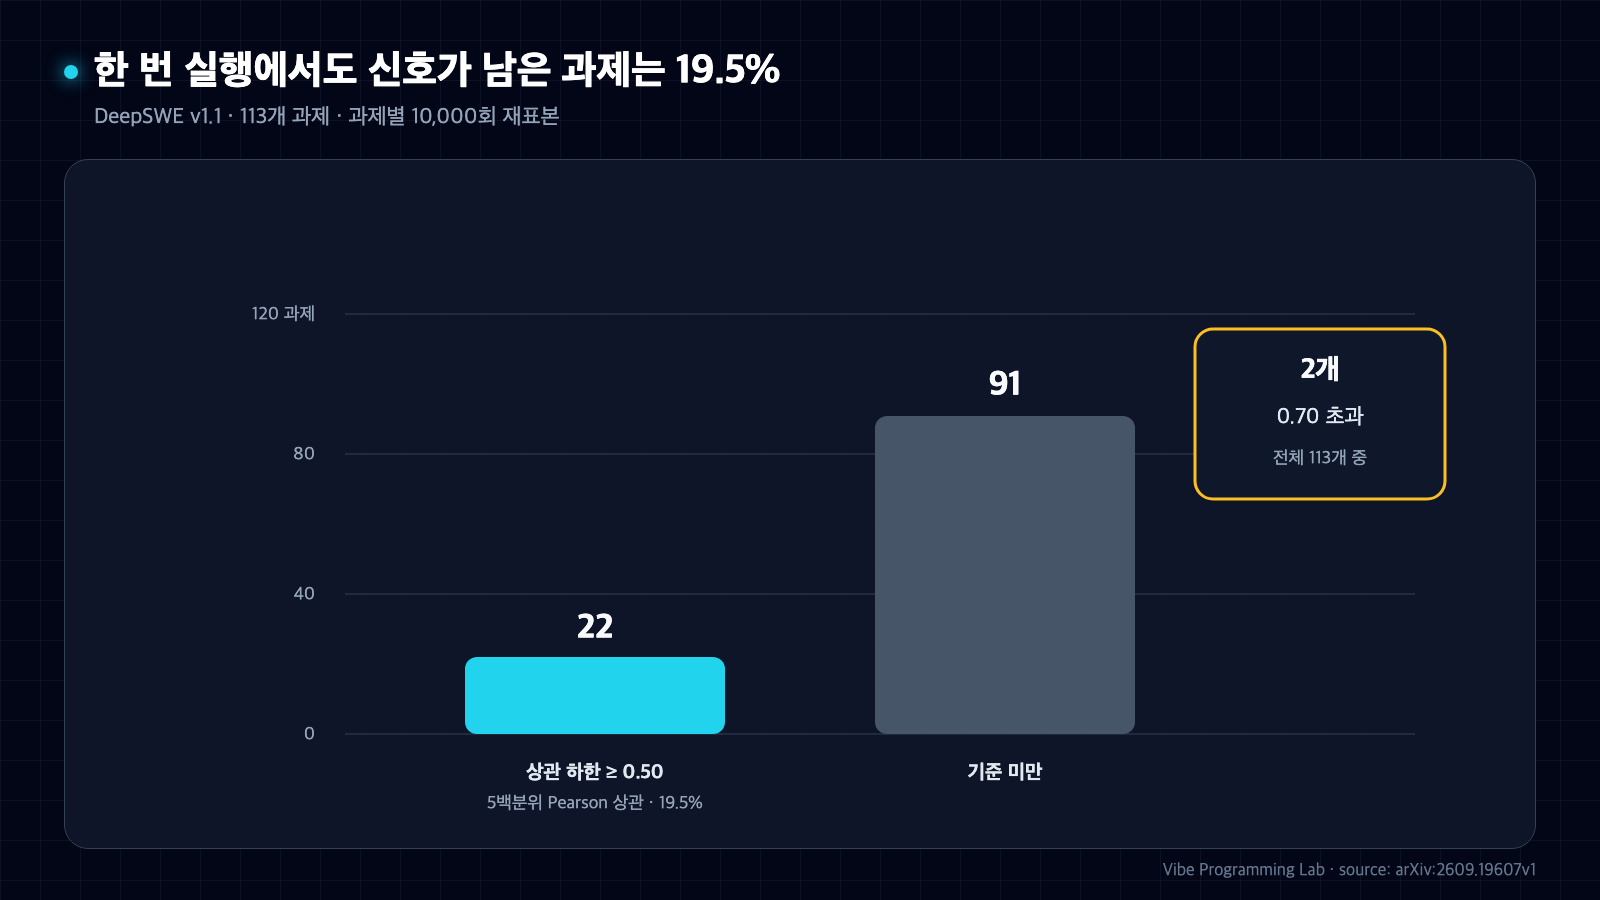
그림 1. 한 번 실행에서도 전체 점수 움직임을 비교적 안정적으로 따라간 과제는 113개 중 22개였다. 출처: arxiv.org/html/2609.19607v1.
이 문장을 "나머지 91개는 나쁜 과제"로 읽으면 안 됩니다. 전체 역량을 넓게 측정하는 벤치마크와 잦은 개발 결정을 위한 작은 A/B 집합은 목적이 다릅니다. 여기서 낮은 값은 해당 과제가 한 번 실행만으로 이번 개발 결정을 설명하기에는 약한 신호라는 뜻입니다.
선택, 점수, 예산, 현장 기준선을 분리했다
DeltaSelect는 네 단계를 섞지 않습니다. 먼저 한 번 실행에서도 신호가 남는 과제를 순위화합니다. 다음으로 과제별 fail-to-pass(F2P) 비율을 전체 점수 축으로 선형 보정합니다. 과제마다 테스트 개수와 난도가 다르므로 원시 F2P 0.5를 서로 같은 값으로 더하지 않기 위해서입니다.
그다음 예산 안에 들어오는 과제를 순위 순서대로 담습니다. 비싼 과제가 남은 예산을 넘으면 뒤의 더 싼 과제도 검사합니다. 마지막 단계가 특히 중요합니다. 공개 벤치마크의 비용과 점수를 그대로 믿지 않고, 실제 배포할 하네스에서 선택된 집합의 baseline을 다시 실행합니다.
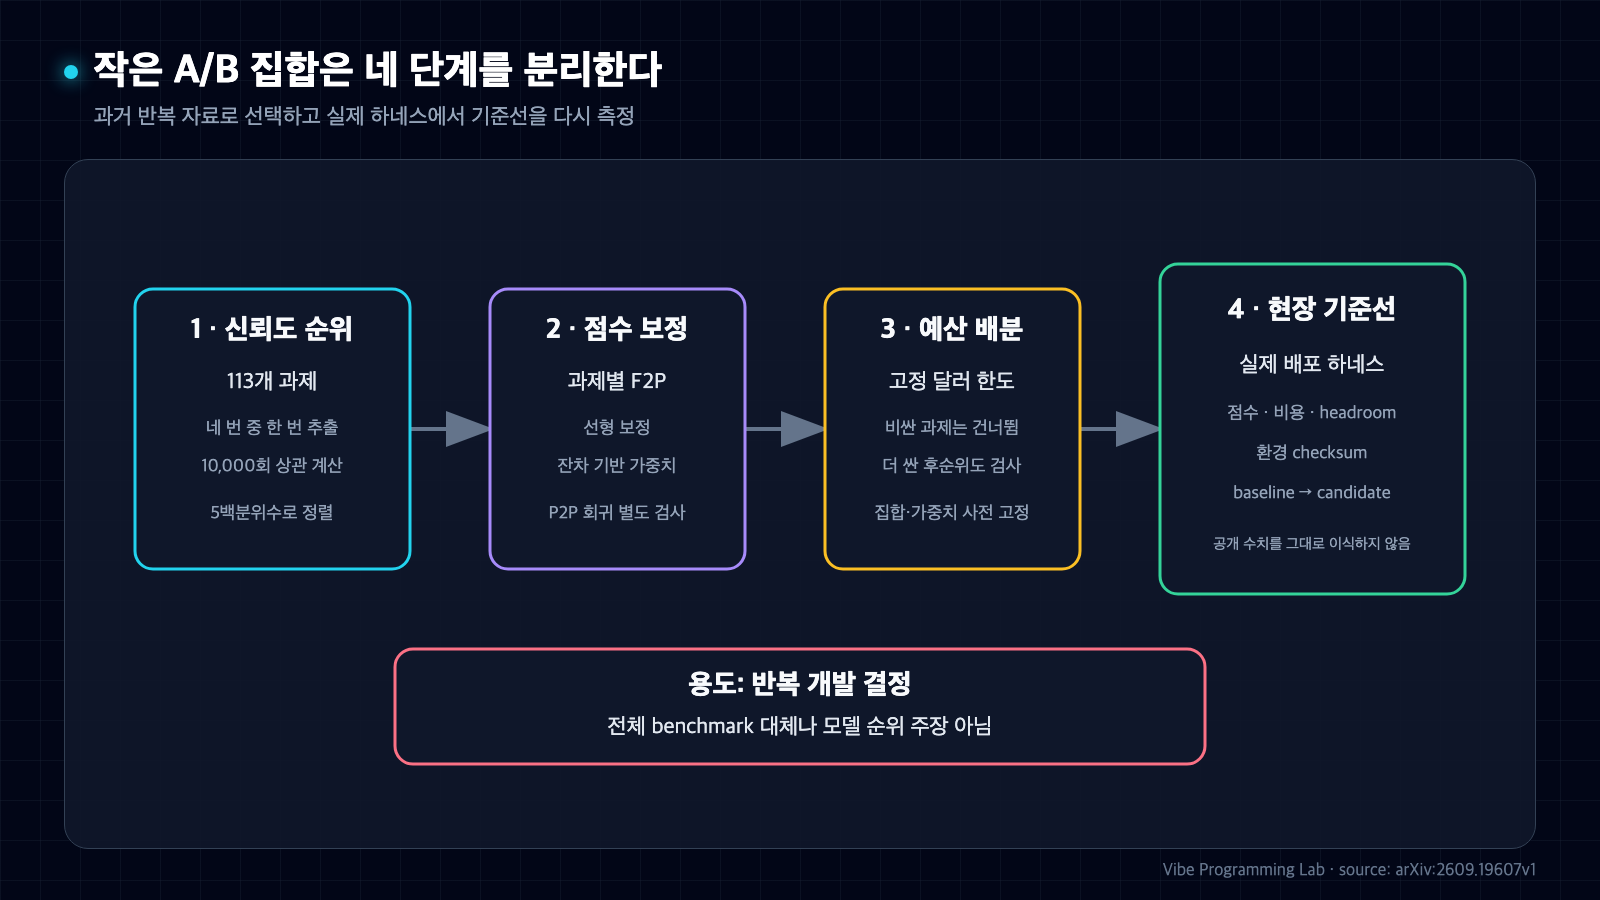
그림 2. 과제 선택과 점수 보정, 예산 배분을 분리하고 실제 하네스에서 baseline을 다시 측정한다. 출처: arxiv.org/html/2609.19607v1.
논문도 이 경계를 직접 확인했습니다. 같은 모델과 같은 여덟 과제를 사용해도 공개 mini-swe-agent 결과와 Codex 하네스 결과의 차이는 낮은 추론에서 21.0%포인트, 중간 추론에서 26.1%포인트였습니다. 비용도 공개 추정치보다 실제 Codex 실행에서 1.5배에서 3.5배 컸습니다. 공개 표의 과제별 비용은 후보 집합을 짜는 출발점일 뿐, 운영 예산표가 아니었습니다.
부분 점수를 쓰되 성공률로 과장하지 않았다
DeepSWE의 최종 pass/fail만 쓰면 부분 진전은 모두 0으로 사라집니다. DeltaSelect는 새로 통과해야 하는 테스트 중 실제로 통과한 비율인 F2P를 사용했습니다. 같은 10,000회 재표본 절차에서 F2P는 상관 하한 0.50 이상인 과제를 22개 찾았습니다. 모든 verifier 테스트를 한데 합친 값은 15개, 이진 pass/fail은 11개, 기존 통과 테스트 보존 비율인 P2P만 쓴 경우는 0개였습니다.
하지만 F2P를 "요구사항의 몇 퍼센트를 완성했다"고 해석하지 않습니다. 테스트는 서로 겹칠 수 있고 난도가 다르며, 하나의 테스트가 여러 assertion을 담기도 합니다. 논문은 P2P를 회귀 검사로 따로 남겼습니다. 부분 점수는 한 번 실행에서 정보를 더 보존하기 위한 측정값이지, 제품 완성률이 아닙니다.
여덟 과제로 스킬을 고친 사례에서 비용은 줄었다
저자는 0.65달러의 공개 기준 예산으로 여덟 과제를 고른 뒤 Agent Layer의 스킬과 지시문을 13번 평가했습니다. 기록된 모델 비용 합계는 27.86달러였습니다. 초기 설정은 보정 점수 36.46%, 비용 4.18달러, F2P 251/411이었습니다. 채택한 설정은 42.36%, 1.75달러, 265/411이었습니다. 모델 호출도 55회에서 37회로 줄었습니다.
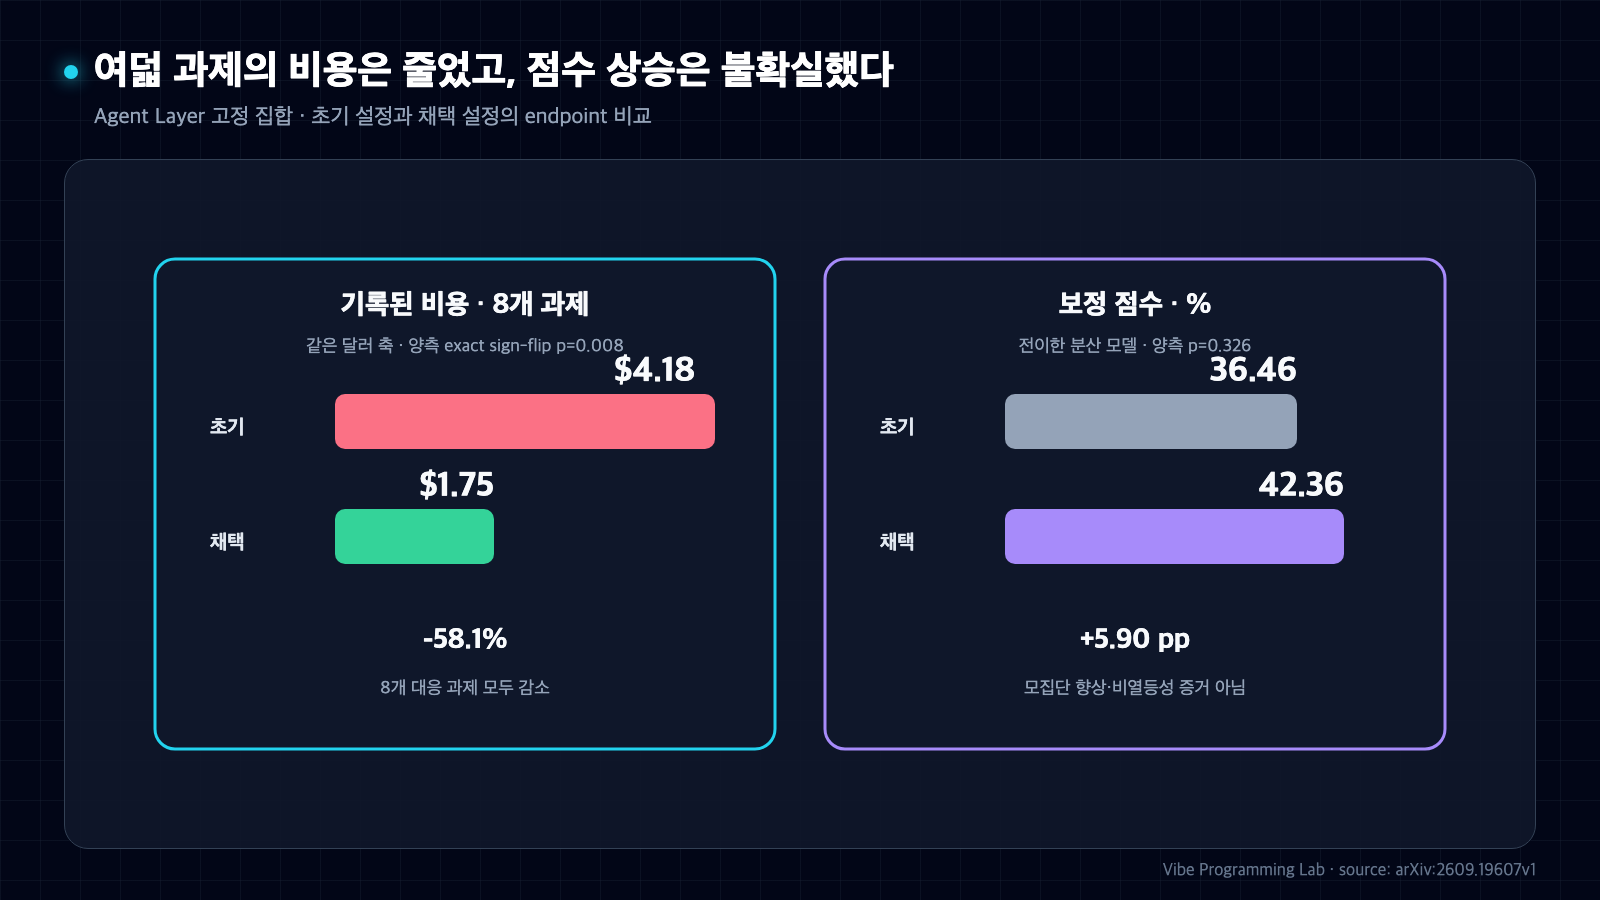
그림 3. 비용 절감은 여덟 과제에서 같은 방향이었지만 점수 상승은 통계적으로 불확실했다. 출처: arxiv.org/html/2609.19607v1.
비용은 여덟 과제 모두에서 낮아졌고, 양측 exact paired sign-flip test의 p값은 0.008이었습니다. 58.1% 절감은 이 고정 집합에서 관찰된 분명한 결과입니다. 반면 점수는 5.90%포인트 올랐지만 p값이 0.326이었습니다. 연구자는 이를 모집단 성능 향상이나 비열등성 증거로 쓰지 않았습니다. 각 endpoint가 과제당 한 번 실행뿐이라 분산을 Codex 자체에서 추정하지 못했고, 가장 가까운 공개 설정의 분산을 옮겨 썼기 때문입니다.
이 차이가 이 연구의 좋은 점입니다. 점수와 비용이 함께 좋아 보인다는 이유로 둘을 같은 강도의 주장으로 묶지 않습니다. 비용 절감은 대응된 여덟 과제 전부에서 같은 방향이었고, 점수 상승은 유리한 관찰이지만 불확실했습니다.
작은 고정 집합은 개발 계기판이지 순위표가 아니다
작은 과제 집합은 빠르지만 좁습니다. 상관 기반 선택은 드문 역량을 빠뜨릴 수 있고, 같은 과제를 반복해서 고치면 저장소나 grader 패턴에 과적합할 수 있습니다. 선형 보정도 F2P와 전체 점수의 관계가 실제로 선형이라는 보장은 없습니다. 서로 비슷한 과제의 의존성은 현재 가중치와 불확실성 계산에 충분히 반영되지 않았습니다.
선택 방식 자체도 아직 우승자가 아닙니다. 논문은 같은 비용에서 무작위, 최저가 우선, 중앙 상관 순위와 직접 비교하지 않았습니다. 과제 순위와 보정에 같은 DeepSWE 스냅샷을 사용했으므로 공개 데이터 분석은 in-sample이며 낙관적일 수 있습니다. 저자 저장소는 DeltaSelect 도구와 고정 데이터, export 형식을 공개하지만, 그것이 다른 모델과 하네스에서도 같은 과제 집합이 최선이라는 뜻은 아닙니다.
실무에서는 작은 집합과 전체 평가의 역할을 나누는 편이 맞습니다. 개발 중에는 task ID, 환경 checksum, 고정 가중치, baseline, 비용, headroom을 잠그고 같은 집합으로 자주 비교합니다. 놀라운 결과가 나오면 동일 설정을 한 번 더 실행해 진단합니다. 릴리스 전에는 더 넓은 회귀 집합과 실제 배포 환경에서 다시 확인합니다. 작은 A/B 집합이 전체 benchmark를 대체하는 것이 아니라, 전체 평가 사이의 개발 결정을 기록 가능한 측정으로 바꾸는 셈입니다.
오늘 글과 겹치지 않는 지점
오늘 아침 글은 uv가 glibc 하한을 lock 단계에 넣어 호환 wheel 버전으로 backtracking하는 문제를 다뤘습니다. 별도 큐 글은 에이전트 로그에서 규칙 기반 신호로 읽을 기록의 우선순위를 정했습니다. 이번 글은 코딩 변경의 효과를 낮은 비용으로 비교할 과제 집합을 고정하고, 공개 벤치마크와 실제 하네스의 측정 차이를 다시 기준선으로 잡는 방법을 다룹니다.
결론도 다릅니다. DeltaSelect의 핵심은 "여덟 문제면 충분하다"가 아닙니다. 한 번 실행에서도 신호가 남는 과제를 과거 반복 자료로 골라 두고, 실제 하네스에서 baseline을 다시 잰 뒤, 결과를 그 고정 집합의 개발 판단으로만 제한하는 것입니다.


댓글
댓글 쓰기