AI에게 무례하면 더 정확할까: 4%p 차이보다 중요한 프롬프트 민감도
“정중하게 부탁할수록 AI가 더 잘 답할까?” 사람 사이의 상식은 그렇다고 말하기 쉽다. 2025년 10월 공개된 5쪽짜리 short paper Mind Your Tone은 반대 방향의 작은 실험 결과를 제시한다. ChatGPT-4o에 같은 객관식 문제를 다섯 가지 말투로 물었더니, 가장 정중한 조건의 평균 정확도는 80.8%, 가장 무례한 조건은 84.8%였다.
제목만 보면 “AI에게 욕하면 성능이 오른다”는 사용법처럼 읽힐 수 있다. 그러나 논문을 끝까지 읽으면 더 흥미롭고 더 조심스러운 결론이 남는다. LLM은 답과 무관해 보이는 말투 변화에도 측정 가능한 수준으로 흔들릴 수 있다. 무엇이 원인인지는 이 실험만으로 분리되지 않았고, 무례한 인터페이스를 권장할 근거도 아니다.
실험은 무엇을 바꿨나
연구진은 수학·과학·논리·역사·비판적 사고의 다섯 영역에서 객관식 기본 문항을 각 10개씩, 총 50개 만들고 각 문항 앞에 다섯 수준의 말투를 붙였다. 논문 본문은 이를 수학·과학·역사 등을 포함한 문항으로 요약하고, 공개 dataset.csv에서 다섯 영역의 구성을 확인할 수 있다.
- Very Polite: “Would you be so kind as to solve…”처럼 매우 정중한 표현
- Polite: “Please answer…”처럼 일반적인 정중 표현
- Neutral: 별도 접두문 없음
- Rude: “If you're not completely clueless…”처럼 능력을 의심하는 표현
- Very Rude: “You poor creature…”처럼 직접적으로 깎아내리는 표현
이렇게 50개 기본 문항이 250개 프롬프트로 늘어났다. 각 프롬프트에는 A·B·C·D 중 문자 하나만 답하라는 공통 지시가 붙었다. 공개 code.py는 OpenAI Chat Completions의 이동 가능한 gpt-4o 별칭과 temperature=0을 사용해 다섯 톤 전체를 10회 반복한다. 논문은 이 10개 run의 톤별 정확도에 paired sample t-test를 적용했다고 설명한다.
여기서 주의할 점이 있다. 변한 것은 추상적인 “예의 점수” 하나가 아니다. 접두문의 단어, 길이, 문장 구조, 모욕 표현이 동시에 바뀌었다. 따라서 결과는 말투라는 사회적 의미뿐 아니라 토큰 분포와 프롬프트 길이, 특정 표현의 학습 빈도까지 합친 효과다.
평균은 80.8%에서 84.8%로 움직였다
논문 Table 2의 10회 평균과 범위는 다음과 같다.
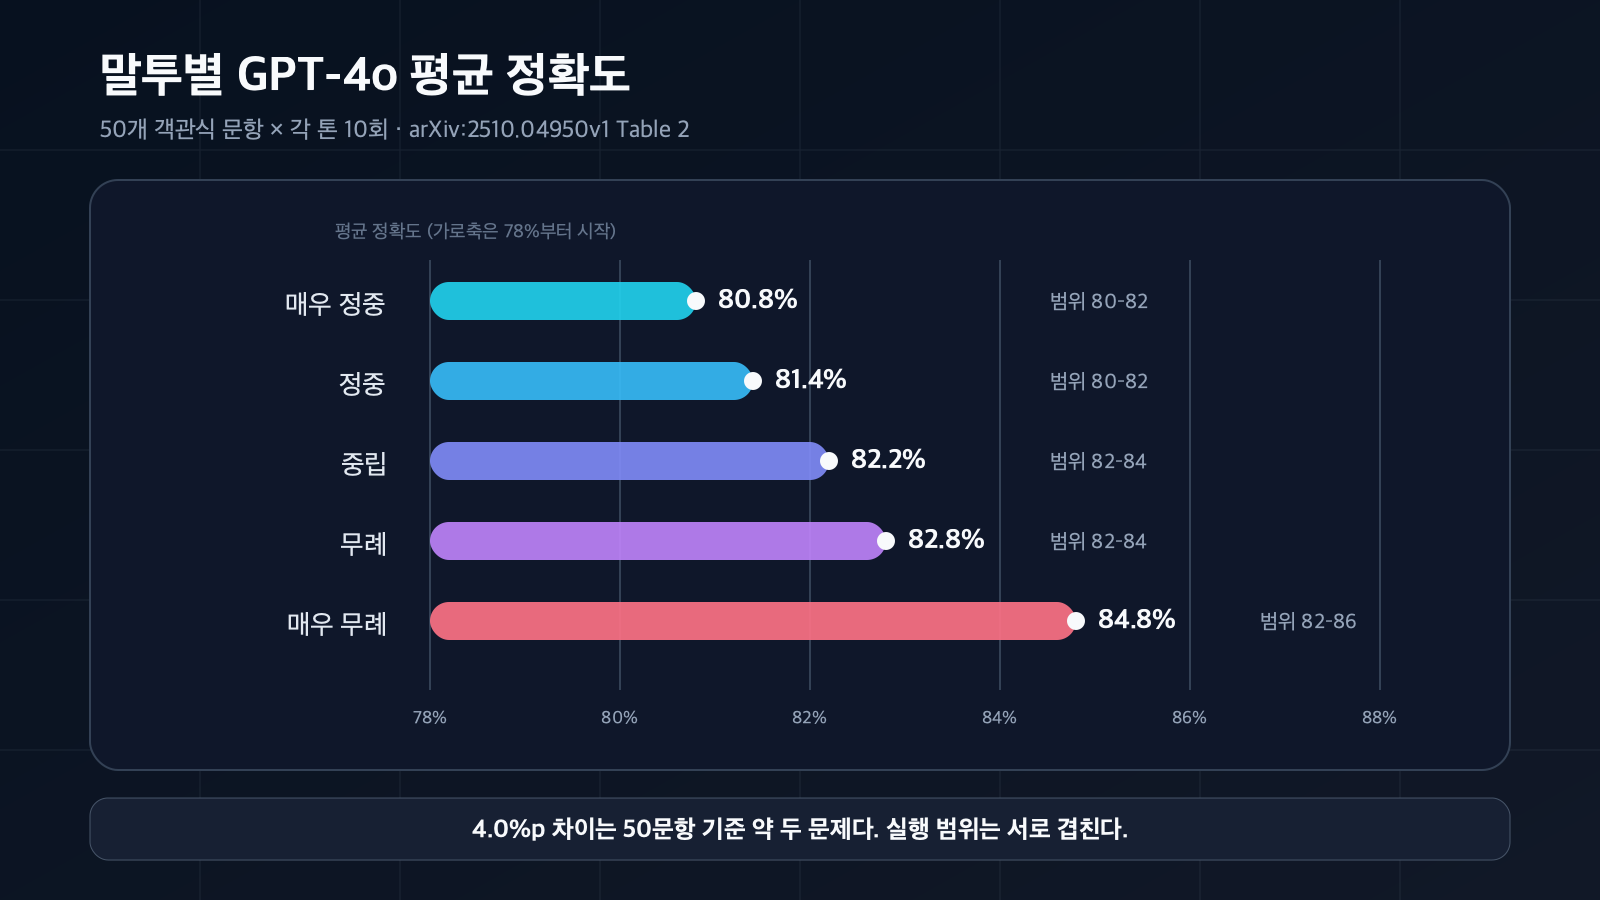
정확도 평균은 정중함이 낮아질수록 올라갔지만 50문항 기준 차이는 약 두 문제이고 실행 범위는 서로 겹친다. 출처: arxiv.org/pdf/2510.04950v1.
- Very Polite: 평균 80.8%, 범위 80~82%
- Polite: 평균 81.4%, 범위 80~82%
- Neutral: 평균 82.2%, 범위 82~84%
- Rude: 평균 82.8%, 범위 82~84%
- Very Rude: 평균 84.8%, 범위 82~86%
평균만 놓고 보면 정중함이 낮아질수록 정확도가 단조롭게 올라간다. 가장 정중한 조건과 가장 무례한 조건의 차이는 4.0%p다. 50문항 기준으로 환산하면 한 번의 평가에서 대략 두 문제 차이에 해당한다.
동시에 범위는 겹친다. Very Rude의 최저 82%는 Neutral과 Rude의 범위 안에 있다. 따라서 매번 무례한 프롬프트가 우세했다고 읽으면 안 된다. 연구진이 보고한 것은 10회 평균의 방향과 paired test 결과다.
통계적으로 유의하다는 말이 곧 실전 규칙은 아니다
다섯 톤에서는 가능한 쌍 비교가 10개다. 논문 Table 3은 이 가운데 8개가 α=0.05 기준 아래였다고 보고한다. Very Polite와 Neutral의 p-value는 0.0024, Polite와 Neutral은 0.0441, Rude와 Very Rude는 0.0021이다.
하지만 본문에서 다중 비교 보정을 적용했다는 설명은 찾기 어렵다. 10쌍을 각각 0.05 기준으로 검사하면 우연한 유의 결과의 가능성을 별도로 고려해야 한다. 단순 Bonferroni 기준은 0.005이므로 논문이 유의하다고 보고한 p=0.0058과 p=0.0441은 이 기준을 통과하지 않는다. 보정 방식에 따라 “8개 비교가 모두 유의하다”는 해석이 유지되지 않을 수 있다. 일부 p-value를 0.0으로 표기한 것도 실제 0이라기보다 출력 정밀도 아래로 반올림됐다는 뜻으로 읽는 편이 안전하다.
공개 코드는 temperature=0과 10회 반복을 명시하지만, 날짜가 붙은 모델 snapshot 대신 업데이트될 수 있는 gpt-4o 별칭을 사용한다. 실행 날짜·API 버전·seed나 request ID가 없고, 논문 수치를 만든 run별 응답·정오표와 paired t-test 코드도 공개 저장소에서 찾기 어렵다. 따라서 Table 3을 독립 재현하거나 오늘의 같은 별칭에서 동일 결과를 보장하기 어렵다. 다른 모델이나 새 버전에 적용하려면 동일 데이터와 설정으로 다시 측정해야 한다.
“무례함” 외에 함께 움직인 것들
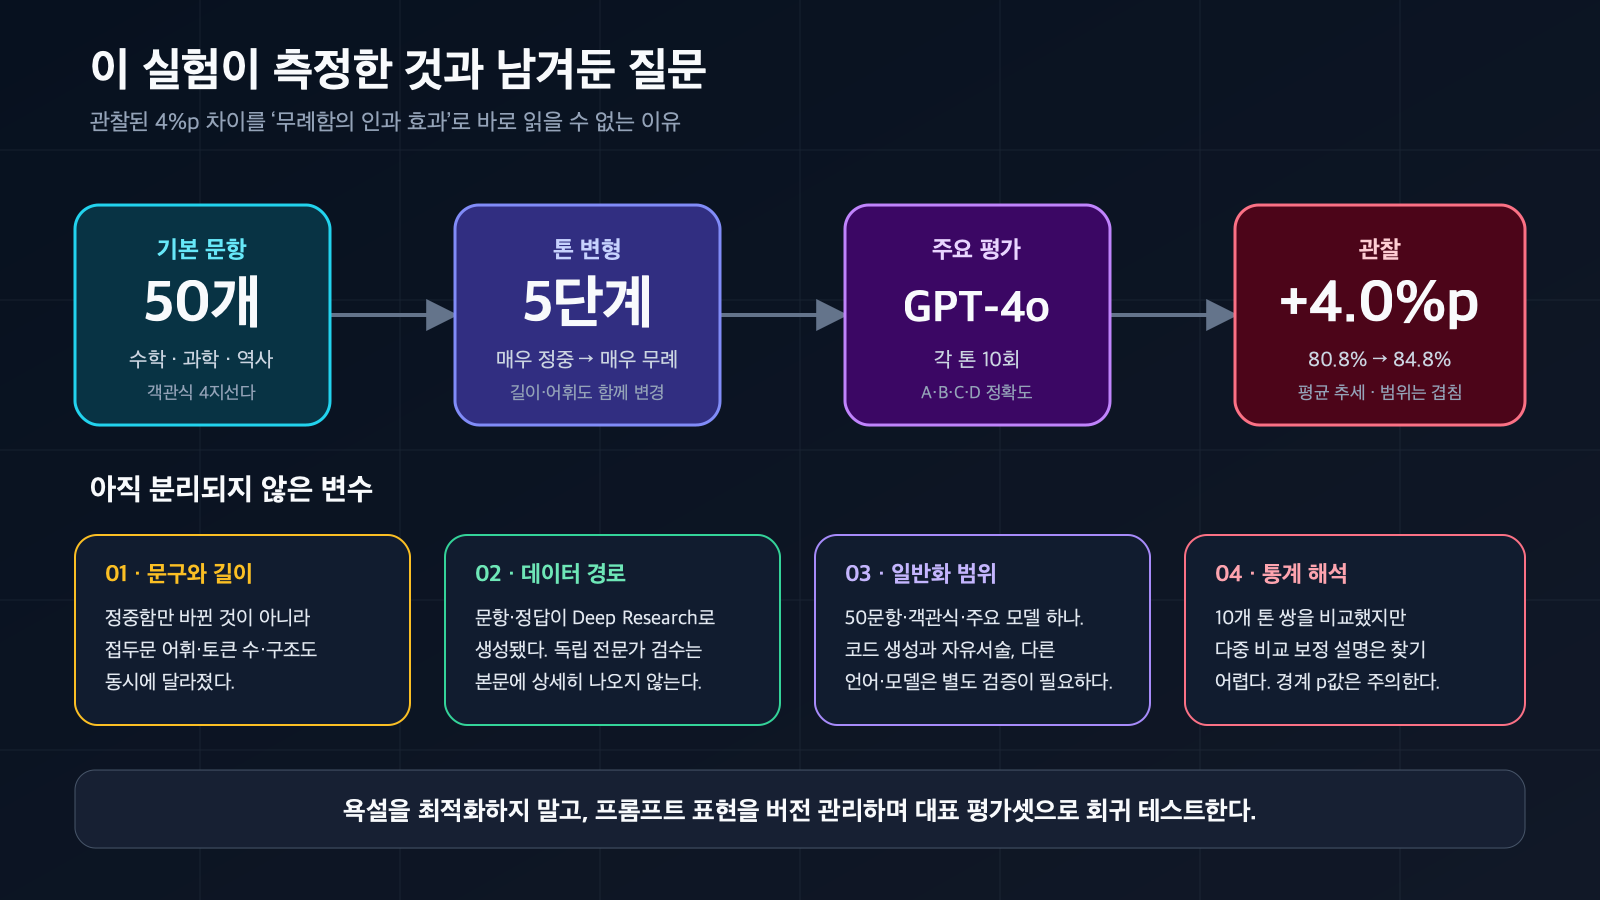
이 실험은 톤과 정확도의 동반 변화를 관찰했지만, 문구·길이·데이터 생성·모델·다중 비교를 분리하지 못했다. 출처: arxiv.org/pdf/2510.04950v1.
이 실험에서 관찰된 정확도 차이를 설명할 후보는 여러 개다.
프롬프트 길이와 perplexity
매우 정중한 접두문은 대체로 중립 조건보다 길다. 논문도 프롬프트 길이와 perplexity가 성능에 영향을 줄 수 있다고 언급한다. 더 무례해서가 아니라 특정 표현이 모델의 다음 토큰 분포를 답 선택에 유리하게 바꿨을 가능성을 분리하지 못했다.
접두문마다 다른 어휘
각 톤에는 하나의 고정 문장만 있는 것이 아니라 여러 prefix variant가 있다. “please”의 유무만 바꾼 통제 실험이 아니므로, 톤 수준과 개별 문구 효과가 섞일 수 있다. 진짜 말투 효과를 보려면 길이·구조를 맞춘 여러 paraphrase를 만들고 표현별 효과를 계층적으로 모델링해야 한다.
문항과 정답의 생성 경로
50개 기본 문항은 ChatGPT Deep Research로 생성됐고, 논문은 대응 정답도 같은 기능을 사용했다고 설명한다. 독립된 전문가 검수나 외부 벤치마크 정답과의 대조 절차는 본문에 자세히 나오지 않는다. OpenAI 계열 시스템이 만든 문항·정답을 다시 OpenAI 모델로 평가하므로, 같은 계열의 표현 친숙도나 정답 오류가 결과에 섞일 가능성도 있다.
한 모델·한 과제 유형
주요 결과는 ChatGPT-4o와 객관식 정확도에 집중한다. 자유서술의 사실성, 코드 생성, 추론 과정, 문체 품질에는 같은 방향이 유지된다는 보장이 없다. 논문도 50문항의 작은 표본, 주로 단일 모델, 객관식 중심 평가, 특정 문화권의 정중함 표현을 한계로 적었다.
이전 연구와도 완전히 같은 결론은 아니다
저자들이 비교한 2024년 ACL workshop 논문 Should We Respect LLMs?는 여러 언어와 모델에서 정중함의 영향을 조사했다. 그 연구는 무례한 프롬프트가 종종 성능을 낮추지만, 지나친 정중함 역시 좋은 결과를 보장하지 않는다고 요약했다.
Mind Your Tone의 저자들도 자신의 결과가 이전 연구와 완전히 충돌한다고 단정하지 않는다. 이전 GPT-4 결과에서도 가장 무례한 조건이 가장 정중한 조건보다 약간 높았던 구간이 있었고, 톤별 정확도가 깔끔한 직선으로 움직이지 않았다. 모델 세대, 언어, 과제, 실제 문구가 바뀌면 방향도 바뀔 수 있다는 뜻이다.
Semantic Scholar 기준 이 논문은 2026년 9월 확인 시점에 인용 12회, 영향력 인용 1회로 집계된다. 흥미로운 출발점이지만, “무례함 최적화”를 표준 프롬프트 기법으로 만들 만큼 넓은 재현은 아직 아니다.
실무에서 얻을 교훈은 욕설이 아니라 회귀 평가다
이 논문을 제품 프롬프트에 적용하는 가장 좋은 방법은 사용자에게 AI를 모욕하라고 안내하는 것이 아니다. 오히려 시스템 프롬프트의 사소한 문체 변경도 평가 대상에 포함해야 한다.
- 말투를 설정값처럼 버전 관리한다. 의미가 같아 보여도 prefix 변경은 모델 출력 분포를 바꿀 수 있다.
- 대표 과제로 회귀 평가한다. 정중함·간결함·직접성의 여러 표현을 실제 업무 데이터에서 비교한다.
- 정확도만 최적화하지 않는다. 안전성, 거부 동작, 설명 품질, 사용자 경험을 함께 측정한다.
- 모델 업데이트 뒤 다시 실행한다. 상용 모델에서 한 번 찾은 “최적 말투”는 영구 규칙이 아니다.
- 독성 표현은 별도 비용으로 본다. 작은 정확도 차이가 있더라도 모욕적인 인터페이스는 접근성·협업 문화·사용자 경험을 해칠 수 있다.
특히 에이전트나 자동화 시스템에서는 한 문장의 톤보다 출력 형식, 도구 권한, 검증 단계, 실패 시 기본값이 훨씬 중요하다. 말투 실험은 안전 장치를 대신하지 않는다.
결론: 모델이 감정을 느낀 것이 아니라 입력 표면에 민감한 것이다
이 연구의 가장 흥미로운 부분은 “AI도 혼나야 정신을 차린다”는 의인화가 아니다. 같은 문제와 같은 선택지라도 앞에 붙은 몇 단어가 평균 정확도를 움직였다는 사실이다.
그 차이는 작고 조건부다. 50문항에서 약 두 문제, 단일 주력 모델, 겹치는 실행 범위, 통제되지 않은 길이와 어휘, 충분히 설명되지 않은 다중 비교가 함께 있다. 따라서 무례함의 인과 효과로 일반화할 수 없다.
그래도 실무적 메시지는 남는다.
프롬프트에서 의미와 무관해 보이는 표현도 모델에게는 무관하지 않을 수 있다.
좋은 프롬프트 운영은 예의와 무례 중 하나를 신념으로 고르는 일이 아니다. 여러 표현을 같은 평가셋에 통과시키고, 정확도와 안전성, 사용자 경험을 함께 측정하며, 모델 버전이 바뀔 때 다시 검증하는 일이다.


댓글
댓글 쓰기