AI 에이전트는 낯선 규칙을 어떻게 찾나: ExplorationBench 점수 읽는 법
새 도구의 설명서가 일부 틀렸다면 에이전트는 무엇을 먼저 시험해야 할까요? 익숙한 문제의 답을 더 많이 외우는 것과, 관찰로 규칙을 찾아 새 문제에 적용하는 것은 다른 능력입니다. ExplorationBench 논문은 일부러 바뀐 규칙을 가진 실행 가능한 두 세계에서 이 차이를 측정합니다. 2026년 9월 공개된 arXiv v1 프리프린트의 저자 보고 결과를 해설하며, 동료 심사나 독립 재현이 확인된 결과로 소개하지 않습니다.
실무 독자의 질문은 ‘우리 에이전트의 최고 점수가 높으니 낯선 환경에서도 꾸준히 유용한 실험을 설계한다고 말해도 될까?’입니다. 답하려면 실험을 고르는 능력, 실행 결과를 받아들이는 효과, 한 번 운 좋게 성공한 실행, 배운 규칙의 실제 적용을 분리해야 합니다. 이 글의 판단표는 그 구분을 보고서에 옮기기 위한 편집상 도구이지 새 모델 평가 결과가 아닙니다.
틀린 설명서와 숨긴 과제: 무엇을 재는가
논문 §3의 구성에는 틀린 부분이 있는 공개 설명서, 공통 예시, 질문을 보내면 정확한 결과를 돌려주는 샌드박스, 탐색 도중 보지 못하는 평가 과제가 있습니다. 에이전트는 질문을 골라 실행하고 피드백을 받은 뒤 다음 질문을 고릅니다. 매 시점 숨긴 과제에 답할 때는 탐색 중인 본체가 아니라 도구를 끈 복사본을 평가하므로, 시험 문제를 도구에 다시 물어 점수를 올릴 수 없습니다. 매 과제의 답변을 세 번 평가하고 그 평균을 사용합니다.
두 세계는 같은 과제 집합을 다른 이름으로 센 것이 아닙니다. AlienCode는 31개 규칙 발견 목표와 70개 숨긴 과제가 있고, 바뀐 프로그래밍 언어의 동작을 해석기로 채점합니다. 프로그램 합성 과제 69개는 비공개 합법 입력 모두를 통과해야 하며 한 과제는 정확한 출력 예측을 요구합니다. AlienLogic은 24개 발견 목표와 별도의 70개 숨긴 과제로, 형식 증명 검사와 선언된 범위 안의 증명 불가능성·거절 조건으로 평가합니다(§3, Appendix A). 둘을 단일한 ‘140개 동일 유형 질문’의 점수로 뭉쳐 비교하지 않습니다.
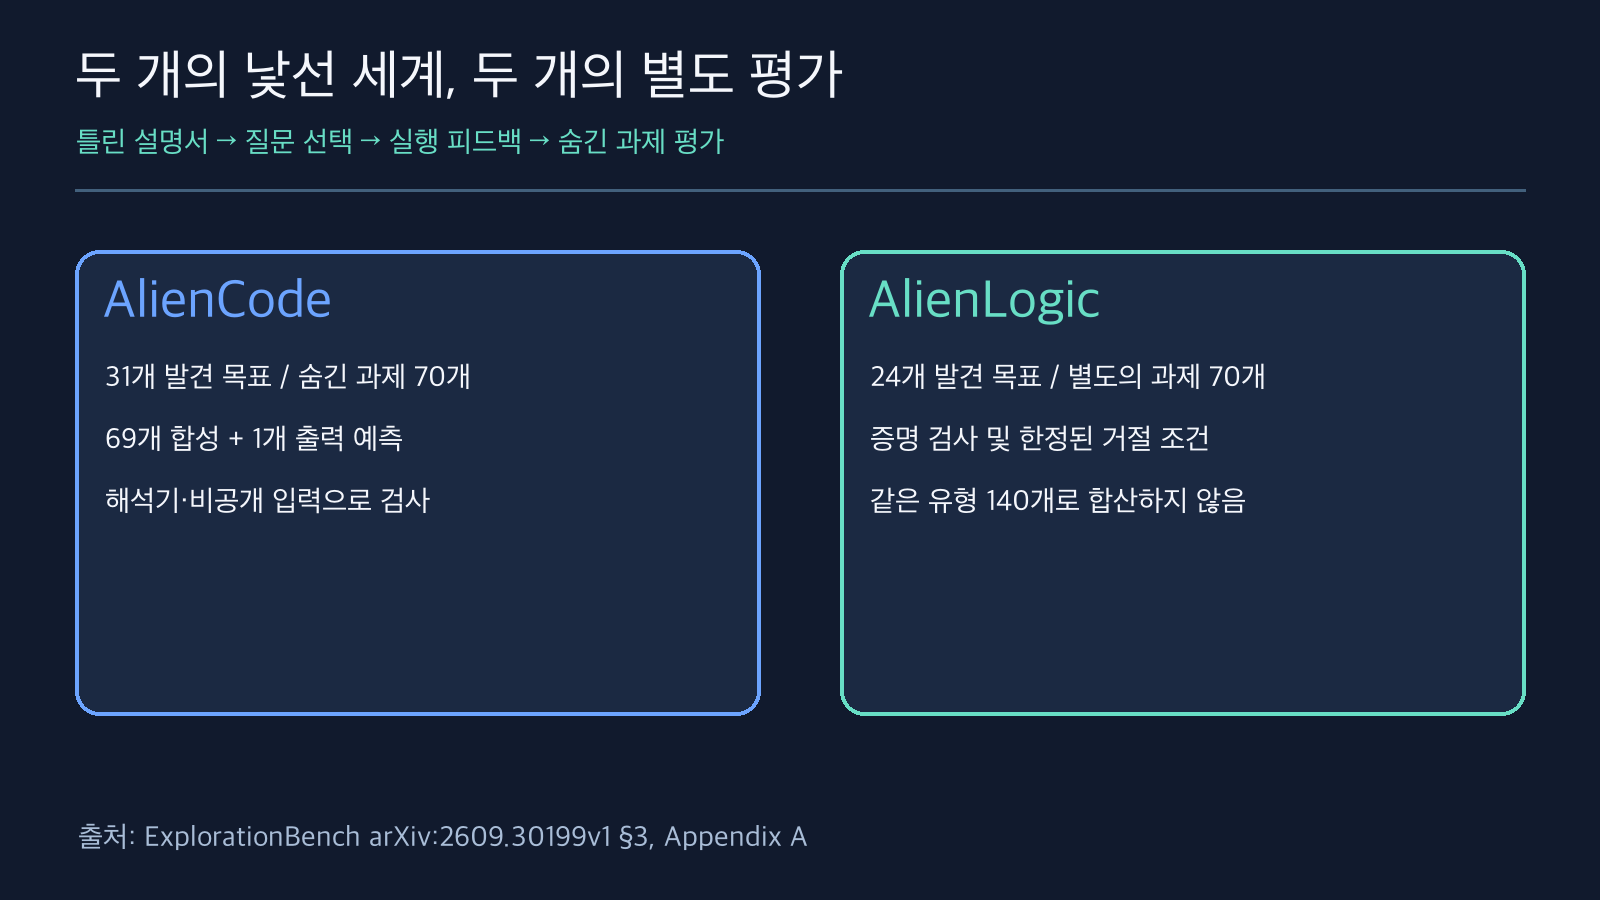
두 실행 세계의 평가 단위는 각각 별도다. 원문 §3·Appendix A에 근거한 자체 비교 도식이며 실제 실행 화면이 아니다. 출처: arxiv.org/html/2609.30199v1.
각 시스템은 세계별로 네 번의 탐색 라운드를 거치며 세 개의 독립적인 자율 경로를 수행합니다. 논문의 Best@3는 세 경로의 마지막 평균 정확도가 가장 높은 경로 하나를 선택합니다. 각 과제마다 세 경로 중 정답을 골라 합치는 pass@3도 아니고, 한 번 실행할 때 기대할 점수도 아닙니다. 비교 통제는 대체로 시스템당 한 경로만 수행합니다(§3.3, §5.1, Appendix A). 실험 횟수의 비대칭성을 밝히지 않으면 스스로 탐침을 고르는 이점을 과장하기 쉽습니다.
높은 최고점 뒤의 세 경로를 함께 보기
AlienCode의 Claude Opus 5 행은 선택된 Best@3 경로에서 탐색 전 M0 3.8%, 네 라운드 뒤 M4 87.6%입니다. 그러나 같은 시스템의 세 경로 최종 평균은 72.5%, 최저 경로는 49.0%입니다(§4 Table 1). 87.6%는 논문의 조건에서 선택한 최고 경로 결과이지 무작위로 한 번 가동할 때의 안정적인 성공률이 아닙니다. 이 수치가 실제 제품에서 과학적 발견을 87.6% 성공한다는 뜻도 아닙니다.
경로 간 편차는 다른 행에서도 큽니다. Kimi K3의 AlienCode 최종 경로는 4.8%부터 77.6%까지 벌어집니다(§4 Figure 9). 같은 경로에서 질문당 세 번 답한 변동과, 처음부터 다른 질문을 골라 진행한 경로 사이의 변동은 별개입니다. 논문은 경로 간 폭이 최대 72.8퍼센트포인트이고 세 답변으로 측정한 표준편차는 최대 4.7퍼센트포인트라고 설명합니다. 보고서에 최고점만 남기면 탐색 정책 선택이 좌우하는 불확실성을 지워 버립니다.
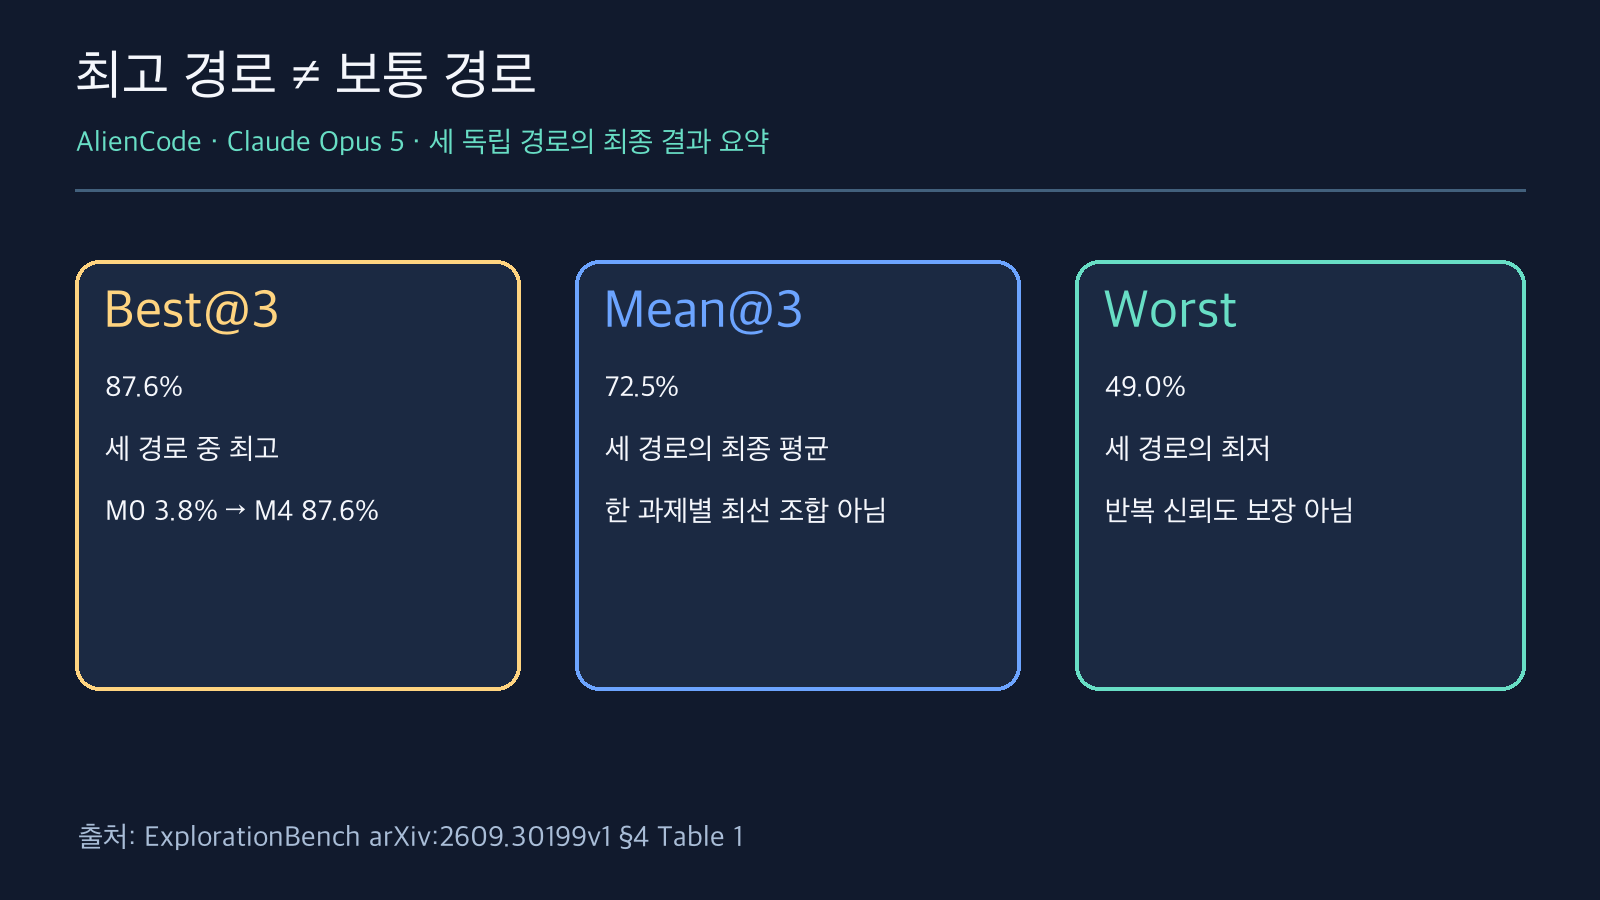
원문 §4 Table 1의 Claude Opus 5 행. 세 경로의 최고·평균·최저이며 한 번 실행의 기대 점수가 아니다. 출처: arxiv.org/html/2609.30199v1#S4.T1.
피드백인가, 질문 선택인가: 통제 실험을 읽는 순서
논문은 자율 탐색 외에 각 시스템에서 선택된 경로의 질문을 다시 재생하는 hindsight 통제와 시스템 독립적인 고정 질문을 내는 fixed 통제를 둡니다. 전자는 같은 질문 목록을 따르되 새 실행의 피드백을 다시 받아 처리하므로, ‘아무 피드백도 주지 않은 재생’으로 설명하면 틀립니다. 후자는 모델이 유리한 질문을 설계하지 못하는 기준선입니다. 자세한 통제 정의는 §4.2 Figure 4와 Appendix A.4에 있습니다.
AlienCode에서 열 시스템의 각 조건별 중앙값은 자율 Best@3 66.0%, hindsight 40.7%, fixed 5.7%입니다. 자율과 hindsight를 시스템별로 짝지어 뺀 차이의 중앙값은 17.1퍼센트포인트이고 열 시스템 중 아홉에서 자율이 높습니다. 17.1은 66.0에서 40.7을 단순히 뺀 결과가 아닙니다. AlienLogic의 짝지은 중앙 차이는 0.5퍼센트포인트에 그쳐, 질문 선택의 이점이 두 세계에 동일하게 나타났다고 말할 수 없습니다. 자율은 세 경로에서 최고를 고르고 통제는 한 경로씩 실행하므로 이 비교만으로 동일 반복 조건의 신뢰도를 입증하지도 못합니다.
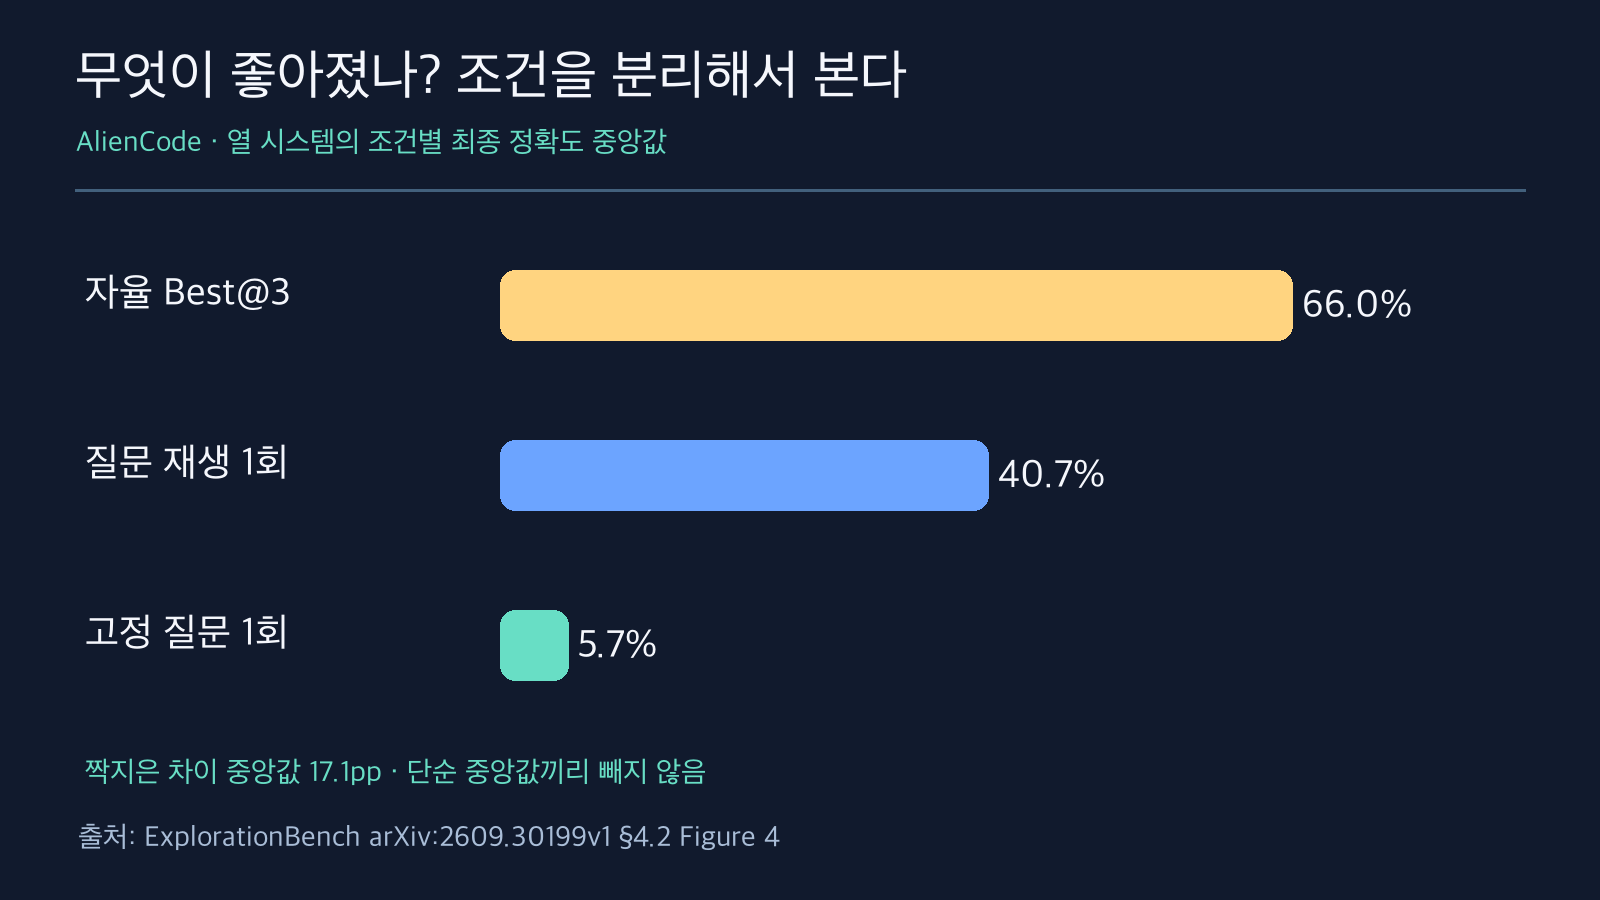
원문 §4.2 Figure 4의 조건별 중앙값을 0 기준 동일 눈금으로 자체 재작성. 17.1pp는 별도의 시스템별 짝지은 차이 중앙값이다. 출처: arxiv.org/html/2609.30199v1#S4.F4.
독자용 판단표: 보고서에서 세 주장 분리하기
아래는 논문 수치와 프로토콜을 실무 보고용으로 재구성한 편집 판단표입니다. 저자들이 제시한 공식 평가 표준이 아니며, 새 에이전트를 실제로 시험한 기록도 아닙니다.
| 확인할 질문 | 보고할 숫자와 비교 | 잘못된 결론을 피하는 방법 |
|---|---|---|
| 스스로 실험을 골라서 나아졌나? | 동일한 세계의 자율 탐색, 선택된 탐침 재생, 고정 탐침을 따로 제시 | 자율 Best@3와 1회 통제를 같은 반복 신뢰도로 취급하지 않는다 |
| 최고 기록이 보통 실행을 대표하나? | Best@3, 세 경로 평균, 최저 경로를 함께 적는다 | 과제별 최선 답을 합친 pass@3로 바꾸지 않는다 |
| 규칙을 말하면 해결도 하나? | 규칙 보고와 숨긴 과제의 정답률을 따로 확인 | 진단용 규칙 보고를 최종 점수로 오인하지 않는다 |
특히 마지막 줄이 중요합니다. AlienCode에서는 필요한 규칙을 전부 올바르게 진술한 647개 과제–경로 쌍에서도 해당 과제의 최종 정확도가 70.9%였습니다(§4 Figure 8). 647은 새로 발견한 독립 규칙 수나 전체 벤치마크 문항 수가 아닙니다. ‘규칙을 안다’는 진단과 ‘규칙으로 프로그램을 작성해 통과한다’는 행동은 따로 시험해야 합니다. 규칙 보고는 진단 정보이지 최종 과제 점수에 합산되지 않습니다.
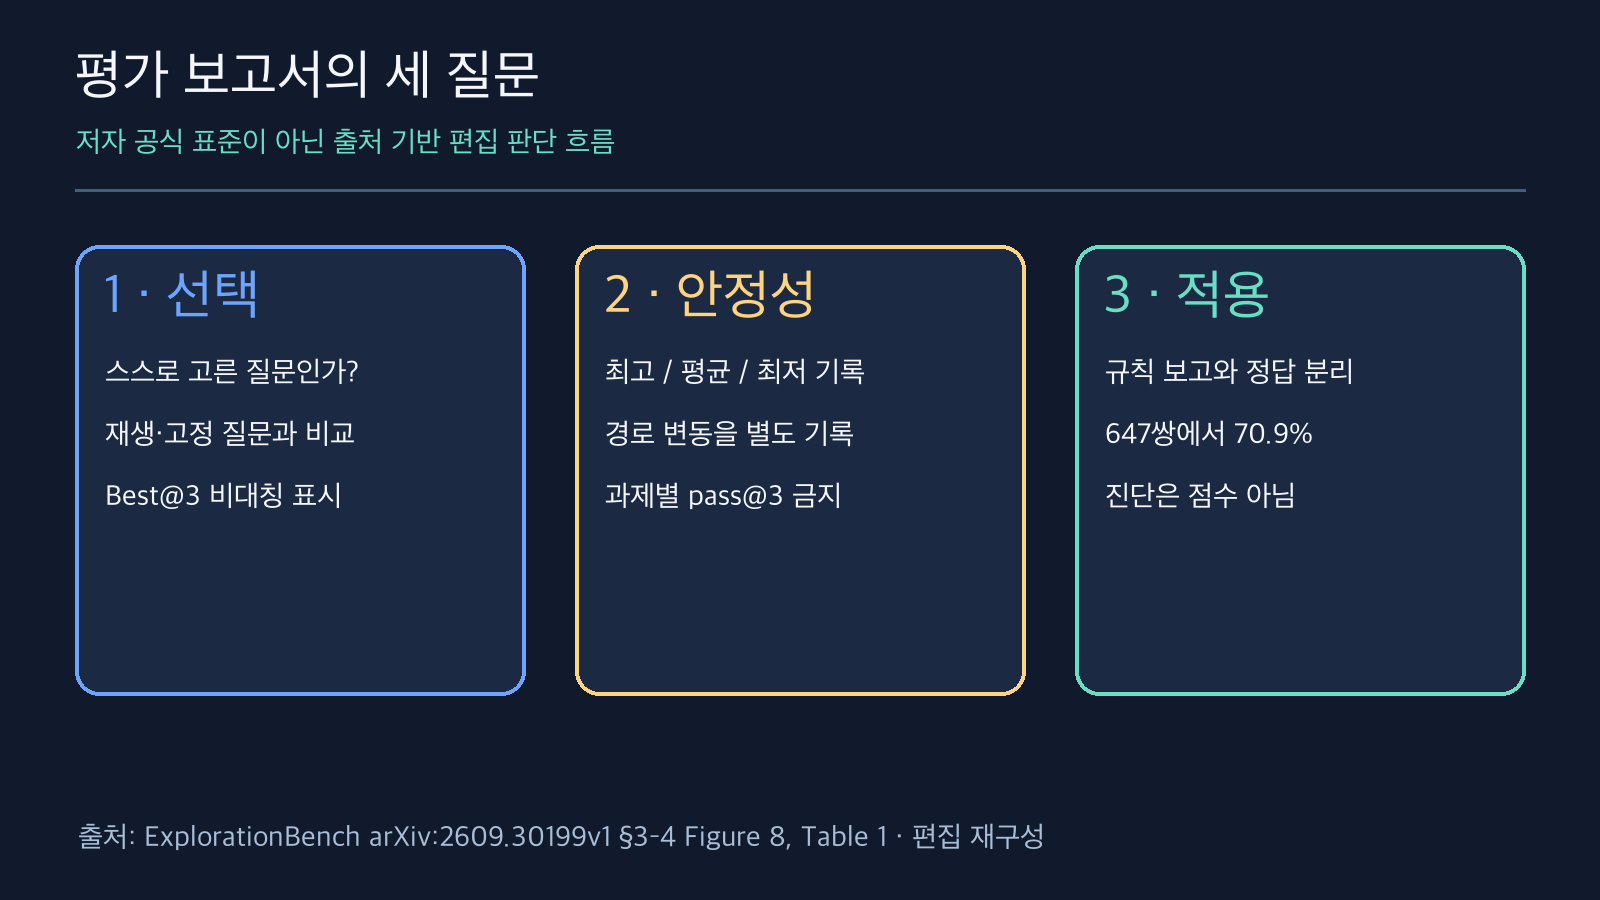
원문 §3–4를 독자용으로 편집 재구성. 저자의 공식 보고 표준이나 새로운 에이전트 실험 결과는 아니다. 출처: arxiv.org/html/2609.30199v1.
실제로 이 표를 사용한다면 먼저 세계와 평가 단위를 적고, 숨긴 과제 70개에 대해 질문당 세 답변을 평균했다는 점을 명시하세요. 다음으로 실험 조건마다 선택된 최고 경로인지, 세 경로 평균인지, 단일 통제 경로인지를 칸을 나눠 기록합니다. 마지막으로 규칙 진술과 과제 통과의 차이를 적습니다. 이 세 칸이 없는 ‘AI가 스스로 과학을 발견했다’는 제목보다 ‘제한된 합성 환경에서 선택한 실험과 피드백의 기여를 비교했다’는 설명이 검증 범위에 맞습니다.
어디까지 일반화할 수 있나
이 판단표는 결정적인 두 합성 세계와 제한된 탐색 예산을 해석하는 편집 도구이며, 실제 과학 연구나 다른 서비스 에이전트의 성능을 검증하지 않았습니다. 원문 §6 역시 현실의 관찰 잡음, 비싸거나 되돌릴 수 없는 실험, 열린 가설 공간, 훨씬 긴 탐색 기간을 다루지 않았다고 밝힙니다. 세 경로와 질문당 세 답변만으로 변동의 분포를 정밀 추정할 수도 없습니다. 시스템별 가장 높은 사용 가능 추론 설정과 탐색 토큰 사용량이 다르므로 순위를 같은 비용의 공정한 성능표로 읽어서도 안 됩니다.
이 글은 보존된 arXiv v1 본문의 §3–6, Table 1, Figure 4·8·9와 Appendix A를 검토한 출처 기반 해설입니다. 저자 코드를 실행하거나 숨긴 과제를 새로 평가하지 않았습니다. 조사한 본문·프로젝트 페이지에서 코드 저장소 링크를 발견하지 못했지만, 코드 자체가 없다는 증거는 아닙니다. 관련 내부 글 링크도 정확한 게시 URL과 내용 관련성을 이 단계에서 별도로 검증하지 못해 억지로 추가하지 않았습니다.


댓글
댓글 쓰기