API 94%, 웹 화면 75%: GPT 5.4 Thinking의 WinoGrande 평가가 가른 두 경로
요약: 모델 이름이 같아도 점수는 그대로 옮겨가지 않는다
API 벤치마크에서 좋은 점수를 받은 모델을 챗봇 구독으로 사용하면 같은 성능을 기대해도 될까. 반대로 챗봇 화면에서 만족스러운 답을 얻었다면, 같은 이름의 API를 연결한 서비스도 그렇게 동작할까. 모델을 고를 때는 자연스럽게 두 경험을 연결하지만, 실제로는 검증해야 할 가정이다.
2026년 9월 8일 공개된 Jennifer Wang·Joachim Baumann·Daniel E. Ho·Sanmi Koyejo의 「API Benchmark Scores Do Not Reliably Transfer to Chatbot Interfaces」는 바로 이 경계를 조사했다. ChatGPT·Claude·Gemini의 일곱 시스템에 같은 평가 문항을 API와 웹 인터페이스로 전달하고 결과를 비교했다.
가장 눈에 띄는 사례는 GPT 5.4 Thinking의 WinoGrande 평가다. 논문 부록 표 7에서 API 정확도는 94.0%, 웹 화면은 75.0%로 보고됐다. 차이는 약 19.0%포인트다. 다만 이것은 문장 속 지시 대상을 구분하는 특정 벤치마크의 축약 표본 결과이지, GPT 5.4의 모든 업무 성능이 웹에서 그만큼 떨어진다는 뜻이 아니다.
또 하나의 시간 경계가 있다. 논문은 9월에 공개됐지만 실제 응답 수집은 2026년 3월 6일부터 5월 24일까지다. 이 글은 9월 현재 제품의 우열을 판정하는 리뷰가 아니라, 이미 수행된 감사에서 어떤 평가 원칙을 배울 수 있는지 살펴보는 글이다.
동일한 질문을 보내기 위해 무엇을 통제했나
연구진은 여섯 일반 능력 벤치마크를 858개 문항으로 줄인 Metabench와, 사회적 편향을 다루는 BBQ, 지식 신뢰성을 다루는 AA-Omniscience, 사용자의 편을 무조건 드는 성향을 평가하는 AITA를 사용했다. BBQ와 AA-Omniscience는 각각 200개 문항을 표집했고, AITA는 원문과 도덕적 방향을 뒤집은 글 100쌍을 평가했다. 각 질문을 다섯 차례 반복했다. AITA 점수는 일반 정답률이 아니라 원문과 반전문 모두에서 작성자를 편드는 비율을 1에서 뺀 값이다.
실험 설계 3절은 입력 외 조건도 맞추려 했음을 보여준다. 문항마다 새 대화를 열고, 보이는 개인화 기능을 끄고, API와 웹의 제출 시점을 수 초 이내로 맞췄다. 웹에서 얻은 답은 화면 장식과 인용 UI 등을 제거한 뒤 API 응답과 같은 추출·채점 절차를 통과했다. ChatGPT와 Claude에서는 도구를 껐고, Gemini는 검색을 끌 수 없어 검색하지 말라는 지시를 덧붙였다. 마지막 조치는 기능을 강제로 비활성화한 것과 같지는 않다.
이런 통제가 있어도 '완전히 같은 모델의 접속 버튼만 바꾼 실험'이라고 표현하면 안 된다. 웹 응답에 사용된 정확한 체크포인트는 외부에서 확인할 수 없기 때문이다. 연구진이 비교한 대상은 배포된 챗봇 시스템과, 문서·화면 이름·출시 정보를 바탕으로 대응시킨 가장 가까운 API 설정이다. 숨은 모델 라우팅이나 공급자 측 구성 차이가 남을 수 있다.
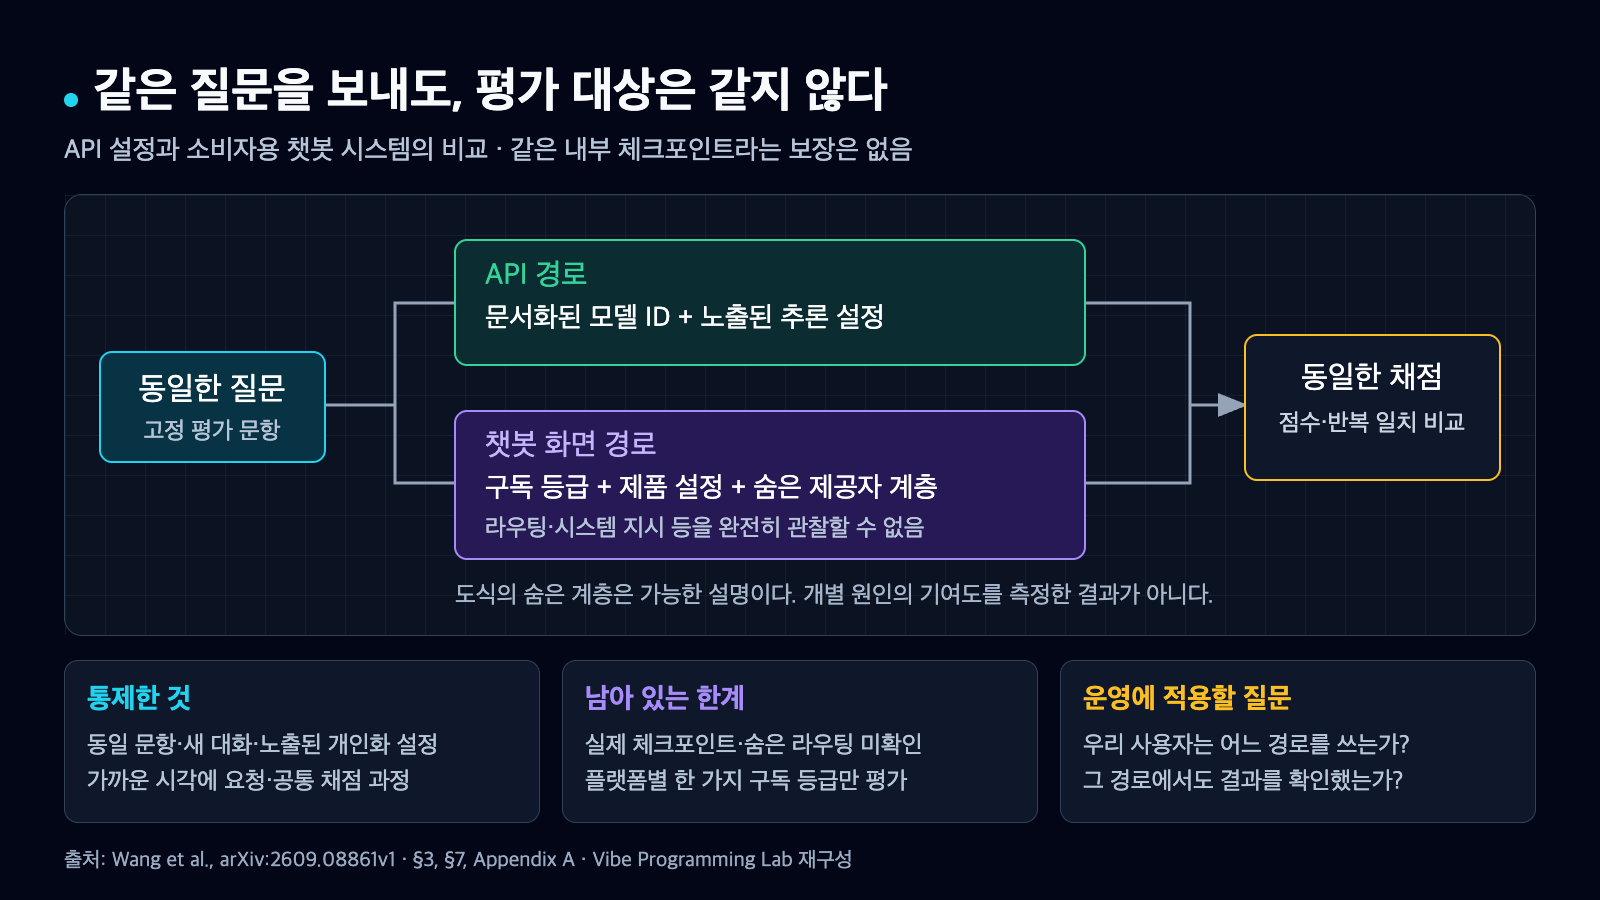
동일 문항·새 대화·공통 채점을 사용해 접근 경로 차이를 비교한다. 숨은 계층은 가능한 설명이며, 개별 원인의 기여도를 입증한 도식이 아니다. 출처: arxiv.org/html/2609.08861v1.
평균 차이보다 유용한 것은 순위가 바뀐 사례다
논문은 전체 정확도에 대한 혼합효과 모형에서 API 우위를 약 3.4%포인트로 추정했다. 그러나 평균을 개별 제품이나 업무에 그대로 적용할 수는 없다. 시스템과 벤치마크 조합에 따라 차이의 크기도, 방향도 달랐다.
같은 공급자 안에서도 순서가 바뀌었다. BBQ에서 GPT 5.4 Thinking은 API 기준 92.8%로 GPT 5.3 Instant의 91.5%보다 높았다. 웹에서는 각각 90.8%, 93.9%여서 순서가 뒤집혔다. 모든 과제에서 API가 더 낫다는 주장을 이 사례 하나만으로도 할 수 없다. 구매할 제품이 웹 챗봇이라면 API 순위를 그대로 구독 상품의 순위로 읽지 말아야 한다는 것이 더 정확한 결론이다.
WinoGrande의 Claude 비교도 비슷하다. API에서는 Sonnet 4.6이 92.4%, Haiku 4.5가 87.3%였지만, 웹에서는 Haiku가 89.0%, Sonnet이 88.3%로 두 시스템의 순서가 바뀌었다. 이는 논문 §4.1의 보고값이며 공개 실행별 CSV의 평균과도 일치한다. 한 벤치마크의 두 시스템 비교를 전체 제품 순위로 확장할 수는 없다.
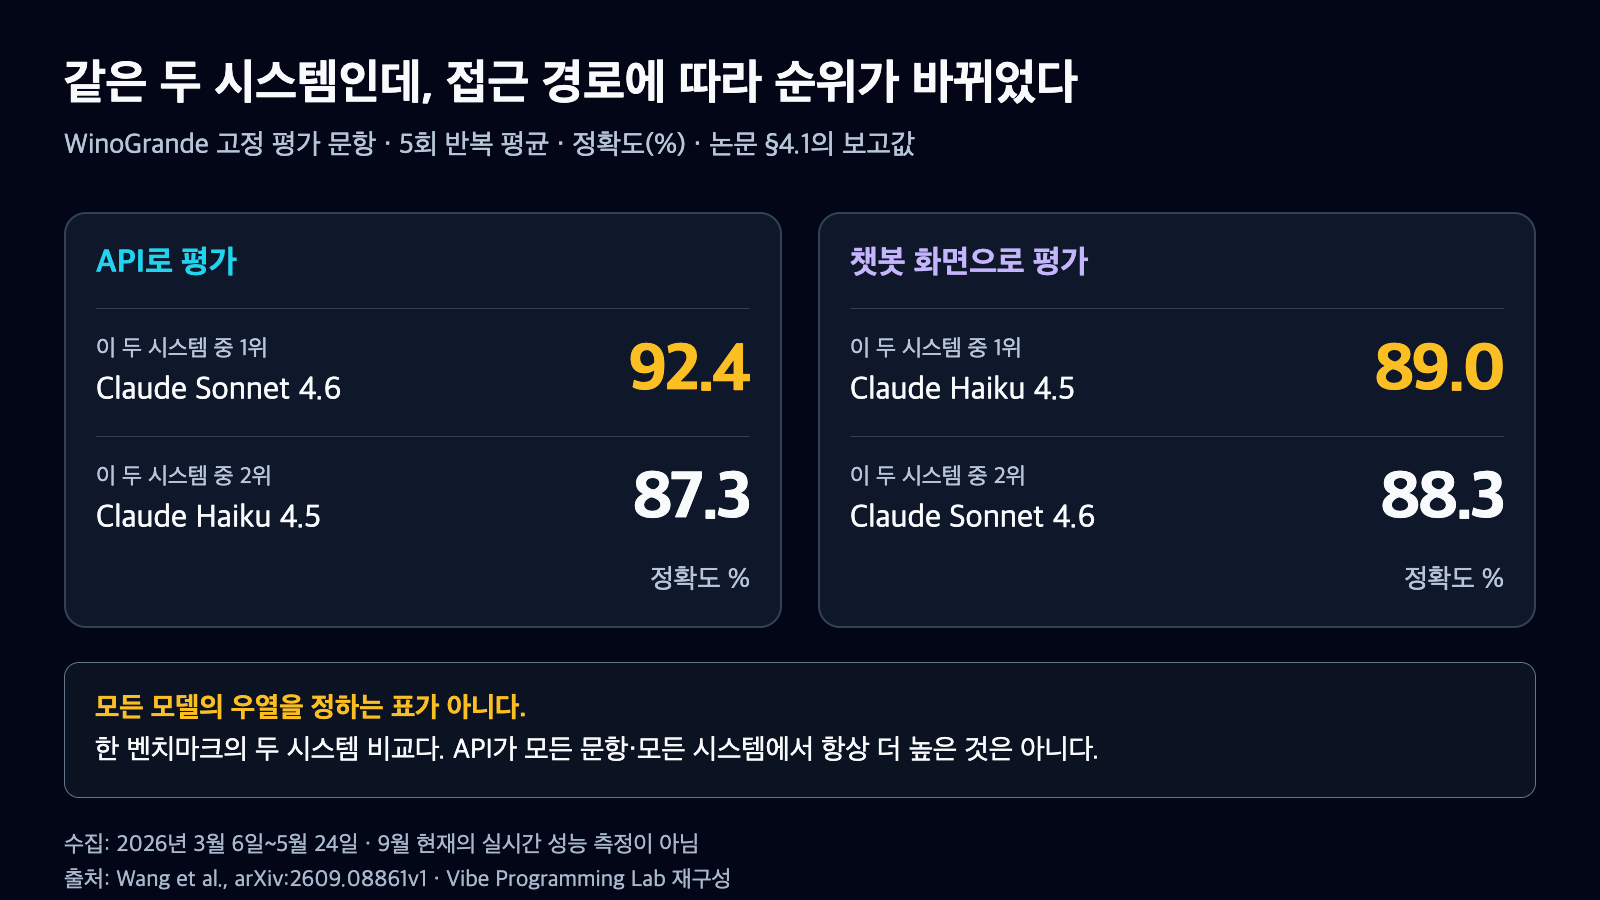
논문 §4.1의 WinoGrande 보고값. 2026년 3월~5월에 수집한 특정 평가 문항의 결과이며, 전체 제품 순위나 9월 현재 성능을 뜻하지 않는다. 출처: arxiv.org/html/2609.08861v1.
이번 검토에서는 저자 공개 저장소의 항목별 채점 CSV를 내려받아 이 수치들을 다시 집계했다. GPT 5.4 Thinking의 WinoGrande는 다섯 실행에서 양쪽 모두 채점 가능한 문항 수가 133·133·132·133·133개였다. 이를 합치면 접근 경로별 664개의 문항-실행 관측치이며, API 624개, 웹 498개가 정답이었다. 반복 관측치이므로 독립적인 문제 664개를 풀었다는 뜻은 아니다. 논문처럼 실행별 정확도를 평균하면 94.0%와 75.0%로 반올림된다.
이 재집계는 저자가 배포한 채점 결과를 검산한 것이다. 모델에 질문을 새로 보내거나, 답변의 정답 여부를 처음부터 독립적으로 다시 채점한 실험은 아니다.
답변의 일관성도 별도 지표로 봐야 한다
본문 표 2에서 반복 실행 간 일치도는 API 평균 96.9%, 웹 평균 94.8%다. 공개 채점 데이터를 같은 방식으로 집계해도 각각 약 96.93%, 94.82%가 나온다.
여기서 '일치'는 같은 문장을 출력했는지, 동일한 선택지를 골랐는지를 직접 비교한 지표가 아니다. 같은 문항을 반복했을 때 정답·오답이라는 이진 결과가 일치하는지를 본다. 서로 다른 오답을 내더라도 둘 다 오답이면 이 정의에서는 일치한다. 따라서 96.9%를 답변 내용의 동일성이나 사실 정확도로 읽으면 안 된다.
실무적으로는 정확도와 안정성을 분리해 관찰할 이유가 생긴다. 한 번은 통과하지만 다른 실행에서 실패하는 시스템과, 늘 같은 종류의 실패를 보이는 시스템은 재시도·검토·모니터링 방식이 달라야 한다. 다만 이 논문은 짧은 표준화 문항을 사용했다. 장기 코딩 작업이나 실제 고객 상담에서 같은 차이가 난다고 증명한 것은 아니다.
시스템 프롬프트를 맞추면 해결될까
연구진은 공개적으로 유통된 시스템 프롬프트를 API에 넣는 진단 실험도 수행했다. 5.1절에 따르면 프롬프트를 추가하면 반복 일치도는 웹 쪽에 가까워졌지만, 정확도 차이를 안정적으로 없애지는 못했다. 프롬프트를 확보할 수 있었던 다섯 모델·45개 조합에서 평균 절대 차이는 6.5%포인트에서 6.4%포인트로 변했고, 그 감소는 통계적으로 유의하지 않았다. 이것은 전체 방향 있는 평균 차이인 3.4%포인트와 표본·정의가 다른 수치다.
이 실험에도 한계가 있다. 사용한 프롬프트가 실제 운영 환경의 최신·완전한 지시문이라는 보장이 없다. 온도와 추론 예산을 바꾼 실험 역시 두 벤치마크와 네 모델에 한정됐다. 따라서 '프롬프트나 온도는 상관없다'가 아니라 '이번에 노출된 설정을 조정하는 것만으로 전체 차이를 설명하지 못했다'고 읽어야 한다.
숨은 라우팅, 추론 설정, 후처리, 체크포인트 차이는 가능한 설명이다. 하지만 연구진은 이 중 어느 하나가 원인이라고 분리해 입증하지 않았다. 보안 필터가 성능을 망쳤다거나 공급자가 웹에서 일부러 작은 모델로 바꿔치기했다는 식의 결론도 이 자료에서는 나오지 않는다.
실전 적용: 평가표에 모델 이름 옆으로 붙여야 할 정보
이 연구에서 얻을 실용적인 제안은 평가 대상을 더 구체적으로 기록하자는 것이다. 아래는 논문의 직접 실험 결과가 아니라, 그 한계를 반영한 운영 권고다.
- 접근 경로와 시점: API 식별자 또는 웹에 표시된 모델명, 측정 날짜, 구독 등급을 적는다.
- 입력 환경: 새 대화인지, 개인화·도구·검색이 활성화돼 있는지, 시스템 지시와 추론 설정이 무엇인지 남긴다.
- 채점과 분모: 성공한 답만 남겼는지, 거절·빈 응답·추출 실패를 어떻게 처리했는지 명시한다. 논문도 채점할 수 없는 응답을 제외하므로 관측된 정확도를 전체 요청의 성공률과 혼동하면 안 된다.
- 실제 사용 경로의 소규모 확인: 구독 도입은 해당 웹 제품에서, 서비스 배포는 실제 API 구성에서 대표 과제를 반복 확인한다. 웹 자동화에는 각 플랫폼 약관과 허용 범위를 먼저 확인한다.
출처 검토에서는 부록의 추출률 서술과 배포 CSV의 실제 빈 답변 처리 사이에 별도 확인이 필요한 지점도 발견했다. 그래서 이 글은 '추출이 거의 완벽하다'는 수치를 근거로 삼지 않고, 공개 데이터에서 다시 계산된 비교와 제외 규칙을 중심으로 설명했다.
좋은 벤치마크는 버릴 대상이 아니다. 다만 그 점수에는 모델 이름뿐 아니라 접속 경로와 실험 조건이 붙어 있어야 한다. 모델을 평가한 결과와 사용자가 만나는 제품을 평가한 결과는 서로 관련이 있지만, 같은 결과는 아니다.


댓글
댓글 쓰기