스키마가 맞아 보여도 절반은 실행되지 않았다: 한국 공공 API로 검증한 도구 연결
함수 이름과 JSON Schema를 읽고 "이 도구의 출력은 저 도구의 입력으로 들어갈 수 있다"고 판단했다. 그런데 실제 한국 공공 API에 연결해 보니 그런 후보 연결의 실행 성공률은 50.2%였다. 두 개 중 하나꼴로 스키마 밖의 현실에 걸린 셈이다.
9월 4일 공개된 EDGE-KOPA 연구는 이 간극을 정면으로 다룬다. 연구진은 10개 한국 공공 API 플랫폼의 2,318개 도구를 연결해 145개 과제를 만들고, 후보 의존성을 실제 endpoint에서 반복 실행했다. 실행 증거로 다듬은 그래프의 연결 성공률은 62.7%로 올라갔고, 제거된 연결은 14.8%만 성공했다. 도구 문서가 그럴듯한 연결을 제안하는 데는 쓸 만하지만, 실행 가능한 계약을 대신하지는 못했다.
요약: 도구 선택보다 도구 사이의 값 전달이 어렵다
KOPA-Bench의 과제는 교통, 금융, 교육, 법률, 정치, 행정 여섯 영역에 걸쳐 있다. 한 과제에는 평균 3.32단계와 4.92번의 도구 호출이 필요했고 최대 호출 수는 14번이었다. 평가도 마지막 문장만 보지 않았다. RESPONSE는 답을, ENVIRONMENT는 서버 상태를, ACTION은 실행한 도구 호출을 따로 검사했다. 정답 도구가 궤적 안에 있어도 최종 상태가 틀릴 수 있고, 정답 목록과 다른 경로로 올바른 결과에 도달할 수도 있기 때문이다.
출력과 입력의 이름이 비슷하다는 사실만으로는 부족했다. 날짜 형식, 식별자 범위, 페이지네이션, API key 취급, endpoint의 일시 장애가 모두 실행 결과를 바꾼다. 연구진이 만든 초기 skeleton graph는 dense retrieval과 LLM 판단으로 후보를 좁혔지만, 그 연결이 실제 호출에서 값을 넘기는지는 아직 모르는 상태였다.
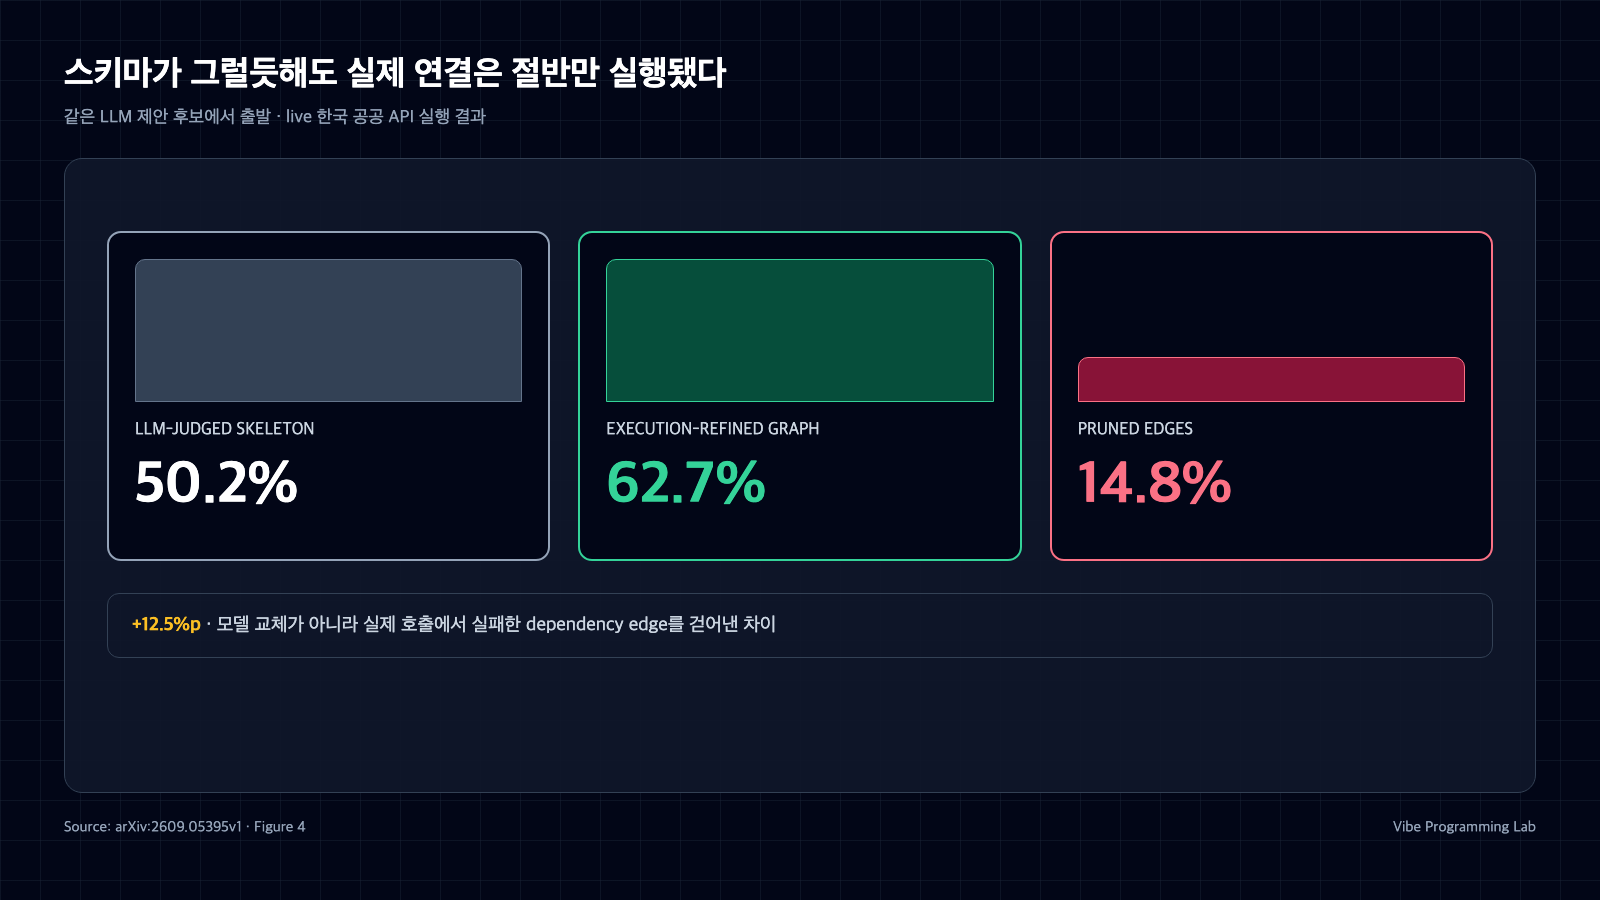
같은 후보 집합에서 실제 endpoint 실행으로 실패한 dependency edge를 걷어내자 연결 실행률이 50.2%에서 62.7%로 12.5%포인트 올랐다. 출처: arxiv.org/html/2609.05395v1.
실행 결과는 차이를 선명하게 만들었다. 초기 후보 연결의 성공률은 50.2%, 최종 그래프는 62.7%였다. 반대로 pruning된 연결은 14.8%에 그쳤다. 같은 후보 집합에서 출발했으므로 12.5%포인트 차이는 모델을 바꿔 얻은 것이 아니라 실제 호출로 실패한 연결을 걷어낸 결과다.
설계: LLM 판단은 약한 사전확률로만 썼다
EDGE는 후보 연결마다 "어떤 출력 field를 다음 입력 parameter에 넣을지"를 정한다. LLM이 매긴 feasibility score는 Beta 분포의 사전확률이 되지만 강도는 2로 낮게 둔다. 몇 번의 실행만으로도 처음 판단을 뒤집을 수 있게 한 것이다. 이후 100회 반복에서 매번 500개 경로를 뽑아 live API에 호출하고 posterior를 갱신한다.
모든 실패를 같은 무게로 벌점 처리하지 않은 점이 실무적이다. schema/type mismatch는 실패 증거가 강하므로 beta에 1.5를 더한다. missing field는 1.0이다. 반면 rate limit은 0.1, timeout과 server error는 각각 0.3만 더한다. 서버가 잠시 느렸다는 이유로 올바른 데이터 의존성을 제거하지 않기 위해서다. 성공도 generic parameter만 채운 경우 0.3, 의미 있는 입력값까지 전달된 경우 1.0으로 나눴다.
최소 두 번 시험한 연결 중 성공률이 0.5를 넘을 posterior 확률이 기준보다 낮은 것만 제거한다. 이 방식이 완벽한 연결만 남긴 것은 아니다. 최종 그래프에도 적게 시험돼 성공이 아직 관측되지 않은 연결이 있었다. 다만 제거된 연결 가운데 70.5%가 한 번도 성공하지 않았고, 남은 연결의 같은 비율은 27.7%였다. 무작위 pruning과는 다른 패턴이다.
한 번의 출력이 22만 개면 선형 체인이 깨진다
공공 API의 또 다른 문제는 cardinality다. EDGE 데이터에서 다단계 연결의 81.2%는 여러 record를 반환하는 출력을 소비했다. 비교 대상으로 제시한 ToolBench-v1, APIGen-MT, Nemotron, ToolACE는 이 비율이 1.6~10.0%였다. 연결 하나가 넘긴 record 수의 중앙값은 27, 90백분위수는 157, 최댓값은 224,958이었다.
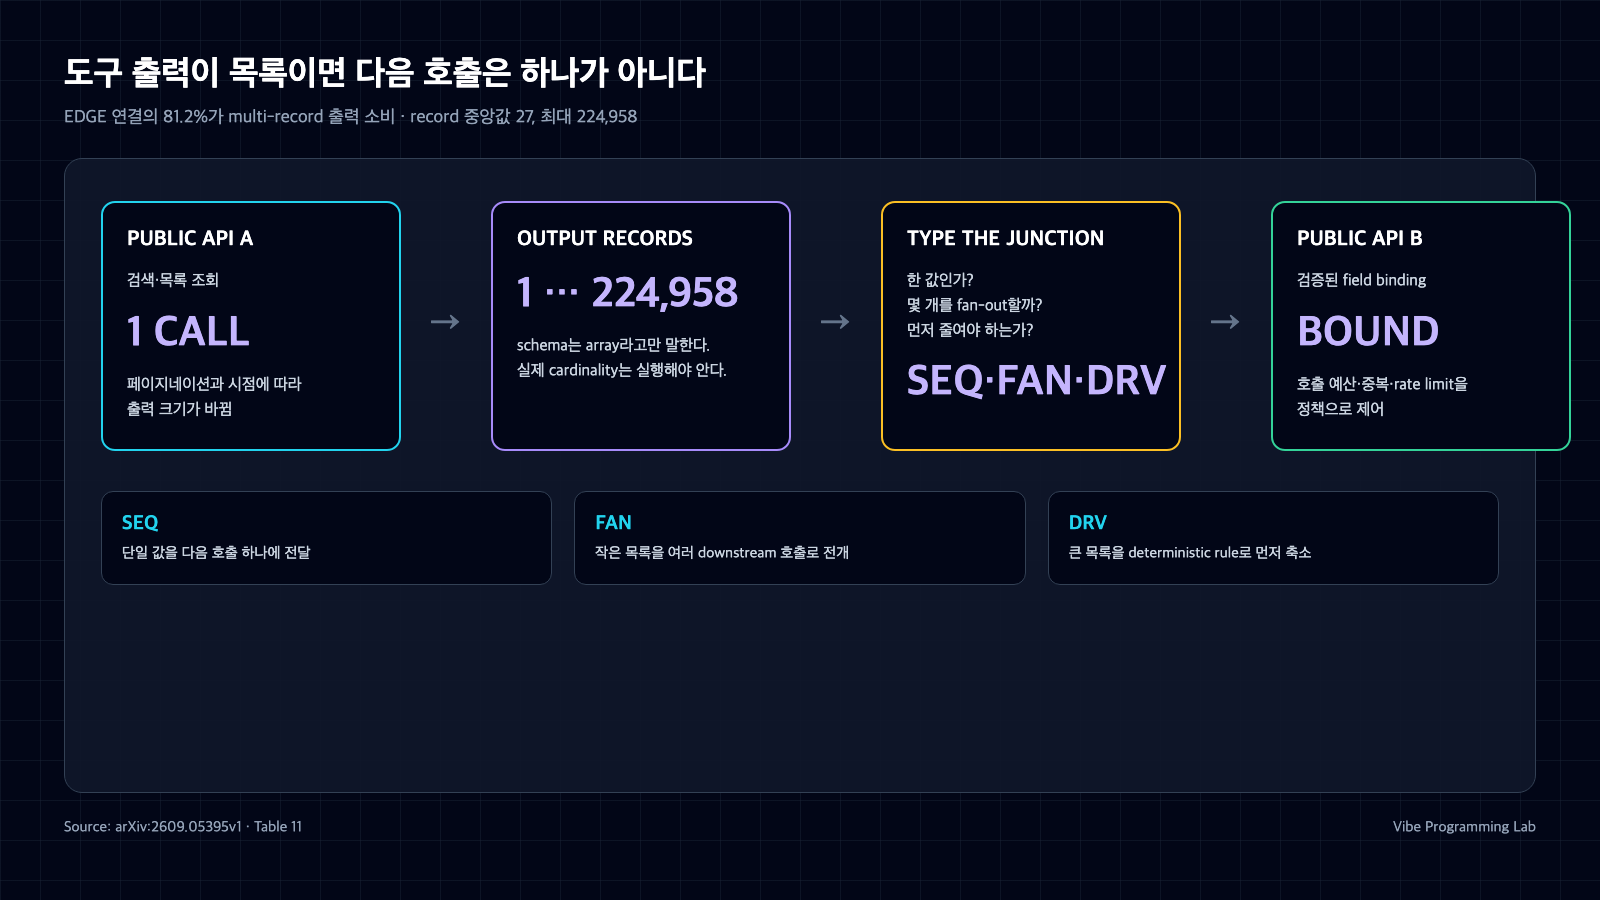
EDGE의 multi-step 연결 81.2%는 multi-record 출력을 소비했다. 단일 값, 작은 목록, 큰 목록을 같은 선형 체인으로 처리하지 않았다. 출처: arxiv.org/html/2609.05395v1.
값 하나를 다음 호출 하나에 넣는 SEQ만으로는 이런 응답을 처리하기 어렵다. EDGE는 적은 수의 값을 각각 호출하는 FAN, 너무 많은 값을 규칙으로 줄이는 DRV를 따로 둔다. 독립 호출은 SEM, 같은 도구에 다른 인자를 넣는 비교는 CMP, 중간 결과에 따라 갈라지는 흐름은 COND로 구성한다. 중요한 건 이름보다 cardinality 계약이다. "목록을 반환한다"는 설명만으로는 한 건인지 22만 건인지 알 수 없다.
이 차이는 비용과 정확도에 동시에 걸린다. 수천 개 record를 그대로 다음 prompt에 넣으면 context가 터지고, 첫 페이지만 읽으면 답이 빠진다. 전부 downstream API에 보내면 rate limit을 맞는다. 어느 field를 key로 쓸지, 중복을 어떻게 제거할지, 몇 건부터 deterministic reducer를 적용할지를 tool schema 바깥의 실행 정책으로 적어야 한다.
결과: 4B 모델이 좋아졌지만 숫자를 과장하면 안 된다
1,781개 EDGE 궤적으로 GRPO 학습한 Qwen3.5-4B의 pass@1은 0.1758에서 0.3094로 13.36%포인트 올랐다. 9B는 0.3275에서 0.4310으로 10.35%포인트 상승했다. 9B 결과는 같은 계열의 미세조정하지 않은 27B 0.4482에 가까웠지만 1.72%포인트 낮다. "작은 모델이 큰 모델을 이겼다"고 쓰면 원문보다 앞서 나간다.
공유 도구를 외웠다는 설명도 따로 검사했다. 합성에 쓰지 않은 서울 열린데이터광장, DART, KRX의 31개 과제에서 4B pass@4는 9/31에서 16/31로 올랐다. 평가와 학습의 function-pair dependency edge 178개는 중복이 0개였다. 다만 두 집합은 전체 평가 도구의 62.2%를 공유한다. 연구진이 보여 준 것은 같은 도구 이름을 보지 않았다는 게 아니라, 같은 연결 구조를 그대로 복제하지 않았고 보지 않은 플랫폼에서도 개선이 남았다는 것이다.
학습 목표도 영향을 줬다. 같은 1,781개 과제로 SFT한 4B는 pass@1 0.2724, GRPO는 0.3094였다. filtering 전후 비교에서는 0.242에서 0.309로 올랐다. 실행 가능한 그래프 하나만의 효과와 학습 목표, 궤적 유형, 필터링의 효과를 한 숫자로 섞어 "execution grounding이 모델 정확도를 13%포인트 올렸다"고 말해서는 안 된다.
주의점: 오늘은 원시 과제를 다시 돌릴 수 없다
이 연구의 endpoint는 연구팀이 통제하지 않는 live service다. schema, 반환 record, availability가 바뀌면 같은 과제도 달라진다. 실시간 데이터 과제를 걸러 내고 환경 상태를 hash로 비교했지만, 시점까지 고정된 완전한 재현은 아니다. 결과도 한국 공공 부문의 여섯 영역에 한정되며 상용·사내 API나 다른 언어로의 일반화는 아직 시험하지 않았다.
9월 8일 확인한 저자 저장소에는 README와 LICENSE만 있고, KOPA-Bench 145개 과제, 1,781개 학습 궤적, fine-tuned checkpoint는 모두 "coming soon"으로 표시돼 있다. 저장소의 최신 commit 780c371 기준으로 공개된 표의 차이는 다시 계산할 수 있었지만, 원시 과제를 실행하거나 모델 결과를 독립 재현할 수는 없었다. 따라서 이 글의 수치는 논문 표와 저자 문서의 보고값이다.
비교 범위도 좁다. schema와 LLM 판단으로 만든 skeleton은 기존 합성 시스템 전체를 재구현한 대조군이 아니다. 후보 집합을 고정한 상태에서 실행 검증의 효과를 분리하기 위한 내부 대조다. 다른 tool-data synthesis pipeline보다 EDGE가 항상 낫다는 결론은 아직 없다.
실전 적용: 연결마다 작은 contract test를 둔다
에이전트에 도구 100개를 붙이기 전에 실제로 함께 쓰는 output→input edge부터 목록으로 만든다. 각 edge에는 source field, target parameter, 변환 규칙, 예상 cardinality, pagination, 빈 결과, 중복, rate limit을 적는다. schema validation은 첫 관문이고, fixture endpoint나 sandbox에서의 실행이 두 번째 관문이다.
실패 분류도 분리한다. type mismatch와 missing field는 계약 결함으로 보고 빠르게 차단한다. timeout, 429, 5xx는 재시도와 관측 대상으로 남기되 연결 자체를 바로 폐기하지 않는다. 성공 로그에는 최종 답뿐 아니라 호출 순서, 전달한 field의 provenance, 응답 record 수, reducer 적용 여부를 보존한다.
평가에서는 RESPONSE, ENVIRONMENT, ACTION을 따로 본다. 답은 맞았지만 쓰기 상태가 틀린 경우와, 불필요한 호출을 많이 했지만 우연히 정답을 낸 경우를 구분할 수 있다. live API를 쓰는 회귀 test라면 기준 응답의 hash와 검사 시각을 남기고, endpoint drift가 제품 회귀처럼 보이지 않도록 고정 fixture test도 함께 둔다.
마지막으로 한 번 성공한 edge를 영구 계약으로 취급하지 않는다. 제공 기관의 schema 변경, 인증 정책, pagination 기본값이 바뀔 수 있다. production에서 자주 쓰는 연결은 주기적으로 재검증하고, 실패율이 올라가면 모델 prompt보다 먼저 upstream API와 binding rule을 확인한다. 도구 호출 에이전트의 신뢰성은 도구 목록의 길이보다 연결을 실제로 시험하는 습관에서 나온다.


댓글
댓글 쓰기