요구사항은 첫 편집 뒤에도 생긴다: 코딩 에이전트의 재작업을 줄이는 명세 체크포인트
코딩 에이전트에게 일을 맡길 때 우리는 첫 프롬프트를 사실상 명세처럼 취급한다. 그런데 실제 작업은 그렇게 깔끔하지 않다. 화면을 보고 나서야 필요한 예외를 떠올리거나, 첫 구현을 만져 본 뒤에 성능·보안·호환성 조건을 더하는 일이 흔하다. 사람 개발자에게도 익숙한 일이지만, 에이전트는 요구사항이 덜 굳은 상태에서 곧바로 파일을 고치기 때문에 그 비용이 몇 분 안에 코드 삭제와 재작성으로 나타난다.
2026년 9월 공개된 연구 Requirements After the First Edit는 이 현상을 실제 코딩 에이전트 세션과 통제 실험으로 측정했다. 핵심 결과는 강하지만 단순한 교훈으로 줄이면 위험하다. 새 요구사항이 등장한 뒤 기존 에이전트 코드의 삭제·교체량은 비교 가능한 비요구사항 편집보다 약 1.96배 많았다. 다만 연구진도 이것을 인과 효과로 단정하지 않는다. 실무에서 가져갈 결론은 "사용자가 처음부터 완벽히 말해야 한다"가 아니라, 첫 편집 전에 빠진 제약을 끌어내고 이후 변경을 안전하게 흡수하는 절차를 두라는 것이다.
연구가 무엇을 셌나
분석 출발점은 SWE-chat의 원시 세션 5,851개다. 이 가운데 연구 조건을 만족한 세션은 3,553개였고, 깨끗한 시작 상태를 재구성할 수 있는 세션은 약 2,060개였다. 최종 확인 분석에는 새 요구사항이 한 번 이상 나타난 402개 세션의 921개 요구사항 이벤트가 들어갔다. 저장소는 74개였다.
여기서 "새 요구사항"은 사용자의 마음을 추측한 개념이 아니다. 첫 파일 편집이 시작된 뒤, 지금까지 대화에 명시되지 않았고 관찰된 실패를 고치라는 말도 아닌 조건이 대화에 들어온 시점을 뜻한다. 사용자가 처음부터 생각했지만 말하지 않았다면 에이전트에게는 여전히 새로 도착한 요구사항이다.
연구진은 각 이벤트 뒤 다섯 번의 편집 안에서 이전에 에이전트가 쓴 줄이 삭제되거나 교체된 양을 invalidation으로 계산했다. 단순 churn과는 다르다. 새 줄을 많이 추가한 것은 세지 않고, 앞서 만든 코드 가운데 사라진 줄만 본다. 포매팅, 파일 이동, 전체 재생성 때문에 삭제량을 과대 측정할 수 있어 공백을 정규화한 줄이 이후 상태 전체에서 정말 사라졌는지를 보는 보수적인 순삭제 지표도 함께 사용했다.
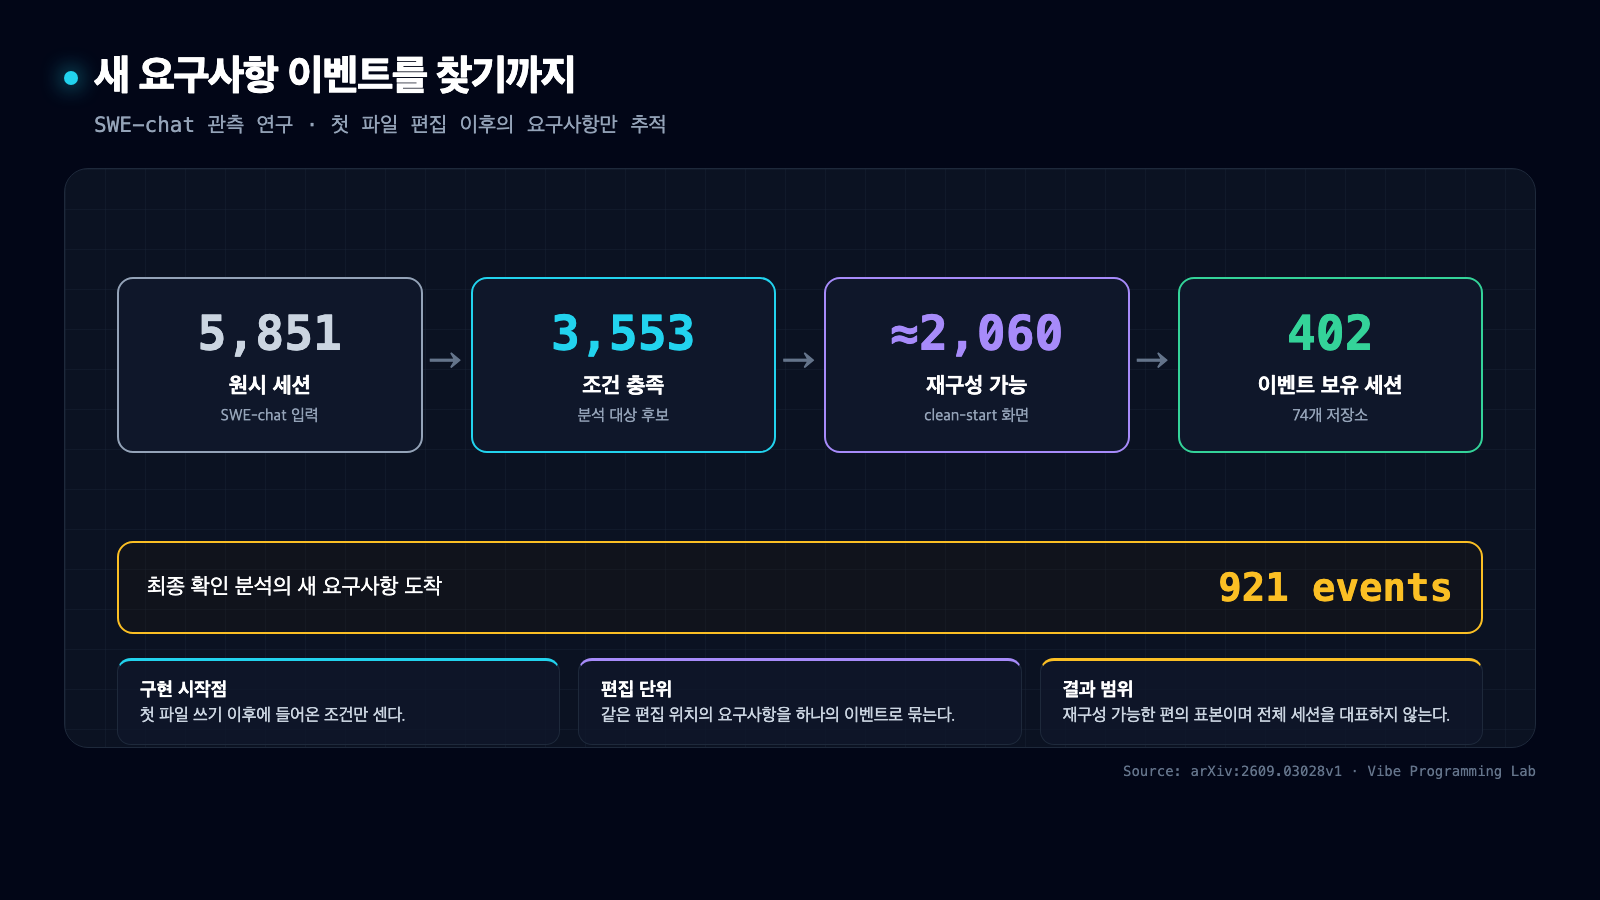
연구의 관측 분석 표본 구성. 최종 확인 분석은 402개 세션의 921개 새 요구사항 이벤트를 사용했다. 출처: arxiv.org/abs/2609.03028v1.
새 요구사항 뒤에는 약 두 배의 삭제가 따라왔다
핵심 비교는 요구사항이 등장한 452개 이벤트와, 같은 세션에서 편집 위치와 기존 에이전트 코드량이 비슷한 비요구사항 편집을 짝지어 만들었다. 실제 요구사항 이벤트 뒤 삭제·교체량의 가중 평균은 57.5줄, 대조 편집은 29.4줄이었다. 비율은 1.96배였고 95% 신뢰구간은 1.31~2.82였다. 차이로 보면 28.2줄이다.
보수적인 순삭제 지표에서도 방향은 같았다. 관측 가능한 창 기준 비율은 2.28배였다. 사용자가 다시 말한 사실 자체가 편집을 늘렸을 가능성을 줄이기 위해 "새 요구사항이 없는 사용자 턴"과 비교한 검사도 같은 방향을 유지했다. 공개된 Zenodo 산출물의 재현 요약은 921개 이벤트, 402개 세션, 74개 저장소와 1.959의 짝비교 비율을 그대로 기록한다.
하지만 "요구사항이 늦어서 정확히 28줄을 낭비한다"고 읽으면 안 된다. 짝짓기는 기존 코드량과 편집 위치를 맞췄지만 작업 난도와 개발 단계 같은 측정되지 않은 차이까지 제거하지 못한다. 삭제된 줄이 새 요구사항 때문에 의미적으로 무효가 됐다고 완전히 추적한 것도 아니다. 표본 150개를 따로 판정했을 때 55%는 요구사항 관련, 31%는 부수 정리, 14%는 불명확했다. 연구가 보여 준 것은 도착 직후의 강한 연관이지 보편적인 인과 법칙이 아니다.
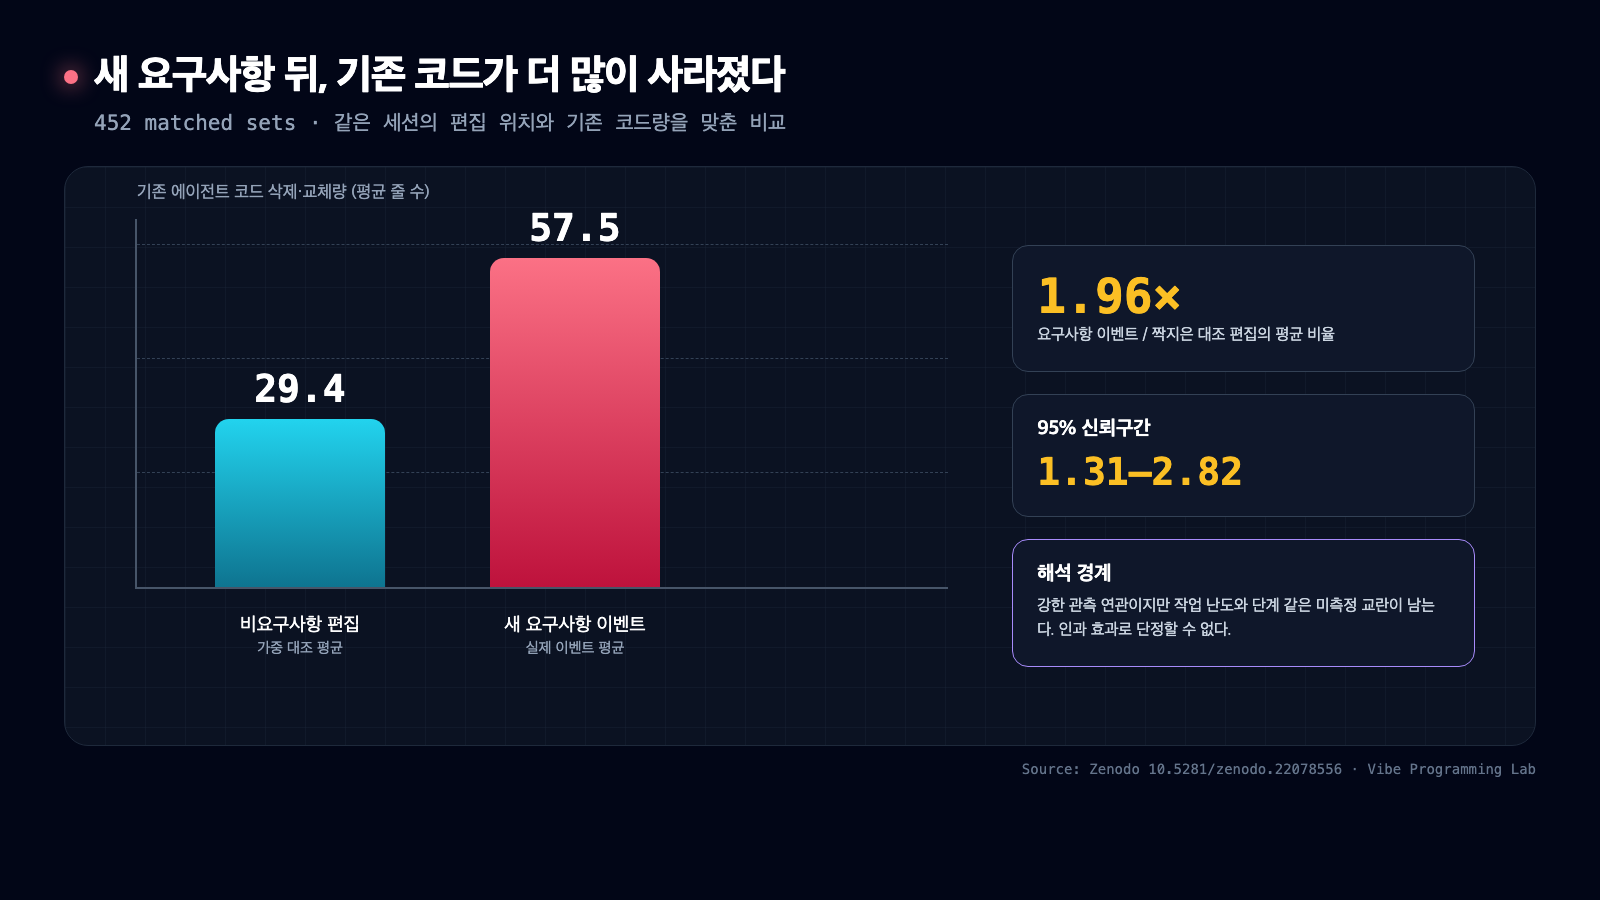
짝지은 452개 이벤트에서 요구사항 도착 뒤 평균 무효화량은 57.5줄, 대조 편집은 29.4줄이었다. 비율 1.96, 95% 신뢰구간 1.31~2.82. 출처: doi.org/10.5281/zenodo.22078556.
늦게 말할수록 더 비싸다는 결론은 나오지 않았다
흥미로운 부분은 반대 결과다. 전체 921개 이벤트 가운데 54.0%가 세션 후반에 나타났지만, 관측 가능한 절대 재작업량은 초반과 후반 사이에서 뚜렷한 차이를 보이지 않았다. 끝부분 이벤트는 이후 편집을 충분히 관찰하기 어렵다는 검열 문제가 있었고, 그 처리 방식에 따라 후반 부담 추정이 달라졌다. 그래서 논문은 "늦을수록 항상 더 많은 코드를 버린다"고 결론내리지 않는다.
요구사항의 종류도 단독 예측 신호가 아니었다. 삭제·교체처럼 파괴적인 요구와 추가·제약 같은 비파괴적 요구의 평균 차이는 3.3줄이었지만, 신뢰구간은 -19.3~26.7줄로 넓었다. 한 번의 사용자 턴에 여러 요구가 묶이는 효과를 떼어 내면 파괴적 유형 자체의 차이는 더 불분명해졌다.
통제 실험에서도 쉬운 처방은 확인되지 않았다. 25개 과제를 두 에이전트와 두 시드로 반복한 실험에서 요구사항 공개를 2라운드로 미루면 그 라운드의 churn은 0.1줄에서 9.3줄로 이동했다. 예상된 구현 시점 이동이다. 반면 "나중에 조건이 하나 더 온다"고 미리 경고만 한 실험은 기존 코드 덮어쓰기에 뚜렷한 차이를 만들지 못했다. 풀링 추정은 0.16줄, 95% 신뢰구간은 -0.56~1.06이었다. 내용 없는 예고는 명세가 아니다.
실무에서는 명세 체크포인트를 작게 둔다
첫 프롬프트를 길게 쓰는 것만으로는 해결되지 않는다. 사용자는 구현을 보고서야 원하는 것을 발견하기도 한다. 대신 첫 파일 수정 직전에 짧은 체크포인트를 둔다.
- 에이전트가 목표를 한 문장으로 다시 쓰게 한다.
- 입력·출력, 오류 처리, 호환성, 성능 한도, 수정 금지 영역을 질문하게 한다.
- 완료 판정을 테스트나 관찰 가능한 예로 바꾼다.
- 확인되지 않은 항목은 가정 목록으로 남기고, 되돌리기 쉬운 작은 첫 변경만 허용한다.
- 새 요구가 오면 기존 계획과 충돌하는지 먼저 표시한 뒤 코드를 고친다.
이 절차의 목적은 모든 요구를 사전에 고정하는 것이 아니다. 첫 구현 전에 값싼 질문으로 잡을 수 있는 제약을 잡고, 뒤늦은 변경이 생겼을 때 무엇을 버렸는지 추적하는 데 있다. 로그인·결제·데이터 마이그레이션처럼 실패 반경이 큰 작업이라면 체크포인트를 반드시 통과하게 하고, 문구 수정처럼 되돌리기 쉬운 일은 바로 진행하게 만드는 식으로 위험에 따라 강도를 달리할 수 있다.
재작업 지표는 줄 수 하나로 끝내지 않는다
삭제 줄 수는 빠르게 계산할 수 있지만 품질이나 비용 전체를 말해 주지 않는다. 100줄을 지우고 더 단순한 설계로 바꾼 것이 좋은 결정일 수 있고, 한 줄짜리 권한 검사를 빠뜨린 것이 더 큰 문제일 수 있다. 운영 대시보드에는 적어도 다음을 함께 남기는 편이 낫다.
- 요구사항이 처음 명시된 시점과 첫 편집 시점
- 새 요구 뒤 삭제·교체된 에이전트 코드량
- 변경된 테스트와 수용 기준
- 요구사항 충돌, 가정 변경, 부수 리팩터링의 구분
- 최종 검증이 원래 목표와 새 조건을 모두 덮는지 여부
연구의 라인 추적기도 파일 이동과 포매팅에서 과대 계산하고, 오래된 블록이 변형된 경우 교체를 놓칠 수 있었다. 실제 팀에서는 diff 통계에 의미 추적과 테스트 증거를 붙여야 한다. "몇 줄을 다시 썼나"보다 "어떤 조건 때문에 어떤 결정을 되돌렸나"가 다음 프롬프트와 도구 설계를 개선하는 정보다.
결론
새 요구사항은 예외가 아니라 코딩 대화의 일부다. 이 연구의 표본에서는 이벤트의 절반 이상이 세션 후반에 나타났고, 그 직후 기존 에이전트 코드 삭제·교체량은 짝지은 비요구사항 편집보다 약 두 배 많았다. 그렇다고 사용자가 모든 것을 먼저 알아내야 하는 것은 아니다. 연구는 늦은 시점이나 파괴적 요구 유형만으로 재작업 규모를 예측할 수 없다고 선을 긋는다.
따라서 좋은 에이전트 운영은 완벽한 첫 프롬프트를 강요하지 않는다. 첫 편집 직전에는 빠진 제약을 묻고, 구현 중에는 가정을 기록하며, 새 조건이 오면 코드부터 고치기 전에 기존 명세와의 차이를 드러낸다. 코드 생성 속도를 조금 늦추더라도 어떤 요구가 어떤 재작업을 만들었는지 남기는 편이 결과적으로 더 빠른 경로일 수 있다. 다만 그 효과는 아직 별도 개입 실험으로 검증해야 한다.


댓글
댓글 쓰기