에이전트 하네스 개선은 누적될까: 같은 예산으로 갈린 세 최적화기
에이전트의 프롬프트와 도구, 메모리, 제어 코드를 한 번 고쳐 벤치마크 점수가 올랐다. 그다음 새 문제가 들어왔을 때 같은 최적화기를 한 번 더 돌리면 개선이 계속 쌓일까. 정적인 점수표는 이 질문에 답하지 못한다. 첫 문제에 맞춘 편법이 새 문제에서는 오히려 발목을 잡을 수 있기 때문이다.
RELAI.ai 연구진의 기술 보고서 Do Agent Optimizers Compound?는 이 차이를 두 단계 실험으로 나눴다. GEPA, Meta Harness, RELAI-VCL에 같은 출발 에이전트와 단계당 200회 rollout 예산을 주고, 처음 본 과제에서의 상승, 새 과제로의 전이, 두 번째 최적화 뒤의 성능을 따로 측정했다. 결과는 간단하지 않다. 첫 점수가 올랐다고 장기 개선이 보장되지는 않았다.
한 번의 벤치마크 점수가 놓치는 것
실험은 Terminal-Bench 2.0의 hard 과제 가운데 22개를 썼다. 1단계 T1은 제한 시간이 900초인 12개 과제, 2단계 T2는 제한 시간이 1,800초인 10개 과제다. 더 오래 걸리는 hard 과제 8개는 제외됐다. 모든 과제는 에이전트별로 두 번 실행했고, 성공 비율을 0, 0.5, 1로 계산했다.
먼저 각 최적화기가 T1만 보고 하네스를 고친다. 그 결과를 T1에서 재면 전통적인 정적 평가다. 다음에는 추가 최적화 없이 T1과 처음 보는 T2를 합친 22개 과제에 넣어 전이를 잰다. 마지막으로 같은 최적화기에 rollout 200회를 더 주고, 합쳐진 과제에서 다시 성능을 측정한다.
이렇게 해야 서로 다른 세 능력이 갈린다. 이미 본 문제를 잘 푸는가. 새 문제에도 개선이 남는가. 새 문제를 학습한 뒤에도 예전 능력을 지키는가. 하나의 최종 평균은 이 셋을 뭉개 버린다.
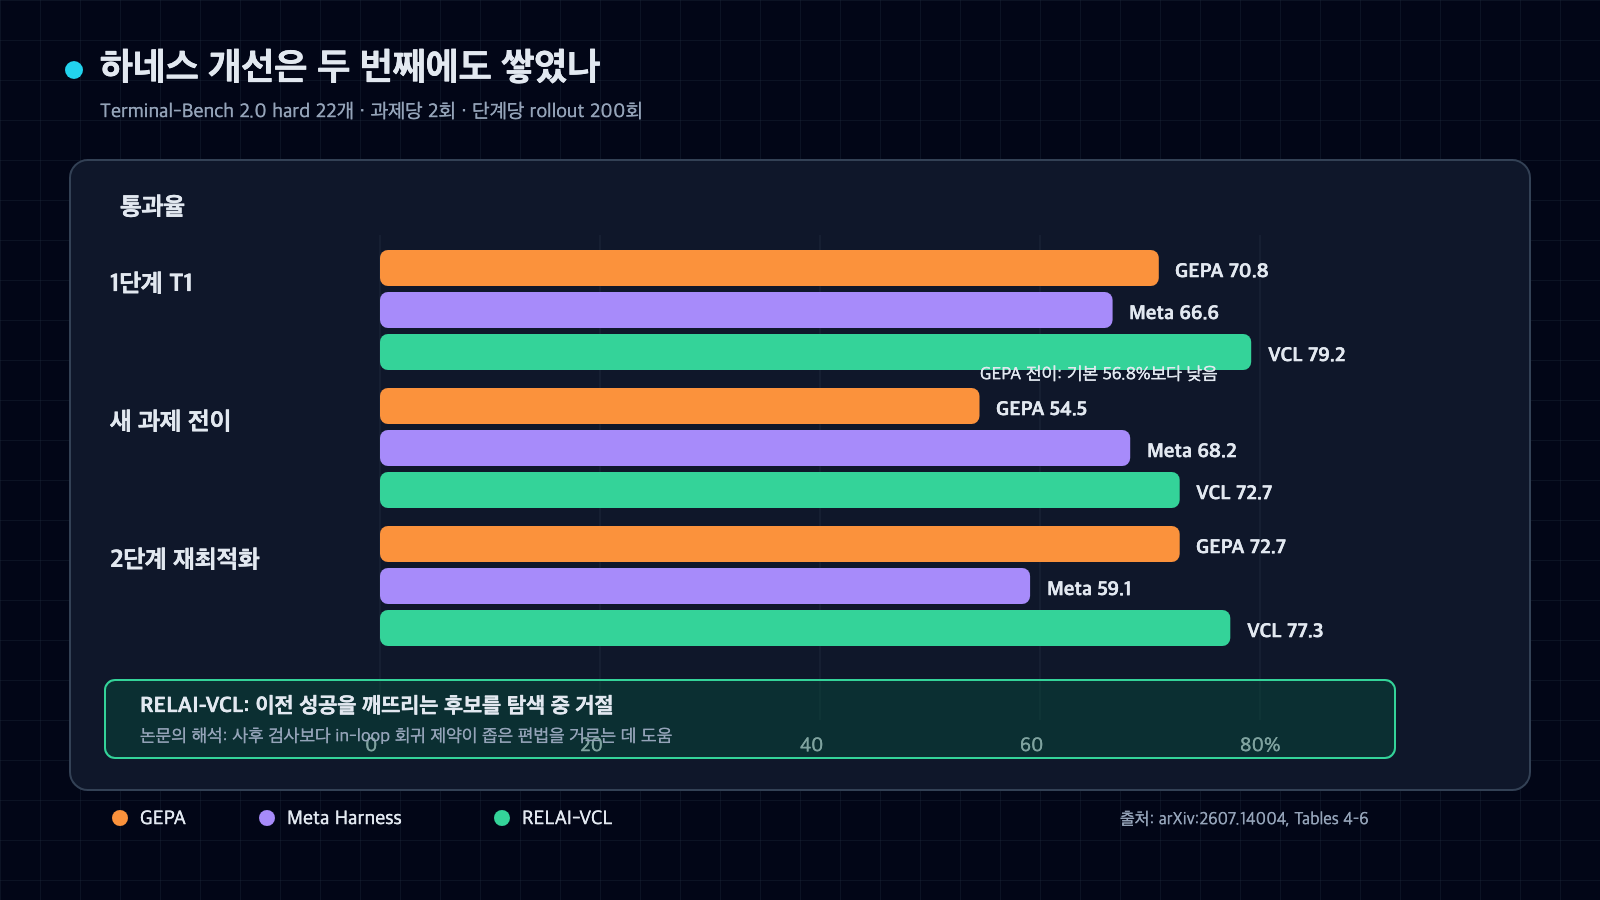
그림 1. 정적 1단계에서는 셋 다 개선됐지만, 새 과제로 전이하고 다시 최적화하자 실패 방식이 갈렸다. 출처: arxiv.org/abs/2607.14004.
첫 단계에서는 셋 다 좋아졌다
T1의 기본 에이전트 통과율은 62.5%였다. GEPA는 70.8%, Meta Harness는 66.6%, RELAI-VCL은 79.2%에 도달했다. 여기까지만 보면 세 방법 모두 성공이다.
하지만 무엇을 바꿨는지는 달랐다. 공개 저장소의 GEPA 프롬프트는 5줄에서 1단계 뒤 103줄, 2단계 뒤 195줄로 늘었다. 여기에 특정 Terminal-Bench 과제 이름, 파일 경로, 기대 문자열과 해결 절차가 들어갔다. 보고서는 이것을 1단계 과적합과 일치하는 정황으로 본다.
Meta Harness는 명령 완료 marker 판별과 잘못된 tool call 처리를 단단하게 만들었다. 2단계 후보는 긴 설치·빌드 로그를 짧게 압축하는 일반적인 변경이었다. RELAI-VCL은 과제 유형 분류, verifier 탐색, 실행 계약 확인, 치명적 오류 차단처럼 특정 과제의 정답을 적지 않는 변경을 선택했다.
새 과제를 넣자 GEPA는 기본값 아래로 내려갔다
1단계에서 만든 하네스를 그대로 22개 과제에 옮겼을 때 기본값은 56.8%였다. GEPA는 54.5%로 내려갔다. 반대로 Meta Harness는 68.2%, RELAI-VCL은 72.7%였다. RELAI-VCL은 아직 최적화에 쓰지 않은 T2만 따로 봐도 65.0%를 기록했다고 보고서는 설명한다.
GEPA가 나쁜 방법이라는 뜻은 아니다. 이 실험에서는 고정된 T1에 맞춘 상세한 프롬프트가 T1 점수는 올렸지만, 과제 분포가 넓어지자 이득이 남지 않았다. 최적화 대상과 평가 대상이 같을 때 높은 점수만 보면 놓치기 쉬운 실패다.
두 번째 최적화에서도 방향이 다시 갈렸다
합쳐진 22개 과제를 대상으로 rollout 200회를 더 쓴 뒤 GEPA는 72.7%까지 회복했다. 새 과제가 최적화 목표에 들어오자 다시 점수가 오른 셈이다. 다만 다음에 또 다른 과제가 들어왔을 때 이 상승이 유지되는지는 이 두 단계 실험으로 알 수 없다.
Meta Harness는 반대였다. 전이는 좋았지만 두 번째 단계의 모든 후보가 기존 에이전트보다 나빴고, 최종 통과율은 59.1%가 됐다. 보고서는 이를 "전이는 되지만 추가 개선은 멈춘" 사례로 분류한다.
RELAI-VCL은 72.7%의 전이 점수에서 77.3%로 더 올랐다. 연구진이 말하는 누적은 단순히 두 번째 점수가 높다는 뜻이 아니다. 새 과제로 전이한 뒤, 다시 최적화해도 이전에 풀던 과제를 잃지 않고 개선해야 한다.
차이는 회귀 검사를 언제 넣었는가에 있다
RELAI-VCL은 새 과제 점수를 올리더라도 이전에 풀던 과제를 깨뜨리는 후보는 탐색 과정에서 거절한다. 회귀 검사를 최종 보고서에 붙이는 사후 절차가 아니라 후보 선택 규칙으로 쓴다. 연구진은 이 제약이 좁은 편법을 걸러내는 일반화 필터처럼 작동했을 가능성을 제시한다.
여기서는 "가능성"이 중요하다. 실험은 회귀 제약만 분리해 제거한 ablation을 제시하지 않는다. 세 방법은 탐색 공간과 후보 생성 방식도 다르다. 따라서 77.3%를 회귀 제약 하나의 순수한 인과 효과로 읽을 수는 없다. 이 실험 안에서 회귀 제약을 둔 방법이 전이와 재최적화를 모두 통과했다는 정도가 안전한 결론이다.
평생 평균은 분해해서 봐야 한다
보고서의 lifelong average는 1단계, 전이, 최종 통과율을 단순 평균한 값이다. 기본값 58.7%, GEPA 66.0%, Meta Harness 64.6%, RELAI-VCL 76.4%다. 공개된 숫자로 다시 계산하면 같은 값이 나온다.
그런데 GEPA와 Meta Harness의 평균은 1.4%포인트 차이뿐이다. 실패 방식은 정반대다. GEPA는 새 과제로의 전이가 약했고, Meta Harness는 두 번째 개선이 무너졌다. 평균만 순위를 매기면 어떤 운영 위험을 감수하는지 보이지 않는다.
실무에서는 대시보드를 세 칸으로 나누는 편이 낫다. 현재 회귀 세트의 통과율, 아직 최적화에 쓰지 않은 신규 과제의 전이율, 새 변경 뒤의 회귀 손실을 따로 기록한다. 후보를 채택할 때는 평균 상승뿐 아니라 이미 통과하던 과제가 깨졌는지도 조건으로 건다.
이 결과를 운영 기준으로 옮길 때의 한계
이 실험은 두 단계뿐이고, 과제끼리의 관련성이 낮다. 실제 제품의 실패는 같은 API, 정책, 데이터에 묶여 있어 서로 더 강하게 연관될 수 있다. 각 과제도 두 번만 실행했다. 작은 표본에서 한 번의 성공과 실패는 통과율을 0.5 단위로 바꾼다.
또한 반복 실행이 가능하고 자동 verifier가 신뢰할 만하다는 가정을 둔다. 현실에서는 재현되지 않는 사용자 실패, 불완전한 로그, 부분적으로만 맞는 평가기가 흔하다. 사용한 기반 모델과 proposer도 특정 GPT-5.5 구성이다. 다른 모델과 더 긴 최적화 연쇄에서도 같은 순위가 유지된다고 단정할 수 없다.
그래도 평가 설계의 교훈은 분명하다. "최적화 후 점수" 하나로 끝내지 말고, 새 과제에 그대로 옮겼을 때와 두 번째 변경 뒤의 회귀를 따로 재야 한다. 자동 개선 시스템을 운영한다면 개선량보다 먼저 보존해야 할 동작 목록을 정하고, 그 목록을 후보 선택 안쪽에 넣어야 한다.
참고 자료와 작성 범위
이 글은 AI를 활용해 공개 논문과 저자 저장소를 대조하고 결과를 재구성한 해설입니다. 제품 후기나 독립적인 모델 재실행이 아닙니다. 평균값 산술은 재계산했지만, 원 실험의 rollout과 채점은 다시 수행하지 않았습니다.


댓글
댓글 쓰기