하네스를 고치는 모델과 실제로 이득을 보는 모델은 다르다
에이전트가 실패 기록을 읽고 프롬프트, 스킬, 메모리, 도구 설명을 스스로 고쳤다고 하자. 다음 실행의 성능이 오르면 "좋은 모델이 좋은 하네스를 만들었다"고 말하기 쉽다. 하지만 여기에는 서로 다른 두 능력이 섞여 있다. 하나는 실행 증거에서 쓸 만한 규칙을 만들어내는 능력이고, 다른 하나는 그 규칙을 실제 작업 중 불러와 끝까지 따르는 능력이다.
arXiv 프리프린트 Harness Updating Is Not Harness Benefit는 이 둘을 harness-updating과 harness-benefit으로 분리했다. 연구진은 일곱 LLM을 SWE, MCP-Atlas, SkillsBench 세 벤치마크에서 업데이트 작성자와 작업 수행자로 교차 배치했다. 결과는 직관과 달랐다. 비싼 모델이 항상 더 좋은 업데이트를 만드는 것도 아니었고, 약한 모델이 외부 스킬만 받으면 곧바로 강해지는 것도 아니었다.
업데이트를 잘 쓰는 능력은 모델 크기와 평평했다
업데이트 작성자, 즉 evolver를 바꾸었을 때 세 벤치마크에서 가장 좋은 모델과 가장 나쁜 모델의 향상 폭 차이는 최대 3.1%포인트였다. 어느 한 모델이 모든 벤치마크에서 이기지도 않았다. 가장 작은 작성자였던 Qwen3.5-9B는 SkillsBench에서 3.8%포인트 향상을 냈다. 논문이 보고한 Opus 4.6의 2.3%포인트보다 높고 Qwen3-235B의 1.5%포인트보다도 높다.
이 수치가 "9B 모델이 항상 Opus보다 낫다"는 뜻은 아니다. 연구의 핵심은 작성자 모델의 기본 작업 능력과 하네스 업데이트의 효용이 강하게 함께 움직이지 않았다는 점이다. flink-query 사례에서는 9B와 Opus가 표현은 달라도 사실상 같은 절차를 담은 스킬을 작성했고, 둘 다 동일한 작업 모델의 점수를 0.67에서 1.0으로 올렸다.
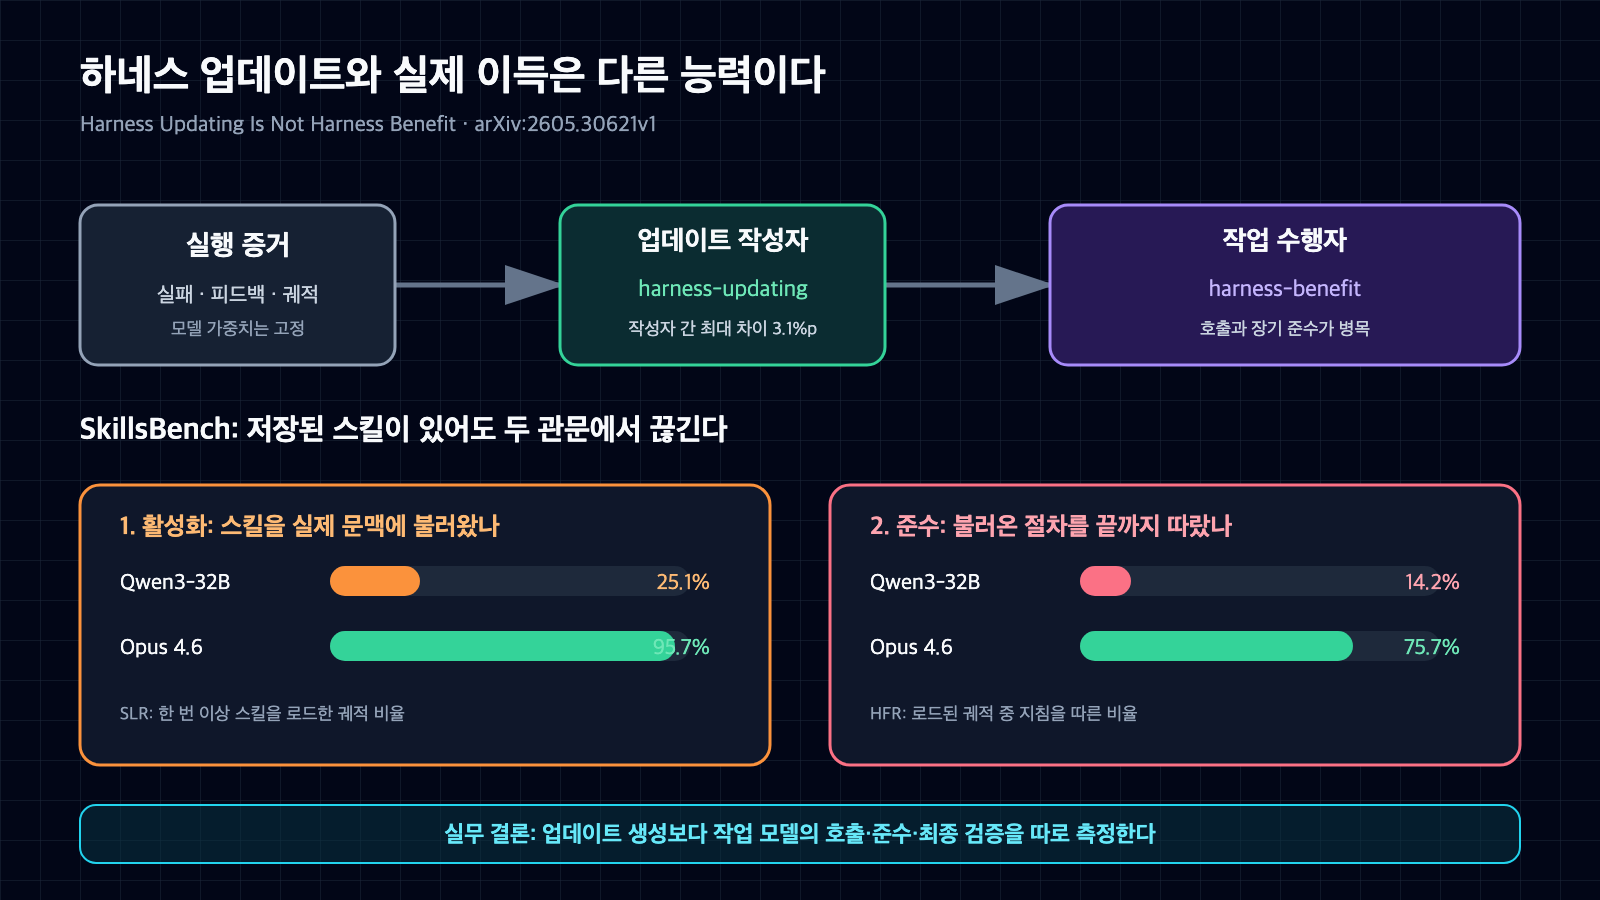
그림 1. 하네스 업데이트 생성과 실제 활용은 별개의 능력이다. SkillsBench에서 Qwen3-32B와 Opus 4.6의 스킬 로드율과 준수율을 논문 표 2 기준으로 비교했다. 출처: arxiv.org/html/2605.30621v1.
최종 성능은 업데이트 작성자보다 작업 모델에 더 묶였다
업데이트 작성자를 일곱 종류로 바꿔도 같은 작업 모델 안의 점수 변동은 MCP-Atlas에서 최대 5.1%포인트였다. 반면 Opus와 Qwen3-235B의 기본 능력 차이는 36.0%포인트였다. 약한 작업 모델에 가장 잘 맞는 작성자를 붙이고 강한 작업 모델에 가장 불리한 작성자를 붙인 극단 비교에서도 강한 쪽이 세 벤치마크 모두 18.6~35.2%포인트 앞섰다.
운영 예산을 나눌 때 이 차이는 꽤 현실적이다. 실패 로그를 요약하고 스킬 문서를 갱신하는 역할에 최고급 모델을 고정하기보다, 실제 도구를 호출하고 상태를 유지하는 작업 모델에 더 많은 능력 예산을 쓰는 편이 이 실험에서는 유리했다. 다만 비용 비교를 직접 수행한 연구는 아니므로, 가격 대비 최적 조합까지 증명했다고 읽어서는 안 된다.
약한 모델은 스킬을 불러오지 못하거나 불러와도 놓쳤다
SkillsBench에서 Qwen3-32B가 한 번이라도 스킬을 문맥에 불러온 비율은 25.1%였다. Opus 4.6은 95.7%였다. 약한 모델은 관련 스킬을 알아보고도 로드 요청을 다른 동작 안에 섞어 보냈고, 환경은 이를 유효한 로드로 처리하지 않았다. 규칙이 저장돼 있어도 작업 문맥에 들어오지 않으면 없는 것과 같다.
로드 성공 뒤에도 차이는 남았다. 스킬을 실제로 따른 비율인 HFR은 Qwen3-32B가 14.2%, Opus 4.6이 75.7%였다. Qwen3-235B는 로드율이 96.1%로 Opus와 비슷했지만 HFR은 35.0%에 그쳤다. 검색이 잘된다는 사실과 지침을 제대로 실행한다는 사실은 별개의 검사 항목이어야 한다.
긴 실행에서는 준수율이 계속 떨어졌다
대표 궤적을 단계별로 판정했을 때 Qwen3-32B의 준수 점수는 하네스 로드 직후 0.52에서 최종 검증 단계 0.13으로 떨어졌다. GPT-OSS-120B는 0.67에서 0.43으로, Opus 4.6은 0.89에서 0.80으로 변했다. 약한 모델의 문제는 처음부터 문서를 이해하지 못하는 데만 있지 않았다. 시간이 흐를수록 대체 절차와 검증 조건을 잃어버렸다.
이 결과는 에이전트 훈련과 평가가 "스킬을 제공했는가"에서 멈추면 안 된다는 뜻이다. 불러오기 성공, 지침 준수, 대체 경로 실행, 마지막 검증까지 따로 관찰해야 한다. 특히 긴 작업에서는 중간 단계마다 현재 규칙과 남은 조건을 다시 노출하는 설계가 필요하다.
운영 체크리스트는 네 단계로 나누는 편이 낫다
첫째, 하네스 업데이트 생성과 작업 실행을 별도 ID와 로그로 남긴다. 누가 규칙을 썼는지보다 어떤 규칙이 어떤 작업 모델에 적용됐는지를 추적해야 한다. 둘째, 스킬 검색 결과와 실제 로드 성공을 분리해 측정한다. 셋째, 로드 직후뿐 아니라 중간과 종료 지점에서 지침 준수 여부를 확인한다. 넷째, 잘못 학습한 규칙을 되돌릴 수 있도록 업데이트를 버전 관리하고, 개인정보나 위험한 도구 규칙이 영구 메모리에 들어가지 않게 승인 경계를 둔다.
논문 저장소는 release/harness-evolution 브랜치로 코드와 실행 안내를 공개했다. 다만 이 글에서는 전체 실험을 독립 재실행하거나 저자 판정 데이터를 다시 채점하지 않았다. 논문 v1과 공개 저장소의 구조, 보고된 표를 대조해 해석한 것이다.
남아 있는 한계
연구는 모델 가중치를 바꾸지 않고 외부 하네스만 갱신하는 설정을 다룬다. 파인튜닝, 강화학습, 혼합형 적응에는 같은 결론을 바로 적용할 수 없다. 모델 목록도 모든 계열과 크기를 포괄하지 않는다. SkillsBench의 HFR과 단계별 준수 점수에는 LLM 판정기가 들어가므로, 숫자는 해당 판정 절차와 벤치마크에 묶여 있다.
그래도 실무 질문은 명확해진다. "하네스가 좋아졌나"만 묻지 말고 "작업 모델이 그것을 불러와 끝까지 지켰나"를 함께 물어야 한다. 업데이트 문서가 훌륭해도 호출과 준수에서 끊기면 시스템 성능은 오르지 않는다.
참고 자료
이 글은 공개 논문과 저자 공개 저장소를 바탕으로 한 해설이다. 제품 사용 후기나 독립 재현 결과가 아니며, 원고 구성과 표현 정리에 AI 도구를 사용했다.


댓글
댓글 쓰기