스킬 점수는 올랐는데 상위 폴더를 허용했다: 플러그인 마이그레이션 평가의 빈틈
버전이 바뀐 플러그인을 AI 에이전트에게 옮기게 할 때, 답변 점수가 높다는 사실만으로 실제 수정이 안전하다고 말할 수 있을까요? 이번 논문은 점수 상승과 구체적인 계약 위반 사례가 함께 존재할 수 있음을 보여줍니다. 핵심은 “스킬이 효과 있다/없다”의 단정이 아니라, 무엇을 시험했고 무엇은 아직 시험하지 않았는지를 평가표에서 분리하는 일입니다.
Beiming Liu 외 연구진의 「Evaluating Agent Skills for Version-Specific Plugin Migration: A Retrospective Study」(arXiv:2609.30120v1, 2026년 9월 24일 공개)는 한 플러그인 마이그레이션 스킬을 정적 진단 과제에 적용한 후향 연구입니다. 본문 §4.1은 22개 정적 과제에서 층화 추출한 16개를 비교합니다. 스킬 없음/있음 두 조건에서 과제마다 두 번씩 실행해 64개 보고서를 만들고, 328개의 기준별 판정을 매겼습니다. 반복 보고서와 기준 판정 수를 독립적인 마이그레이션 과제 수로 세면 안 됩니다.
평균은 올랐지만, 무엇의 평균인가
표 1의 원래 루브릭 평균은 스킬 없음 93.83, 스킬 있음 98.75로 차이는 4.92점입니다. 이는 0~100점 보상 척도의 점수 차이지, 상대 개선율도 아니고 “마이그레이션 성공률이 4.92% 상승”했다는 뜻도 아닙니다. 16개 과제 중 6개는 상승, 2개는 하락, 8개는 두 조건 모두 100점이었습니다. S1 하나가 42.5점을 보탰고, 이를 제외하면 나머지 15개 과제의 평균 차이는 2.42점입니다.
논문이 제시한 과제 단위 부트스트랩 95% 구간은 [0.31, 10.86], Wilcoxon 검정의 p값은 0.0797입니다. 이 숫자는 관찰된 과제들에 대한 탐색적 요약으로 읽는 편이 정확합니다. 천장 효과가 크고 한 과제의 기여가 두드러지며, 연구진도 후향적 단일 사례라는 범위를 설명합니다. 이 구간을 다른 플러그인·모델·운영체제에 그대로 일반화할 수 없습니다.
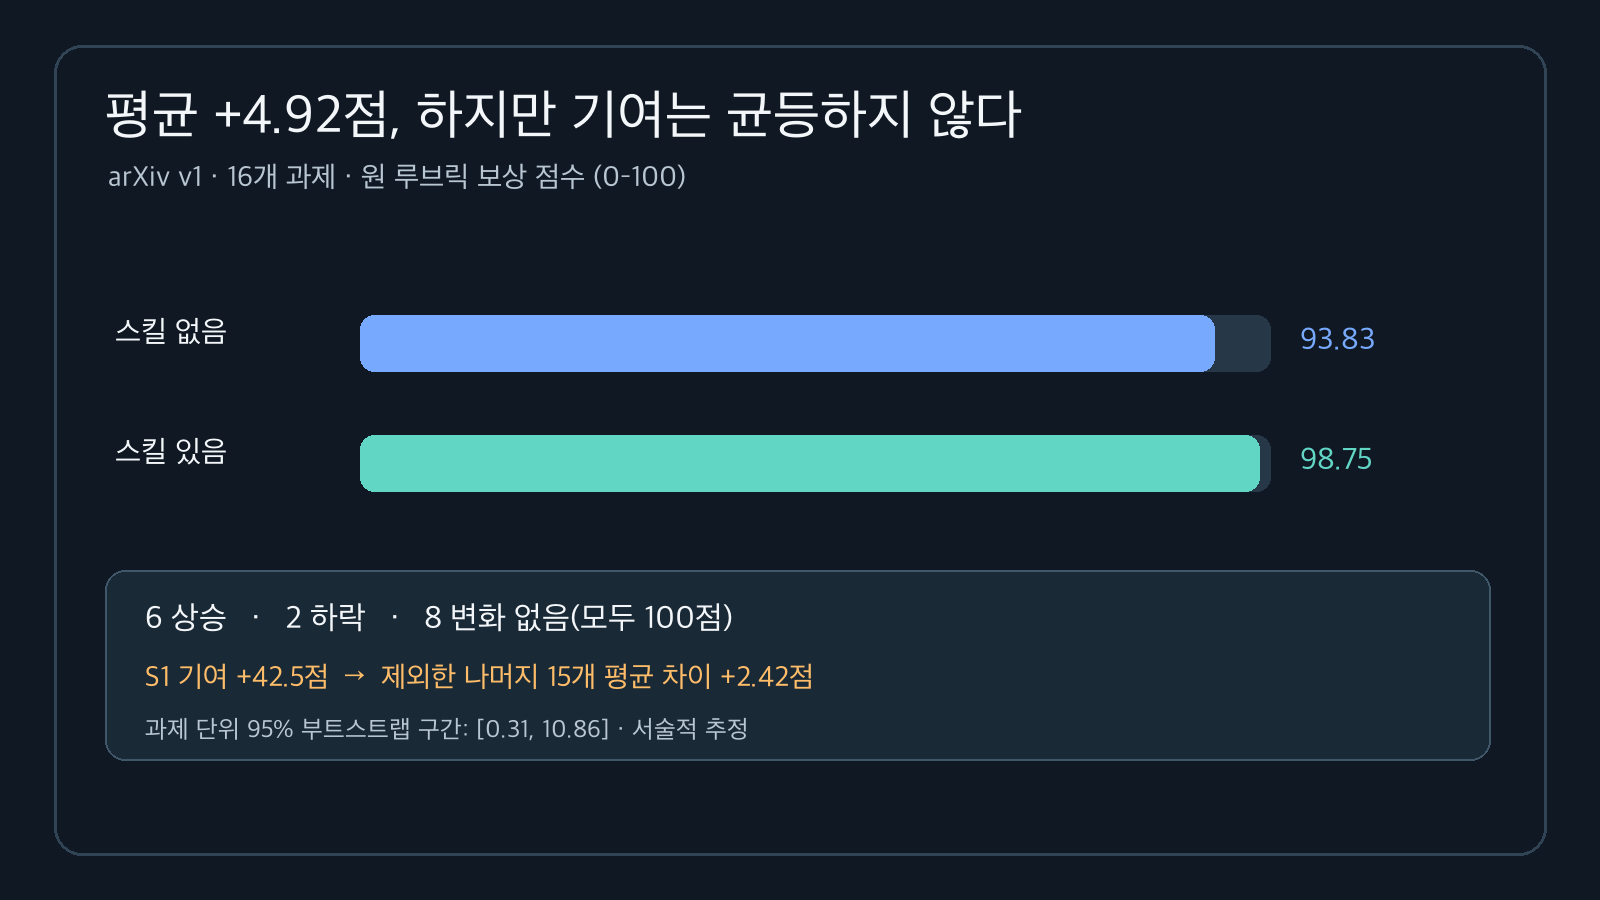
원 루브릭 평균 차이는 4.92점이지만 S1 기여는 42.5점이며, 여덟 과제는 양쪽 모두 만점이다. 성공률이 아닌 점수 비교다. 출처: arxiv.org/html/2609.30120v1.
점수 평균은 요약에 유용하지만, 어떤 종류의 실수가 남았는지 숨길 수 있습니다. 표 2의 안전·경계 도메인에서 원 판정은 양쪽 조건 모두 10/10 만점을 기록했지만, 표적 검토에서 S11의 상대경로 경계 사례가 발견됐습니다. 따라서 “해당 영역 만점”을 독립적으로 검증된 안전성으로 번역하면 안 됩니다.
계약을 세 칸으로 나눠 확인하기
아래는 논문 결과를 실제 검토 업무에 옮길 때 사용할 수 있는 편집상 도구입니다. 저자들이 이 표를 시험해 성능 향상을 측정한 것은 아닙니다. 한 줄마다 버전 경계, 반례 입력, 관찰 가능한 런타임 확인을 함께 적으면 “API 이름을 맞혔다”와 “목표 환경에서 계약을 지켰다”를 분리할 수 있습니다.
| 점수·계약 | 묻는 질문 | 이 사례에서 보이는 것 | 다음 검증 |
|---|---|---|---|
| 점수 변화 | 어떤 분모·조건의 점수인가? | 16개 정적 과제의 평균 루브릭 보상 +4.92점 | 기능 수정 성공률과 분리해 기록 |
| 경계 입력 | 명시한 금지 입력을 거부하는가? | S11 상대경로 판정은 정확한 .. 부모 경로를 허용했다고 보고됨 |
POSIX·Windows 경계 입력을 각각 확인 |
| 런타임 계약 | 실제 호스트에서 원하는 상태가 되는가? | S18 점수는 좁은 timer 조건을 채점; 다른 종료 방식의 실패를 증명하지 않음 | 마운트 상태와 타이머 참조를 관찰 |
| 증거 강도 | 누가 무엇을 검토했나? | 원 판정·표적 검토·모델 재채점은 사람의 독립 정답과 다름 | 독립 판정자와 실행 가능한 통합 테스트를 별도로 둠 |
S11: 통과 점수와 경계 조건의 충돌
§5.2의 S11 사례는 상대경로 판정식이 POSIX와 Windows 양쪽 알고리즘에서 정확히 ..인 부모 경로를 허용했다고 저자들이 추출한 내용입니다. 보고된 진단 입력 14개 중 2개가 실패한 사례입니다. 이것은 완전한 마이그레이션이 실행됐다는 뜻이 아니며, 라우팅·심볼릭 링크 동작을 확인했다는 뜻도 아닙니다. 저자들이 보고한 정적 판정 사례이지, 이 글에서 코드를 실행해 독립 재현한 취약점 주장이 아닙니다.
그럼에도 실무 질문은 구체적입니다. “상대경로인가?”처럼 범주만 쓰지 말고, 경계값 .., 하위 경로, 절대경로, 구분자 변형을 플랫폼별로 적습니다. 이어서 정규화 전후 값을 기록하고, 허용된 루트 내부인지 비교하며, 실제 파일 접근이 가능한 격리된 테스트에서 기대 결과를 확인합니다. 논문 사례는 이러한 검증 설계의 동기를 제공하지만, 여기 열거한 테스트 목록 전체를 논문이 실행했다고 말하는 것은 아닙니다.
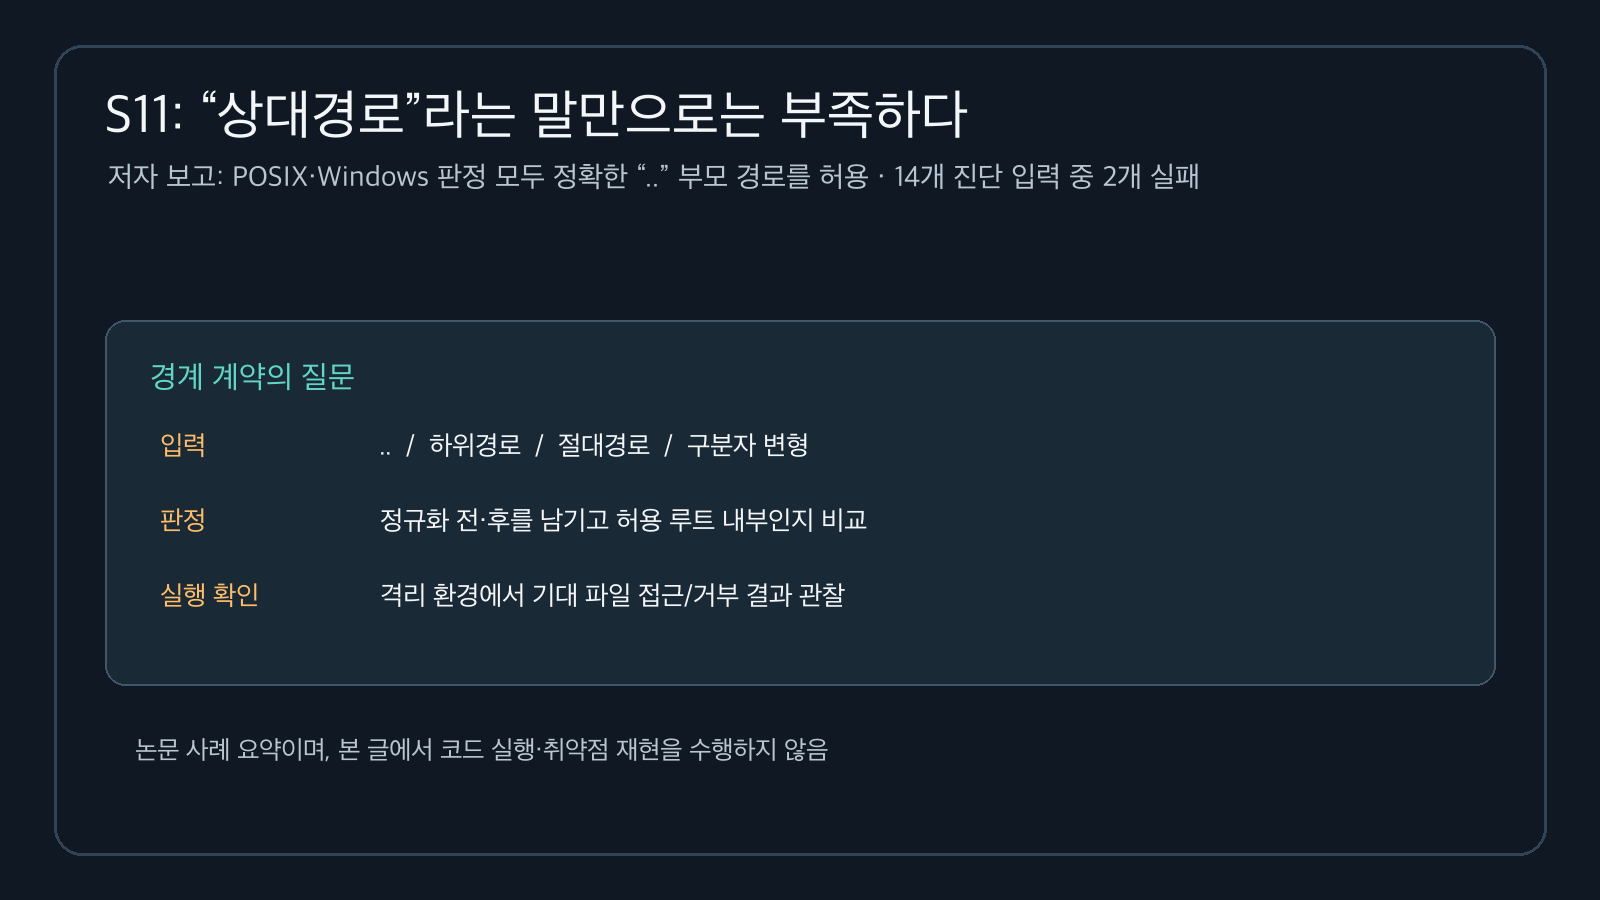
저자 보고에서 POSIX·Windows 판정이 정확한 부모 경로를 허용했다. 아래 점검 단계는 글의 제안이며 논문에서 실행한 재현 절차가 아니다. 출처: arxiv.org/html/2609.30120v1.
S18: “멈춤”의 의미를 테스트 계약으로 고정하기
S18에서는 티어다운 호출 자체가 동작할 수 있었지만, 좁은 루브릭은 호스트가 여전히 마운트된 상태에서 타이머 참조를 해제하는 조건을 요구했습니다. 이 기준에서 부분 점수를 받았다고 해서 다른 티어다운 경로가 멈춤을 해결하지 못한다는 결론은 나오지 않습니다. 테스트 문구가 어떤 종료 상태를 요구하는지, 루브릭이 그 상태를 제대로 표현하는지, 실행 환경이 그 경로를 관찰했는지를 따로 적어야 합니다.
버전 마이그레이션 체크리스트라면 API 이름·인자 형태 같은 정적 조건, 순서·소유권·마운트 상태 같은 생명주기 조건, 마지막으로 실제 종료·재시작 같은 결과 조건을 분리할 수 있습니다. 정적 점검에서 확인하지 못한 동작은 “실패”라고 과장하지 말고 “미검증”으로 남깁니다. 반대로 점수표가 요구한 한 경로의 통과도 제품 수준 성공 증거로 승격하지 않습니다.
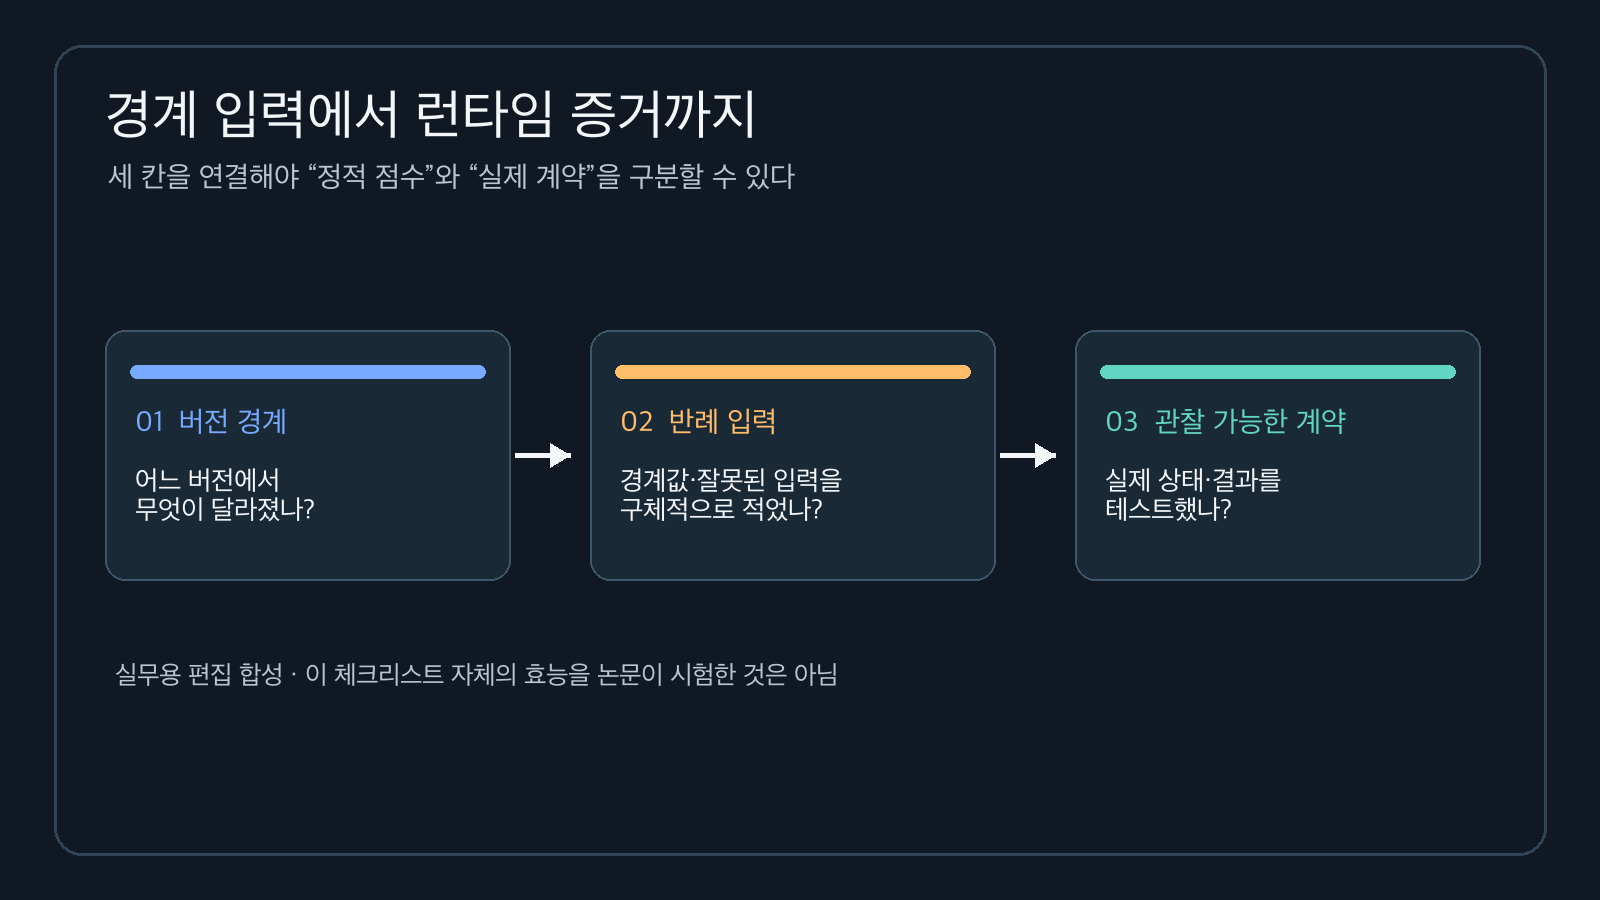
버전 변화·경계 입력·실제 관찰을 연결하는 편집상 실무 제안이다. 논문이 이 체크리스트의 효능을 측정한 것은 아니다. 출처: arxiv.org/html/2609.30120v1.
검토 점수도 정답은 아니다
저자들은 10개 답변, 56개 기준을 표적 검토했고 2개 답변에서 세 기준의 불일치를 보고했습니다. 이는 목적 표집된 작은 검토이지 전체 채점의 오류율이 아닙니다. 원 점수에서 S11 검토 결과를 반영하면 평균 차이가 4.61점으로 바뀌고 구간은 0을 가로지릅니다. 모든 검토된 대체 판정을 반영한 차이는 5.39점이며 구간 하한이 0에 닿습니다. 따라서 방향만 고정된 것처럼 읽거나, 더 큰 대체 평균을 진실로 택하는 것은 모두 부정확합니다.
두 개의 다른 계열 언어모델이 같은 64개 보고서를 다시 판정했을 때 평균 차이는 각각 10.63점과 6.09점이었습니다. 판정자 간 일치가 인간 정확도나 루브릭 타당성을 보증하지는 않습니다. 연구의 위협 타당성 절은 원 판정 모델과 해결 모델의 계열 공유, 개발 노출 과제, 단일 프레임워크, 제한된 반복, 기여자와 검토자의 겹침 등을 한계로 듭니다. 독립적인 사람의 전수 검증을 했다고 표현할 근거는 없습니다.
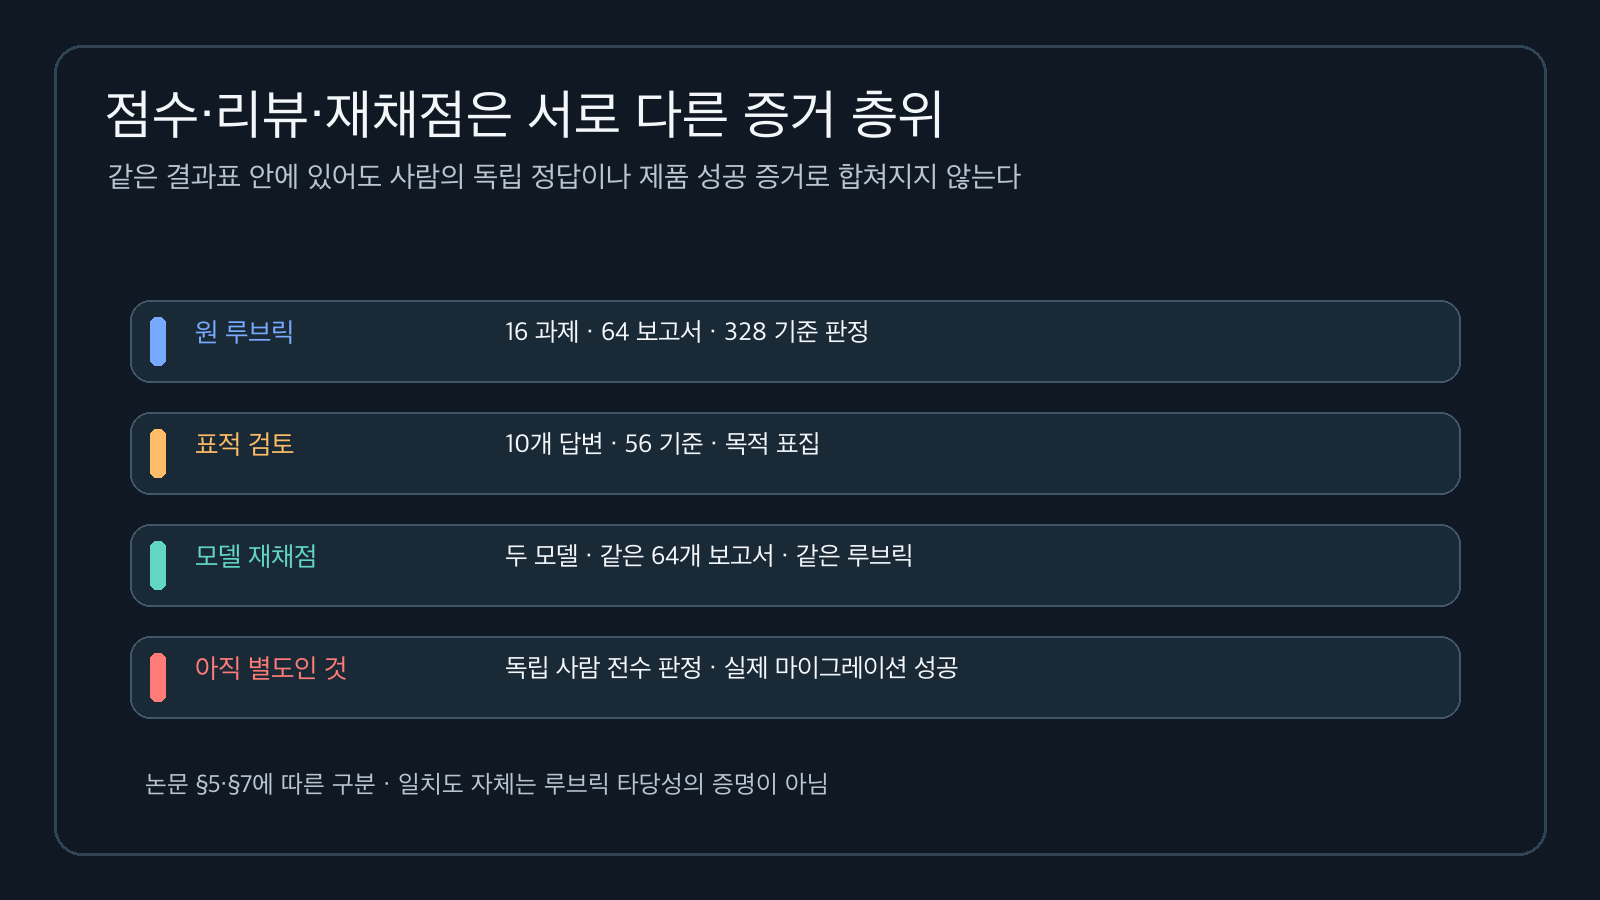
서로 다른 판정 절차와 미수행 검증을 분리한다. 모델 간 일치가 독립 인간 정확도나 제품 성공의 증거는 아니다. 출처: arxiv.org/html/2609.30120v1.
다음 마이그레이션 검토에 적용할 최소 질문
새 버전 전환을 승인하기 전에 다음 질문을 변경 계약과 테스트 케이스에 직접 연결해 보세요.
- 버전 경계: 어떤 버전부터 API·설정·생명주기 계약이 달라졌으며, 근거가 되는 공식 문서와 커밋은 무엇인가?
- 반례: 빈 값, 잘못된 이름, 경계 경로, 중복 이벤트, 종료 직전 호출처럼 “그럴듯한 정상 입력” 바깥의 최소 반례는 무엇인가?
- 관찰: 테스트가 반환값만 보는가, 아니면 실제 파일·호스트 상태·이벤트 순서·타이머·재시작 결과까지 확인하는가?
- 채점: 전체 점수의 분모, 만점 포화 과제, 부분 점수 기준, 사람 검토 표본이 무엇인지 함께 공개했는가?
- 범위: 정적 진단, 패치 생성, 빌드·테스트 통과, 운영 배포 후 관찰 중 어느 단계까지 실제로 수행했는가?
이 질문은 논문에서 측정된 새 체크리스트 효능이 아니라, 관찰된 한계와 반례를 바탕으로 한 실무용 편집 도구입니다. 자체 환경에서 실행하지 않은 테스트는 완료로 표시하지 마세요.
결론: 점수를 계약의 증거로 착각하지 않기
이 연구가 지지하는 결론은 제한적이지만 유용합니다. 이 정적 과제 묶음과 기록된 구성에서 스킬 조건의 원 루브릭 평균은 4.92점 높았습니다. 동시에 점수는 천장에 몰렸고 단일 과제가 큰 비중을 차지했으며, 표적 검토에서는 구체적인 경계·계약 불일치가 드러났습니다. 이는 스킬이 무효라는 증명도, 실제 수정 성공률이 향상됐다는 증명도 아닙니다.
실무자는 평균 점수와 별도로 버전 경계, 반례 입력, 관찰 가능한 런타임 상태를 기록하고, 독립 채점·통합 테스트가 없는 부분을 미검증으로 남길 수 있습니다. 논문 본문과 커밋 고정 저장소 자료를 검토하고 수치 재계산 자료를 대조했지만, 저자 실험을 독립 재현하거나 코드를 실행한 것은 아닙니다. 이 경계까지 공개하는 것이 숫자를 덜 화려하게 만들 수는 있어도, 마이그레이션 판단을 더 정직하게 만듭니다.
출처
- Beiming Liu 외, “Evaluating Agent Skills for Version-Specific Plugin Migration: A Retrospective Study,” arXiv:2609.30120v1, 2026-09-24. §4.1, §5.1–5.3, §7, Appendix A Table 4. https://arxiv.org/html/2609.30120v1
- 연구 저장소의 논문 링크 대상 커밋: acb9b4c3cde0d017ae625b84d358f7c51569a31d. https://github.com/oh-my-dsh/dsh-plugin-upgrade-skill/tree/acb9b4c3cde0d017ae625b84d358f7c51569a31d


댓글
댓글 쓰기