실패 하나마다 고치지 마라: Ecdysis가 에이전트 하네스를 1.84배 빨리 학습한 방법
실패 사례가 많다고 좋은 수정이 나오는 것은 아니다
LLM 에이전트의 성능은 모델만으로 결정되지 않는다. 계획을 세우는 방식, 도구 결과를 문맥에 넣는 규칙, 상태를 다시 확인하는 시점 같은 런타임 하네스가 같은 모델의 행동을 크게 바꾼다. 그래서 최근에는 실패한 작업을 보고 하네스 코드를 자동으로 고치는 연구가 늘었다.
문제는 실패 하나를 곧바로 하네스 결함으로 해석할 때 생긴다. 특정 작업에서 모델이 예약 변경 조건을 놓쳤다고 해서 그 행동을 전역 금지하면 그 사례는 통과할 수 있다. 대신 다른 정상 경로까지 막힐 수 있다. 9월 10일 공개된 Ecdysis 논문은 이 지점을 정면으로 다룬다. 개별 실패에 순서대로 반응하지 않고, 여러 작업에서 반복되는 실패 구조를 한꺼번에 모아 하네스를 고친다.
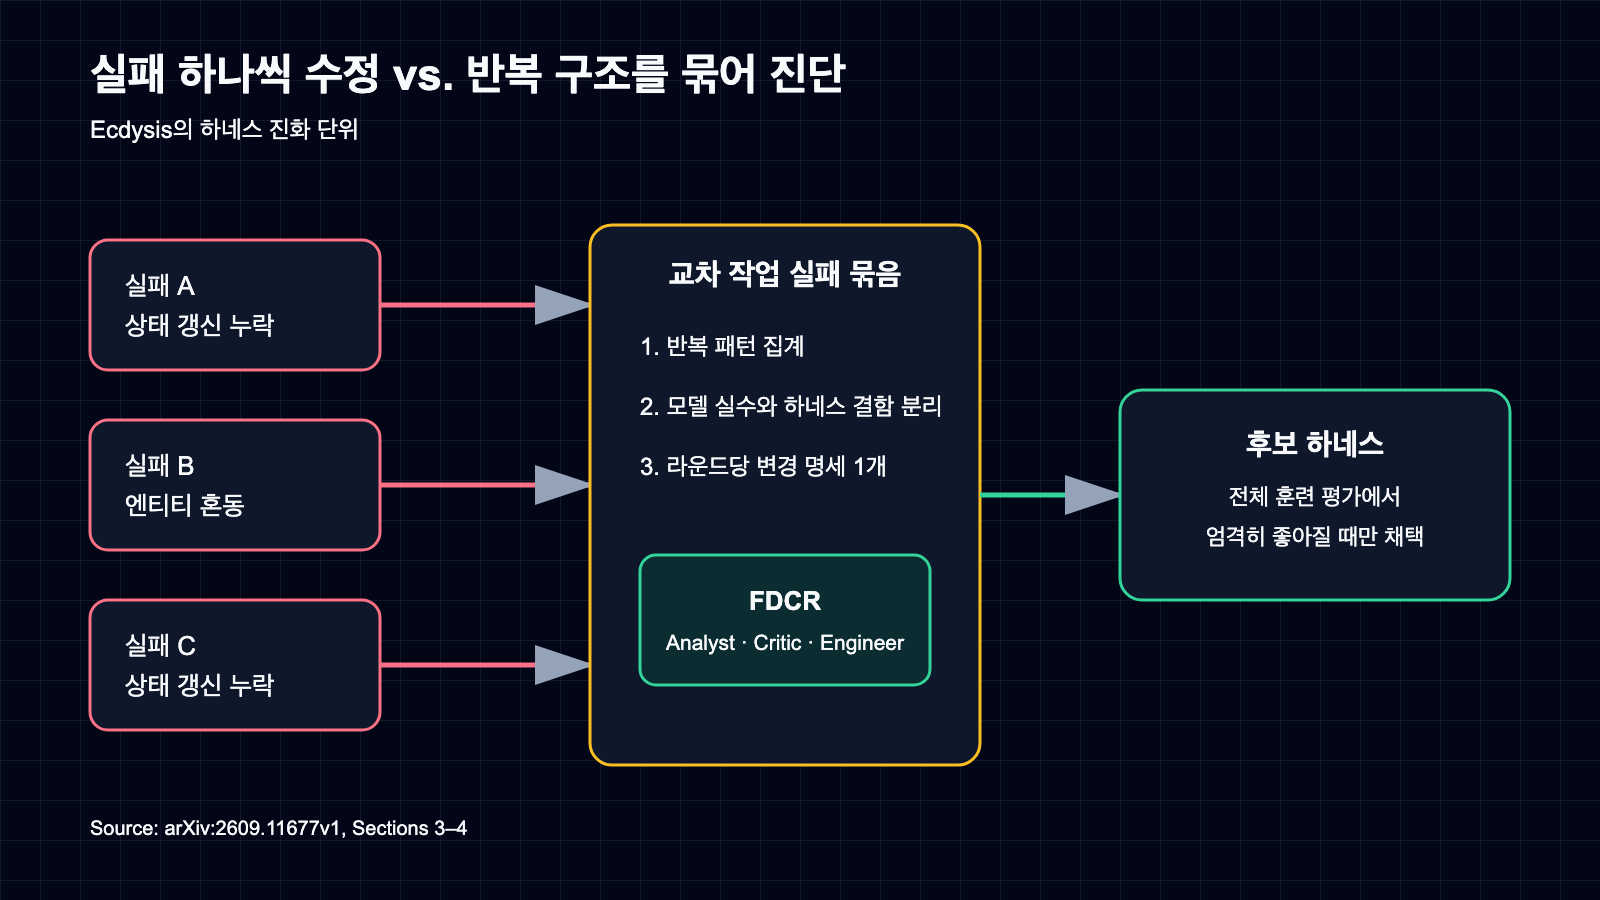
그림 1. Ecdysis는 실패 하나마다 코드를 바꾸지 않고 여러 작업에서 반복되는 구조를 모아 라운드 단위 변경 명세를 만든다. 출처: arxiv.org/html/2609.11677v1#S3.
Ecdysis는 실패를 모으고 역할을 나눠 진단한다
기준선인 Self-Evolution은 실패 기록마다 코딩 에이전트를 호출한다. 각 수정은 한 라운드의 후보에 차례로 누적된다. 호출 횟수가 늘고, 앞선 수정이 뒤의 사례에 맞춰 다시 흔들릴 여지가 있다.
Ecdysis의 기본형은 라운드에서 나온 실패 증거를 한 묶음으로 만든 뒤 수정 계획을 한 번 작성한다. 여기에 FDCR(Failure-Driven Collaborative Refinement)을 붙이면 Analyst, Critic, Engineer가 두 차례 원인을 검토하고 Moderator가 최종 변경 명세를 합친다. 역할 수를 늘리는 것이 목적은 아니다. 여러 작업에서 반복된 상태 동기화, 엔티티 식별, 도구 순서 문제와 특정 모델이 한 번 낸 실수를 갈라내려는 장치다.
실험에서는 모델 파라미터를 고정했고 하네스만 바꿨다. 세 진화 방식은 같은 Human-Augmented 하네스에서 출발했다. 후보는 기존 하네스보다 훈련 점수가 엄격히 좋아질 때만 남겼고, 후보를 만든 궤적이 아니라 다음 전체 평가에서 판정했다. 이 설계 덕분에 결과를 단순한 모델 교체 효과로 읽을 위험은 줄었다.
정확도는 올랐지만 모든 모델과 작업에서 이긴 것은 아니다
논문은 Qwen3-8B로 하네스를 학습한 뒤 Qwen3 8B·14B·32B, MiniMax-M2.7, Llama-3.1-8B에 그대로 적용했다. τ²-Bench의 Airline과 Retail에서 각 테스트 작업 20개를 세 번씩 실행했다. 모델, 데이터셋, 방법 조합마다 60개 held-out 궤적이며, 표의 평균은 다섯 모델과 두 데이터셋 조합을 묶은 값이다.
Self-Evolution의 평균 정확도는 46.67%였다. 실패를 묶기만 한 Ecdysis는 54.67%, FDCR까지 쓴 Ecdysis는 59.33%였다. Pass@3는 63.50%에서 71.50%로, 세 번 모두 성공한 Pass³는 29.00%에서 45.00%로 올랐다. 논문 초록의 "18.56% 향상"은 τ²-Bench만의 절대 상승 폭이 아니다. AgentBench까지 포함해 다섯 모델과 세 데이터셋 평균을 58.67%에서 69.56%로 높인 상대 증가율이다.
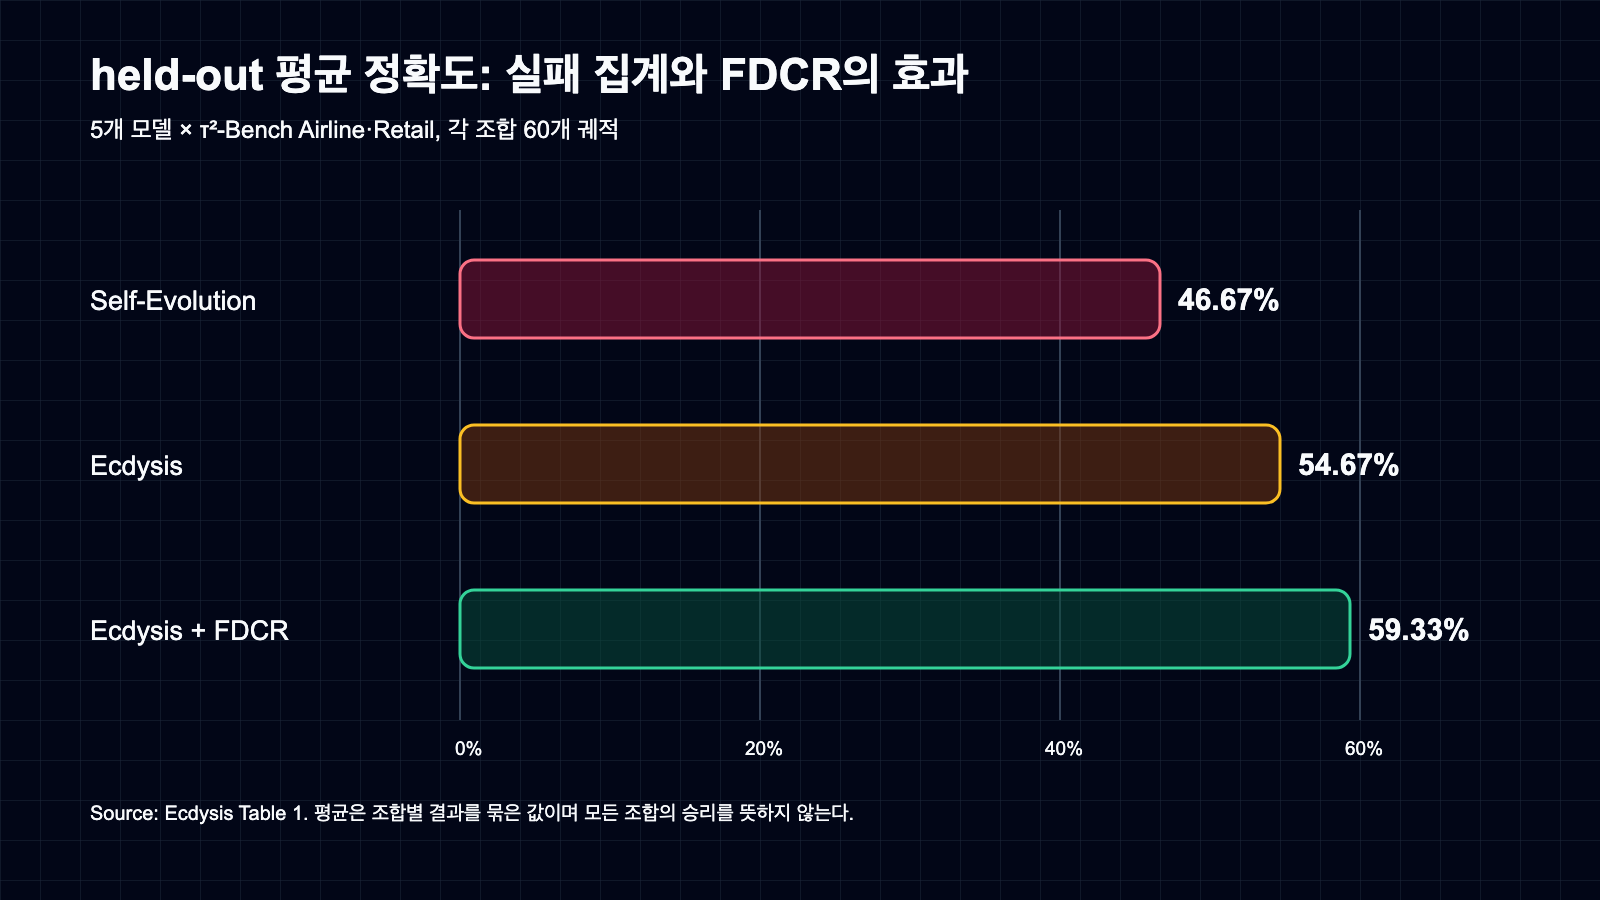
그림 2. 다섯 모델과 두 τ²-Bench 데이터셋의 평균 정확도는 실패 집계와 FDCR를 더할수록 높아졌지만 모든 개별 조합에서 이긴 것은 아니다. 출처: arxiv.org/html/2609.11677v1#S5.T1.
결과가 한 방향으로만 움직인 것은 아니다. MiniMax-M2.7의 Retail에서는 FDCR 없는 Ecdysis가 100%였지만 FDCR 버전은 96.67%였다. Llama-3.1-8B Retail은 10.00%에서 11.67%로 차이가 작았다. 평균이 좋아졌다는 말과 모든 조합에서 좋아졌다는 말은 다르다.
속도 이득의 핵심은 협업보다 묶음 처리였다
훈련 시간은 더 선명하다. Retail에서 Self-Evolution은 1,831.4초가 걸렸고 Ecdysis 기본형은 1,292.4초, FDCR형은 1,405.9초였다. Airline에서는 8,120.6초가 2,510.8초와 4,403.0초로 줄었다. 논문이 제시한 최대 1.84배 속도 향상은 Airline에서 Self-Evolution과 FDCR형을 비교한 값이다. 실패를 묶기만 한 기본형은 같은 조건에서 3.23배 빨랐다.
API 비용도 같은 패턴을 보였다. Airline에서 Self-Evolution은 6.382달러, 기본형은 2.136달러, FDCR형은 2.609달러였다. Retail에서는 각각 8.484달러, 2.485달러, 5.763달러였다. 여러 역할이 추가된 FDCR는 정확도를 더 얻는 대신 기본형보다 시간과 비용을 더 쓴다. "협업 에이전트가 싸다"가 아니라 "반복 수정 호출을 줄인 묶음 진단이 싸고, 협업 진단은 그 절감분 일부를 정확도에 다시 쓴다"가 맞는 해석이다.
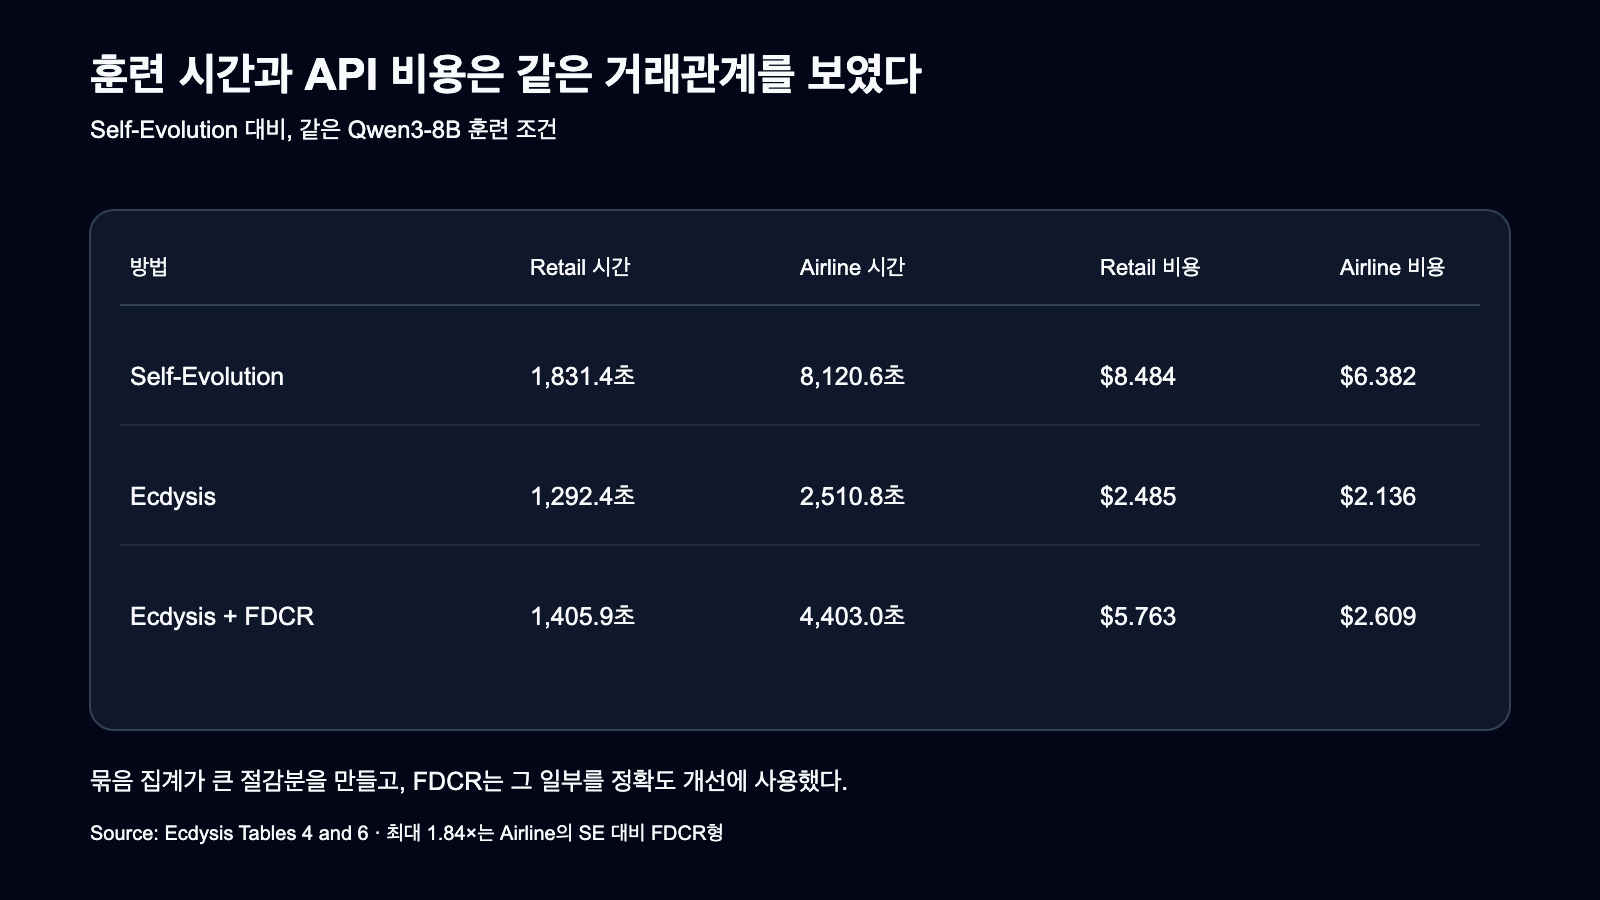
그림 3. 실패 묶음 집계가 훈련 시간과 API 비용의 큰 절감분을 만들고 FDCR는 그 일부를 정확도 개선에 다시 사용했다. 출처: arxiv.org/html/2609.11677v1#S5.SS3.
held-out 추론에서도 평균 토큰 사용량은 Self-Evolution 11.57M에서 기본형 10.35M, FDCR형 10.16M으로 줄었다. 다만 개별 조합의 실행 시간과 토큰은 들쭉날쭉했다. 논문도 실행 시간이 모델 서비스 지연과 궤적 길이를 함께 반영한다고 적었다. 한 숫자를 실제 운영 비용에 그대로 대입하면 안 된다.
실무에서는 실패 수보다 실패 구조를 먼저 세자
이 연구에서 바로 가져올 수 있는 아이디어는 자동 코드 수정이 아니라 변경 단위다. 운영 에이전트가 실패할 때마다 프롬프트나 도구 규칙을 고치기 전에, 일정 기간의 실패를 상태 동기화, 모호한 엔티티, 선행 조건 누락, 도구 호출 순서처럼 구조별로 묶어 보는 편이 낫다. 한 번만 나타난 모델 실수와 여러 작업에서 되풀이된 하네스 결함을 같은 우선순위로 다루지 않는 것이다.
변경 승인 규칙도 중요하다. Ecdysis는 새 후보가 이전 하네스보다 전체 훈련 평가에서 엄격히 좋아질 때만 채택했다. 실제 시스템에서는 성공률 하나만 볼 수 없다. 비용, 지연, 위험한 도구 호출, 사용자 확인 누락을 함께 회귀 검사해야 한다. 특정 실패를 없애려다 정상 행동 공간을 줄였는지도 별도로 확인해야 한다.
공개 저장소에는 일반 훈련 알고리즘, FDCR 구현, 산출물 스키마와 합성 테스트가 있다. 반면 논문 실험의 작업별 자산과 로컬 실행 파일은 저장소 밖에 있다고 README가 밝힌다. 따라서 저장소 공개는 방법 수준 재현에 도움을 주지만, 논문의 모든 수치를 독립 재실행할 수 있다는 뜻은 아니다. 이번 글도 공개 논문 표와 공식 저장소 구조를 대조한 분석이며 모델 API 실험을 다시 돌리지는 않았다.
Ecdysis가 보여 준 결론은 단순하다. 실패를 더 빨리 고치는 것보다, 무엇을 고칠 실패인지 먼저 분류하는 편이 낫다. 에이전트 운영에서 로그 수집 다음 단계는 자동 패치 버튼이 아니라 반복되는 실패 구조를 찾는 일이다.


댓글
댓글 쓰기