KV 캐시에서 지운 토큰이 메모리를 돌려주지 못하는 이유: vToken의 블록 회수
LLM 서버에서 긴 요청을 동시에 처리하다 보면 모델 가중치보다 생성 중 쌓이는 KV 캐시가 먼저 병목이 될 수 있다. 토큰 일부를 제거하는 정책을 적용해도 GPU의 가용 블록 수가 늘지 않는다면 어디를 봐야 할까? vToken 논문은 토큰이 논리적으로 사라지는 일과 그 토큰이 차지했던 물리 블록을 다른 요청에 재할당하는 일을 분리한다. 이 글은 논문 v1의 설계와 수치를 실제 적용 판단에 쓰기 위한 해설이며, 저자의 시스템을 독립 재현한 성능 보고가 아니다.
토큰은 지웠는데 블록은 왜 남아 있나
PagedAttention 계열은 KV 캐시를 고정 크기 블록으로 관리한다. 토큰 제거 정책이 블록 가운데 몇 토큰만 지우면, 살아 있는 토큰 하나 때문에 블록 전체가 여전히 할당 상태다. 따라서 논리적으로 사용하지 않는 슬롯이 생겨도 다른 요청에 쓸 수 있는 블록으로 곧장 돌아오지 않는다. 논문은 동일한 토큰 제거 결정을 적용하면서 물리 회수 백엔드만 끈 Naive-Evict를 비교 대상으로 삼는다. 기본 vLLM은 토큰 제거 자체를 하지 않는 별도 기준이므로, 이 세 가지를 섞어 비교하면 효과의 원인을 잘못 읽게 된다.
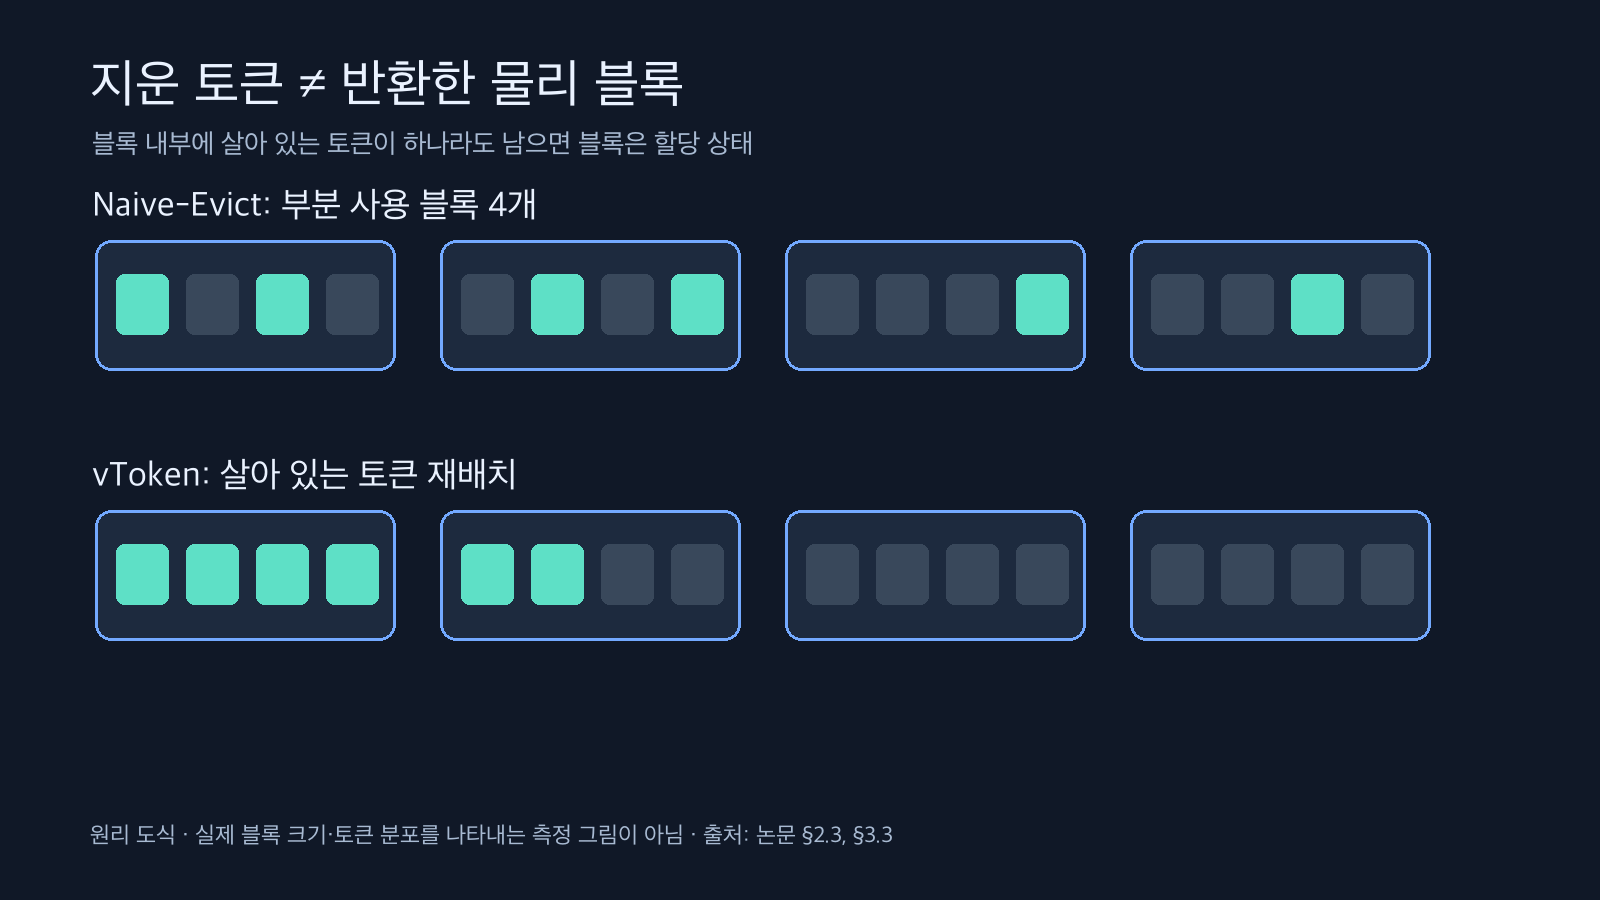
그림 1. 논리적 제거와 물리 블록 반환의 차이. 토큰 분포는 설명용이며 실제 실험 데이터가 아니다. 출처: arxiv.org/pdf/2608.13263.
논리 주소와 물리 주소 사이에 무엇을 두었나
vToken은 요청별 토큰 테이블에 논리 토큰 ID, 현재 블록·오프셋, 생존 상태를 기록한다. 제거 정책은 evict_token으로 더 이상 필요하지 않은 토큰을 표시한다. 이때 즉시 GPU 메모리를 반환했다고 가정하면 안 된다. 회수 관리자는 살아 있는 토큰을 다른 블록에 모을 이득과 임시 목적지 공간을 먼저 계산하고, 비동기 복사 완료 후 위치 매핑을 바꾸며 빈 블록을 반환한다. 다음 attention이 옮겨진 데이터를 읽기 전에 CUDA 이벤트로 의존성을 맺는다. 저자 구현은 vLLM v0.18.0, PyTorch v2.10.0 위에서 블록 관리와 attention 커널의 기본 구조를 유지한다.
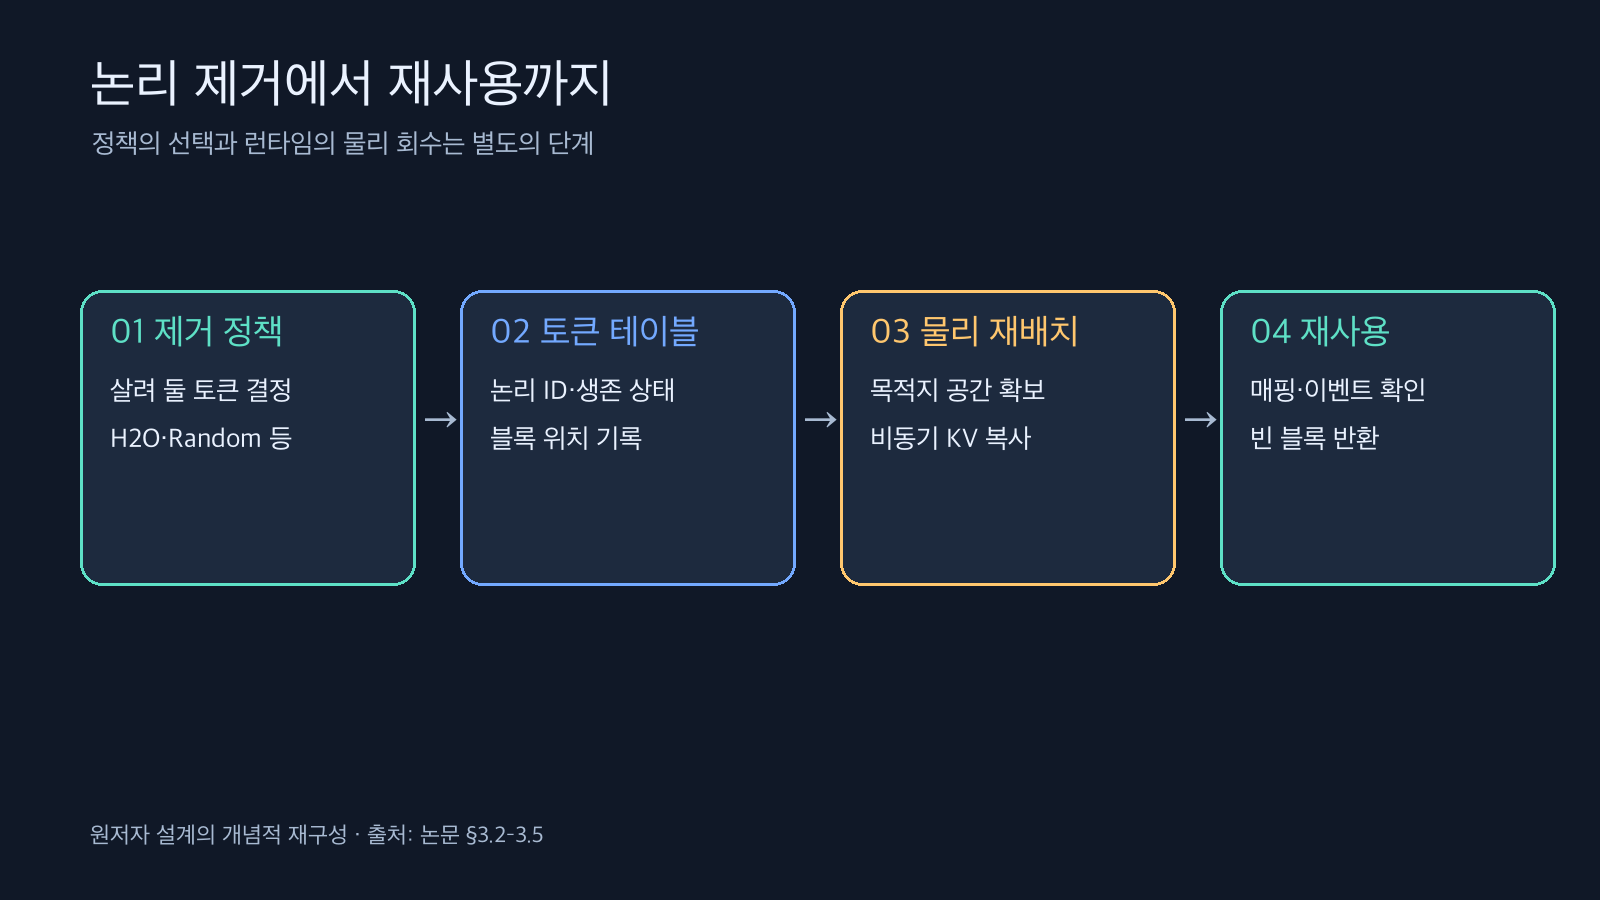
그림 2. 정책과 런타임 회수 책임을 분리한 vToken 설계의 개념적 재구성. 출처: arxiv.org/pdf/2608.13263.
72.3%와 1.37배는 서로 다른 지표다
논문 §5.1–5.3의 단일 NVIDIA H100 80GB 실험에서는 Mistral-7B와 Llama-3.1-8B, ShareGPT·LongBench, H2O·Random·Scissorhands 등의 조합을 다뤘다. Naive-Evict와 같은 프롬프트·디코딩 설정·제거 정책·메모리 예산을 맞춘 비교에서 요청당 유지된 KV 블록 수가 27.2–72.3% 감소했다고 보고한다. 이는 GPU 전체 메모리 사용량이 언제나 72.3% 감소한다는 뜻이 아니다. SLA 제약을 둔 처리량 개선은 논문 초록에서 최대 1.37배로 기술한다. p95 지연 기준은 기준 동시성 8에서의 Naive-Evict p95에 5% 여유를 더한 값이며, 가능한 동시성 중 처리량이 가장 높은 지점을 고른다. 초록의 수치와 본문에 나오는 개별 정책·실험 조합의 수치를 하나의 보편적 보장으로 합쳐서는 안 된다.
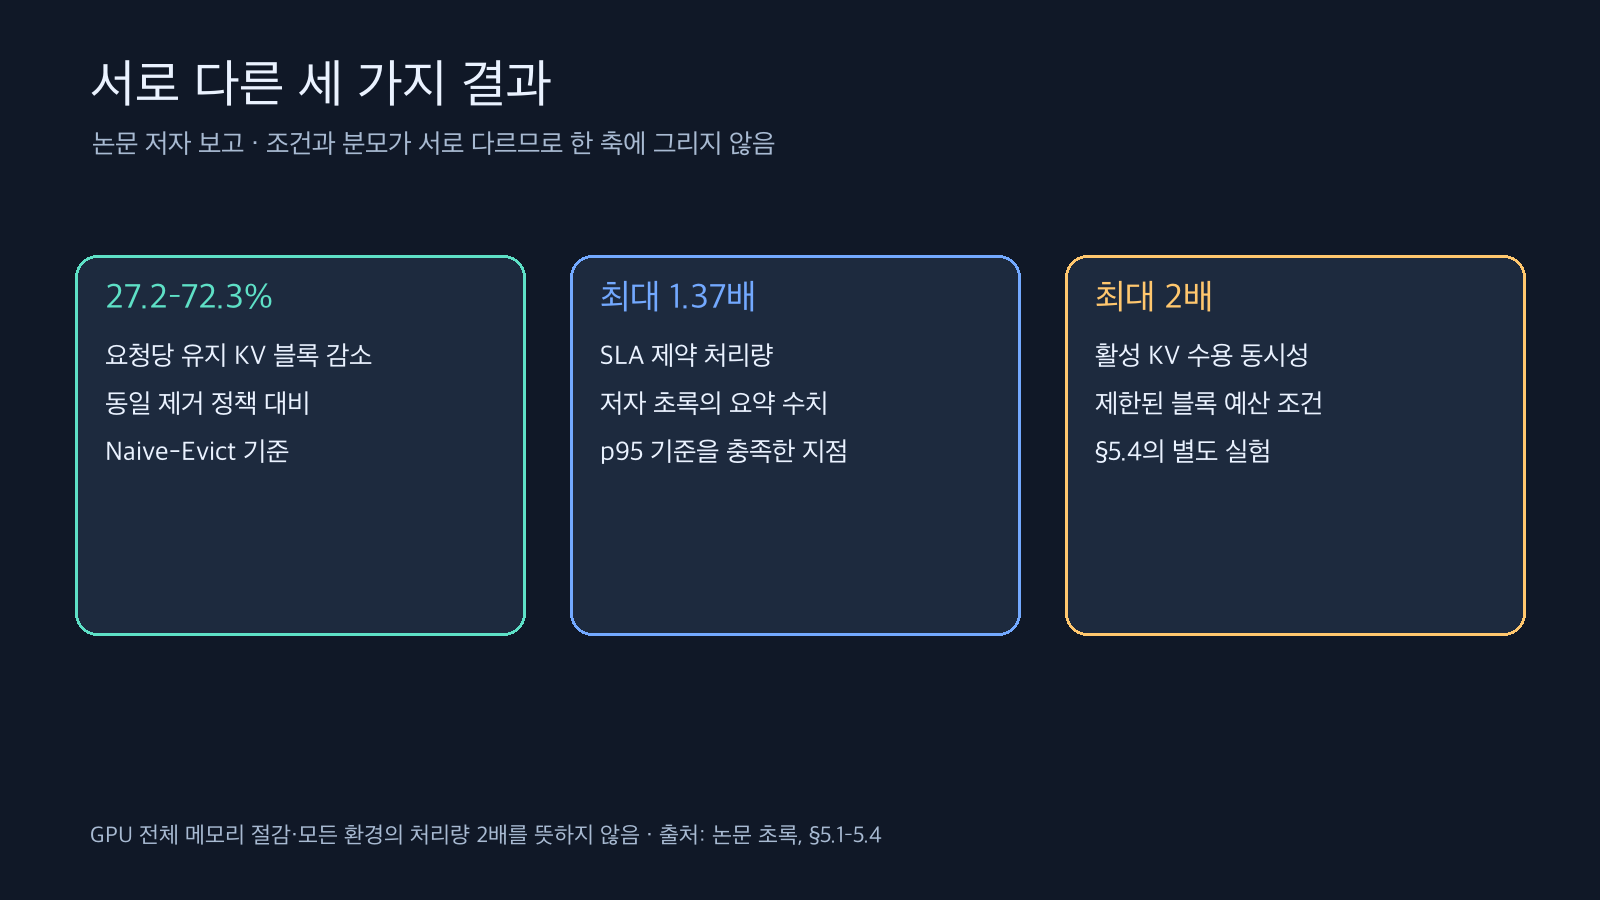
그림 3. 세 수치는 서로 다른 분모와 실험 조건을 가지며 공통 비율 축으로 비교하지 않는다. 출처: arxiv.org/pdf/2608.13263.
동시성 2배는 어떤 압박 조건에서 나왔나
별도 §5.4의 수용량 경계 실험은 Llama-3.1-8B, LongBench, H2O, 통제된 활성 KV 블록 예산을 사용한다. gpu_mem_util=0.35에서는 Native vLLM과 Naive-Evict가 동시 요청 5개까지, vToken은 8개까지 가능한 것으로 검증했다. gpu_mem_util=0.50에서는 각각 11개와 22개로, 이 조건에서 최대 가능 동시성이 2배다. Qwen2.5-14B의 별도 확인도 3개에서 6개로 보고한다. 이는 무제한 일반 서비스에서 항상 동시성이 2배이거나 처리량이 2배라는 뜻이 아니다. 최대 가능 동시성은 주어진 활성 KV 예산에서 요청들이 메모리에 들어가는 경계이고, SLA 제약 처리량은 지연 기준을 충족하며 처리한 토큰 속도다.
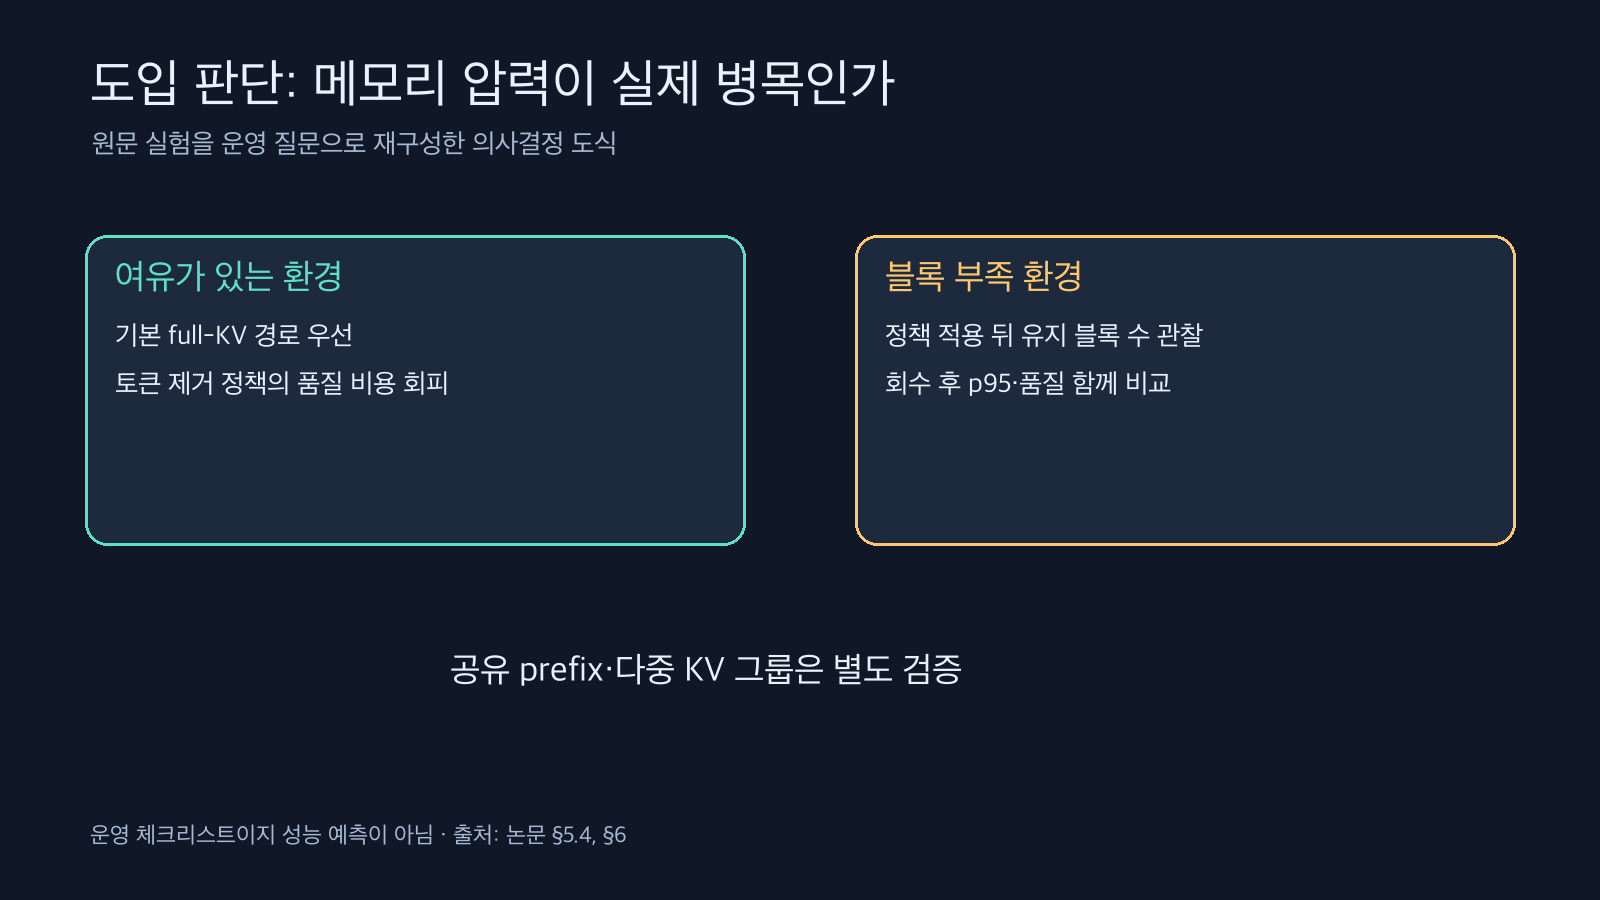
그림 4. 저압 구간과 메모리 압박 구간을 구별한 운영 판단. 성능 보장표가 아니다. 출처: arxiv.org/pdf/2608.13263.
운영자가 점검할 적용 판단표
판단 기준은 토큰을 지웠는가가 아니라 비워진 물리 블록을 다시 할당할 수 있는가다.
| 관찰 | 먼저 확인할 증거 | 해석과 다음 선택 |
|---|---|---|
| KV 블록 여유가 충분하다 | 활성 요청·가용 블록·지연 | 기본 full-KV 경로를 유지한다. 논문도 저압 구간에서는 기본 경로를 선호한다. |
| 제거 뒤에도 할당 블록이 줄지 않는다 | 블록별 살아 있는 토큰 분포·요청당 유지 블록 | 논리적 제거만 일어났는지, 물리 회수와 목적지 공간이 있는지 확인한다. |
| 회수 중 지연이 커진다 | p95, 복사·계획 시간, GPU 간섭 | 회수 빈도와 비동기 복사 시점을 함께 본다. 블록 절약만으로 성공을 판단하지 않는다. |
| 공유 접두부/여러 KV 그룹을 쓴다 | prefix 공유·캐시 그룹 구조 | 현 구현의 적용 범위 밖을 식별하고 별도 검증 없이 이식하지 않는다. |
이 표는 논문의 단일 GPU·단일 KV 그룹 실험을 운영 점검 질문으로 재구성한 것이며, 다른 서비스의 성능을 예측하지 않는다.
성능 수치보다 먼저 봐야 할 한계
논문 §6에 따르면 현재 구현은 하나의 runtime KV 그룹을 대상으로 하며, prefix cache가 공유하는 블록은 보수적으로 회수 대상에서 제외한다. 다중 GPU나 다른 커널·스케줄러, 실제 서비스의 품질 손실을 검증했다고 볼 수 없다. 토큰 제거 정책 자체가 어떤 문맥을 버려도 되는지 결정하며, vToken은 그 정책의 정확도를 보증하지 않는다. 저자들은 같은 제거 결정을 적용한 144개 대응 생성에서 추가적인 출력 차이를 점검했지만, 이는 모든 과제의 정답 품질 증명이 아니다. 회수에는 목적지 블록과 계획 비용도 든다. 따라서 적용 전에 기준 경로·정책·메모리 예산·지연 SLA를 고정하고, 요청당 유지 블록과 p95 및 출력 품질을 각각 확인해야 한다.
참고 자료
이 글은 공개 논문과 공식 vLLM 문서를 바탕으로 AI 도구를 사용해 작성한 독립적인 설명과 판단표다. 제품 사용 후기나 저자 실험의 독립 재현이 아니다.


댓글
댓글 쓰기