싼 모델로 넘겼는데 더 비싸졌다: 코딩 에이전트 라우팅의 KV 캐시 함정
코딩 에이전트의 비용을 줄이려면 쉬운 작업을 싼 모델에 맡기면 된다고 생각하기 쉽습니다. 그런데 긴 대화와 파일 기록을 넘기고, 결과를 다시 큰 모델이 읽어야 한다면 모델 단가 차이보다 문맥 재처리 비용이 더 커질 수 있습니다.
이번에 검토한 Jev Engineering for Coding Agents는 논문이 아니라 2026년 9월에 독립 편집된 작업 노트입니다. TypeSafe 창업자의 설계 메모를 바탕으로 했지만 TypeSafe가 발행하거나 보증한 문서는 아닙니다. 그래서 이 글은 노트의 아키텍처를 사실처럼 받아들이지 않고, 공개된 식을 다시 계산하고 공식 TypeSafe 문서와 FastContext 논문으로 범위를 대조합니다.
모델이 아니라 문맥을 어디서 다시 읽는가
작업 노트가 던지는 질문은 단순합니다. KV 캐시가 없다면 코딩 에이전트를 어떻게 설계할 것인가. 지금의 에이전트는 대화를 뒤에 계속 붙입니다. 앞부분의 캐시를 재사용하면 싸지만, 중간을 바꾸거나 다른 모델로 넘기면 긴 문맥을 다시 처리해야 합니다.
노트의 대안은 상태와 문맥을 분리하는 것입니다. 도구 호출, 파일, 테스트 로그, 계획을 주소 가능한 chunk로 저장하고, 매 턴 현재 질문에 필요한 길이만 골라 모델 앞에 놓습니다. TypeSafe 공식 문서는 Jev를 코드를 쓰는 생성 모델이 아니라, typed question과 state를 받아 choice·score·noul 같은 구조화된 결과와 확률을 반환하는 System One 모델로 설명합니다. 즉, 아래 구조는 현재 제품의 완성 기능 목록이 아니라 이 primitive를 코딩 에이전트 하네스에 적용한 설계 제안입니다.
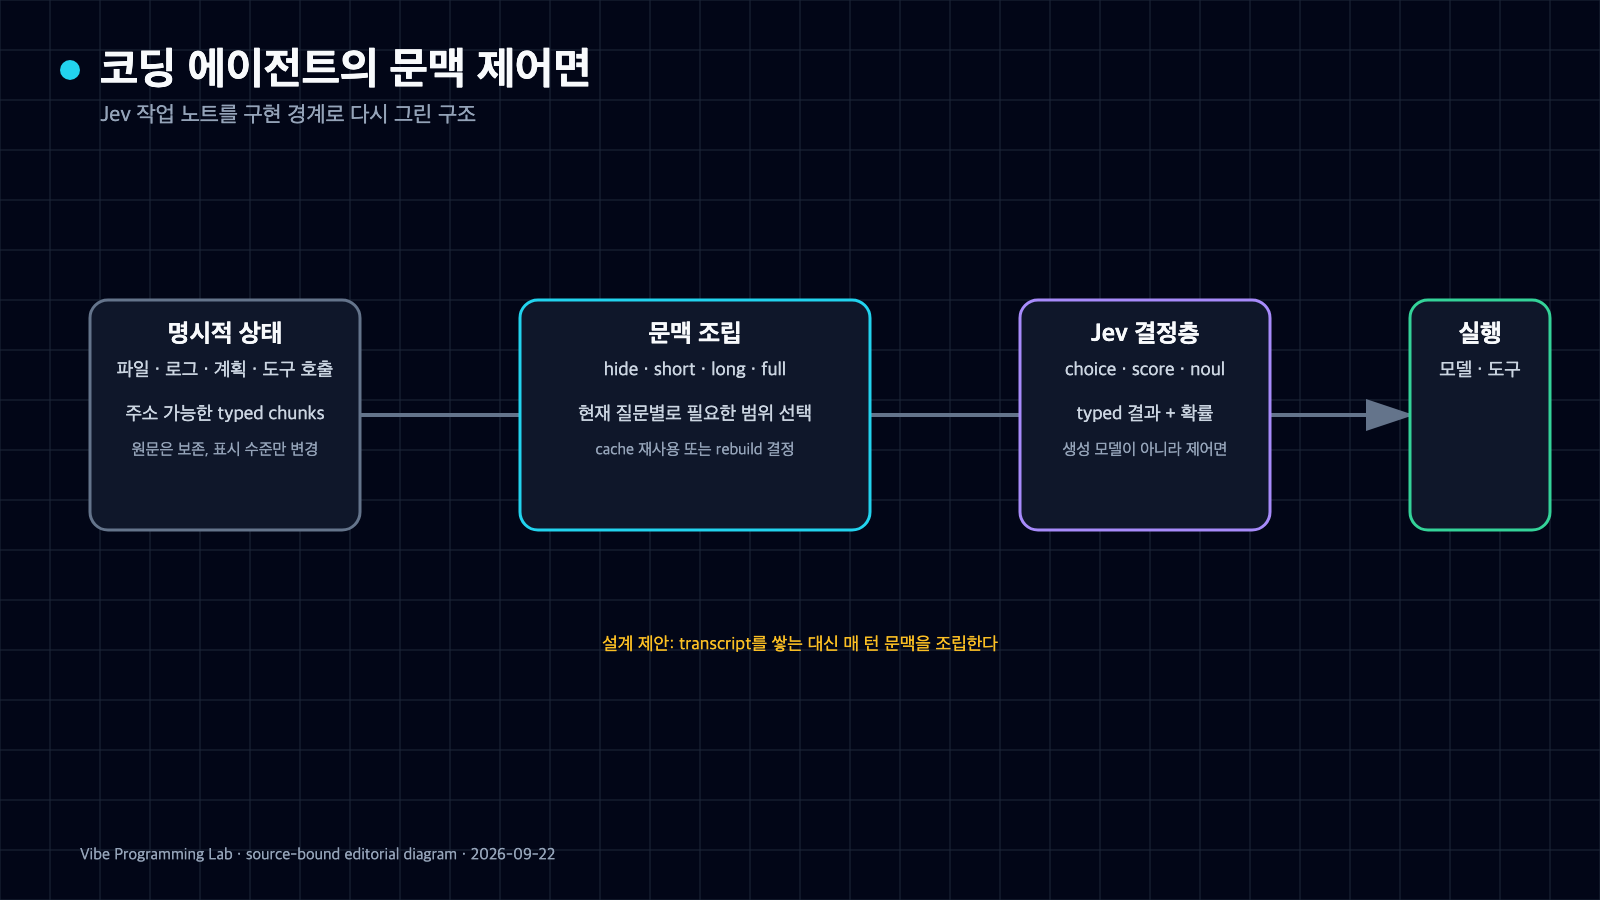
그림 1. 작업 노트의 제안은 transcript 누적 대신 질문마다 문맥을 조립하고 Jev가 구조화된 제어 결정을 내리게 한다. 현재 제품 기능이 아니라 제안 구조다. 출처: drive.google.com/file/d/17h982xvsL3E7b80iGmOCfKp9qTOW9ohv/view.
라우팅 비용을 직접 계산해 보기
작업 노트는 Opus의 예시 입력·출력 단가를 각각 5와 25, Sonnet은 3과 15로 놓습니다. 여기서 X는 이미 쌓인 문맥, Y는 새로 생성하는 출력, Z는 파일·명령 출력처럼 추가로 읽는 토큰 비율입니다.
- 큰 모델만 쓰는 경로:
25Y + 5Z - 작은 모델로 넘겼다가 돌아오는 경로:
3X + 20Y + 8Z
예시값 X=0.65, Y=0.12, Z=0.23을 넣어 Python 3.11.14 on macOS 환경에서 다시 계산하면 다음과 같습니다.
pure_opus = 25*Y + 5*Z = 4.15
라우팅 경로는 6.19입니다. 이 가정에서는 작은 모델을 섞은 쪽이 약 49.2% 더 비쌉니다. 작은 모델이 비싸서가 아닙니다. 내려갈 때 X를 읽고, 돌아올 때 Y와 Z 일부를 큰 모델이 다시 읽기 때문입니다.
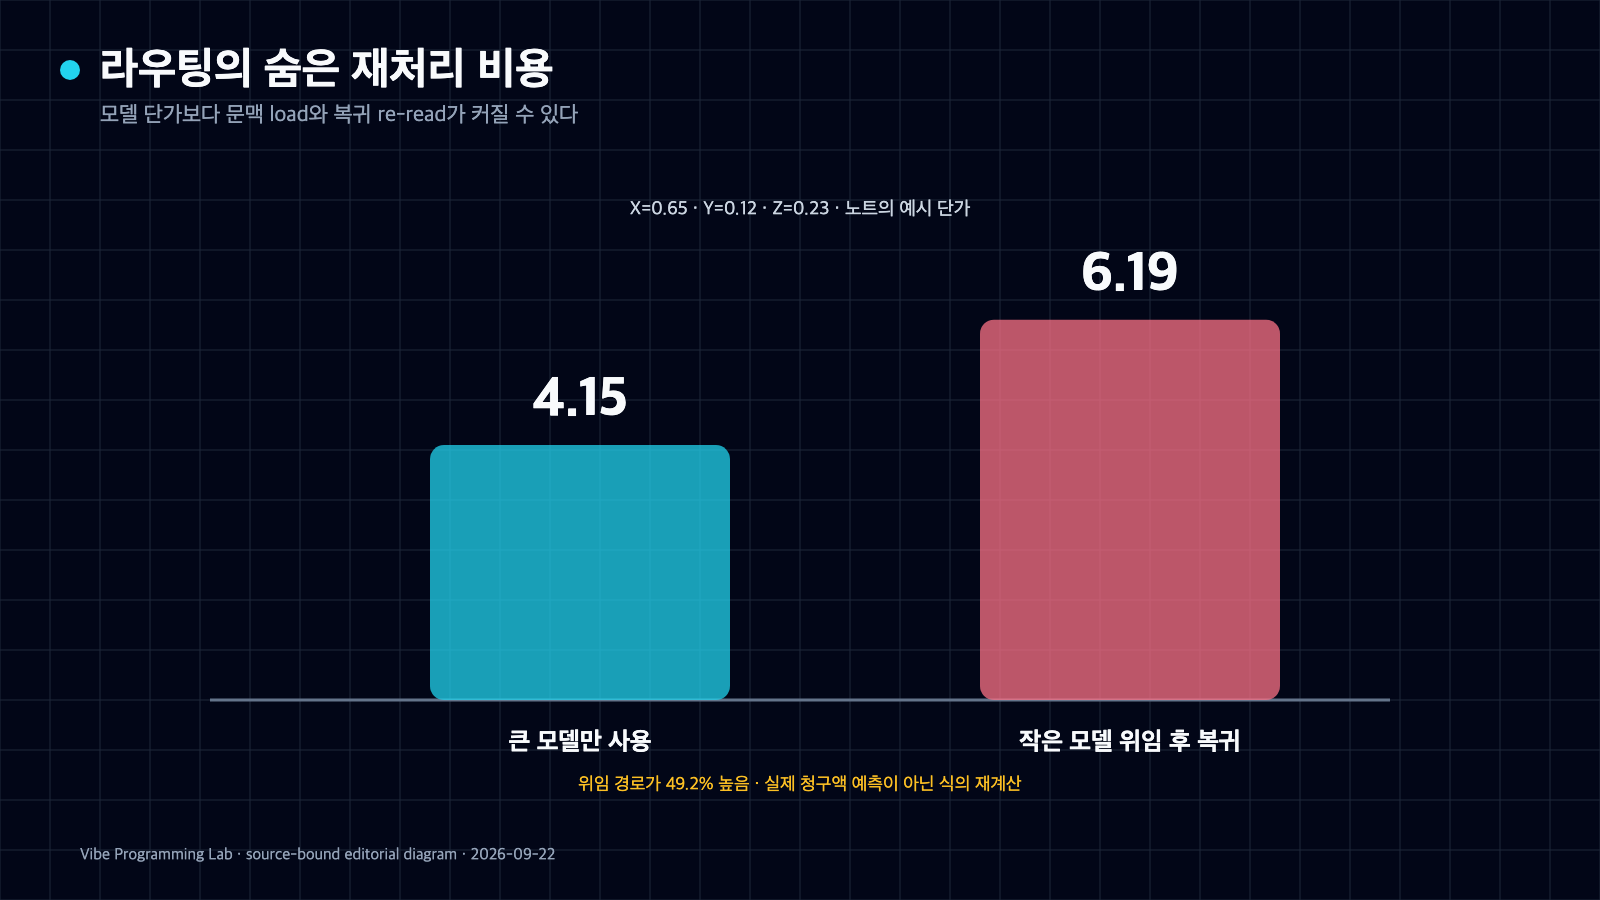
그림 2. 노트의 예시 단가와 세션 비율을 재계산하면 위임 후 복귀 경로가 49.2% 높다. 실제 청구액 예측은 아니다. 출처: drive.google.com/file/d/17h982xvsL3E7b80iGmOCfKp9qTOW9ohv/view.
계산의 제한
이 계산은 작업 노트의 가상 단가와 예시 세션 비율을 다시 계산한 것이며, 실제 청구액이나 Jev의 성능 측정이 아닙니다. 제공사 가격, 캐시 할인, 비동기 배치, 프롬프트 구조가 바뀌면 결과도 달라집니다. 다만 "싼 모델을 썼다"와 "전체 경로가 싸졌다"가 같은 말은 아니라는 점은 분명합니다.
재계산 실행 영수증
Python 3.11.14 on macOS에서 X=0.65, Y=0.12, Z=0.23을 넣어 실행했습니다. 출력 핵심은 pure_opus=4.15, routed=6.19, ratio=1.492이며, 로그는 evidence/routing-calculation.txt에 보존했습니다. 로그 SHA-256은 0a24a949994b4b3bcce638956bb932b3724c995d8e51118586b8dd17b7b542dd입니다.
30초 라우팅 판단표
따라서 라우팅 판단표에는 모델 단가뿐 아니라 내려보낼 문맥 X, 생성량 Y, 도구 출력 Z, 그리고 복귀 때 다시 읽힐 범위를 함께 적어야 합니다.
| 질문 | 예라면 | 아니라면 |
|---|---|---|
| 하위 작업에 필요한 문맥을 작은 묶음으로 만들 수 있는가 | 위임 후보 | 큰 모델에서 계속 처리 |
| 결과를 구조화된 짧은 chunk로 합칠 수 있는가 | 복귀 비용 낮음 | 긴 transcript 재처리 위험 |
| 파일 민감도상 다른 제공사로 보낼 수 있는가 | 비용·속도 비교 | 허용된 제공사만 사용 |
| 같은 목표가 이미 실행 중인가 | 기존 작업 재사용 | 새 작업 등록 |
| 새 모델의 실패를 같은 ID로 복구할 수 있는가 | 자동화 가능 | 사람 확인 후 재개 |
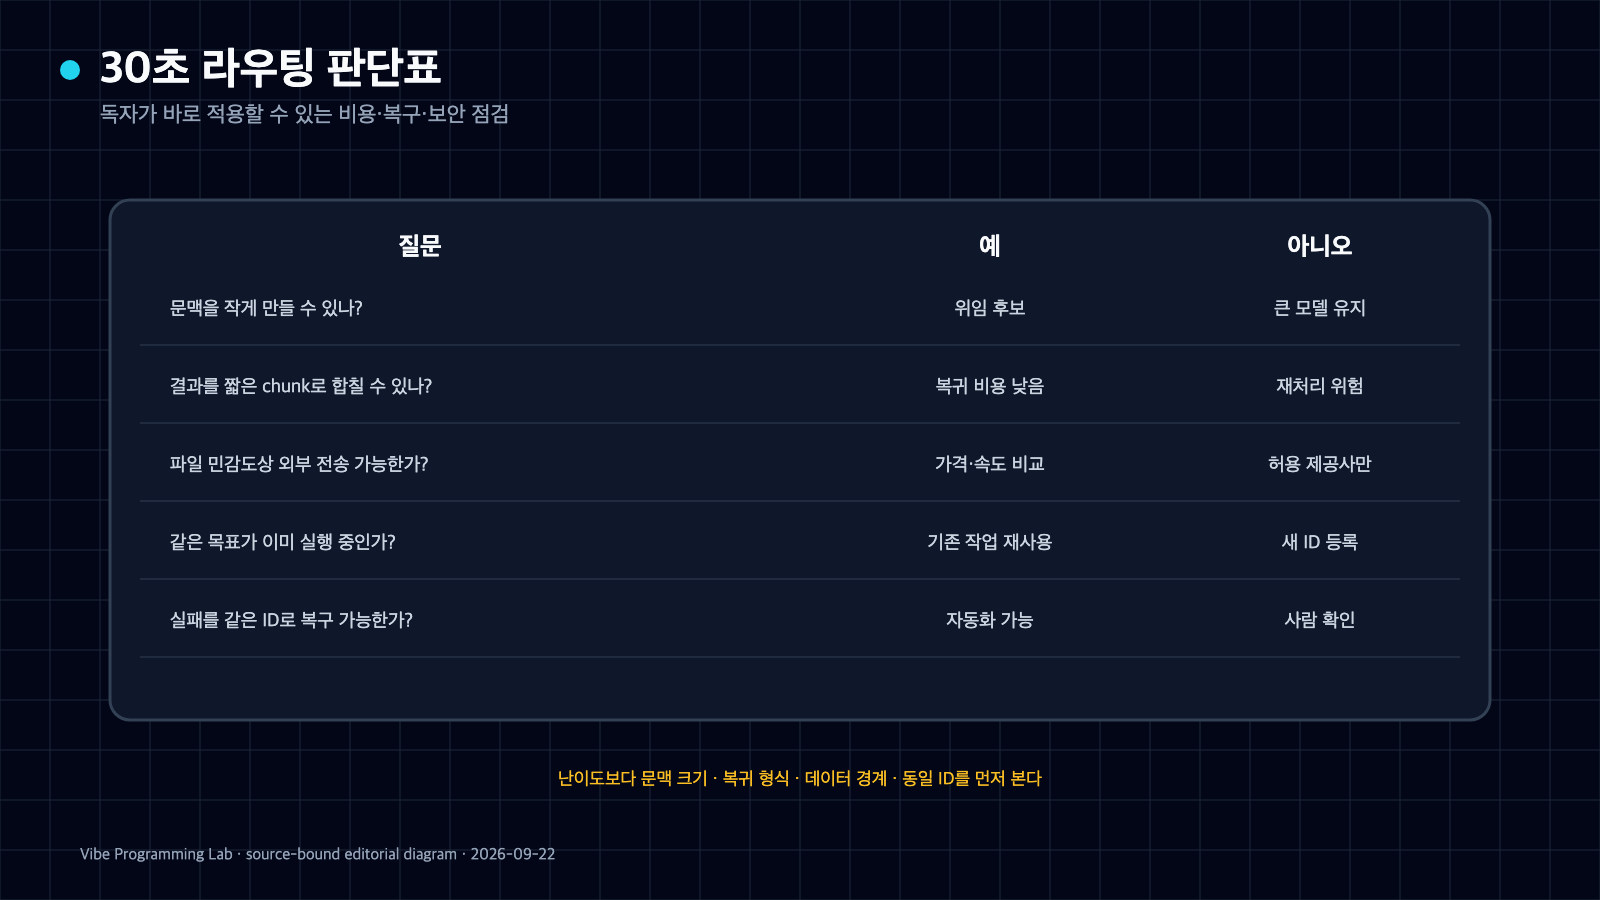
그림 3. 모델 난이도보다 문맥 크기, 복귀 형식, 데이터 경계와 동일 ID 복구 가능성을 먼저 확인하는 편집자 판단표. 출처: drive.google.com/file/d/17h982xvsL3E7b80iGmOCfKp9qTOW9ohv/view.
이 표의 핵심은 난이도보다 경계를 먼저 보는 데 있습니다. 짧은 독립 조사나 read-only 검사처럼 입력과 출력이 작으면 저렴한 모델이 잘 맞습니다. 반대로 전체 저장소와 긴 실패 로그를 넘기고 결과까지 통째로 되가져오면 단가 이점이 사라질 수 있습니다.
검색과 읽기가 먼저 줄어야 한다
작업 노트의 token-share 표는 설명용 추정치입니다. 하지만 방향은 FastContext의 실제 측정과 맞습니다. FastContext 연구진은 SWE-bench Multilingual의 GPT-5.4-high 실행 300개를 분석했습니다. 읽기와 검색은 평균 tool-use turn 17.72회 중 9.96회, 즉 56.2%였고, main agent 전체 토큰의 46.5%를 썼습니다.
이 값은 모든 코딩 에이전트로 일반화할 수 없습니다. 특정 모델, 하네스, 벤치마크의 측정입니다. 그래도 최적화 순서는 제시합니다. 먼저 반복 파일 읽기, 넓은 grep 결과, 실패 로그를 줄이고, 그다음 모델 라우팅을 계산해야 합니다. 검색 비용을 그대로 둔 채 모델 이름만 바꾸면 긴 문맥을 싼 모델과 비싼 모델이 번갈아 읽을 뿐입니다.
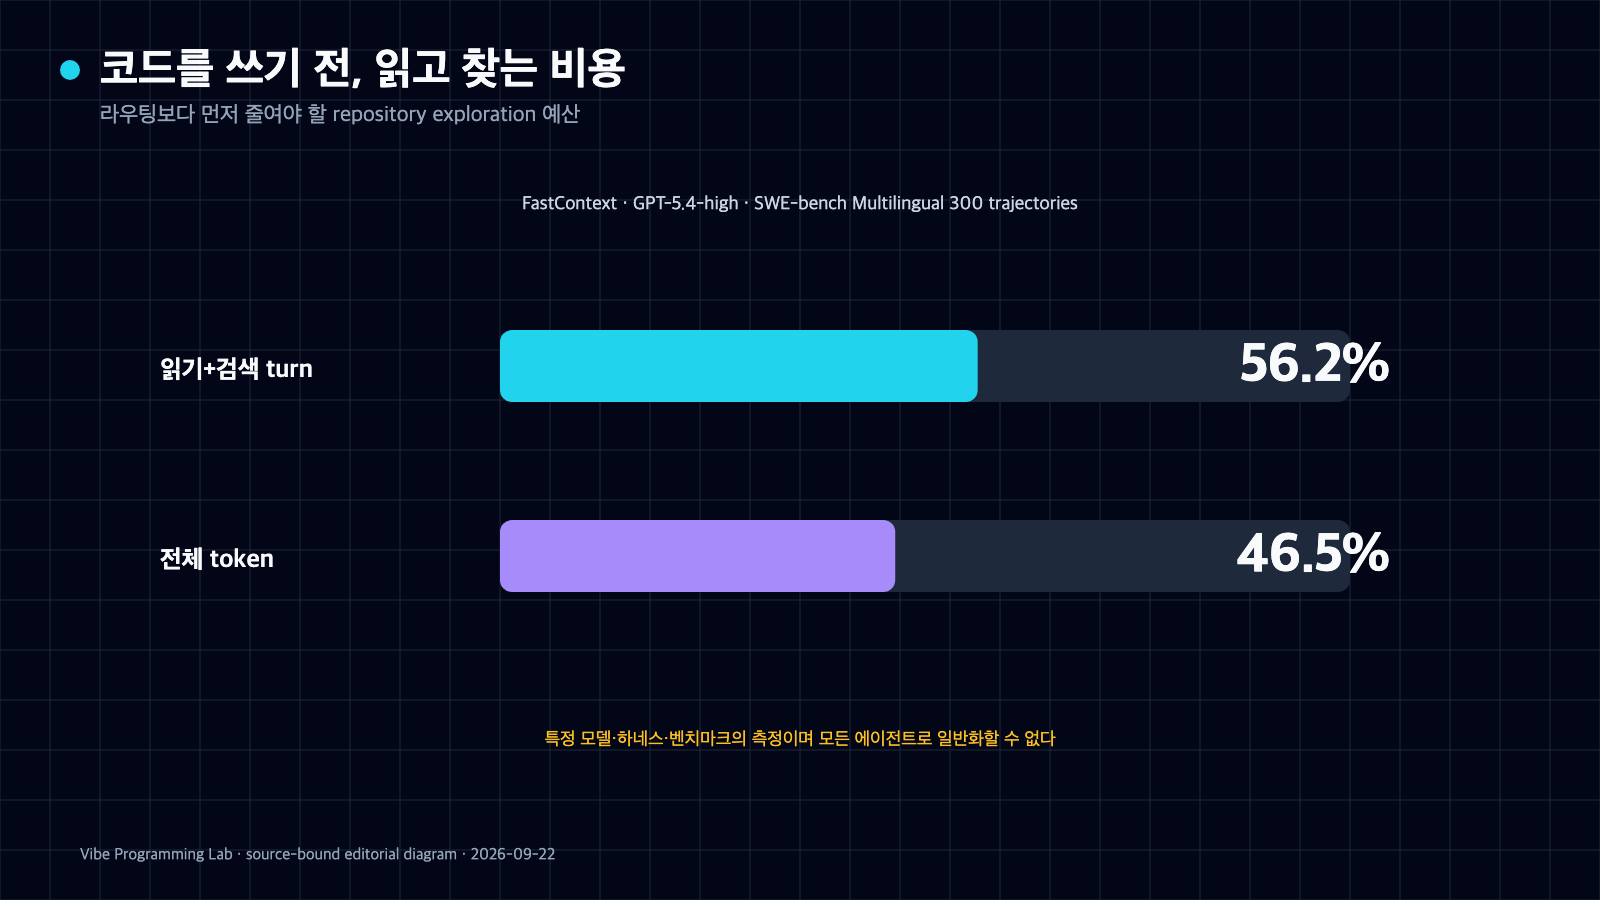
그림 4. FastContext 측정에서 읽기와 검색은 tool-use turn의 56.2%, main-agent token의 46.5%였다. 특정 모델·하네스·벤치마크의 결과다. 출처: arxiv.org/html/2606.14066v1.
구현할 때 지켜야 할 세 가지 경계
첫째, 상태를 지우지 말고 표시 수준을 바꿉니다. 2,400줄 grep 결과가 이번 질문에는 12개 hit만 필요할 수 있고 다음 질문에는 아예 필요 없을 수 있습니다. 삭제 대신 hide / short / long / full 같은 수준을 고르면 다른 질문에서 원문을 다시 찾을 수 있습니다.
둘째, 도구는 한꺼번에 모두 노출하지 않습니다. 짧은 capability 목록을 먼저 보여 주고, 선택된 몇 개의 schema와 문서만 뒤늦게 붙입니다. 이것은 도구를 숨기는 전략이 아니라 불필요한 schema를 매 턴 다시 읽지 않게 하는 전략입니다.
셋째, 보안 정책을 난이도와 분리합니다. 공개 문서 읽기는 저렴한 모델로 보낼 수 있어도 .env, 인프라 설정, 비공개 연구 코드는 허용된 제공사 안에서만 처리해야 합니다. 비용 최적화가 데이터 경계를 우회하는 이유가 되어서는 안 됩니다.
결론
코딩 에이전트의 라우팅은 "쉬운 일은 싼 모델"이라는 한 줄 규칙으로 끝나지 않습니다. 작은 문맥을 만들어 넘길 수 있고, 결과를 짧은 구조로 되돌릴 수 있을 때만 위임의 단가 이점이 살아납니다.
실무에서는 모델 가격표보다 먼저 세 값을 기록하면 됩니다. 내려보낼 문맥, 새 출력, 다시 읽힐 도구 결과입니다. 이 셋을 적지 못한다면 라우팅 절감액도 계산할 수 없습니다. 반대로 상태를 chunk로 분리하고 표시 수준과 민감도를 붙이면 비용, 복구, 보안을 같은 표에서 판단할 수 있습니다.


댓글
댓글 쓰기