같은 LLM 심판에게 같은 답을 줬는데 순위가 바뀌었다: 5만2988회 감사의 경고
LLM을 심판으로 쓰는 평가는 이미 흔하다. 두 답변 중 더 나은 것을 고르게 하고, 학습 데이터를 걸러 내고, 리더보드 점수를 만든다. 그런데 심판에게 같은 요청을 다시 보냈을 때 판정 순서가 달라진다면 어떨까. 프롬프트와 모델 이름을 고정했다는 사실만으로는 측정 도구가 고정됐다고 말할 수 없다.
9월 3일 공개된 논문 「Clean Engineering, Unstable Measurement」는 이 문제를 52,988회의 요청 감사 기록으로 추적했다. 연구진이 원래 검증하려던 것은 풀이 중간 과정에서 정답 가능성을 읽을 수 있는지였다. 하지만 사전에 정한 측정 도구 신뢰성 관문을 통과하지 못해 본 실험으로 넘어가지 않았다. 실패를 결과 뒤에 설명한 것이 아니라, 어떤 수치에서 중단할지 먼저 정하고 그대로 멈췄다는 점이 이 논문의 쓸모다.
요약: 실행 기록은 깨끗했지만 측정값은 흔들렸다
같은 시간대에 후보 답변 순위를 반복 측정했을 때 Spearman 상관은 0.400이었다. 연구진이 사전에 요구한 기준은 0.90이었다. 바이트까지 같은 요청을 다음 날 다시 실행한 100쌍의 순위 일치율은 0.78로, 기준 0.99에 못 미쳤다.
이 숫자에서 52,988을 표본 수로 읽으면 안 된다. 논문은 이를 전체 감사 요청량이라고 명시한다. 핵심 분석 단위는 유효한 과제 그룹 31개, 다음 날 replay 100쌍, 보충 실험의 창별 10회, 알려진 오류를 넣은 판정 3,060건이다. 요청 전달, JSON schema, request hash, 기록 가능한 metadata는 모두 정상 범위였다. API 호출이 성공했다는 사실과 평가 도구가 안정적이라는 결론은 별개였다.
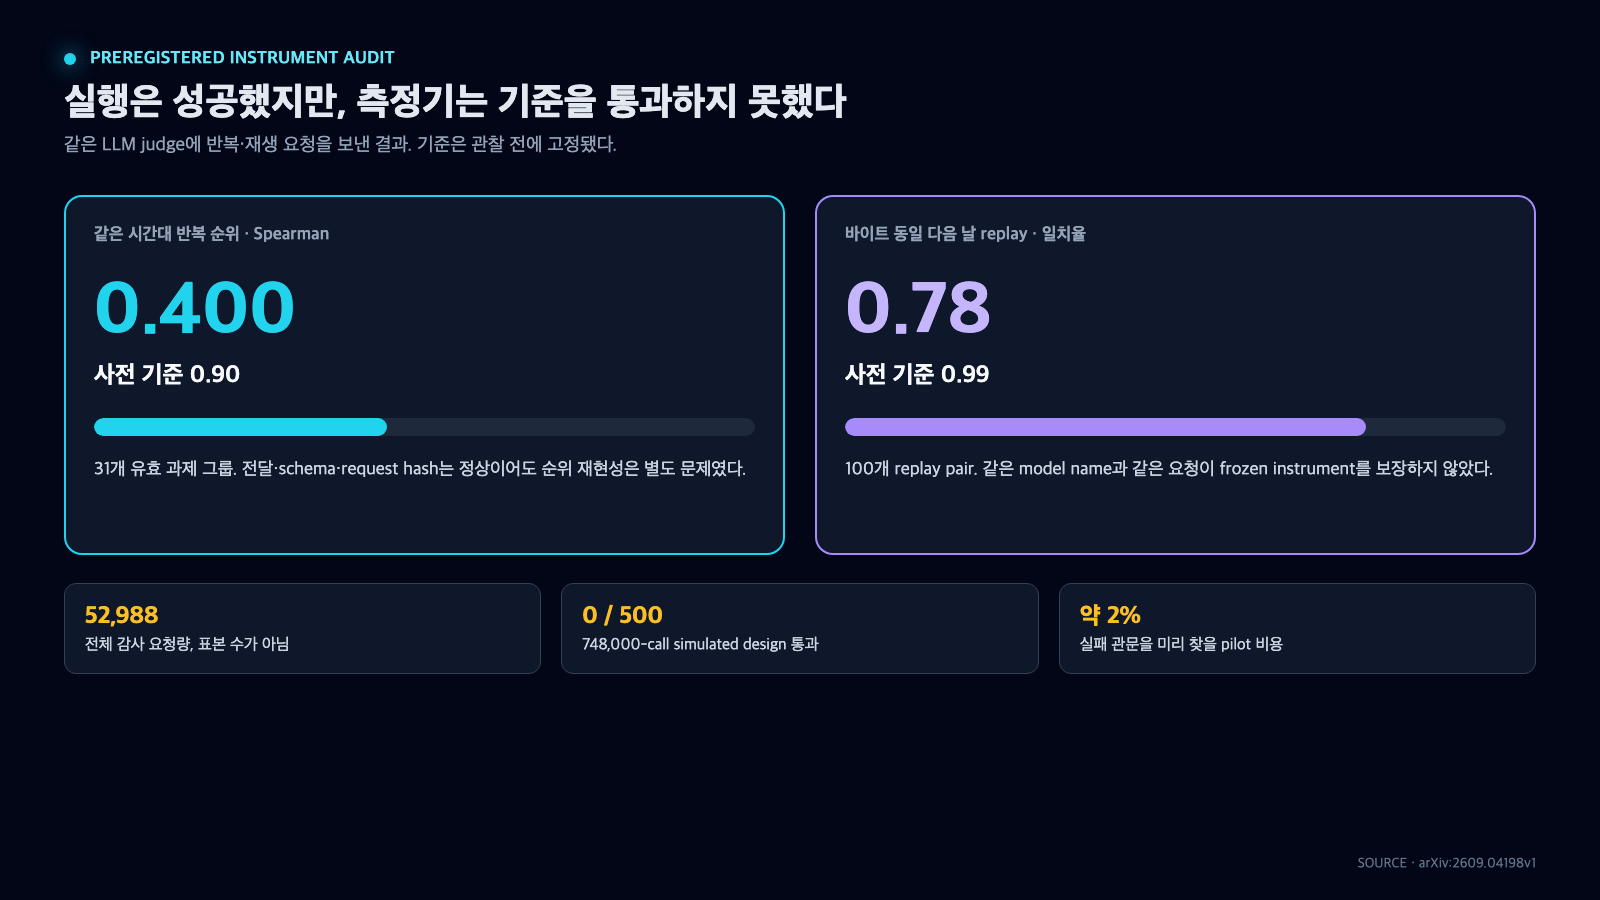
요청 전달과 schema 검증이 성공해도 측정 재현성은 별도 관문이다. 52,988은 전체 감사 요청량이며 표본 수가 아니다. 출처: arxiv.org/html/2609.04198v1.
왜 같은 모델 이름이 같은 측정기를 뜻하지 않았나
공유 endpoint 뒤에서는 요청이 같은 model name으로 들어가도 실행 조건이 완전히 같다고 보장되지 않는다. 동시 요청을 묶는 batch, kernel 선택, 배포 변경 같은 조건이 결과에 영향을 줄 수 있다. 논문은 특정 provider의 내부 원인을 확인했다고 주장하지 않는다. 외부에서 관찰한 불일치를 API가 노출한 metadata만으로 설명할 수 없었다고 선을 긋는다.
문제는 평가 대상의 차이도 너무 작았다는 데 있다. 후보 사이의 신호는 심판 자체의 noise floor보다 최대 7개 자릿수 작았다. 이런 구간에서 정확한 순위를 강제하면 작은 흔들림이 순열 전체의 오류로 커진다. label을 어떤 의미에 대응시키는지도 신호만큼 판정에 영향을 줬다. 답변 품질이 아니라 A와 B에 붙인 의미가 결과를 밀어낸 셈이다.
평가 metric을 바꾸거나 호출 수를 늘리는 우회도 이 실험 범위에서는 해결책이 아니었다. 같은 drift batch를 세 metric으로 읽어도 흔들림이 남았고, 748,000회 호출을 가정한 simulated design은 500회 중 한 번도 사전 기준을 통과하지 못했다. 표본을 늘리면 무작위 오차의 평균은 줄일 수 있지만, 측정 대상보다 큰 불안정성과 잘못 정의된 순위 관문까지 자동으로 고치지는 못한다.
기다리기, provider 교체, self-hosting의 실제 범위
시간을 띄우면 나아질 것이라는 예상도 해당 날짜들에서는 맞지 않았다. 같은 날 일치율 0.805와 다른 날 0.800은 실질적인 개선을 보여 주지 않았고, 이후 5일 반복에서도 바닥이 사라지지 않았다. 네 provider의 중앙값은 0.74에서 0.88 사이였다. 공개 metadata 필드 가운데 이 차이를 예측한 항목은 없었다.
self-hosting은 조건부로 나았다. batch-invariant kernel을 쓴 조용한 서버에서는 불일치가 줄었다. 하지만 동시 부하를 주자 불일치가 8.4배 늘어 공유 endpoint 수준으로 돌아왔다. 따라서 "로컬 모델이면 결정적"이라고 일반화할 수 없다. 모델 weight뿐 아니라 serving kernel, 동시성, batch 정책과 부하까지 측정 조건에 들어가야 한다.
또한 이 연구는 모든 LLM judge가 쓸모없다고 말하지 않는다. 특정한 중간 풀이 순위 측정과 보충 실험에서 관찰한 외부 동작을 보고한다. provider 서비스 품질이나 모델 내부 메커니즘을 평가한 연구도 아니다. 알려진 크기의 오류를 넣은 실험에서는 판정 분리가 오류 크기보다 오류 종류를 더 따라갔다. 이 심판은 적어도 그 설정에서 정밀한 "오차 크기 측정기"가 아니었다.
실전 적용: 평가 전에 평가기를 교정한다
LLM judge를 CI 관문이나 데이터 필터에 넣기 전에 작은 pilot을 별도 단계로 둔다. 논문은 전체 호출량의 약 2%만 쓴 pilot으로 두 개의 도달 불가능한 관문을 미리 발견할 수 있었다고 계산한다. 같은 입력을 같은 시간대와 다른 날짜에 반복하고, 순위·점수의 분산과 일치율을 먼저 기록한다. 기준은 결과를 본 뒤 정하지 말고 사전에 고정한다.
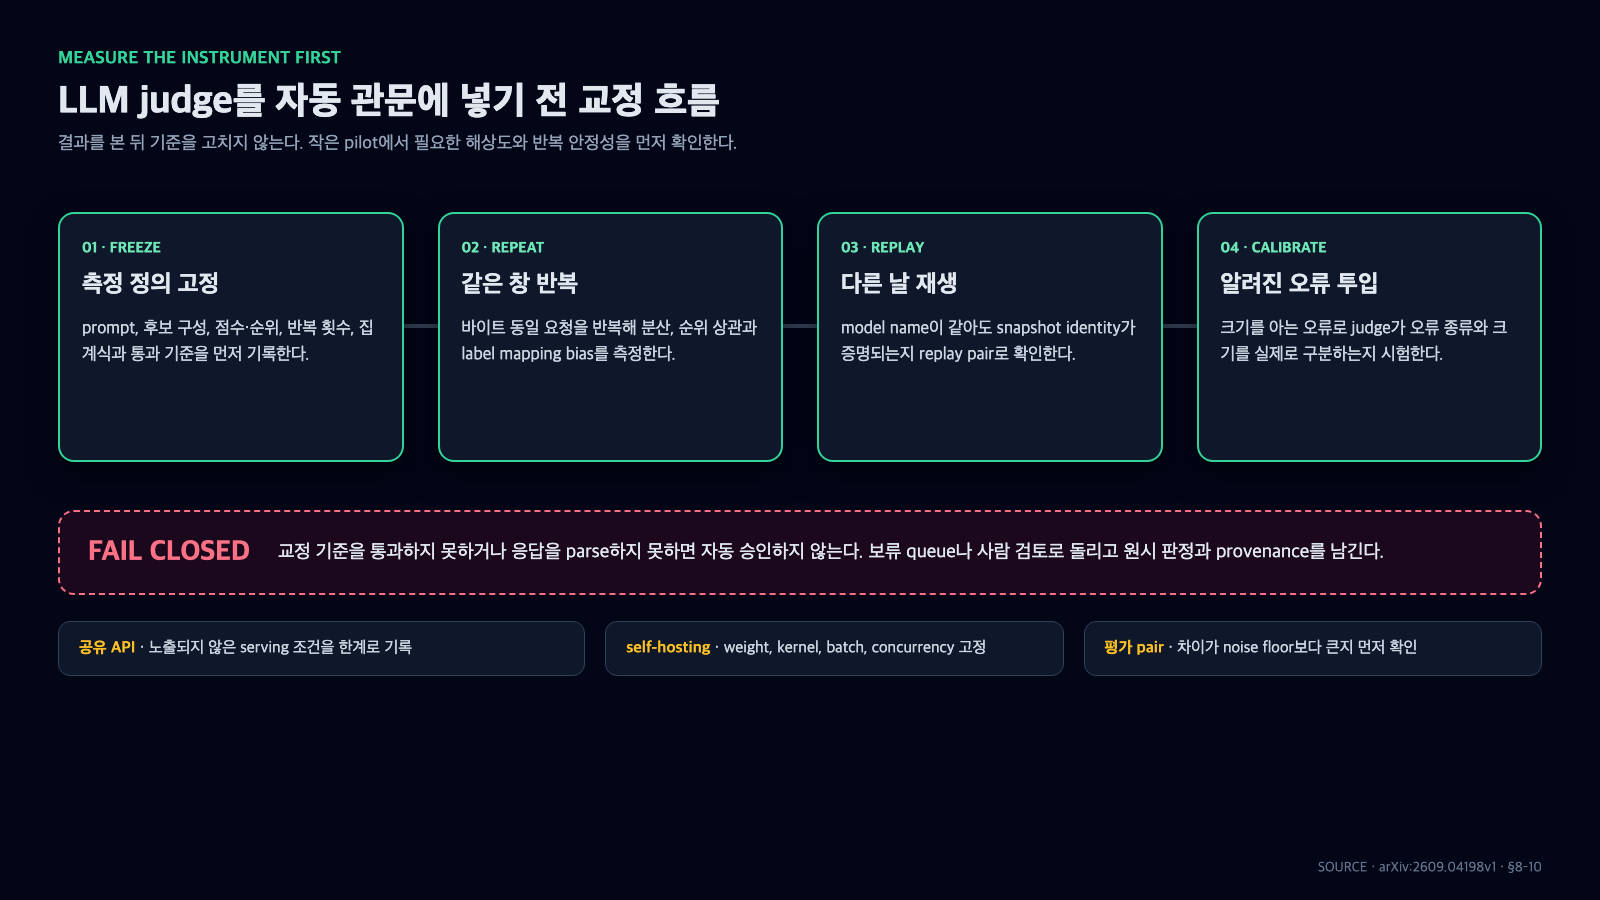
작은 pilot에서 측정기의 반복 안정성과 해상도를 먼저 확인하고, 기준 미달은 자동 승인하지 않는다. 출처: arxiv.org/html/2609.04198v1.
순위 평가에는 정보가 있는 pair만 넣는다. 사람이나 프로그램 검증으로 차이가 거의 없다고 확인된 후보에 억지로 1위와 2위를 붙이면 noise를 성능 차이로 오해하기 쉽다. 가능하면 단일 순위보다 연속 점수와 허용 오차 구간을 사용하고, 여러 번 호출해 평균낼 계획이라면 반복 횟수와 집계식을 측정 정의에 포함한다.
실행 provenance도 더 자세히 남겨야 한다. prompt, request body hash, model identifier와 시간만으로는 부족할 수 있다. self-hosting이라면 model weight digest, serving image, kernel, batch와 concurrency 설정을 기록한다. 공유 API라면 얻을 수 없는 정보가 있다는 사실 자체를 제한 사항으로 적는다. endpoint metadata가 같다는 이유로 내부 snapshot까지 같았다고 쓰지 않는다.
마지막 관문은 fail closed가 낫다. judge 응답을 parse하지 못했거나 교정 기준을 충족하지 못하면 통과로 간주하지 않는다. 데이터 선별이라면 보류 queue로 보내고, CI라면 사람 검토로 돌린다. 측정기가 불안정한데도 자동 배포를 계속하는 것보다 중단 이유와 원시 판정을 보존하는 편이 나중에 복구하기 쉽다.
운영 대시보드에는 평균 점수 하나보다 반복 분포를 남긴다. 같은 항목을 여러 번 평가했을 때 판정이 몇 번 뒤집혔는지, 날짜를 바꾼 replay가 얼마나 일치했는지, 사람 검토와 충돌한 항목이 어떤 유형인지 따로 본다. 모델을 교체하면 기존 교정 결과를 승계하지 말고 새 측정기로 다시 pilot을 돌린다. provider가 model alias 뒤의 snapshot을 바꿀 수 있는 환경도 같은 원칙으로 다룬다.
이 절차는 비용 절감에도 도움이 된다. 대규모 평가가 끝난 뒤 결과를 버리는 것보다 작은 pilot에서 도달 불가능한 기준을 찾는 편이 싸다. 다만 pilot 통과는 영구 인증서가 아니다. 요청 분포, prompt, 후보 난이도나 serving 조건이 달라지면 측정 범위도 달라지므로 주기적인 replay와 drift 경보가 필요하다.
범위와 주의점
이 글의 수치는 arXiv v1 논문 본문과 표·보충 실험 설명을 대조해 옮겼다. 공개된 저자 repository는 확인하지 못했고, 연구의 요청 ledger나 provider 호출을 독립 재실행하지 않았다. 52,988회는 표본 수가 아니라 감사 요청량이며, 748,000회 수치는 실제 추가 API 실행이 아니라 논문의 simulation이다.
논문의 가장 안전한 결론은 좁다. 공유 endpoint의 model name은 frozen instrument의 증명이 아니다. LLM judge로 다른 시스템을 평가하기 전에, 반복 입력에서 그 judge가 필요한 해상도와 안정성을 실제로 내는지 먼저 측정해야 한다.


댓글
댓글 쓰기