브라우저 LLM은 왜 호출 횟수에 민감할까: WebGPU 디스패치 비용 읽기
브라우저에서 작은 언어 모델을 돌릴 때 GPU 사용률만 높이면 빨라질 것이라고 기대하기 쉽습니다. 하지만 토큰을 한 개씩 생성하는 추론에서는 계산 자체보다 매번 연산을 준비해 GPU에 전달하는 비용이 먼저 눈에 띌 수 있습니다. Jędrzej Maczan의 논문 「Characterizing WebGPU Dispatch Overhead for LLM Inference Across Four GPU Vendors, Three Backends, and Three Browsers」는 바로 이 호출 비용을 분리해 측정하려는 연구입니다. 이 글은 결과를 한국어 개발자가 설계 판단에 쓸 수 있게 풀어 설명하되, 논문이 시험한 범위와 아직 모르는 부분을 함께 남깁니다.
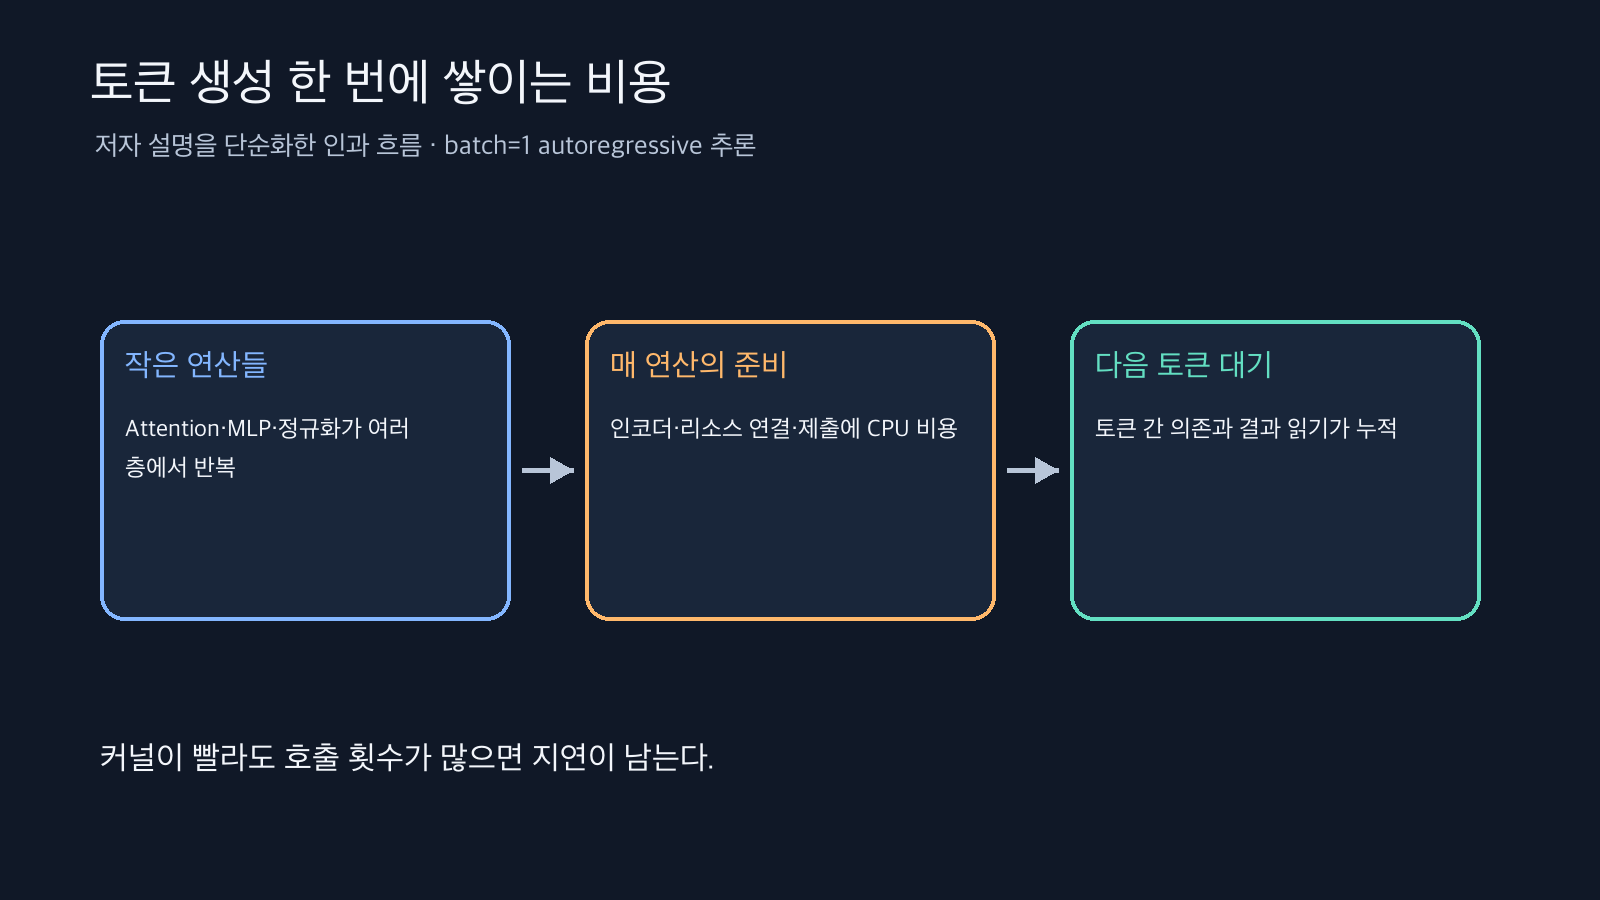
batch=1에서는 여러 작은 연산의 호출 준비와 토큰 의존이 겹쳐 지연을 만들 수 있다. 논문의 설명을 요약한 개념도이며 실측 그래프가 아니다. 출처: arxiv.org/abs/2604.02344.
1. 계산보다 호출이 앞서는 순간
WebGPU는 브라우저 안에서 GPU 기능을 쓰게 하는 인터페이스입니다. 보안과 이식성을 위해 작업을 명령 버퍼에 기록하고, 사용할 자원을 연결한 뒤 큐에 제출합니다. 이는 브라우저가 GPU 작업을 검증하고 여러 제조사 API를 감싸는 데 필요한 구조지만, 작은 연산을 아주 많이 실행하면 준비 단계도 반복됩니다. 변환기 모델의 한 번의 토큰 생성에는 attention, MLP, 정규화 같은 연산이 여러 층에 걸쳐 이어지고, 다음 토큰은 직전 토큰 결과를 기다립니다. 큰 행렬 계산처럼 한 번에 긴 일을 시키는 것과 달리, batch 크기 1의 autoregressive 추론은 잘게 쪼개진 작업과 순차 의존이 두드러집니다.
논문은 Qwen2.5-0.5B의 분석에서 한 forward pass에 FX 그래프 노드 1,911개가 있고, 그중 약 876개가 잠재적 계산 연산이라고 설명합니다. 모든 노드가 실제 WebGPU dispatch가 되는 것은 아닙니다. 예를 들어 shape 연산은 GPU 호출을 요구하지 않을 수 있고, fusion에 따라 호출 수가 바뀝니다. 따라서 “876회”는 무조건 실행되는 API 호출 수가 아니라 미융합 기준의 상한에 가까운 분석값으로 읽어야 합니다.
이 지점에서 지연은 세 층으로 생각하면 편합니다. GPU 커널의 계산 시간, WebGPU API의 dispatch 준비·제출 비용, 그리고 Python 같은 프레임워크의 주변 비용입니다. 이 구분 없이 전체 토큰 속도 하나만 비교하면, 어떤 최적화가 원인을 건드렸는지 알기 어렵습니다.
2. 한 번 재고 끝내면 왜 과장될까
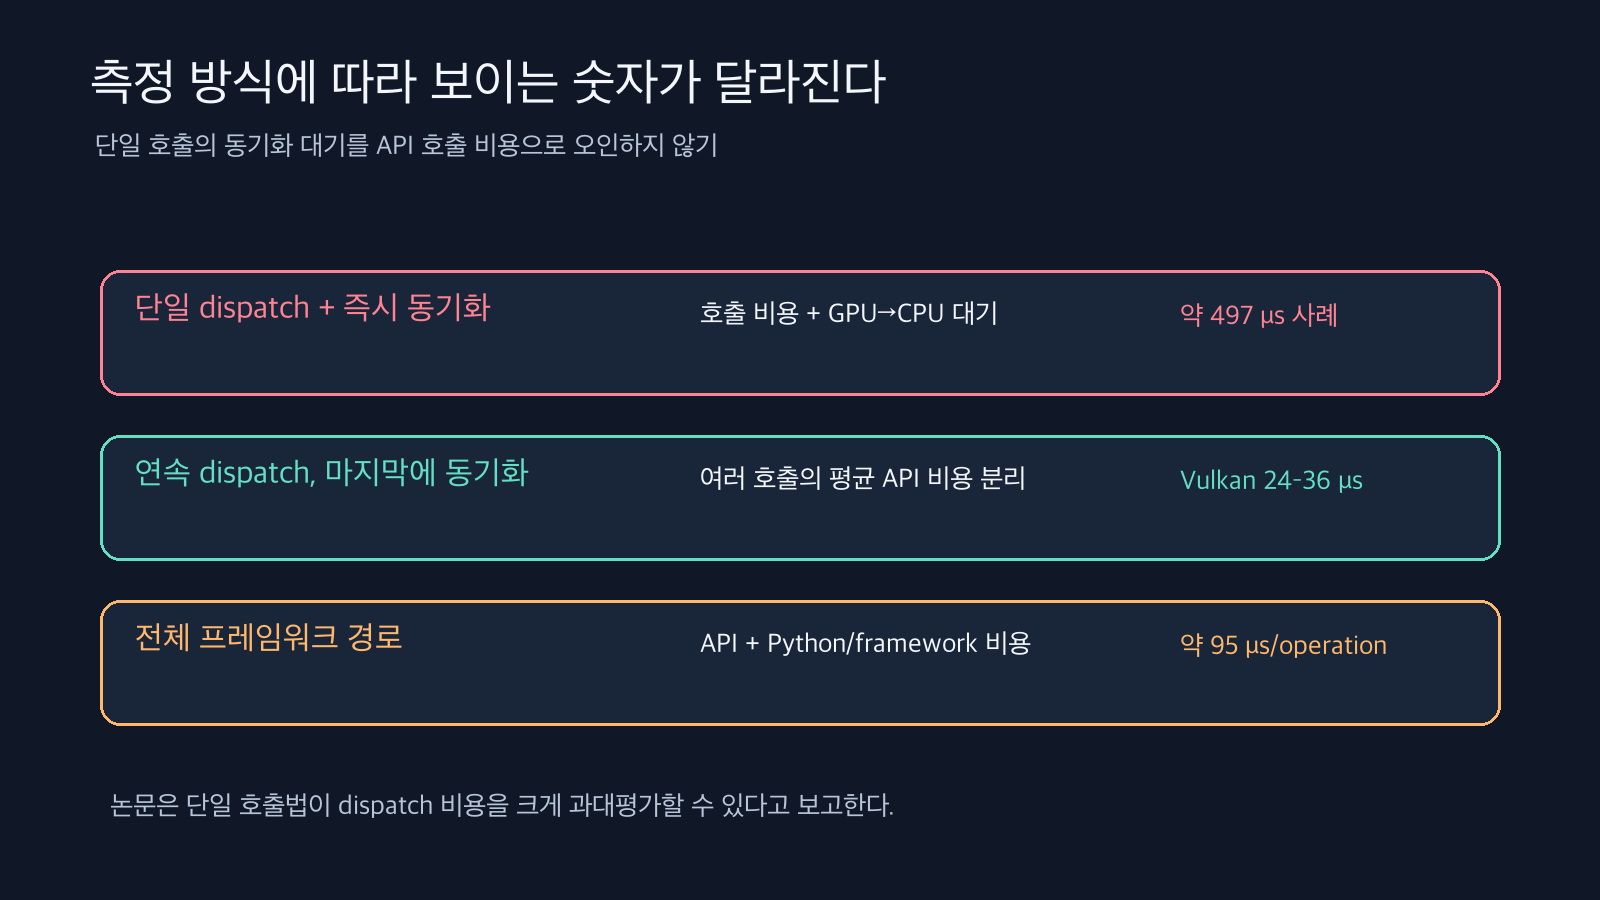
단일 dispatch와 즉시 동기화하는 측정은 대기 비용을 섞을 수 있다. 수치는 논문 사례로 특정 설정에 한정된다. 출처: arxiv.org/abs/2604.02344.
GPU 명령 제출은 비동기일 수 있습니다. CPU가 제출한 뒤 GPU가 끝날 때까지 기다리는 동기화 시간을 단일 호출 비용에 합쳐 버리면, API 자체의 비용과 GPU→CPU 대기 시간이 섞입니다. 논문은 단일 연산을 실행하고 매번 동기화하는 방식이 실제 dispatch 비용을 크게 과대평가할 수 있다고 지적합니다. 대신 여러 dispatch를 연속으로 넣고 마지막에만 동기화하면, 반복 호출의 평균 비용을 더 잘 분리할 수 있습니다.
논문이 보고한 Vulkan 환경의 API dispatch 비용은 대략 24–36마이크로초이고, Metal은 구현에 따라 대략 32–71마이크로초 범위입니다. 별도로 RTX 5090에서 측정한 전체 프레임워크 포함 연산 비용은 약 95마이크로초였습니다. 두 값은 같은 종류의 시간이 아닙니다. 뒤의 값에는 API뿐 아니라 Python·프레임워크 비용도 들어갑니다. 저자가 제시한 분해는 불확실성이 약 30%인 근사치이므로, 95에서 API 비용을 뺀 결과를 모든 앱의 고정 프레임워크 오버헤드로 취급해서는 안 됩니다.
실무에서는 먼저 계측 경계를 적어 두는 것이 좋습니다. “호출 전후 CPU 시간”, “GPU 완료까지 기다린 시간”, “전체 토큰 생성 시간”은 서로 다른 질문에 답합니다. 단일 GPU 호출만 재는 미니 벤치마크가 실제 생성 속도를 설명하지 못할 수 있는 이유가 여기에 있습니다.
3. fusion은 호출 수를 줄여 병목을 겨냥했다
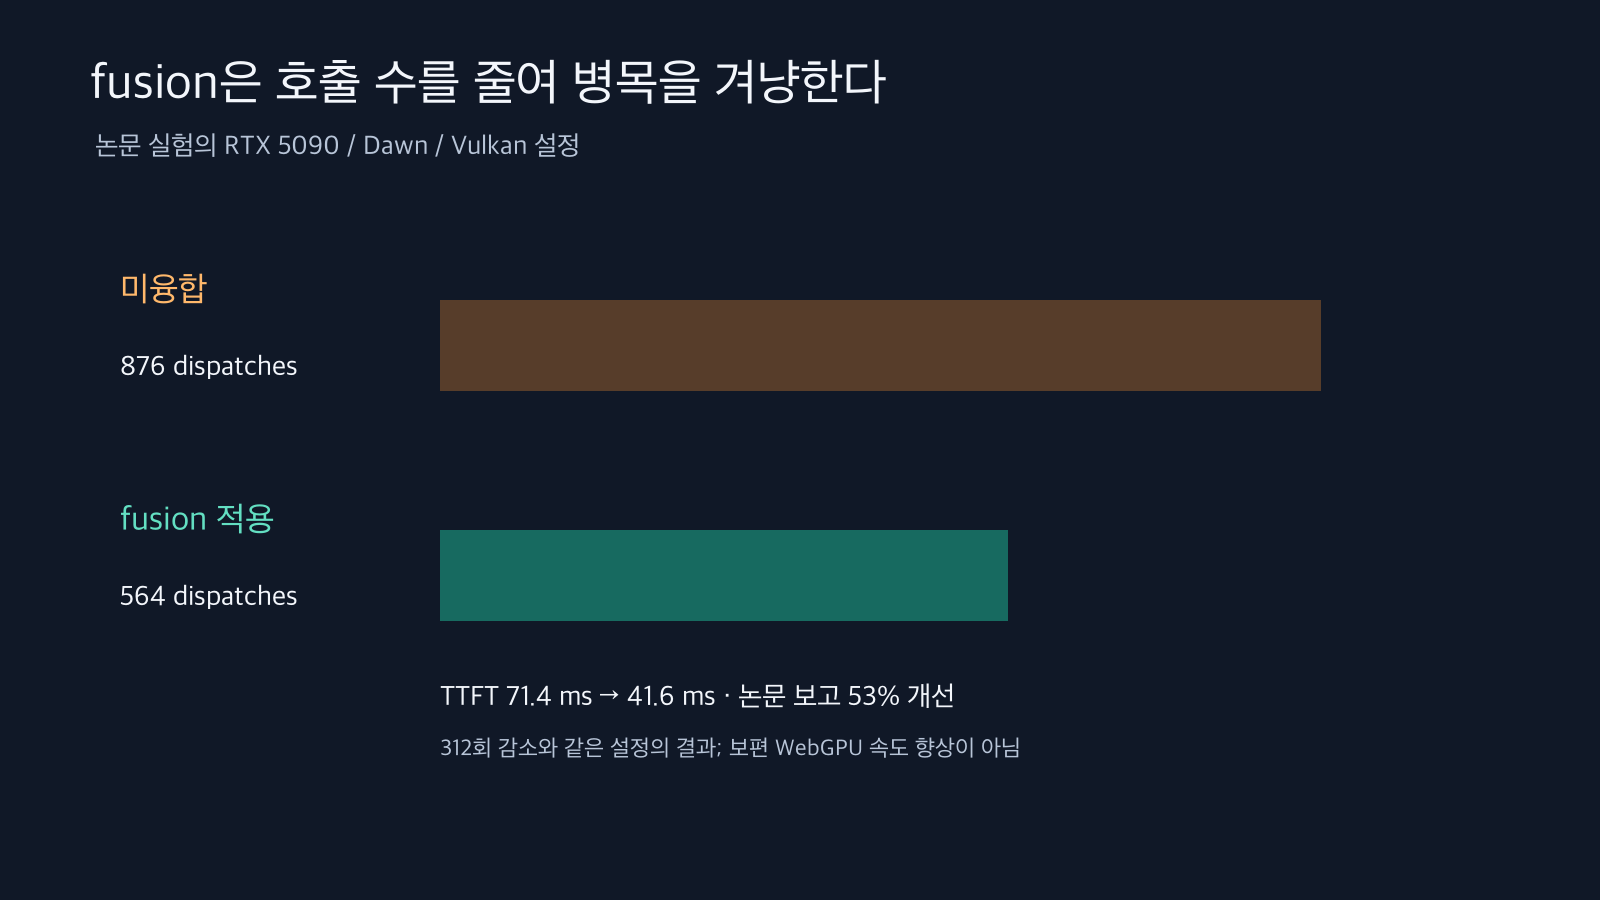
RTX 5090/Dawn/Vulkan 논문 설정에서 dispatch 감소와 TTFT 변화를 비교한다. 연구진 보고값이지 독립 재현이 아니다. 출처: arxiv.org/abs/2604.02344.
논문은 RTX 5090, Dawn, Vulkan 구성에서 Qwen2.5-0.5B 경로의 미융합 876 dispatch를 fusion 적용 뒤 564로 줄였다고 보고합니다. 312회 감소와 함께 TTFT(첫 토큰까지 시간)는 71.4밀리초에서 41.6밀리초로 내려갔고, 논문은 이를 53% 개선으로 제시합니다. 이는 저자가 설명한 특정 실험 설정의 결과입니다. WebGPU 앱이 모두 53% 빨라진다거나, 브라우저별로 같은 변화가 난다는 뜻은 아닙니다.
무엇을 합쳤는지도 중요합니다. RMSNorm fusion은 정규화에 필요한 여러 단계를 하나로 묶고, MLP fusion은 게이트·업 프로젝션과 활성화의 일부를 결합합니다. 작은 원소별 연산만 합쳤을 때의 개선은 제한적이었지만, 구조적으로 더 많은 dispatch를 없앤 조합이 결과에 크게 기여했다고 저자는 분석합니다. 반대로 큰 Transformer 블록 전체를 한 번에 실행하는 mega-kernel 실험은 통계적으로 유의한 결과를 얻지 못했다고 보고합니다. “더 많이 합칠수록 항상 좋다”는 단순한 규칙은 성립하지 않습니다. GPU 병렬성이 줄어들거나 동기화 제약이 생길 수 있기 때문입니다.
논문은 같은 설정에서 커널 품질은 유지하고 호출 수를 줄이는 비교를 병목의 인과적 단서로 사용합니다. 독자는 이 결과를 최적화 후보를 고르는 증거로 참고할 수 있지만, 자신의 앱에서 실제로 같은 병목인지 프로파일링해야 합니다.
4. 다른 브라우저와 GPU에 그대로 옮기지 말 것
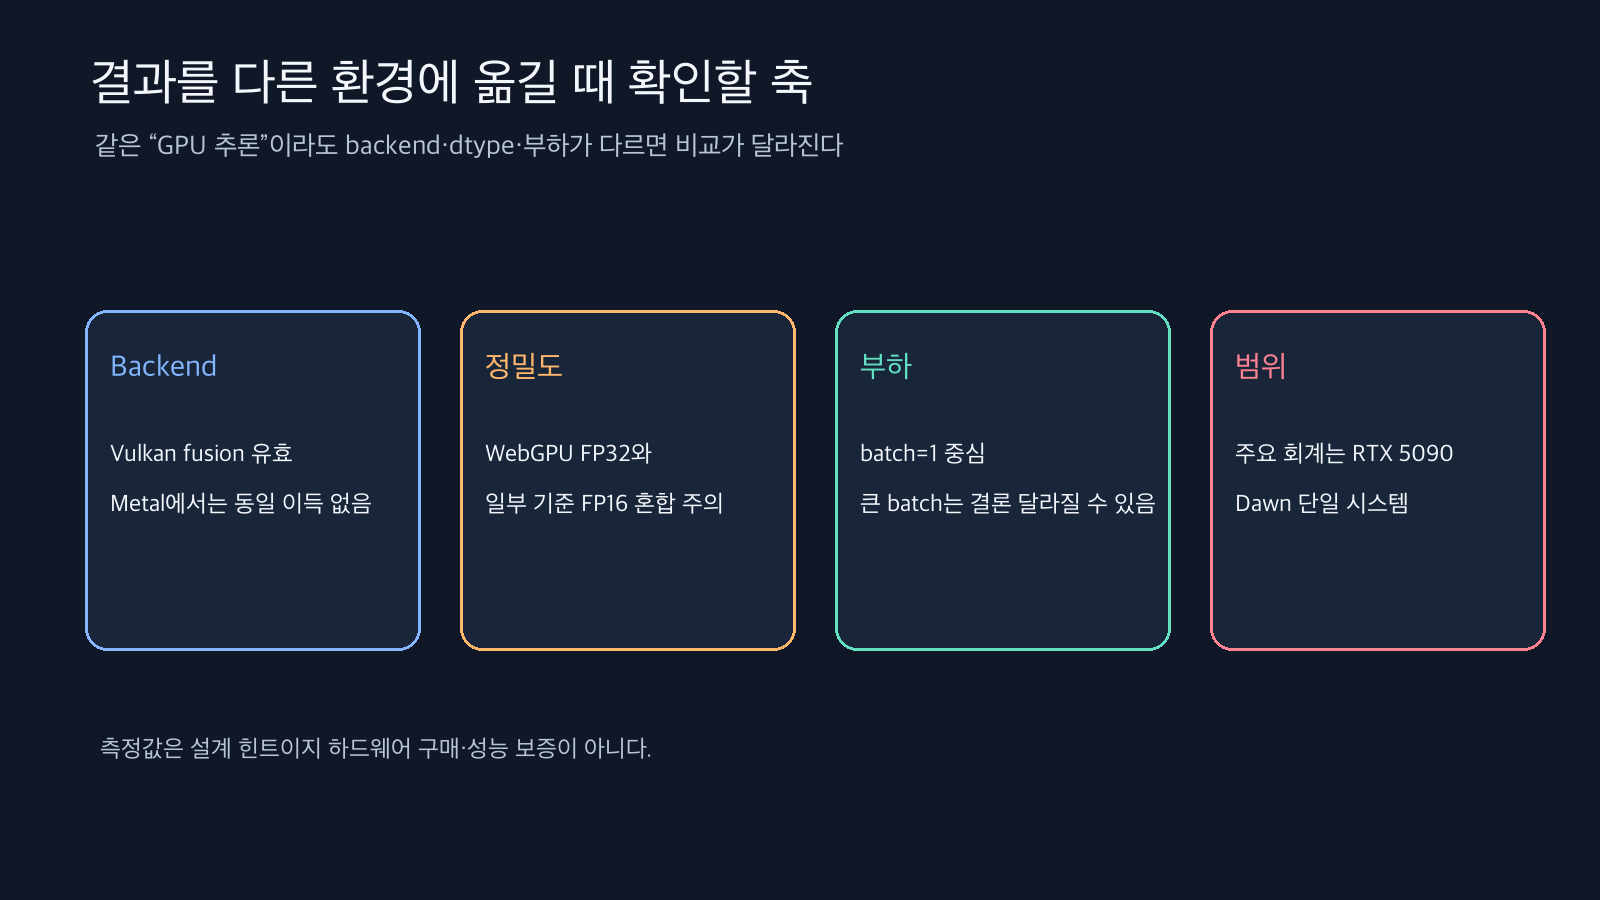
다른 시스템에 결론을 적용하기 전에 확인할 네 축을 제시한다. 성능 수치 비교를 일반화하지 않는다. 출처: arxiv.org/abs/2604.02344.
논문은 네 GPU 업체와 여러 백엔드·브라우저를 조사했지만, 세부 결과의 범위는 균일하지 않습니다. 주요 torch-webgpu 오버헤드 회계는 RTX 5090의 Dawn/Vulkan 구성에 기대고 있으며, 저자도 다른 플랫폼의 torch-webgpu 검증이 더 필요하다고 적습니다. 브라우저별 구현 차이도 관찰됐습니다. 예를 들어 Safari의 Metal 측정값과 wgpu-native의 Metal 측정값은 서로 달랐습니다. 동일한 그래픽 API 계열이라고 해서 드라이버·런타임 경로까지 같다고 가정할 수 없습니다.
비교 정밀도 역시 핵심입니다. WebGPU 경로는 float32였지만 일부 CUDA·MPS 기준은 float16이었습니다. 논문은 이 dtype 불일치가 격차를 부풀릴 수 있다고 밝히고, 맞춘 정밀도 비교에서 결과가 달라지는 사례를 제시합니다. 그러므로 “WebGPU가 CUDA보다 몇 배 느리다” 같은 단일 문장만 떼어 인용하면 조건을 잃습니다. 배치 크기 1 결과를 큰 batch 서빙에 적용하는 것도 조심해야 합니다. batch가 커지면 호출 비용을 더 많은 계산에 나눠 부담할 수 있습니다.
Firefox의 높은 dispatch 비용은 논문에서 여러 환경에서 비슷하게 관찰됐지만, 저자는 원인을 확인하기 위해 Firefox 소스 코드를 조사하지 않았습니다. 속도 제한과 일치하는 패턴이라는 설명은 가설이지 확정된 구현 원인이 아닙니다. 실험 결과와 메커니즘 해석을 구분해야 하는 좋은 사례입니다.
5. 개발자가 바로 써볼 판단 순서
batch=1 브라우저 추론을 먼저 개선한다면 호출을 합칠 수 있는지와 실제 backend를 확인하고, 비교 기준의 dtype이 같은지 점검한다. 구체적으로 GPU를 바꾸기 전에 토큰 생성 경로에서 CPU와 GPU가 어디서 동기화되는지 살펴본다. 이어서 프레임워크 호출 수와 실제 dispatch 수를 구분해 세고, 같은 모델·같은 dtype·같은 batch 조건으로 비교한다. 여러 작은 연산을 결합할 수 있는지도 살펴보되, 결합 전후에 품질·메모리·병렬성이 보존되는지 확인한다. 마지막으로 브라우저와 backend 조합을 바꿔도 개선이 유지되는지 측정한다.
이 순서는 특정 도구의 성능을 약속하지 않는 진단 프레임입니다. 사용자의 데이터가 기기 밖으로 나가지 않아야 하거나, 네트워크 연결 없이 동작해야 하거나, 교육·실험용으로 브라우저 배포가 편리한 경우에는 절대 속도 외의 이점이 있습니다. 반면 지연시간이 엄격한 서비스나 높은 처리량이 필요한 서버에서는 네이티브 런타임이 더 적절할 수 있습니다. 선택은 “WebGPU 대 CUDA”의 승패가 아니라, 요구조건과 측정 경계를 맞추는 일입니다.
이 글은 논문을 읽고 결과의 적용 범위를 분석한 것이며, 새로운 벤치마크를 실행하거나 독립 재현하지 않았다.
논문은 독립적으로 재현되지 않았고, 이 글도 논문 본문을 읽어 정리한 편집 분석입니다. 따라서 그림의 숫자는 저자가 보고한 결과이며, 여기서 새로 실행한 성능 측정이 아닙니다. 특히 backend별 fusion 효과, 프레임워크 비용 분해, Firefox 원인 설명은 적용 범위를 구분해 읽어야 합니다. 이 글은 논문을 읽고 결과의 적용 범위를 분석한 것이며, 새로운 벤치마크를 실행하거나 독립 재현하지 않았습니다.
참고 자료
- Jędrzej Maczan, “Characterizing WebGPU Dispatch Overhead for LLM Inference Across Four GPU Vendors, Three Backends, and Three Browsers,” arXiv:2604.02344. 초록 및 서지 정보 · HTML 전문


댓글
댓글 쓰기