LLM은 몰라서 틀릴까, 꺼내지 못해 틀릴까: WikiProfile 400만 응답이 가른 두 실패
LLM이 사실 질문에 틀리면 보통 "학습하지 못한 정보"라고 설명한다. 새 논문 Empty Shelves or Lost Keys?는 그 묶음을 둘로 갈라 본다. 선반이 비어 있어서 답이 없는 실패와, 선반에 있지만 열쇠를 못 찾아 꺼내지 못한 실패다.
Google Research 연구진은 WikiProfile이라는 공개 벤치마크로 13개 LLM을 시험했다. 2,150개 사실마다 10개 과제를 만들고, thinking을 켠 조건과 끈 조건에서 답을 여덟 번씩 생성했다. 전체 평가는 약 450만 응답이다. 강한 모델은 이 벤치마크에서 사실의 95~98%를 행동적으로 인코딩한 것으로 분류됐지만, thinking을 쓰지 않으면 26~34%를 직접 회상하지 못했다. 논문의 초록이 요약한 범위는 25~33%이고, 본문 Figure 4의 집계는 26~34%다. 반올림과 보고 범위가 다른 대목이라 여기서는 둘을 섞지 않는다.
"안다"를 질문 하나의 정오로 판단하지 않았다
연구진은 사실 하나를 subject와 object가 포함된 명제로 잡았다. 예를 들어 원문이 "Oasis가 첫 공연을 Boardwalk club에서 했다"고 썼다면, object를 묻는 direct 질문과 subject를 거꾸로 묻는 reverse 질문을 만든다. 표현도 원문에 가까운 버전과 자연스럽게 바꾼 버전으로 나눈다.
encoding 측정에는 두 과제가 쓰였다. 정답 직전까지 원문을 보여 주고 이어 쓰게 하는 proposition completion, 같은 왼쪽 문맥 뒤에서 직접 질문하는 contextual question이다. 둘 중 하나라도 thinking 없이 정답률이 0.5를 넘으면 encoded로 분류한다. 반면 "knows"는 서로 다른 표현과 방향의 네 질문 모두가 임계값을 넘어야 한다. 익숙한 문맥에서는 재현하지만 질문 방향이 바뀌면 실패하는 사실을 따로 보기 위한 비대칭 정의다.
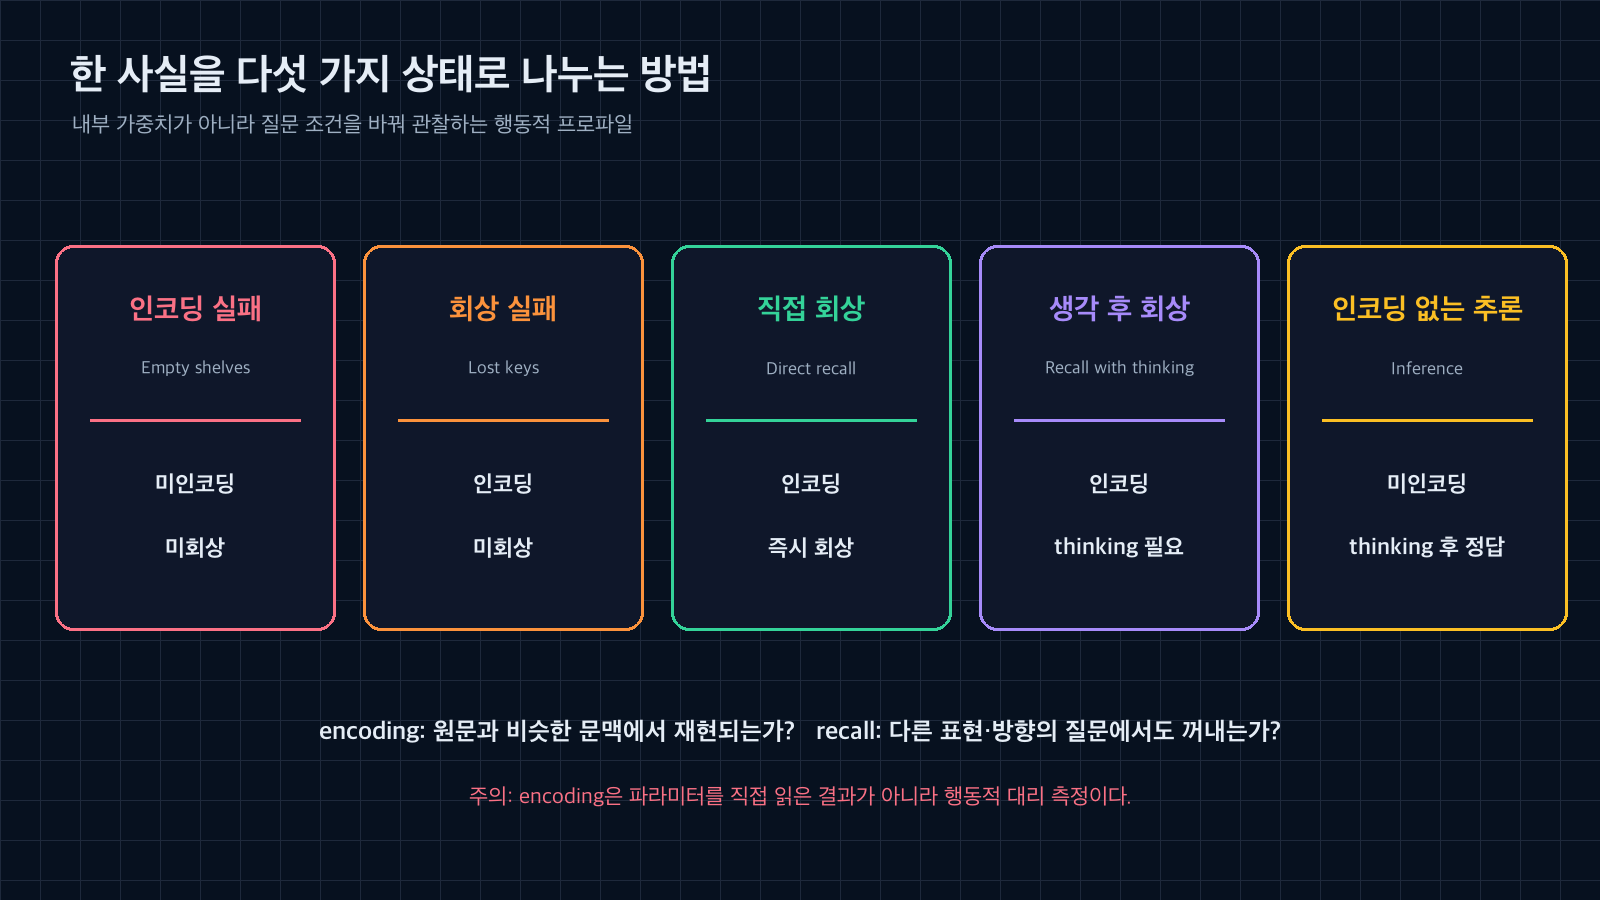
같은 오답도 pretraining-like 문맥에서 재현되는지와 다른 질문에서 회상되는지에 따라 원인이 달라진다. 출처: arxiv.org/pdf/2602.14080v2.
그 결과 사실은 다섯 프로파일로 나뉜다. 아예 인코딩되지 않고 답하지 못한 encoding failure, 인코딩 판정은 받았지만 thinking을 써도 답하지 못한 recall failure, 즉시 답하는 direct recall, thinking을 써야 답하는 recall with thinking, 인코딩 판정 없이 thinking으로 답한 inference without encoding이다. 마지막 유형은 다른 사실로부터 추론하거나 운 좋게 맞혔을 수도 있고, encoding 과제가 놓친 사실일 수도 있어 해석이 약하다.
2,150개 사실과 10개 질문은 어떻게 만들어졌나
WikiProfile은 Wikipedia 1만 페이지에서 후보 사실을 뽑은 뒤 범주와 entity type을 맞춰 5천 후보로 줄였다. direct·reverse 질문을 생성하고, 답이 하나인지와 모호함을 웹 검색에 근거한 prompted LLM으로 거른다. 질문 하나라도 탈락하면 사실 전체를 버렸고 약 2,200개가 남았다. 마지막 수동 검수에서 2% 미만을 더 제외해 2,150개가 됐다.
각 사실의 10개 과제는 encoding용 2개, closed-book 지식 질문 4개, 그 네 질문의 multiple-choice 버전 4개다. 공개 Hugging Face 파일을 직접 확인하니 CSV 행도 2,150개였고 direct, reverse, contextual, completion과 선택지 열이 들어 있었다. 모델군은 Gemini 2.5·3, GPT-4.1·5 계열, Gemma 3 네 크기로 구성된다. 각 과제에서 temperature 1로 여덟 응답을 받아 계산식상 약 450만 건(13×2×2,150×10×8)을 평가했다.
채점은 Gemini 2.5 Pro thinking 기반 grader가 CORRECT, INCORRECT, PARTIALLY, OTHER로 나눈다. 정답률 계산에서는 뒤의 두 범주를 제외한다. 저자들은 GPT-5 grader와 비교해 98.2% 일치를 보고했지만, 사람 전수 채점은 아니다.
비어 있는 선반보다 잃어버린 열쇠가 더 남았다
frontier 모델의 행동적 encoding은 95~98%에 이르렀다. 그래도 thinking 없이 직접 회상하지 못한 사실은 26~34%, thinking 뒤에도 실패한 사실은 11~12%였다. 강한 모델에서 오답을 전부 "학습 데이터에 없었다"고 처리하면 recall failure를 상당 부분 놓치는 이유다.
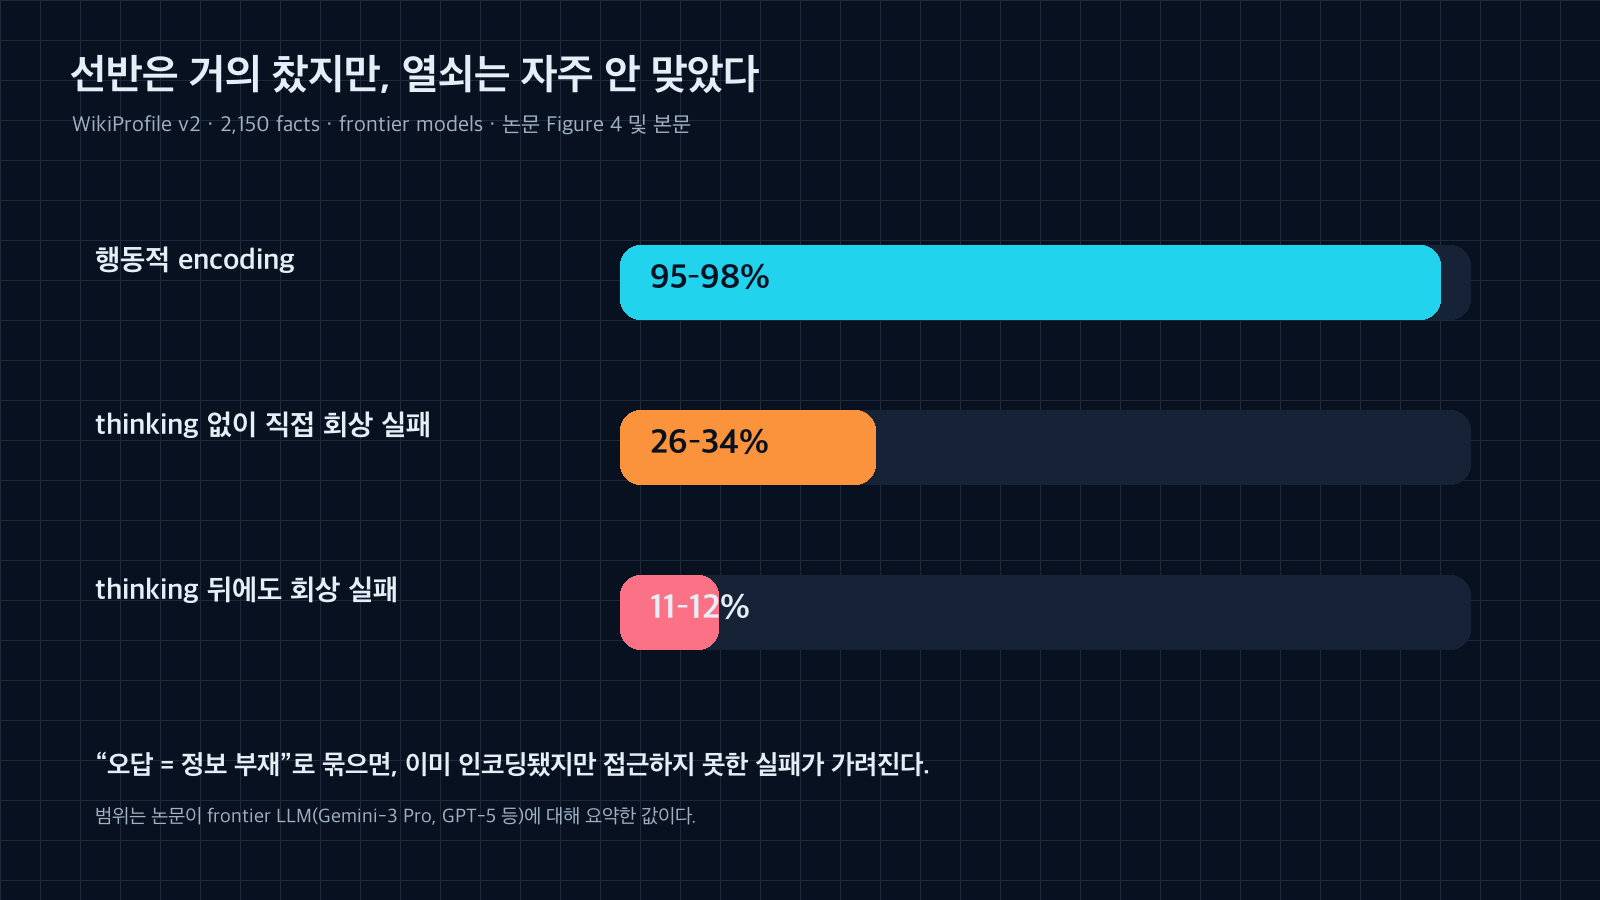
frontier 모델은 대부분의 사실을 행동적으로 encoding했지만 질문 조건이 달라지면 상당수를 직접 회상하지 못했다. 출처: arxiv.org/pdf/2602.14080v2.
크기 확대가 두 문제를 똑같이 줄이지도 않았다. Gemma 3 계열은 1B에서 27B로 갈 때 encoding failure가 85%에서 23%로 급감했다. 하지만 규모가 커질수록 남은 오류 중 recall failure의 몫이 커졌고, 논문은 thinking 조건에서 33%, thinking 없는 조건에서 40%까지 올라갔다고 보고한다. 더 큰 선반을 들여놓는 일과 이미 꽂힌 책을 다른 문맥에서 찾는 일은 같은 문제가 아니었다.
long-tail과 질문 방향에서도 차이가 났다. Gemini-3 Pro는 인기 상위 20%와 하위 20% 사실의 encoding 격차가 약 5%p였지만 직접 회상 격차는 약 21%p였다. GPT-5의 생성형 질문에서는 direct 82.9%, reverse 74.0%였다. 그런데 정답을 보기 중에 제시한 multiple-choice 검증에서는 reverse가 더 어렵지 않았다. 연결 자체가 완전히 없기보다, 학습 때와 반대 방향으로 답을 생성하는 접근 경로가 약하다는 해석에 힘을 싣는다.
Thinking은 열쇠 찾기를 도왔지만 공짜는 아니다
thinking-optimized 모델에서 직접 알지 못했던 encoded 사실의 약 40~65%가 thinking 뒤 known으로 바뀌었다. non-encoded 사실의 회복은 Figure 8 캡션 기준 5~15%였다. 본문 문장은 이를 5~20%로 더 넓게 요약한다. 그림의 조건부 비교를 따를 때는 5~15%를 쓰는 편이 안전하다.
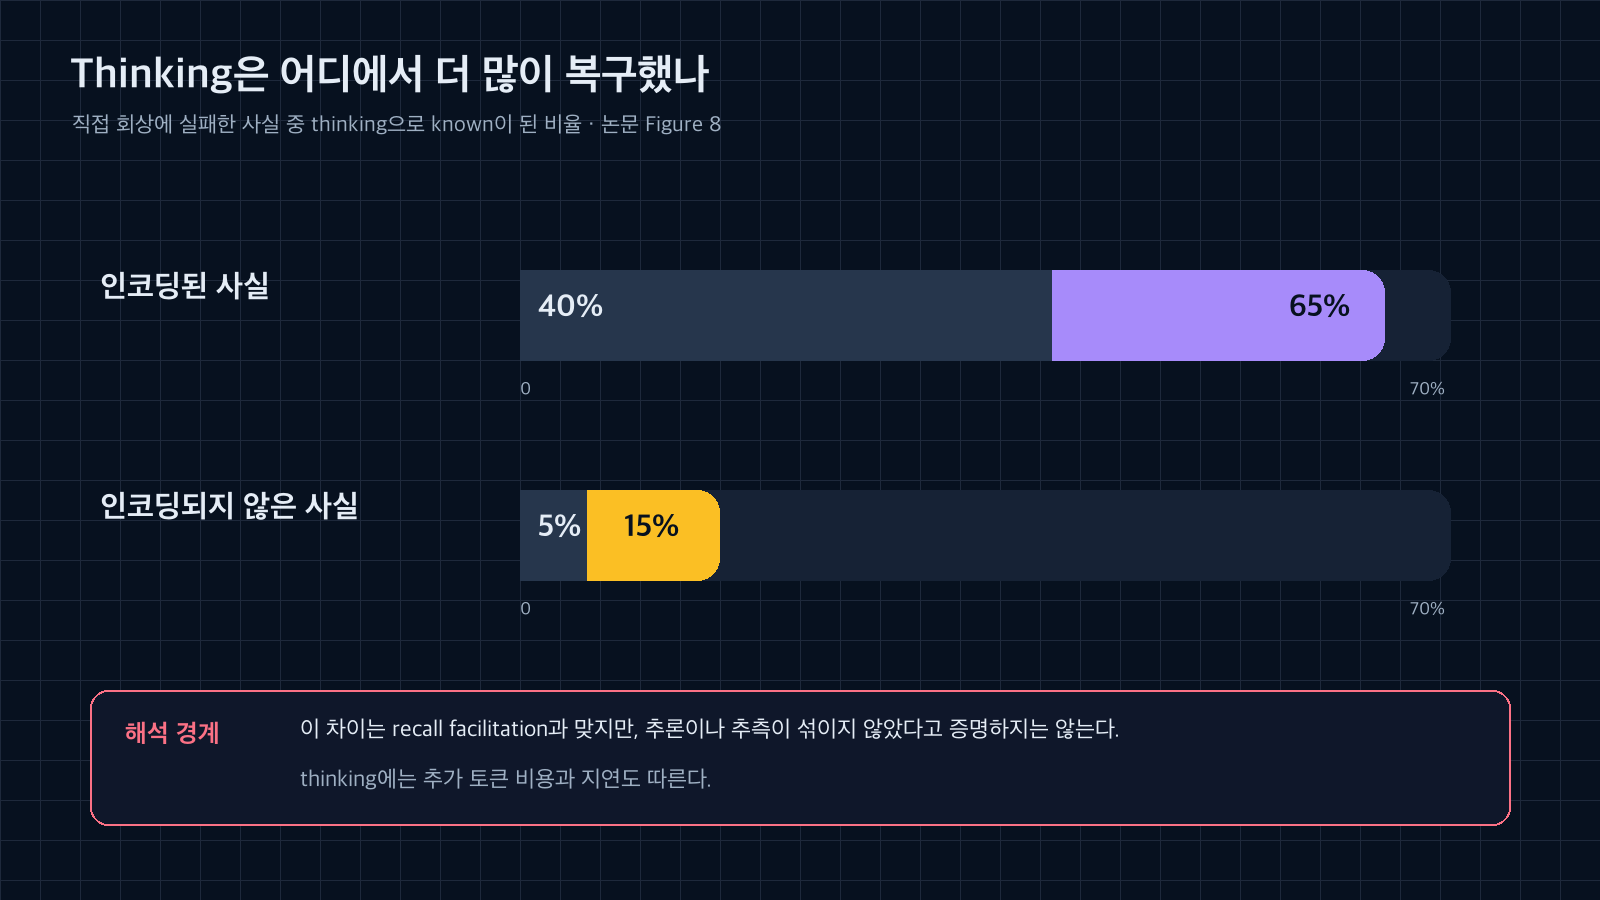
thinking의 회복은 encoded로 분류된 사실에서 훨씬 컸지만, 이 비교만으로 추론이나 추측의 혼입을 배제할 수는 없다. 출처: arxiv.org/pdf/2602.14080v2.
효과는 원래 접근이 약한 곳에서 컸다. Gemini-3 Pro의 희귀 사실 회상은 thinking으로 20.1%p 올랐고 인기 사실은 11.3%p 올랐다. GPT-5 reverse 질문은 19%p, direct 질문은 12%p 상승했다. 저자들은 응답 다양성보다 recall facilitation이 주된 설명이라고 본다. 다만 단일 홉 문제라도 관련 사실을 엮은 추론이나 educated guess가 섞일 수 있다. "모델 내부에 그 문장이 확실히 저장돼 있었다"는 파라미터 수준 증명과는 다르다.
비용도 남는다. 논문은 frontier 모델에서 사실의 10~20%가 thinking을 통해서만 접근 가능하다고 적는다. 모든 질문에 긴 추론을 붙이면 정확도 일부를 얻는 대신 토큰 비용과 지연을 낸다. 언제 thinking이 필요한지 미리 알아채는 일 자체가 metacognition 문제다.
제품에서는 모델 교체 전에 질문 경로를 시험할 수 있다
사실성 테스트를 정답률 하나로 끝내지 말고 같은 사실을 여러 경로로 묻는 편이 낫다. 원문과 가까운 문맥, 자연스러운 재표현, 관계를 뒤집은 질문, 보기에서 고르는 검증을 묶으면 "없음"과 "접근 실패"를 어느 정도 분리할 수 있다. 고객지원이나 사내 지식봇에서는 직접 답변이 실패했을 때 retrieval, 후보 제시, 짧은 thinking을 단계적으로 붙여 어느 경로가 회복시키는지 기록할 수 있다.
운영 지표도 달라진다. 모델 크기별 정확도만 비교하지 말고 direct와 reverse 격차, 인기 구간별 격차, thinking으로 회복된 비율, 회복당 추가 토큰과 지연을 함께 본다. retrieval 결과에 정답 후보가 들어왔을 때만 맞힌다면 생성 회상보다 recognition에 의존하는 시스템일 수 있다. 그 사실을 알면 더 큰 모델을 사는 것과 검색·질문 설계를 고치는 것 중 어디에 비용을 써야 할지 판단하기 쉬워진다.
이 결과를 "모델이 속으로는 안다"로 읽으면 과하다
가장 큰 경계는 encoding 정의다. 연구진은 모델 가중치나 activation을 검사하지 않았다. Wikipedia 원문과 비슷한 왼쪽 문맥에서 사실을 재현하면 encoded라고 보는 행동적 대리 측정이다. Wikipedia가 pretraining 자료에 들어갔을 가능성이 높아서 가능한 설계이며, 다른 사내 문서나 최신 사건에도 같은 비율이 나온다는 보장은 없다.
벤치마크 생성은 자동 파이프라인과 웹 검색 기반 prompted LLM에 크게 의존한다. 마지막에 사람이 사실을 검수했지만 응답 평가는 prompted LLM grader다. direct/reverse 구성, 네 질문 모두를 통과해야 한다는 knows 정의, 0.5 초과 임계값, PARTIALLY와 OTHER 처리에 따라 프로파일 비율이 달라질 수 있다. 저자들이 민감도 분석을 제시했어도 정의 의존성은 사라지지 않는다.
또 13개 모델의 특정 버전, temperature 1, 여덟 샘플 결과다. thinking은 모델별 기본 budget 또는 CoT prompting으로 구현돼 같은 연산을 뜻하지 않는다. 추가 계산이 recall을 돕는 효과와 실제 추론·추측을 완전히 분리하기도 어렵다. 따라서 이 논문의 단단한 결론은 "오류 중 일부는 문맥 변화에 따른 접근 실패로 설명된다"까지다. 모든 환각이 잃어버린 열쇠라는 주장도, 내부 지식의 존재를 직접 증명했다는 주장도 아니다.
참고 자료
- 논문 v2: https://arxiv.org/abs/2602.14080v2
- 고정 PDF: https://arxiv.org/pdf/2602.14080v2
- 공개 WikiProfile 데이터셋: https://huggingface.co/datasets/google/WikiProfile


댓글
댓글 쓰기