저장소 문맥을 LoRA로 압축하면 매번 다시 읽지 않아도 될까
코딩 에이전트가 저장소를 이해하려면 import, 내부 API, 테스트 관례를 알아야 한다. 가장 단순한 방법은 관련 파일을 찾아 프롬프트에 붙이는 것이다. 문제는 저장소가 클수록 검색 결과가 길어지고, 호출할 때마다 같은 문맥 비용을 다시 낸다는 점이다.
Code2LoRA는 다른 길을 택한다. 저장소를 읽은 결과로 전용 LoRA 어댑터를 만들어 코드 모델의 파라미터 쪽에 문맥을 넣는다. 추론 프롬프트에는 저장소 파일을 추가하지 않기 때문에 논문 표현으로는 "추론 시 토큰 오버헤드 0"이다. 다만 공짜 메모리는 아니다. 어댑터를 생성하는 하이퍼네트워크를 미리 훈련해야 하고, 실험에 쓰인 생성기는 수억 개의 학습 파라미터를 가진다.
RAG 대신 파라미터로 문맥을 옮긴다
Code2LoRA-Static의 입력은 저장소 한 시점의 스냅샷이다. 저장소 인코더가 코드를 벡터로 만들고, 하이퍼네트워크가 그 벡터를 받아 Qwen2.5-Coder-1.5B에 붙일 LoRA 가중치를 생성한다. 기반 코드 모델과 저장소 인코더는 고정하고 하이퍼네트워크만 학습한다.
이 구조의 장점은 호출마다 긴 검색 문맥을 붙이지 않아도 된다는 것이다. 처음 보는 저장소에도 어댑터를 한 번에 생성할 수 있으므로 저장소마다 LoRA를 다시 미세조정하는 방식과도 다르다. 대신 어댑터가 담는 지식은 인코더와 학습 분포가 포착한 범위로 제한된다.
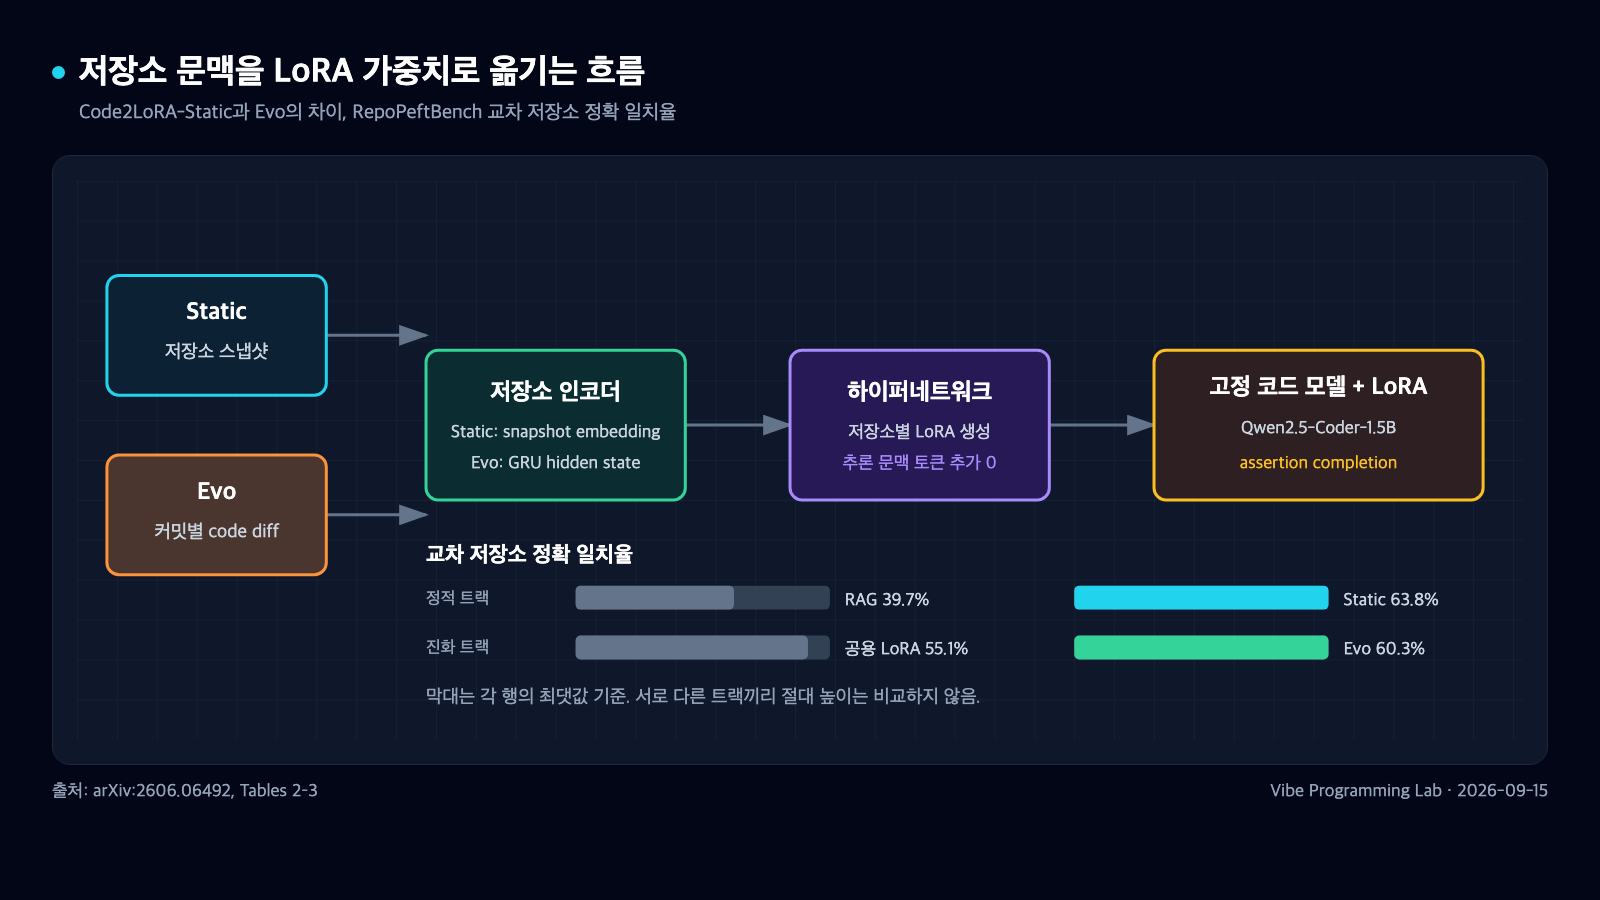
그림 1. Code2LoRA는 저장소 스냅샷 또는 커밋별 변경을 인코딩해 LoRA를 만들고, 추론 프롬프트에 저장소 문맥 토큰을 추가하지 않는다. 출처: arxiv.org/abs/2606.06492.
정적 저장소에서 63.8%를 기록했다
연구진은 604개 공개 Python 저장소로 RepoPeftBench를 만들었다. 과제는 pytest와 unittest의 assertion 뒷부분을 완성하는 문제다. 정적 트랙에는 훈련 39,612개, 교차 저장소 테스트 6,414개, 저장소 내부 테스트 5,222개가 들어갔다.
처음 보는 저장소를 재는 교차 저장소 정확 일치율에서 기본 모델은 45.7%, RAG(k=3)는 39.7%, 의존성을 따라 문맥을 붙인 방식은 48.2%였다. FFT+RAG가 53.9%였고 Code2LoRA-Static은 63.8%였다. 저장소 내부 평가에서는 66.2%로, 저장소마다 따로 훈련한 LoRA의 64.0%와 비슷하거나 조금 높았다.
여기서 RAG가 항상 나쁘다고 읽으면 안 된다. 이 표는 assertion completion이라는 한 과제, 한 검색 구성, 한 기반 모델의 결과다. 검색기가 더 좋아지거나 대상 작업이 달라지면 순위도 달라질 수 있다.
커밋이 쌓이면 스냅샷은 낡는다
활성 저장소는 어제의 스냅샷으로 끝나지 않는다. Code2LoRA-Evo는 커밋마다 생긴 code diff를 GRU에 순서대로 넣고 숨은 상태를 갱신한다. 그 상태가 매 시점의 LoRA를 만든다. 스냅샷 하나를 다시 압축하는 대신 변경 이력을 따라 어댑터 궤적을 유지하는 셈이다.
커밋 기반 진화 트랙의 교차 저장소 정확 일치율은 기본 모델 31.5%, RAG 23.6%, 하나의 공용 LoRA 55.1%, 정적 Code2LoRA 55.7%, Code2LoRA-Evo 60.3%였다. Evo는 공용 LoRA보다 5.2%포인트 높았다. 저장소 내부 평가는 64.5%로, 저장소별 LoRA 64.2%와 거의 같았다.
2025년 4월 1일 이후 만들어진 92개 저장소의 OOD 표에서는 Evo가 74.1%로 가장 높았다. 하지만 이 숫자를 다른 표와 바로 비교하면 안 된다. OOD 정답 길이 중앙값이 7자였고 기존 테스트는 12~13자여서 정확 일치가 더 쉬웠다. 논문도 OOD 표 안에서의 약 1.8%포인트 차이만 강조한다.
토큰 절약과 시스템 비용은 별개다
"추론 토큰 0"은 저장소 문맥을 프롬프트에 추가하지 않는다는 뜻이다. 전체 비용이 0이라는 뜻은 아니다. Static 하이퍼네트워크는 약 7억2천만, Evo는 약 7억4천5백만 학습 파라미터를 가진다. 연구진은 단일 H100 80GB에서 3 epoch를 훈련했다.
그래서 이 방식은 작은 팀이 저장소 하나를 위해 바로 붙이는 플러그인이라기보다, 많은 저장소에 반복해서 적용할 생성기를 먼저 훈련하는 접근에 가깝다. 호출량이 많고 긴 문맥 주입 비용이 계속 쌓이는 서비스라면 계산이 맞을 수 있다. 저장소가 몇 개뿐이거나 근거 파일을 사람이 확인해야 하는 작업이라면 RAG의 투명성이 더 실용적일 수 있다.
정확 일치율만으로 코드 이해를 증명할 수는 없다
평가는 Python 저장소, Qwen2.5-Coder-1.5B, assertion completion 한 종류에 한정됐다. 정확 일치는 실행 결과가 같은 다른 표현을 오답으로 처리한다. 논문은 EditSim과 CodeBLEU를 함께 보고하고 일부 실행 probe도 했지만, 모든 생성 assertion을 실제 프로젝트에서 실행한 것은 아니다.
또한 저장소 지식이 파라미터에 들어가면 출처 경계가 흐려질 수 있다. 개인 저장소를 넣었을 때 긴 코드를 그대로 내보내거나 라이선스가 다른 학습 코드를 닮은 결과를 만들 위험도 남는다. 연구진도 프로덕션 안전성을 주장하지 않는다.
실무에서는 세 질문부터 답해야 한다
첫째, 병목이 정말 입력 토큰인가. 검색한 파일 몇 개로 충분하다면 복잡한 어댑터 생성기를 운영할 이유가 약하다. 둘째, 저장소 변경을 얼마나 자주 반영해야 하는가. 주기적 스냅샷이면 충분한지, 커밋 순서가 필요한지 구분해야 한다. 셋째, 답의 근거 파일을 보여 줘야 하는가. 코드 리뷰나 보안 감사에서는 성능보다 추적 가능성이 더 중요할 수 있다.
검증 계획도 따로 둬야 한다. 기존 저장소와 처음 보는 저장소를 분리하고, 오래된 커밋으로 만든 어댑터가 새 변경에서 얼마나 깨지는지 재며, 정확 일치뿐 아니라 실제 테스트 실행률을 본다. 토큰 감소량에는 저장소 인코딩과 어댑터 생성 비용을 함께 넣어야 한다.
참고 자료와 작성 범위
이 글은 AI를 활용해 공개 논문, 코드 아티팩트, 데이터 페이지를 대조해 쓴 해설입니다. 제품 후기나 독립적인 모델 재실행이 아닙니다. 표의 수치는 논문에서 다시 옮겼으며, RepoPeftBench 전체를 별도로 재채점하지 않았습니다.


댓글
댓글 쓰기