멀티모달 정렬 점수가 높아도 이미지를 읽었다는 뜻은 아니다: PA gap의 쓰임과 한계
이미지와 질문을 함께 처리하는 모델에서 시각 토큰과 텍스트 토큰의 내부 표현이 비슷해지면, 모델이 이미지를 잘 이해했다고 말하기 쉽습니다. 하지만 비슷한 좌표에 놓였다는 사실과 그 이미지가 해당 질문의 답에 도움이 됐다는 사실은 다릅니다. 이번 글은 Wang·Wang·Ding의 arXiv v1 프리프린트가 제시한 개입 실험을 바탕으로, 평가자가 정렬 점수를 읽을 때 던져야 할 반례와 비교 순서를 정리합니다. 동료 심사를 거친 확정 결과로 소개하지 않습니다.
독자의 실무 질문은 ‘우리 모델의 정렬 곡선이 올라갔는데, 이를 이미지 사용의 증거로 보고해도 되는가?’입니다. 답은 내부 점수 하나로는 불가능하다는 것입니다. 이 연구가 다룬 것은 비전 인코더의 출력을 projector로 언어모델 토큰 공간에 옮긴 뒤, 시각·텍스트 토큰이 같은 LLM 층을 통과하는 구조입니다. 연구팀은 다섯 계열의 모델 체크포인트 13개(0.5B~72B)에 대해 MMBench의 동일한 질문–이미지 객관식 쌍 1,000개를 조건별로 평가했습니다. 13,000개의 독립 질문을 새로 수집한 실험이라고 읽어서는 안 됩니다.
① 정렬이 유지돼도 정답은 무너질 수 있다
연구의 첫 개입은 이미지 자체를 흐리게 만드는 방식이 아닙니다. projector 출력의 시각 토큰을 각각 등방성 가우시안 노이즈 벡터로 바꾸되, 원래 토큰의 노름에 맞춰 크기를 다시 조정합니다. 이렇게 하면 크기 변화의 영향을 줄이고 내용·방향을 제거한 경우를 볼 수 있습니다. 원본(Orig)과 노이즈(Noise)를 같은 질문에서 비교하자, 모델별 정확도 차이 Noise − Orig의 교차 모델 중앙값은 −45.2 퍼센트포인트(pp), 사분위 범위는 −46.6~−43.2pp였습니다(논문 §4 Table 2). 이는 ‘정확도가 45.2% 상대적으로 감소’했다는 뜻이 아닙니다.
반면 첫 번째 주각 코사인 σ₁, CKA, SVCCA, MIR 같은 단일 요약 점수는 원본과 내용이 사라진 노이즈를 일관되게 분리하지 못했습니다(§3.1 Figure 2). 특히 노이즈 상태에서도 깊은 층의 첫 코사인이 높을 수 있습니다. 시각 토큰과 텍스트 토큰이 같은 LLM 가중치를 통과하면, 유용한 이미지 정보가 없어도 공통 방향이 생길 수 있다는 것이 논문의 해석입니다. MLP를 우회했을 때 첫 코사인의 변화가 attention을 우회했을 때보다 13개 모델 모두에서 컸고, 그 효과 크기 비율의 교차 모델 중앙값은 3.5배였습니다(§3.2 Figure 3B). 이 개입은 해당 모델군에서 공유 MLP 경로의 역할을 뒷받침하지만 모든 멀티모달 구조의 보편 법칙을 입증하지는 않습니다.
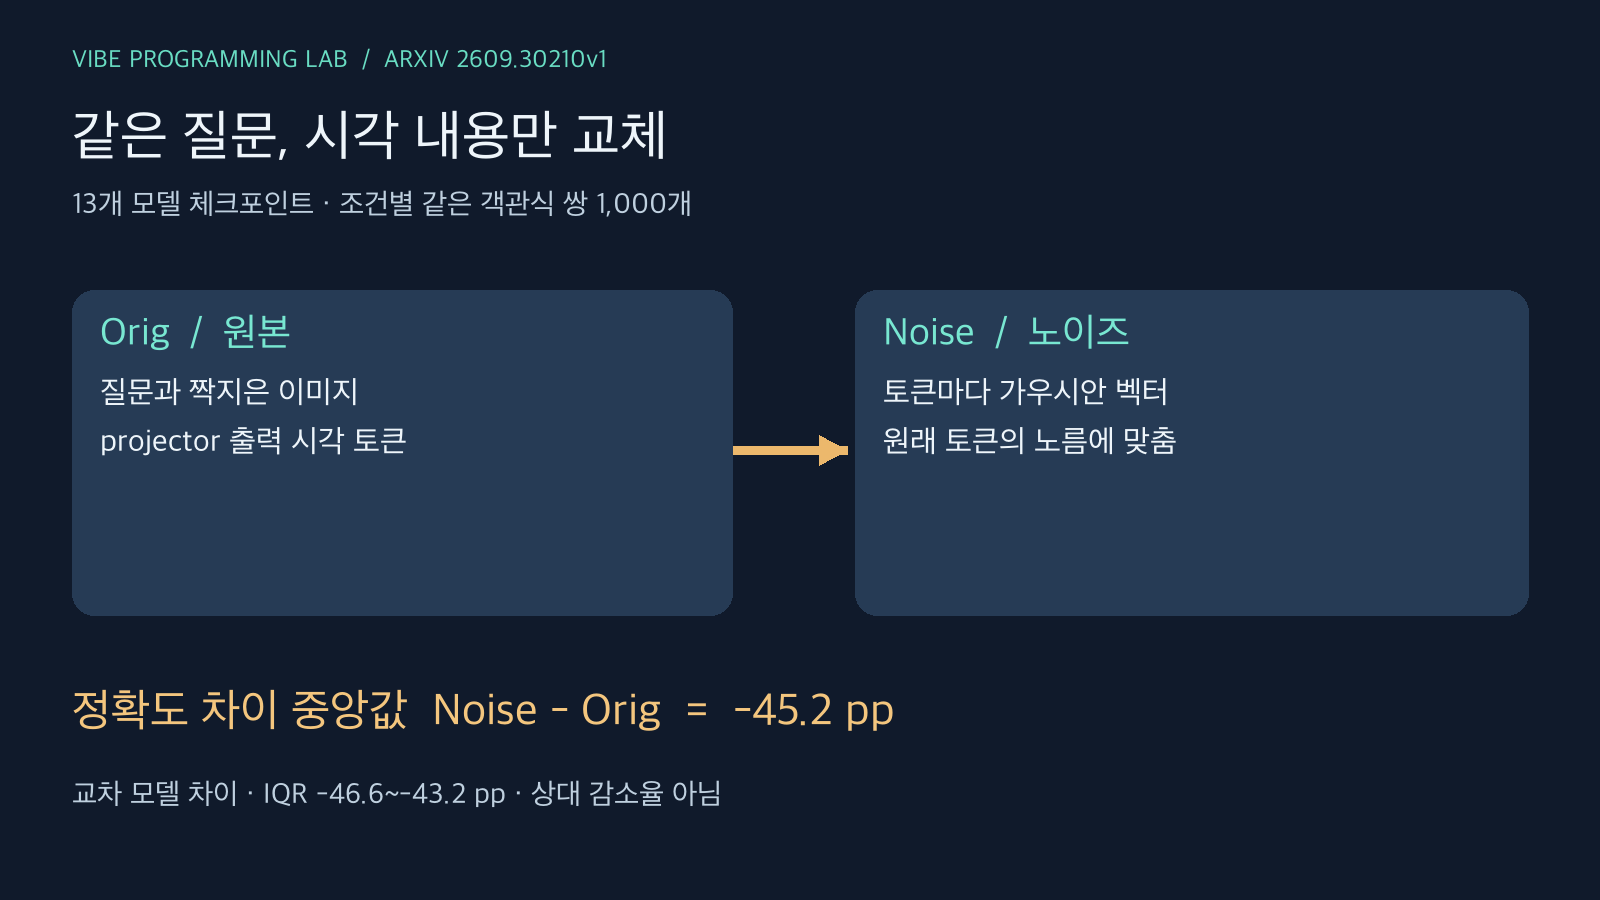
같은 1,000개 객관식 쌍의 조건을 바꾼 논문 §3.1·Table 2를 개념 도식화했다. −45.2pp는 13개 모델의 차이 중앙값이며 독립 재실험이나 상대 감소율이 아니다. 출처: arxiv.org/html/2609.30210v1.
② PA gap은 ‘높은 한 방향’과 ‘여러 방향’을 구분한다
논문이 제안하는 principal-angle gap(PA gap)은 시각·텍스트 PCA 부분공간 사이의 상위 두 주각 코사인의 차이 σ₁ − σ₂입니다(§3.3 Definition 2). 한 방향만 크게 겹치면 gap이 커지고, 둘째 방향까지 겹치면 작아집니다. 이 연구 설정에서는 작은 gap이 더 다방향적인 정렬을 뜻합니다. 점수 이름이 ‘gap’이라는 이유로 클수록 좋다고 해석하면 방향을 거꾸로 읽습니다. 높은 σ₁ 하나는 공유 가중치의 지배적 방향만 반영할 수도 있습니다.
논문의 방향성 순위 규칙에서는 PA gap이 원본을 노이즈보다 앞세운 모델이 13/13, 원본을 무관 이미지(Irr)보다 앞세운 모델도 13/13이지만, 원본·무관 이미지·노이즈의 완전한 세 조건 순위는 12/13입니다(§4 Table 3). 두 개의 13/13을 합쳐 세 조건 전체가 13/13이었다고 주장하면 안 됩니다. Table 3의 순위에는 모델별 범위의 최소 5% 차이를 요구하는 방향성 규칙이 적용됩니다.
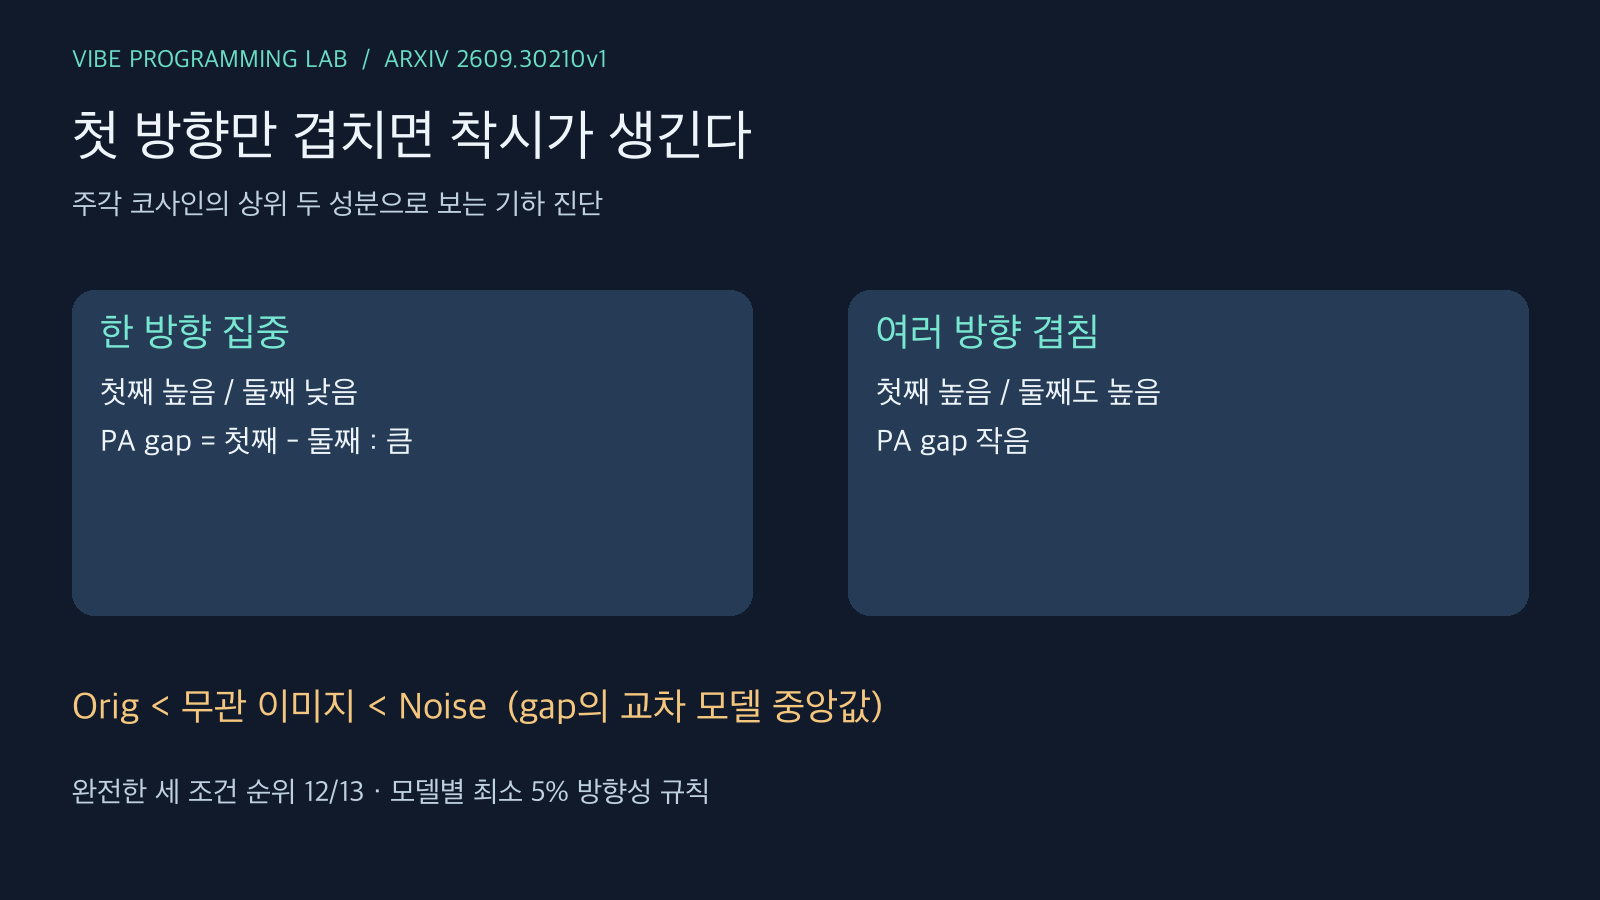
§3.3 Definition 2와 §4 Table 3을 개념적으로 다시 그렸다. 상자는 측정된 고유 스펙트럼 그림이 아니며 완전 순위는 12/13이다. 출처: arxiv.org/html/2609.30210v1.
원본 시각 토큰과 노이즈를 단계적으로 섞는 실험에서는 PA gap과 정확도의 Pearson 상관계수 절댓값의 교차 모델 평균이 0.894, 중앙값이 0.917, 최솟값이 0.655였습니다. |r|>0.80인 모델은 12/13이고 예상한 부호는 13/13입니다(§3.4 Table 1). 이것은 개입 혼합 비율에 걸친 각 모델의 연관성이지 모델 정확도 89.4%가 아닙니다. 부록 E Table 11에 따르면 일부 모델의 혼합 비율 측정 지점은 11개가 아닌 6개이므로 모든 모델이 동일한 촘촘한 격자에서 측정됐다고 쓰지 않습니다.
③ 구조가 있어도 질문과 무관하면 gap만으로 정답을 보증할 수 없다
노이즈는 이미지 구조까지 없애므로 ‘구조 있는 정보’와 ‘질문에 유용한 정보’를 한 번에 비교하기 어렵습니다. 연구진은 같은 데이터셋의 다른 질문과 짝지은 무관 이미지 조건도 시험했습니다. 13개 모델 정확도의 조건별 중앙값은 원본 85.4%, 무관 이미지 36.1%, 노이즈 39.0%입니다(§4.3 Figure 6; Appendix A Table 8). 이 숫자들은 각각의 모델 정확도를 다시 모델들 사이에서 요약한 것이지 13개 모델의 전체 정답을 합친 비율이 아닙니다.
무관 이미지의 내부 기하는 노이즈보다 다방향적이지만, 정답률은 오히려 낮은 범위에 머뭅니다. 논문 Table 3에 제시된 PA gap 교차 모델 중앙값은 원본 0.130, 무관 이미지 0.213, 노이즈 0.324 순서입니다. 여기서 0.213이 0.324보다 낮다는 사실은 무관 이미지가 질문의 정답에 더 유용하다는 뜻이 아닙니다. 즉 이 지표는 시각 스트림의 구조적 전달을 진단하는 데 쓸 수 있어도 답변 관련성을 단독 인증하지 못합니다. 연구진이 텍스트 전용(Text) 기준선과 토큰 순서 섞기(Shuf) 통제를 함께 둔 이유도 입력의 내용·구조·과제 관련성 효과를 분리하려는 데 있습니다.
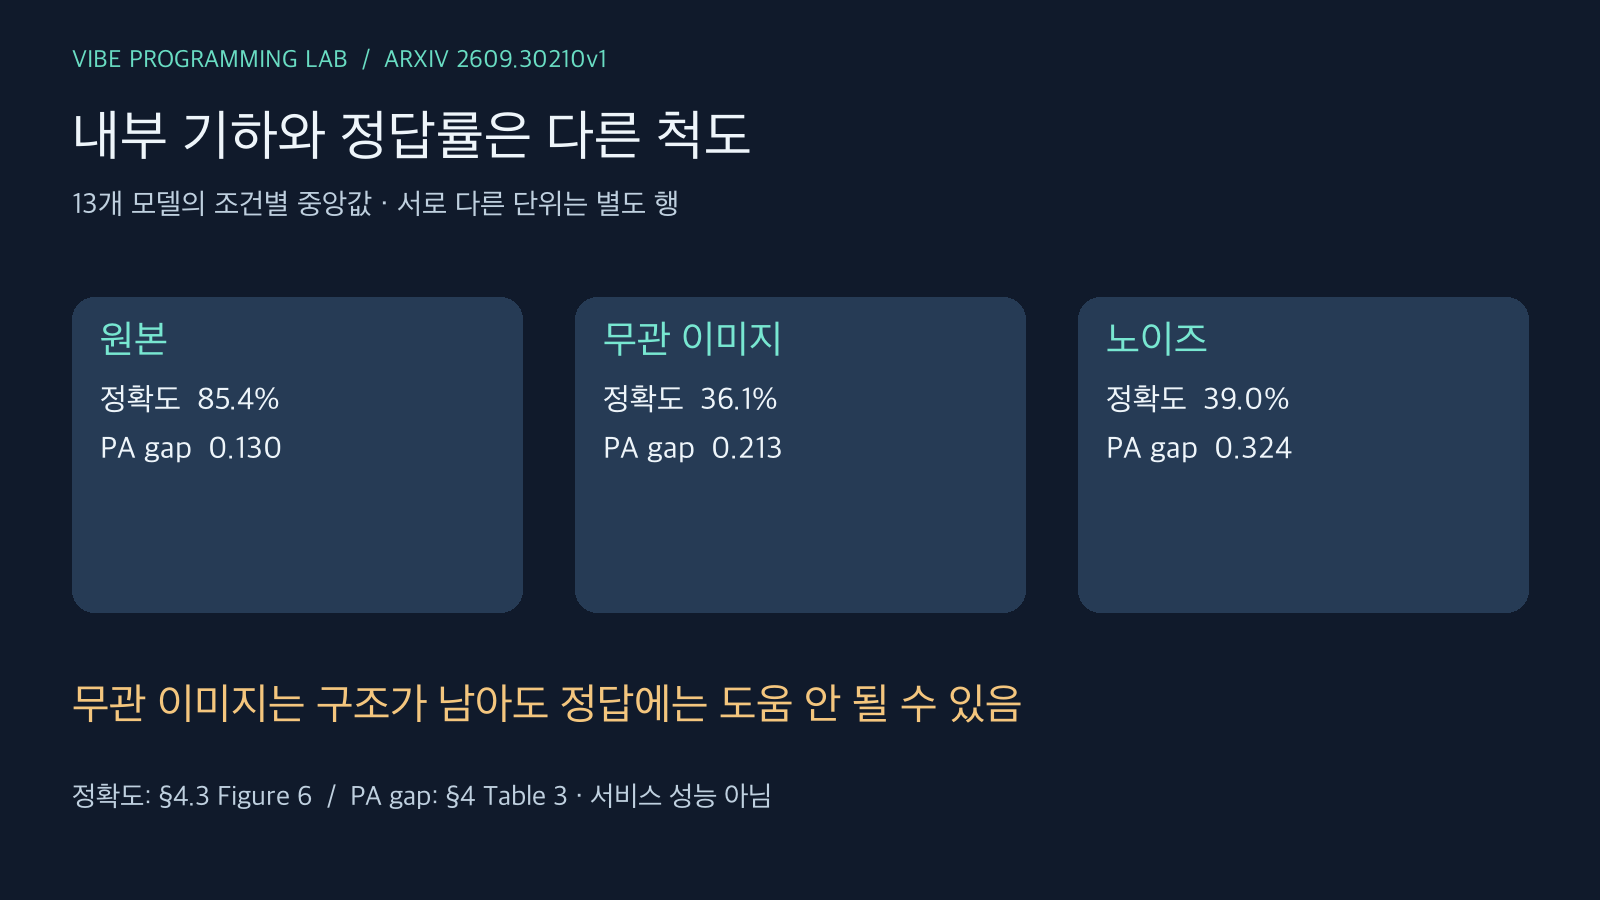
§4 Table 3·Figure 6의 서로 다른 단위와 교차 모델 중앙값이다. 무관 이미지의 낮은 gap이 정답 관련성의 증거가 아니라는 반례. 출처: arxiv.org/html/2609.30210v1.
평가 보고서에 넣을 세 칸 판단표
아래 표는 논문의 실험 조건을 바탕으로 제가 재구성한 편집상 판단 도구입니다. 새 모델 실험 결과나 저자들의 공식 의사결정 표가 아닙니다.
| 관찰 | 바로 말할 수 있는 것 | 아직 확인할 것 |
|---|---|---|
| 원본과 노이즈에서 정렬 점수가 비슷하다 | 점수만으로 시각 내용의 보존을 구별하지 못한다 | 같은 질문에서 원본·노이즈 정확도를 짝지어 비교 |
| PA gap이 작다 | 여러 방향의 내부 기하가 남아 있다 | 무관한 이미지를 넣어도 답이 맞는지 확인 |
| 무관 이미지에서 정확도가 낮다 | 구조 있는 시각 입력이 정답에 도움이 된다는 보장은 없다 | 텍스트 전용 기준선과 과제별 오류를 함께 보고 |
실제로 보고서를 작성한다면 먼저 측정 단위를 고정해야 합니다. 정확도는 같은 1,000개 질문에서 조건별로 측정한 각 모델의 값인지, 모델 간 차이의 중앙값인지 구분하고, 백분율과 pp도 분리합니다. 그다음 원본 대비 노이즈의 정확도와 정렬 점수를 나란히 적습니다. PA gap을 쓴다면 σ₁만 높아 생긴 착시인지 둘째 방향도 따라오는지 확인하고, 무관 이미지 조건을 별도 행으로 남깁니다. 마지막으로 현재 과제 밖에 이 결론을 적용할 때는 검증되지 않은 영역을 적습니다. 데이터가 준비되지 않았다면 ‘이미지를 활용했다’는 단정 대신 ‘내부 기하만 관찰했다’고 표현하는 것이 더 정확합니다.
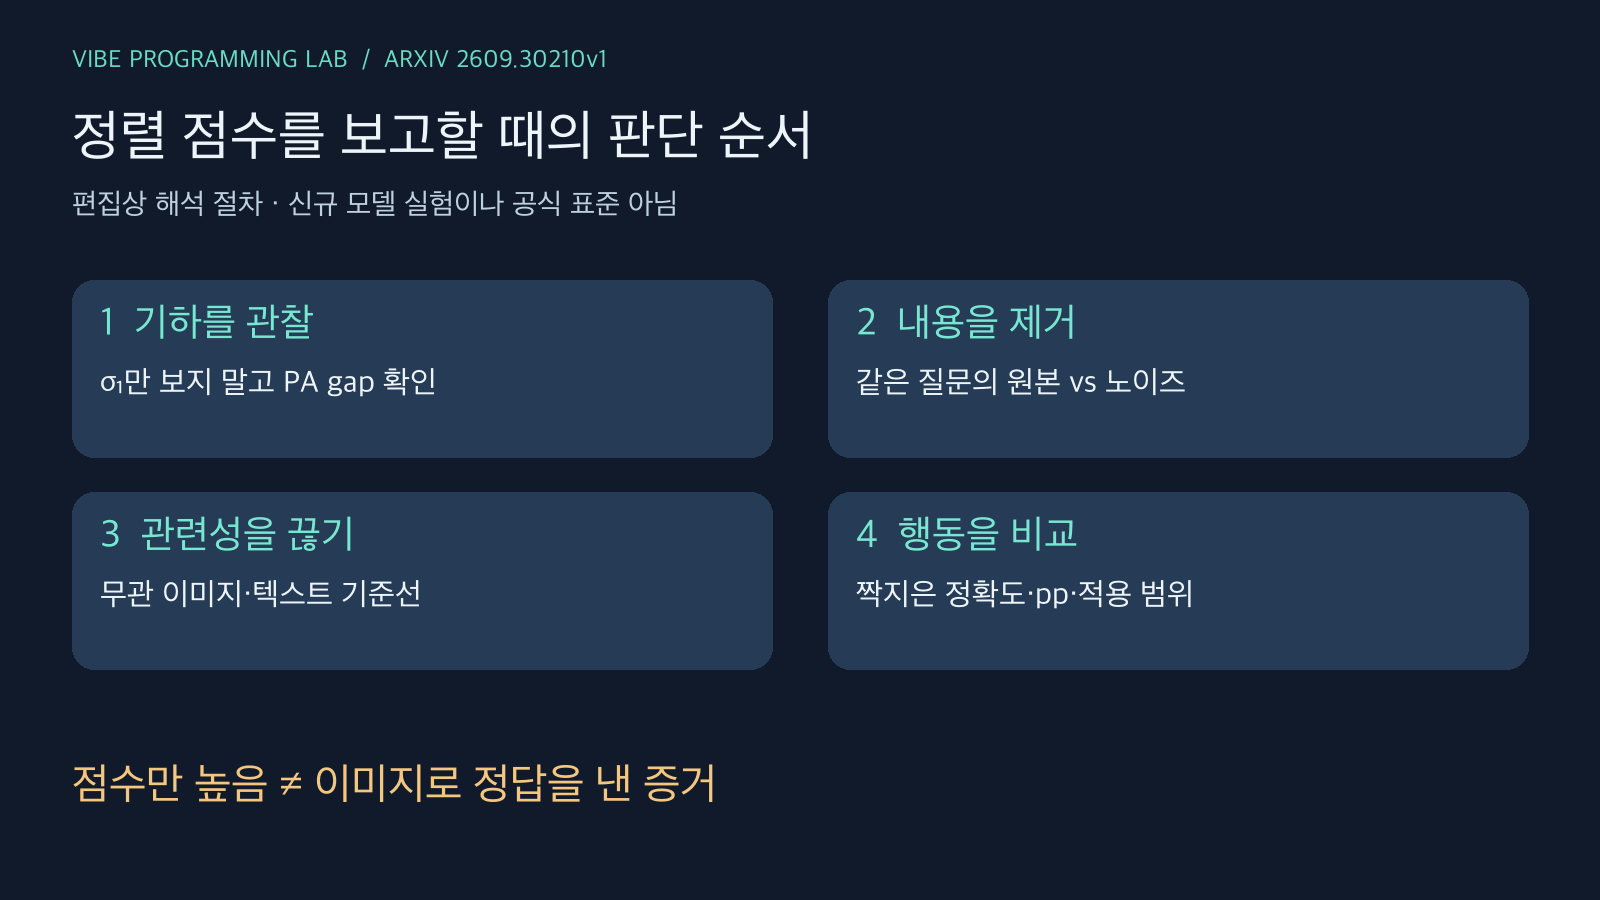
원문 §3–5에서 독자용으로 재구성한 편집 판단 순서다. 저자의 운영 표준이나 새 모델에서 검증한 절차가 아니다. 출처: arxiv.org/html/2609.30210v1.
적용 범위와 읽을 때의 주의점
이 판단표는 논문의 제한된 projector–LLM·MMBench 객관식 실험을 해석한 도구이며, 실제 서비스·다른 융합 구조·영상·문서·에이전트 작업에서의 성능을 검증하지 않았습니다. 특히 무관 이미지의 구조가 보인다는 것과 질문의 답을 돕는다는 것은 다른 주장입니다. 논문은 arXiv v1 프리프린트이며, 이 글은 원문과 보존된 본문 증거를 검토한 해설이지 저자 모델을 다운로드해 재실행하거나 독립적으로 다른 데이터셋에서 재현한 보고서가 아닙니다. 공개 HTML에서 저자 코드 링크를 찾지 못한 관찰만으로 코드가 없다고 단정하지도 않습니다.
이 연구의 유용한 교훈은 특정 새 점수를 만능 지표로 교체하라는 것이 아닙니다. 내부 정렬은 기하의 증거, 통제 개입과 과제 정확도는 행동의 증거로 분리해서 기록하라는 것입니다. 전자가 높아도 후자를 건너뛸 수 없고, PA gap이 더 잘 정렬된 경우에도 무관 이미지 반례를 통과해야 답의 관련성을 주장할 수 있습니다.
원문과 수치 위치
- Hong-Han Wang, Yuntao Wang, Hu Ding, 「The Alignment Illusion in Multimodal Large Language Models」, arXiv:2609.30210v1 (2026-09-24), 초록·버전, HTML 본문. §3.1 Figure 2(노이즈 개입), §3.2 Figure 3(공유 경로), §3.3 Definition 2(PA gap), §3.4 Table 1(혼합 상관), §4 Table 2·Table 3·Figure 6(정확도·방향성), Appendix A·E(평가 프로토콜·혼합 지점), §5(한계).


댓글
댓글 쓰기