Python import 5.5ms를 믿으면 놓치는 것: PyPI 500개 패키지 6만3431회 측정
Python 명령줄 도구가 굼뜨면 네트워크나 본문 로직부터 의심하기 쉽다. 하지만 짧게 실행되는 CLI, 테스트 worker, 새 컨테이너에서는 import가 실행 시간의 큰 몫을 차지한다. 문제는 우리가 흔히 보는 import 벤치마크가 이미 만들어진 바이트코드를 재사용하는 warm 상태, 그것도 패키지 최상위 모듈 하나만 재는 경우가 많다는 점이다.
9월 2일 공개된 논문 「The Import Tax」는 이 빈틈을 꽤 큰 규모로 측정했다. PyPI 다운로드 상위 500개 패키지의 릴리스 이력을 2021년 3분기부터 분기별로 뽑고, CPython 3.9부터 3.14까지 여섯 버전에서 실행했다. Apple M5·macOS와 Intel Xeon·Linux를 따로 돌려 성공한 측정은 63,431건이다. 결론은 단순히 "Python import가 느리다"가 아니다. 평균적인 패키지는 빠르지만, cold start와 일부 무거운 패키지가 사용자 체감을 결정한다.
요약: 중앙값 하나로는 startup을 설명할 수 없다
macOS의 CPython 3.12에서 최신 패키지의 warm top-level import 중앙값은 5.5ms였다. 여기까지만 보면 별일 없어 보인다. 그러나 90백분위는 42ms, 99백분위는 354ms였고 litellm은 781ms였다. 머신러닝·클라우드 SDK가 느린 쪽에 많이 모였다.
설치 직후 첫 실행은 더 비쌌다. 소스를 .pyc로 컴파일하는 비용이 붙어 cold import가 warm 중앙값보다 전체 중앙값 기준 3.0배, 90백분위 기준 22.4배 길었다. scikit-learn은 warm 322ms에서 cold 7.9초로 뛰었다. 개발 노트북에서 두 번째 실행만 재고 "충분히 빠르다"고 결론 내리면 CI와 serverless의 첫 요청을 놓칠 수 있다.
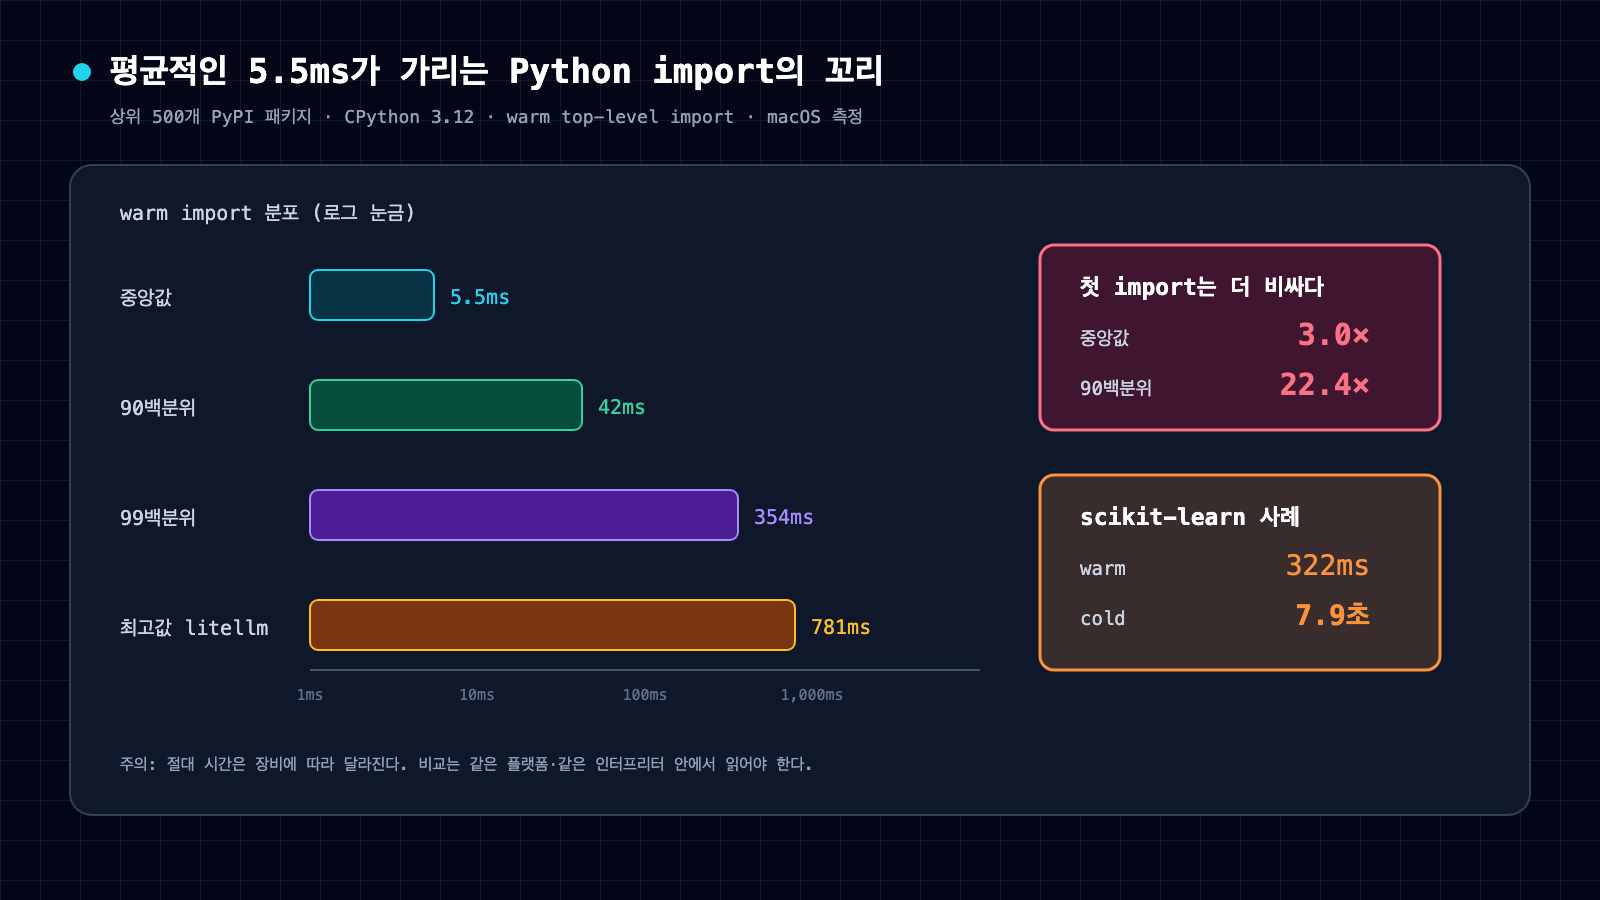
warm top-level 중앙값은 짧지만 꼬리는 길다. 첫 설치 뒤 cold import는 전체 중앙값 3.0배, 90백분위 22.4배였다. 출처: arxiv.org/html/2609.02753v1.
6만3431회 측정은 어떻게 만들어졌나
연구자는 각 패키지·릴리스·인터프리터 조합마다 새 가상환경을 만들고 uv로 정확한 패키지 버전을 설치했다. 그 뒤 새 Python 프로세스를 일곱 번 띄웠다. 첫 실행은 cold 값으로 분리하고, 나머지 여섯 번의 중앙값을 warm 값으로 썼다. 한 프로세스의 module cache가 다음 반복에 섞이지 않도록 한 설계다.
최상위 모듈만 재는 실험도 보완했다. import pkg가 거의 빈 껍데기인 패키지가 있어서, 공개된 1단계 submodule을 함께 불러오는 eager workload를 별도로 측정했다. eager 비용은 top-level import의 중앙값 1.7배였지만 90백분위에서는 294배였다. aiobotocore는 최상위가 0.07ms에 불과했지만 1단계 submodule까지 읽으면 88ms였다. 빠른 facade와 실제 사용 비용은 다른 숫자다.
측정 과정에서 나온 방법론적 실패도 눈여겨볼 만하다. 연구자는 시간을 줄이려고 여러 설치 작업을 병렬로 돌리되 측정 구간만 lock으로 직렬화해 봤다. 반복값의 변동계수는 3.4%로 낮았지만, 완전 직렬 실행과 같은 35개 cell을 비교하자 병렬 환경의 값이 중앙값 12%, 90백분위 35% 부풀었다. 낮은 분산이 낮은 bias를 보장하지 않은 셈이다. 논문은 병렬 측정값을 버리고 전체 캠페인을 직렬로 다시 수행했다.
새 Python이 항상 import까지 빠른 것은 아니다
같은 패키지 코드를 여섯 인터프리터에서 비교했을 때 플랫폼 결과가 갈렸다. macOS arm64에서는 CPython 3.14의 warm import가 3.9보다 중앙값 1.16배 느렸다. Linux x86-64에서는 3.14가 1.07배였고 3.13은 3.9와 거의 같았다. 연구자는 이 차이의 원인을 특정하지 않았다. 따라서 "3.14가 import를 16% 느리게 만든다"를 모든 환경에 적용하면 안 된다.
point release 차이는 더 컸다. 같은 Linux 장비에서 CPython 3.11.5는 3.11.16보다 중앙값 1.34배 느렸다. 이 차이는 논문이 본 major version 간 변화보다 컸다. Python 버전을 3.11이라고만 기록한 벤치마크는 재현에 필요한 정보를 하나 빼먹은 것이다. OS, CPU, 저장장치, 정확한 patch version을 같이 남겨야 한다.
PEP 810의 lazy import가 돌려준 비용
PEP 810은 Python 3.15에 명시적 lazy import를 넣는다. 논문은 3.15.0rc1의 global lazy mode로 최신 패키지 414개를 따로 검사했다. lazy mode에서 import 문 자체는 거의 공짜가 됐고, 처음 속성에 접근해 모듈을 실제로 불러오는 비용도 정상 import의 중앙값 0.07배였다. 모듈 내부의 transitive import까지 뒤로 밀려, 프로그램이 패키지 일부만 쓰면 끝내 지불하지 않는 비용이 생기기 때문이다.
호환성 비용도 확인됐다. 정상 모드에서 import되던 414개 중 8개는 global lazy mode에서 실패했다. 논문은 httpcore, openai, orjson, google-crc32c, anthropic, google-cloud-aiplatform, mpmath, truststore를 열거했다. 확인된 실패는 C extension type 등록이나 module-level 설정처럼 import 시점의 side effect가 재배치되는 문제와 관련됐다. 이 결과는 "lazy를 전역으로 켜면 98%는 안전하다"는 보증이 아니다. 한 장비에서 각 패키지의 최신 버전을 본 호환성 census다.
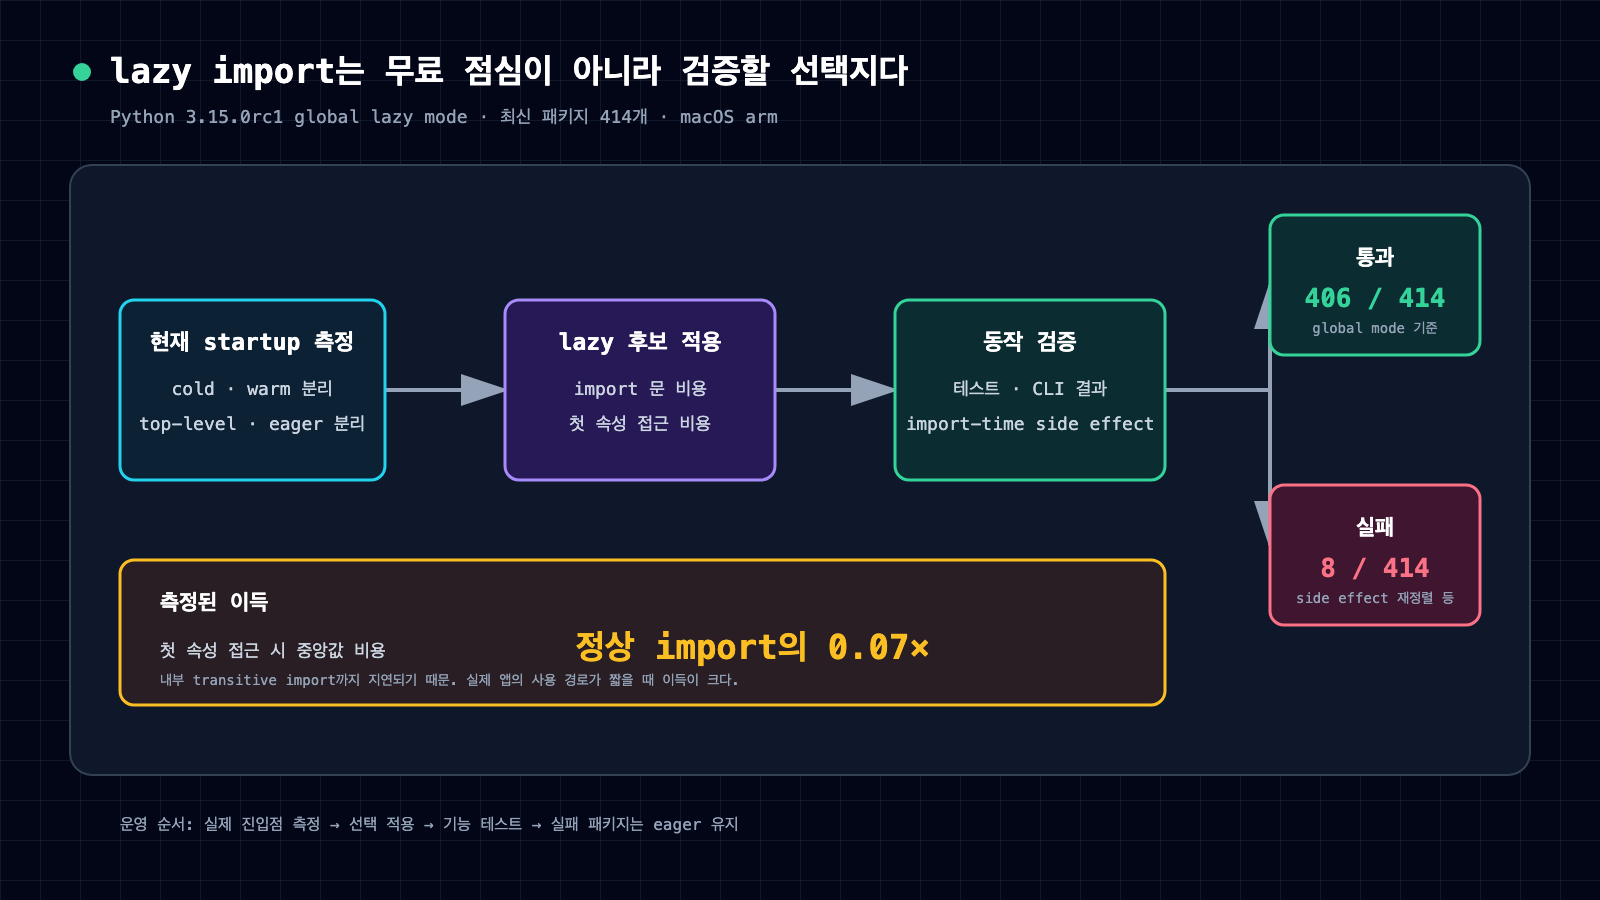
global lazy mode는 첫 속성 접근 비용을 정상 import의 중앙값 0.07배로 줄였지만, 414개 중 8개 패키지는 import-time side effect 재배치 등으로 실패했다. 출처: arxiv.org/html/2609.02753v1.
실전 적용: 평균보다 내 진입점을 먼저 잰다
CLI와 batch job은 실제 entry point를 cold 상태에서 재야 한다. 새 가상환경이나 깨끗한 container layer에서 첫 실행 시간을 기록하고, 같은 명령을 반복해 warm 값과 나눈다. python -X importtime trace를 남기면 어떤 transitive import가 시간을 쓰는지도 볼 수 있다. 최상위 import만 빠른 패키지는 실제 command가 접근하는 submodule까지 포함해 재야 한다.
lazy import는 측정 뒤에 좁게 적용하는 편이 낫다. 시작 경로에 있지만 자주 쓰지 않는 모듈을 후보로 잡고, CLI 출력과 테스트 결과, plugin 등록, C extension 초기화를 확인한다. 오류가 난 패키지는 eager로 유지한다. 전역 switch를 먼저 켠 뒤 깨진 side effect를 하나씩 찾는 방식은 startup 절감액보다 디버깅 비용이 커질 수 있다.
회귀 검사는 같은 runner와 정확한 Python patch version에 묶는다. 중앙값만 두지 말고 cold·warm, top-level·실제 workload를 나눠 기록한다. 이번 연구처럼 병렬 설치가 cache와 memory bandwidth를 건드릴 수 있으므로 microbenchmark는 직렬로 돌리고, 별도의 end-to-end CI 시간으로 효과를 다시 확인해야 한다.
예산을 잡을 때는 패키지별 숫자를 더하는 것보다 사용자 경로를 통째로 재는 편이 정확하다. 여러 모듈이 같은 dependency를 공유하면 import cache 때문에 단순 합산이 실제보다 커지고, 조건부 plugin이나 command별 submodule은 반대로 누락되기 쉽다. --help, 가장 자주 쓰는 짧은 명령, 무거운 작업을 시작하는 명령을 나눠 첫 실행과 반복 실행을 재면 어느 경로에서 lazy loading이 실제 체감으로 이어지는지 알 수 있다.
패키지 관리자는 top-level namespace를 가볍게 만들되 숫자를 숨기는 최적화에 머물면 안 된다. 빈 facade 뒤에서 첫 속성 접근이 크게 튀면 비용이 사라진 것이 아니라 이동한 것이다. release 전 벤치마크에는 import 문, 첫 공개 API 접근, 대표 기능 한 번 수행까지 세 지점을 두고, 지연된 예외가 사용자 요청 중간에 나타나지 않는지도 확인할 필요가 있다.
범위와 주의점
절대 millisecond 값은 두 시험 장비에 종속된다. Linux 실험은 network storage를 썼고 warm 반복의 중앙 변동계수가 macOS 0.9%보다 큰 4.7%였다. 과거 패키지 릴리스도 당시 dependency lock이 아니라 2026년에 해석 가능한 최신 transitive dependency와 함께 설치됐다. top-level+1단계 submodule 역시 실제 애플리케이션의 import graph와 같지 않다.
데이터와 harness는 논문에 "요청 시 제공"으로 적혀 있어, 이 글에서는 원시 결과를 독립 재계산하지 못했다. 대신 논문의 실험 설계, 표와 본문 수치, 공식 PEP의 상태와 Python 대상 버전을 대조했다. 이 한계 때문에 특정 패키지의 절대값을 SLA로 복사하기보다, 자기 진입점에서 cold와 warm을 분리하는 측정법을 가져오는 편이 안전하다.
참고 자료
- https://arxiv.org/abs/2609.02753v1
- https://arxiv.org/html/2609.02753v1
- https://peps.python.org/pep-0810/


댓글
댓글 쓰기