ROFT: 에이전트가 자기 설명으로 학습할 때, 행동 보상 없이 무엇이 달라지나
코딩 에이전트가 과제를 풀고 실패 이유를 설명했다면, 그 설명을 다시 읽게 하는 것만으로 다음 풀이가 나아질까? ROFT 논문 v1은 에이전트 자신의 성공·실패 회고 문장만 다음 토큰 예측의 학습 대상으로 삼는 방법을 보고한다. 흥미로운 점은 보상 점수로 정책을 업데이트하는 강화학습이 아니라는 사실보다, 행동 토큰에는 직접 손실을 주지 않았는데도 별도 과제의 해결률이 달라졌다는 관찰이다. 그러나 이 결과를 “자기반성이 RL을 같은 비용에서 이겼다”로 읽으면 훈련 예산과 데이터 선택의 중요한 차이를 놓친다.
회고를 학습하고, 시험할 때는 회고를 들고 가지 않는다
논문의 §2.2와 부록 B.2·B.4를 따라가면 흐름은 과제 → 에이전트의 풀이 시도 → 성공·실패 피드백 → 같은 모델이 생성한 사후 설명 → 설명 토큰의 다음 토큰 학습이다. 과제와 행동, 피드백은 조건으로 주어지지만 직접 예측할 목표 토큰에서는 마스킹된다. 문맥을 거쳐 기울기가 흐를 수 있으므로 “행동과 전혀 무관한 학습”이라는 뜻도 아니다. 성공한 시도와 실패한 시도 모두 회고 후보가 되며 기본 설정에서는 한 시도당 독립적으로 네 개의 회고를 생성한다. 설명의 의미적 품질을 따로 판별하는 필터가 있었다고 가정해서도 안 된다.
평가 때 저장해 둔 회고를 답안에 붙여 주는 검색 증강 방식이 아니다. 학습 뒤 에이전트는 회고 없이 다시 과제를 푼다. 따라서 이 실험이 보이는 것은 회고 텍스트를 생성하고 지도한 훈련 과정과 이후 풀이 성능의 연관이지, 매 실행 시 “잠깐 반성해 봐”라는 프롬프트 한 줄의 효과가 아니다. 조직에서 같은 방법을 검토한다면 실패 로그를 모으는 데서 멈추지 말고, 어느 토큰을 목표로 학습하고 추론 시 어떤 문맥을 제거하는지 확인해야 한다.
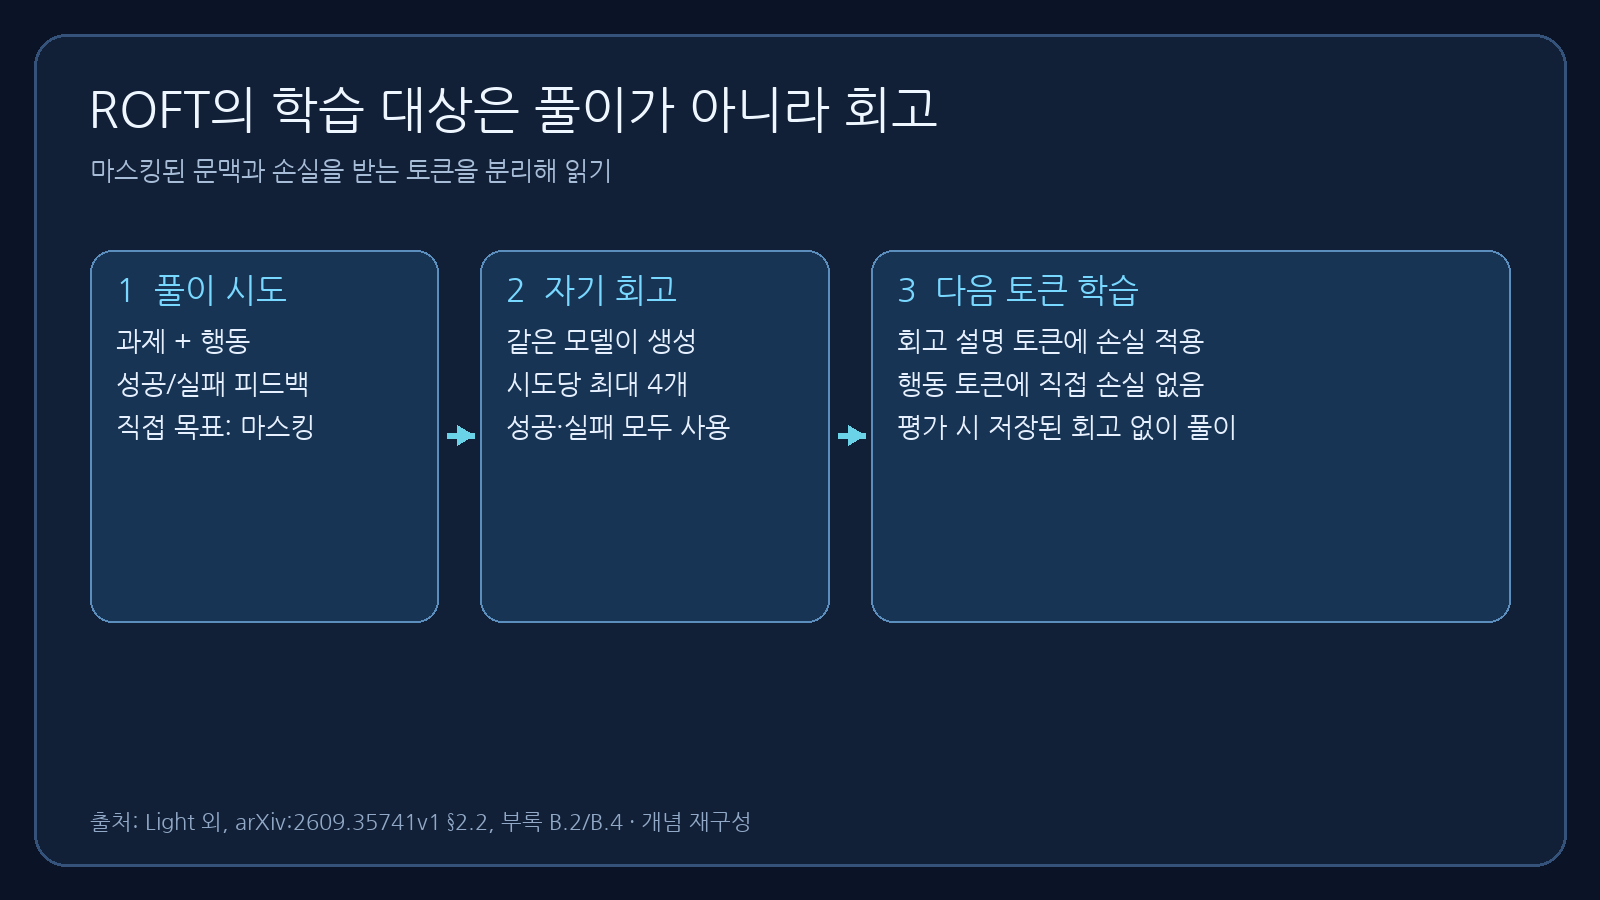
ROFT는 풀이 행동 대신 자체 회고 설명 토큰에 직접 손실을 준다. 행동은 문맥으로 영향을 줄 수 있으며 평가 때 저장된 회고를 제공하지 않는다. 출처: arxiv.org/html/2609.35741v1.
49.2%와 48.0%: 결과보다 비교 조건을 먼저 읽기
주요 실험은 Qwen3.5-4B가 초기 세 번의 시도에서 성공과 실패를 모두 낸 767개 SWE-rebench 훈련 문제를 골랐다. 이는 보상 학습 비교군 GRPO가 성공과 실패의 차이를 이용하기 쉬운 선택이다. 평가는 별도의 500개 SWE-bench Verified 과제에서 이뤄졌다. 논문의 수치는 출발 모델 44.2%, ROFT 20업데이트 뒤 246/500, 49.2%, GRPO 40업데이트 뒤 240/500, 48.0%다. 출발 모델의 221/500은 44.2%에 500을 곱해 역산한 값이며, 논문의 같은 문장에서 직접 보고된 정수 분자처럼 제시하지 않는다.
ROFT와 GRPO의 업데이트 수가 다르다. 논문의 §3.1·그림 5·부록 E.1은 40업데이트 시 ROFT 4.32시간·완료된 풀이 시도 6,035회, GRPO 8.30시간·11,576회라고 보고한다. 또한 ROFT 10업데이트 시점의 49.0%·1.29시간을 GRPO 40업데이트의 48.0%·8.30시간과 대조한다. 이것은 연구진 환경에서 관찰된 효율 비교이지 같은 시도 수, 같은 회고 생성 수 또는 동일 연산량에서 측정한 승패가 아니다. 두 방식 모두 훈련용 B200 GPU 네 장과 추론용 B200 네 장을 사용했지만, GRPO의 동일 보상 그룹은 버리고 다시 시도하는 반면 ROFT는 시도마다 최대 네 개의 회고를 생성한다. 위 시도 수에는 GRPO에서 거절된 완료 시도도 들어가지만 회고 생성은 들어가지 않는다. 시간에는 회고 비용이 들어가고 평가·다운타임은 빠져 있다.
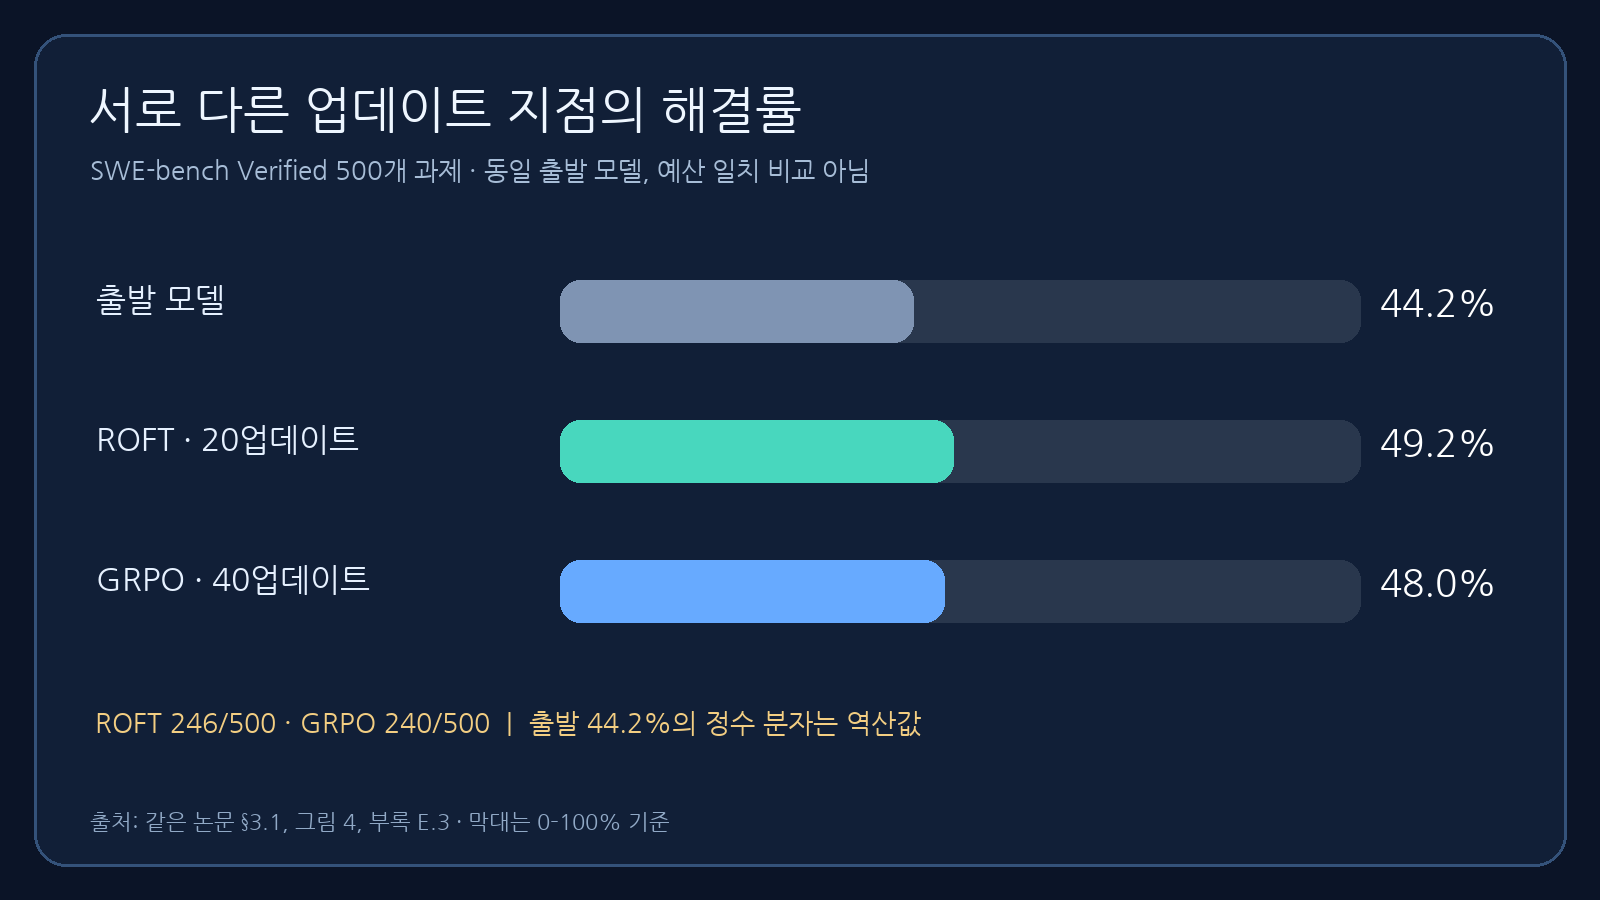
ROFT 246/500과 GRPO 240/500은 업데이트 수와 훈련 예산이 다른 지점의 저자 보고 결과다. 막대는 동일한 0–100% 척도다. 출처: arxiv.org/html/2609.35741v1.
왜 실패 사례가 쓸모 있을 수 있나
보상으로 성공 행동을 강화하는 접근과 달리, 이 방법은 실패한 실행에서도 “왜 이 경로가 틀렸는지”를 설명하는 문장을 학습 대상으로 만들 수 있다. 이는 실패를 성공으로 다시 표기한다는 뜻이 아니다. 실패한 회고가 잘못된 인과 설명을 담는다면 그런 문장을 그대로 학습할 위험도 있다. 논문의 두 단일 과제 시험은 초기 모델의 64번 시도 중 성공이 0번인 SymPy와 SymbiFlow 문제를 골라, 40업데이트 후 온라인 해결률 1.75%와 3.29%를 각각 보고한다. 여기서 0/64는 처음 골라 본 과제의 초기 탐침이고, 후자의 백분율은 이후의 평활화된 온라인 비율이다. 500개 홀드아웃 평균도, 모든 불가능해 보이는 과제를 해결한다는 증거도 아니다.
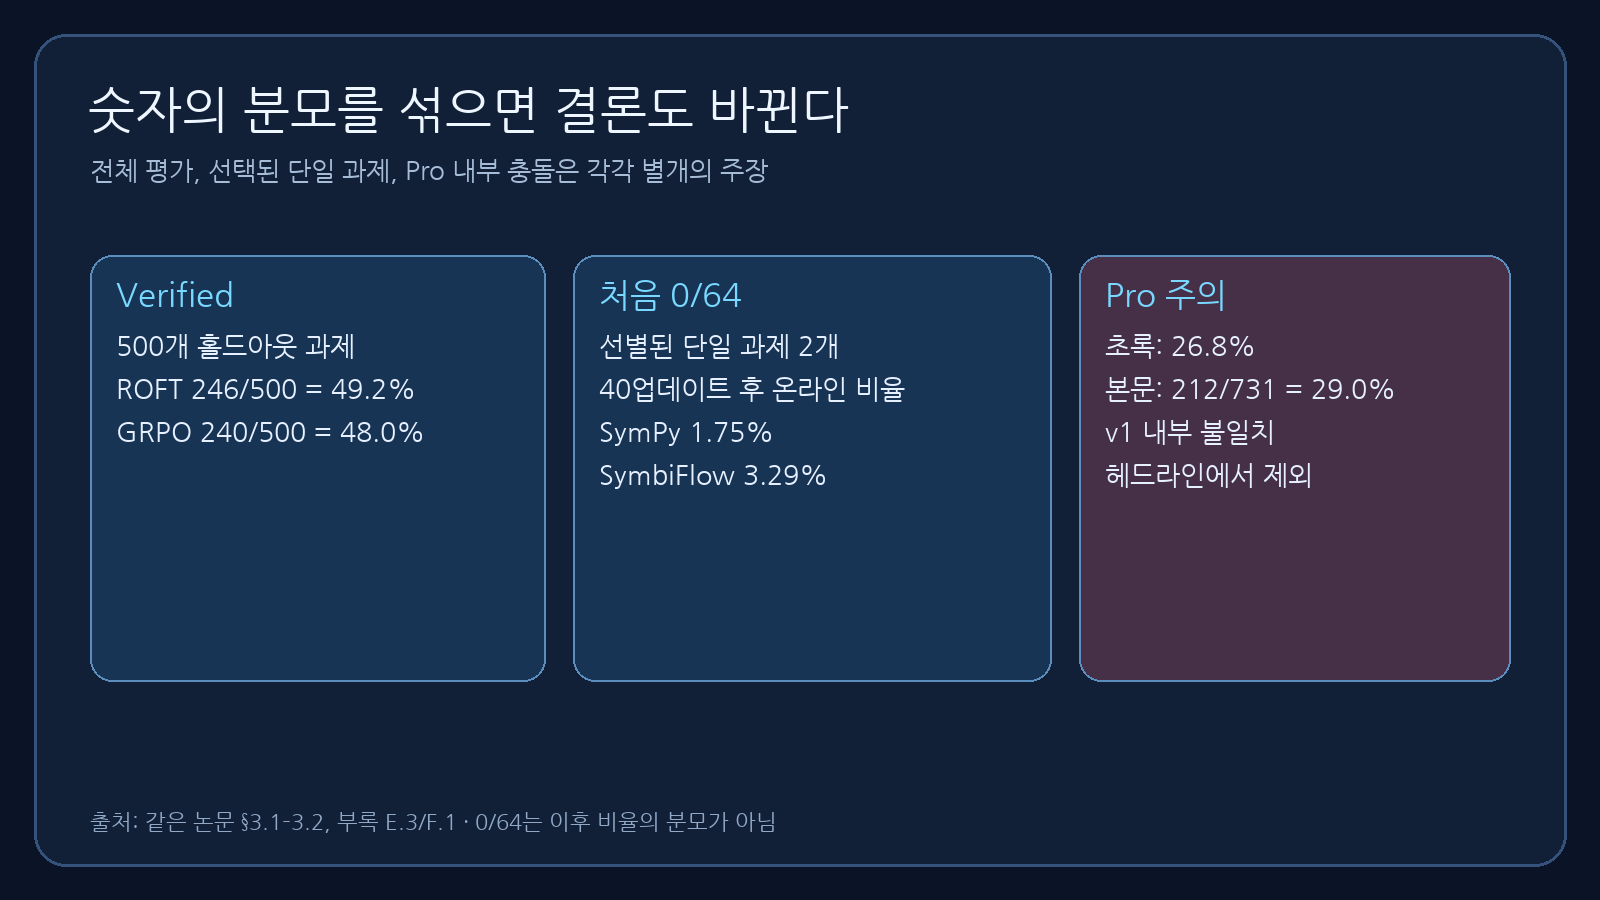
0/64는 단일 과제의 초기 탐침이지 이후 온라인 비율의 분모가 아니다. Pro의 초록과 본문은 v1에서 일치하지 않아 성과 헤드라인에서 제외한다. 출처: arxiv.org/html/2609.35741v1.
팀에서 비교한다면: 결과·비용·오염을 분리한 기록표
같은 출발 모델과 홀드아웃 과제를 사용하되, 업데이트 수뿐 아니라 완료된 풀이 시도·회고 생성량·GPU 시간·평가 비용을 따로 기록한다.
| 결정 지점 | 고정하거나 남길 것 | 과장하지 말아야 할 해석 |
|---|---|---|
| 훈련 문제 선정 | 초기 성공·실패 혼합 문제와 전부 실패한 문제를 분리하고 선택 기준을 기록한다. | 혼합 문제에서의 우위가 모든 실패 문제에 일반화된다고 말하지 않는다. |
| 지도 신호 | 행동·피드백 마스킹, 회고 생성 개수, 생성 모델과 텍스트 품질 표본을 기록한다. | 목표 행동 손실이 없다는 사실을 행동과 무관한 학습이나 완전한 무보상 과정으로 바꾸지 않는다. |
| 자원 비교 | 동일 GPU 구성에서 업데이트, 완료 시도, 버려진 그룹, 회고 생성, 실제 경과 시간과 평가 시간을 분리한다. | 20회 대 40회 업데이트 또는 6,035회 대 11,576회를 동일 계산량 대조로 부르지 않는다. |
| 평가·오류 분석 | 별도의 홀드아웃 과제, 성공 판정, 원본 대비 새로 해결·잃은 과제, 여러 시드를 남긴다. | 하나의 평균 차이로 일반적 인과 메커니즘이나 실제 서비스 비용 절감을 확정하지 않는다. |
이 표는 연구의 측정 결과가 아니라 조직 내 시험을 설계할 때 누락하기 쉬운 변수를 드러내기 위한 도구다. 작은 파일럿이라면 회고가 없는 동일한 훈련량의 대조군, 인간이 쓴 설명과 자기 생성 설명의 구분, 실패 설명의 환각 사례를 함께 기록할 수 있다. 이 비교표는 논문 수치를 독자의 실험 설계로 바꾼 편집상 제안이며, 이 글은 모델을 훈련하거나 SWE-bench를 독립 재현하지 않았다.
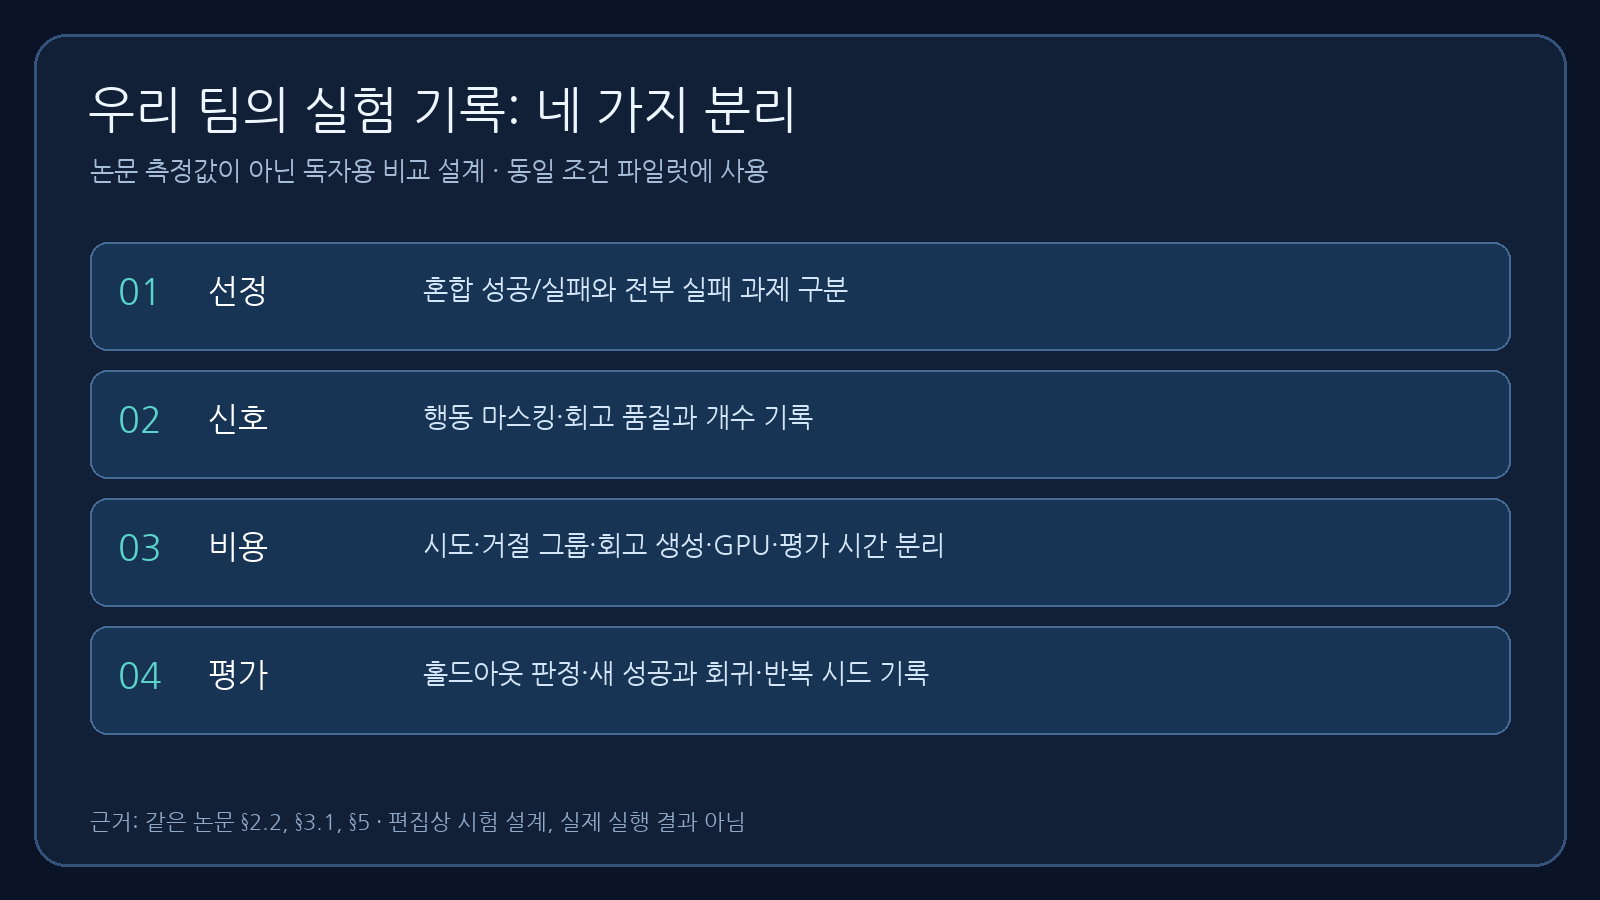
같은 출발 조건의 파일럿에서 무엇을 기록할지 제안한 편집상 설계이며 저자의 추가 실험이나 독립 재현 수치가 아니다. 출처: arxiv.org/html/2609.35741v1.
남겨 둘 의문: Pro 수치 충돌과 일반화 범위
SWE-bench Pro 관련 초록은 ROFT 20업데이트의 26.8%를 적지만, 본문 §3.1과 부록 E.3은 212/731, 29.0%라고 적는다. 같은 부록의 GRPO는 185/731, 25.3%다. 500개 Verified와 731개 Pro는 서로 다른 평가 집합이고, 26.8과 29.0의 차이는 단순 반올림으로 해소되지 않는다. 원인의 정정 근거가 없는 v1 상태에서 Pro 숫자를 대표 성과로 선택하지 않는 편이 안전하다.
논문의 §5는 장기 학습·평가의 높은 비용 때문에 주로 소프트웨어 엔지니어링과 Qwen3.5-4B에 실험이 집중됐고 인과 기제를 밝히려면 더 큰 통제 연구가 필요하다고 밝힌다. §3.4에 9B 실험이 있어도 모든 모델·업무에 대한 보증은 아니다. 재현성 설명은 일부 코드를 채택 이후 공개하겠다고 하며, 이 글에서 확인한 v1 본문에 바로 재현 가능한 프로젝트 저장소 링크는 없었다. 그래서 지금 실무적으로 가져갈 것은 보편적인 “RL 대체” 선언이 아니라 회고 토큰만 지도할 때 무엇이 변했는지 검증하는 비교 설계다.
원문·범위: Light 외, Shockingly Simple Self-retrospection Improves Agentic Models Without RL, arXiv v1 (§2.2, §3.1–3.2, §5, 부록 B·E·F); v1 초록·제출 기록. 수치는 저자 보고이며 독립 실행·재현 결과가 아니다. 위 판단표는 편집상 분석이다.


댓글
댓글 쓰기