SWE-bench 1위와 2위가 둘 다 396개를 풀었다: 순위표가 구분하지 못하는 것
1. 같은 396점이면 공동 1위라는 뜻일까
SWE-bench Verified의 선두 두 제출물은 500개 과제 중 396개를 해결했다. 둘 다 79.2%다. 여기까지만 보면 공동 1위라고 부를 수 있다. 그런데 바로 아래 제출물들이 394개, 388개, 387개를 풀었다고 해서 그 순서까지 믿어도 될까.
9월 15일 공개된 논문 Coding Agents Have Converged는 이 질문을 점수 차이가 아니라 과제별 성공·실패 행렬로 다시 풀었다. 연구진은 SWE-bench 네 분할의 공개 제출물 254개를 모았고, Verified에서는 2026년 7월 30일에 동결한 134개 제출물과 500개 과제를 분석했다. 모델을 새로 실행한 실험이 아니라 공개 verdict를 다시 계산한 감사다.
결과는 꽤 날카롭다. Verified 상위 10개 시스템이 모두 푼 과제는 285개, 모두 실패한 과제는 51개였다. 상위 10개를 서로 구분할 가능성이 있는 과제는 나머지 164개, 전체의 32.8%뿐이다. 점수 분모는 500이지만 비교의 실질적인 분모는 비교할 시스템 집합에 따라 줄어든다.
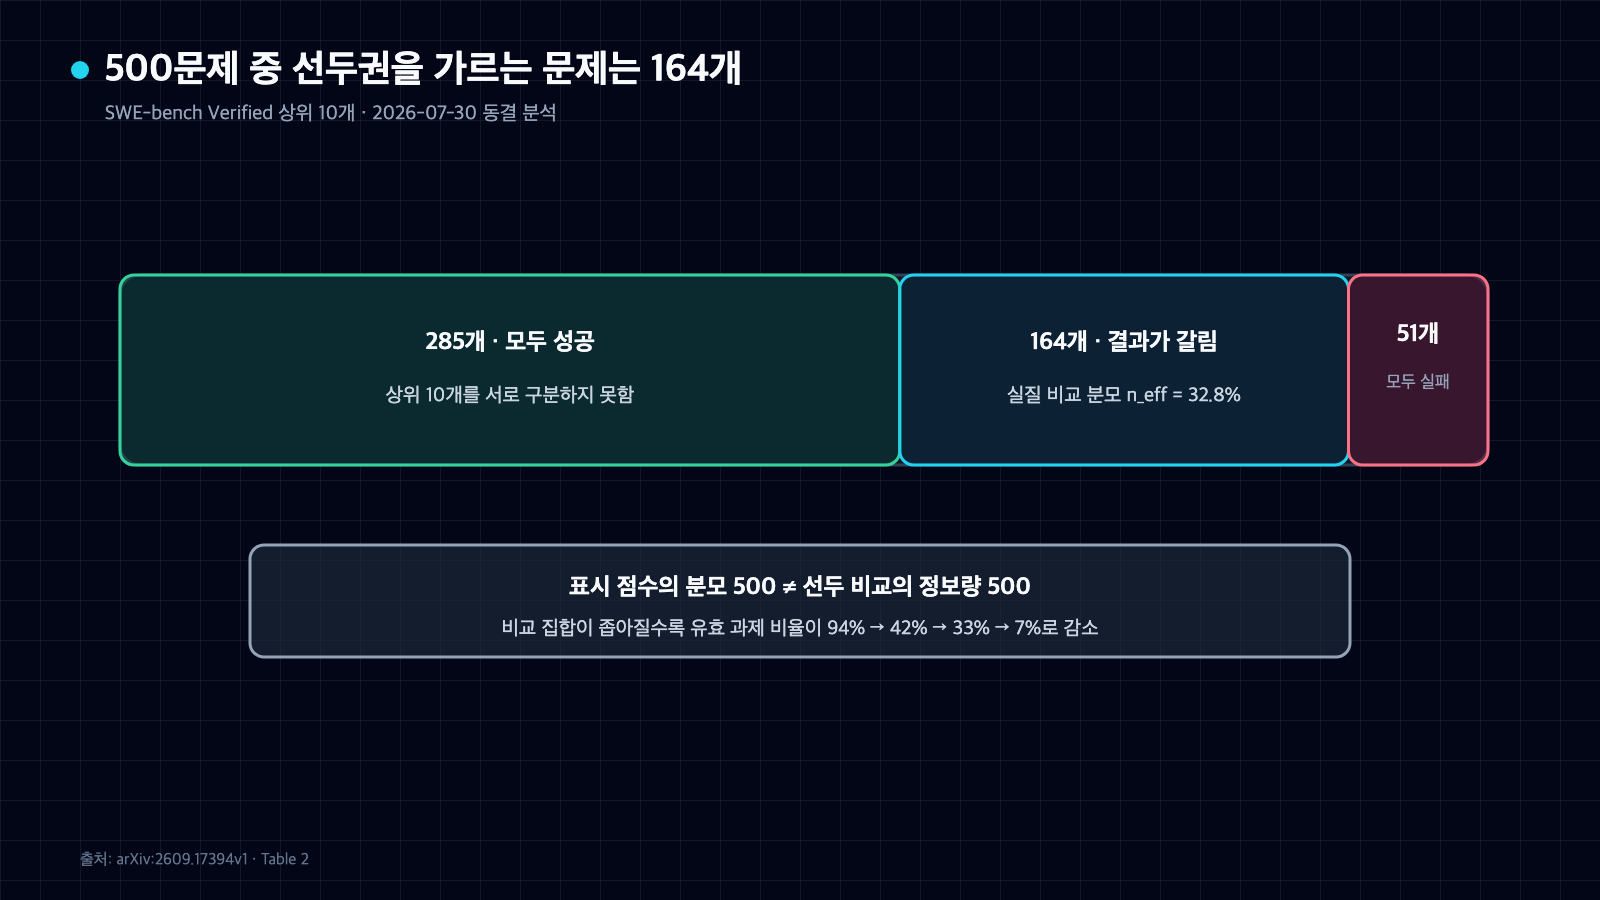
그림 1. 상위 10개를 실제로 구분하는 과제는 500개 중 164개다. 출처: arxiv.org/abs/2609.17394v1.
2. 500문제가 있어도 비교에는 164문제만 남는다
논문은 이 수를 n_eff, 즉 비교 집합에서 전원이 같은 결과를 내지 않은 과제 수로 정의한다. 전체 134개 제출물을 한꺼번에 보면 Verified의 94%가 구분에 기여한다. 하지만 상위 20개에서는 42%, 상위 10개에서는 33%, 상위 2개에서는 7%로 떨어진다. 리더보드 전체는 넓은 능력 범위를 잘 가르지만, 비슷해진 선두만 확대하면 눈금이 급격히 굵어진다.
단순 포화만이 전부는 아니다. 상위 시스템의 성공 집합도 강하게 겹쳤다. 선두권의 중첩 계수 중앙값은 0.935였고, 각 점수만 유지한 무작위 배치 기준선은 0.774였다. 약한 시스템이 푼 문제 대부분을 강한 시스템도 푼다는 뜻이다. 서로 다른 전문성을 가진 시스템이 각기 다른 문제를 푸는 모양보다, 비슷한 문제를 함께 풀고 함께 놓치는 모양에 가깝다.
이 상태에서는 1~2개 차이를 독립 표본처럼 읽으면 안 된다. 같은 500개 과제를 두 시스템이 함께 풀었기 때문에 비교는 쌍을 이룬다. 연구진이 exact McNemar 검정을 적용하자 Verified 상위 30개의 인접한 29쌍 가운데 유의수준 0.05에서 분리된 쌍은 하나도 없었다. Lite와 Multimodal도 인접 쌍을 분리하지 못했다. 반면 과제가 2,294개이고 시스템 점수 폭도 더 넓은 Test 분할에서는 23쌍 중 14쌍이 분리됐다. 검정이 무조건 둔한 것이 아니라, 선두권 Verified가 현재 해상도보다 촘촘하게 읽히고 있다는 반례다.
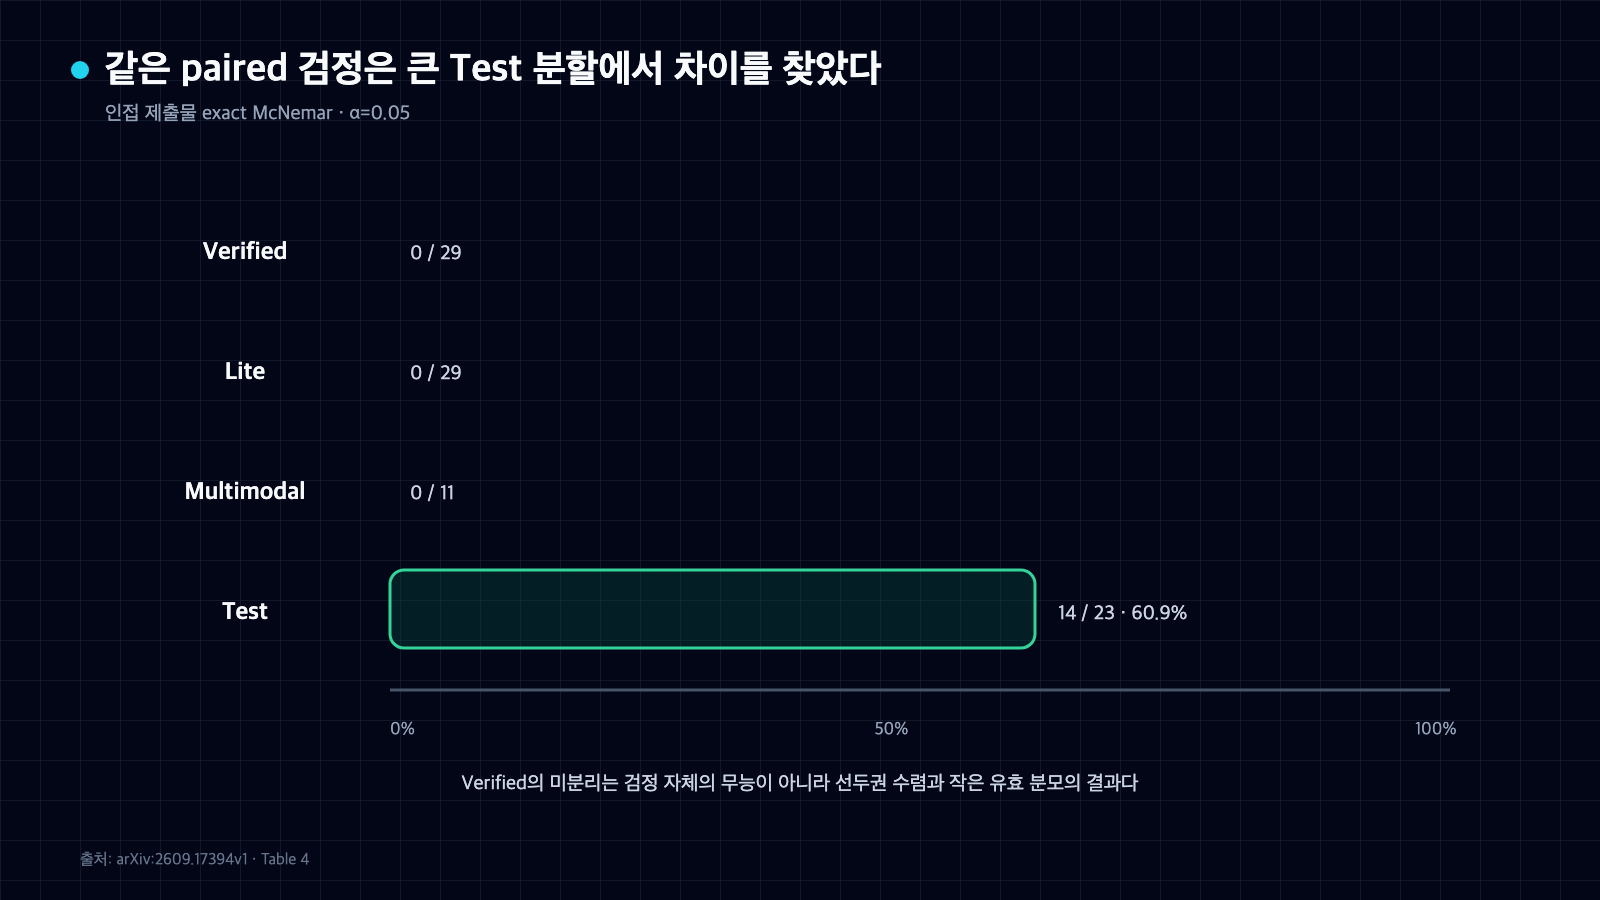
그림 2. 같은 검정은 과제 수와 점수 폭이 큰 Test 분할에서 23쌍 중 14쌍을 분리했다. 출처: arxiv.org/abs/2609.17394v1.
3. 모델 점수라고 쓰였지만 실제 단위는 모델과 하네스의 쌍이다
리더보드 한 줄에는 모델만 들어가지 않는다. 에이전트 루프, 도구, 검색, 컨텍스트 구성, 재시도 정책이 묶인 scaffold도 함께 결과를 만든다. 논문은 공개 메타데이터에서 모델과 scaffold를 복원했다. 같은 모델을 여러 scaffold에 넣은 관찰값의 점수 범위 중앙값은 15.6%포인트였다. claude-3-5-sonnet은 아홉 scaffold에서 168개부터 317개까지 벌어져 29.8%포인트 차이가 났다. Verified 상위 30개 전체 점수 폭인 8.8%포인트보다 크다.
그렇다고 scaffold가 모델보다 더 중요하다고 결론 내릴 수는 없다. 팀이 모델과 scaffold를 함께 선택했고, 제출 버전과 엔지니어링 노력도 달랐다. 완전한 무작위 대조 실험이 아니라 관찰 자료다. 실제로 같은 모델·같은 scaffold 조합을 다른 날짜에 다시 제출한 다섯 셀도 점수 범위 중앙값이 5.4%포인트였다. 실행 변동과 버전 변화가 섞였을 수 있다.
안전한 결론은 좁다. 표시된 수치는 모델 하나의 속성이 아니다. 적어도 (model, scaffold, version)의 결과로 기록해야 한다. 모델만 보고 사내 도구의 성능을 옮겨 적으면, 외부 리더보드와 다른 에이전트 루프에서 순서가 뒤집힐 수 있다.
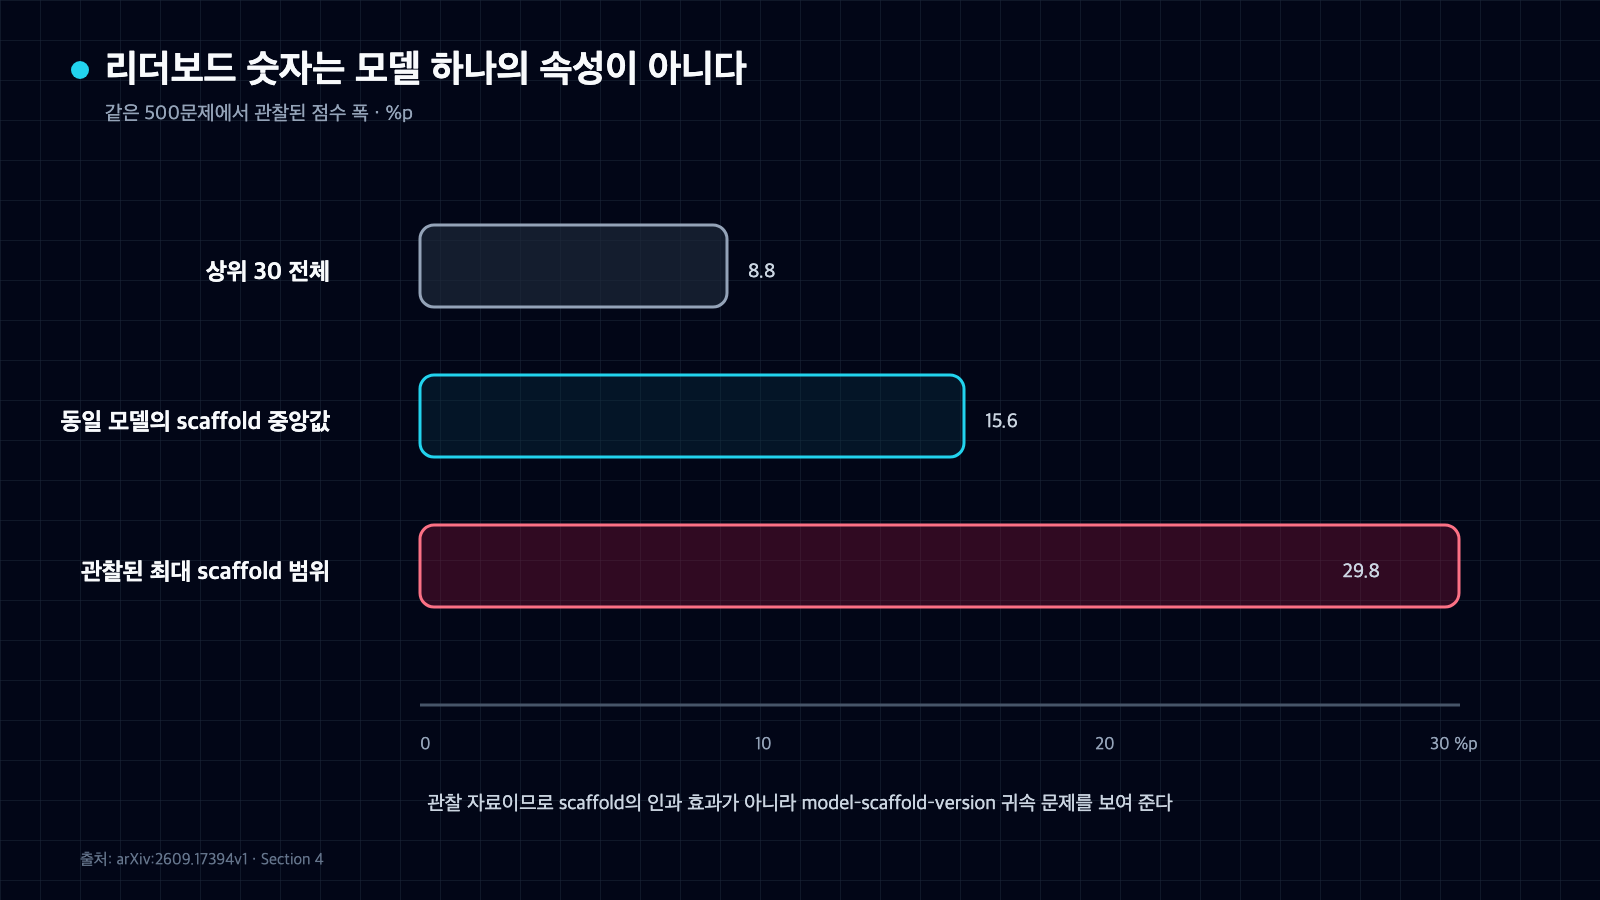
그림 3. 같은 모델에서도 scaffold에 따라 관찰 점수 폭이 상위 30개 전체 폭보다 컸다. 출처: arxiv.org/abs/2609.17394v1.
4. 순위를 없애자는 얘기가 아니라 해상도를 표시하자는 얘기다
연구진은 상위 30개를 인접 순위 대신 기술적 tier로 묶었다. 보정하지 않은 leader 비교 규칙에서는 8개, 12개, 10개의 세 그룹이 나왔다. 435개 전체 쌍을 Holm 방식으로 보정하면 19개와 11개의 두 그룹이 됐다. 어느 쪽도 그룹 안의 시스템이 동등하다는 증거는 아니다. 차이를 검출하지 못했다는 것과 같은 능력이라는 것은 다르다.
여기서 중요한 건 tier 개수보다 규칙을 함께 공개하는 일이다. 어떤 비교군을 썼는지, 다중 비교를 어떻게 보정했는지, 실제로 순위를 가른 과제가 몇 개인지 보여 줘야 한다. 1위부터 30위까지 숫자만 늘어놓으면 측정값보다 더 정밀한 결정을 유도한다.
쉬운 과제를 빼면 해결될 것 같지만, 논문의 반사실 검사는 그렇지 않았다. 상위 20개에 대해 모두 같은 결과가 나온 과제를 제외하면 점수 폭은 8.8%포인트에서 18.7%포인트로 넓어지고 인접 순위 세 곳이 바뀌었다. 그래도 인접 29쌍 중 분리된 쌍은 여전히 0개였다. paired 검정은 두 시스템이 같이 성공하거나 같이 실패한 과제를 원래부터 차이 계산에 쓰지 않기 때문이다. 쉬운 문제를 지우면 비용은 줄어도 새로운 정보는 생기지 않는다.
5. 직접 재실행해 보니 핵심 숫자는 남고 분모는 움직였다
논문의 재현 저장소는 공개 SWE-bench verdict를 내려받아 표와 tier를 다시 만든다. 9월 16일 현재 저장소 커밋 aaf8b6…의 스크립트를 실행하고, SWE-bench experiments 최신 main의 커밋 40f164…을 사용해 계산했다. 상위 10개의 285개 공동 성공, 51개 공동 실패, 164개 구분 과제, 인접 29쌍 중 0쌍이라는 핵심 결과는 다시 나왔다. 모델별 scaffold 범위 중앙값 15.6%포인트도 같았다.
다만 제출물 수는 논문의 134개가 아니라 135개였고, 사용 가능한 단일 모델 태그도 61개가 아니라 62개였다. 논문은 7월 30일 자료를 동결했다고 적었지만 공개 fetch_data.sh는 experiments 저장소의 특정 커밋을 체크아웃하지 않고 최신 main을 얕게 복제한다. 9월 1일 제출물이 하나 추가된 뒤라 생긴 차이다. 이번 재실행은 논문의 정확한 동결본을 독립 복원한 것이 아니라, 이후 데이터에서도 중심 결론이 유지되는지 확인한 것이다.
이 구분은 사소하지 않다. 재현 스크립트가 있어도 입력 데이터가 움직이면 표의 분모가 달라진다. 논문 숫자를 그대로 재현하려면 데이터 commit이나 해시 manifest가 같이 필요하다. 반대로 최신 데이터를 일부러 쓰는 연속 감사라면 조회 시각과 commit을 결과에 붙여야 한다.
6. 사내 코딩 에이전트 평가에 바로 적용할 것
사내 벤치마크에서 모델 A가 모델 B보다 2%포인트 높다고 나왔을 때 먼저 n_eff를 계산해 볼 만하다. 두 후보가 모두 맞히거나 모두 틀린 과제를 제외하고, 실제로 결과가 갈린 과제가 몇 개인지 본다. 그 수가 작다면 점수 차이의 소수점보다 불확실성을 먼저 보여 줘야 한다.
다음으로 배포할 조합을 그대로 평가해야 한다. 모델 이름만 고정하지 말고 실제 에이전트 루프, 도구 버전, 검색 설정, 재시도 횟수를 하나의 실험 단위로 저장한다. 같은 조합을 여러 번 실행해 실행 변동도 분리한다. 과제를 늘릴 때는 아무 문제나 더하지 말고 후보 시스템의 결과가 실제로 갈리는 문제를 받아들인다.
마지막으로 엄격한 순위가 필요한 결정과 넓은 성능 구간만 필요한 결정을 구분한다. 비용이 크게 다른 두 후보를 거르는 데는 현재 벤치마크가 충분할 수 있다. 비슷한 선두 둘 중 하나를 조달할 때는 1~2개 성공 차이가 결정을 지지하지 못할 수 있다. 리더보드는 쓸모없어진 것이 아니다. 다만 어디까지 읽을 수 있는지 함께 적어야 한다.


댓글
댓글 쓰기