코드를 읽는 것과 실행을 맞히는 것은 다르다: SWE-Flux로 보는 에이전트 검증법
코딩 에이전트에게 “이 함수가 무엇을 하는가”라고 물으면 설득력 있는 설명이 돌아온다. 그러나 “이 저장소의 이 테스트를 돌릴 때 어떤 값이 어느 정의에서 쓰이는가”는 다른 질문이다. 경로, 분기, 테스트 입력과 실행 중 상태를 맞혀야 한다. 2026년 9월 23일 제출된 SWE-Flux 원문 v1은 바로 그 차이를 측정한 동료 심사 미확인 프리프린트다. 여기서는 점수를 만능 코딩 능력의 순위로 읽지 않고, 개발자가 에이전트의 답을 어디까지 믿고 무엇을 재검증해야 하는지에 초점을 맞춘다.
무엇을 물었고, 무엇을 못 하게 했나
저자들은 SWE-bench-Live에서 고른 파이썬 저장소 12개로 실행 기반 질문 480개를 만들었다. 단일 테스트 대상 308개와 복수 테스트 대상 172개, 질문 유형은 13개다(§IV, Table IV). 질문 하나가 저장소 하나 또는 테스트 하나를 뜻하는 것은 아니다. 정답은 깨끗한 저장소 컨테이너에서 테스트를 실행해 얻은 추적을 각 인스턴스의 파서로 해석한 결과다. 정답을 다른 언어 모델이 채점한 방식이 아니다. 다만 사람이 테스트와 오라클의 의미를 큐레이션했고, 질문 명세 확인용 별도 에이전트는 코드를 실행할 수 있었다. 평가받는 모델에는 읽기 전용 저장소 도구가 주어졌지만 평가 시 테스트 실행이나 정답 추적 접근은 허용되지 않았다.
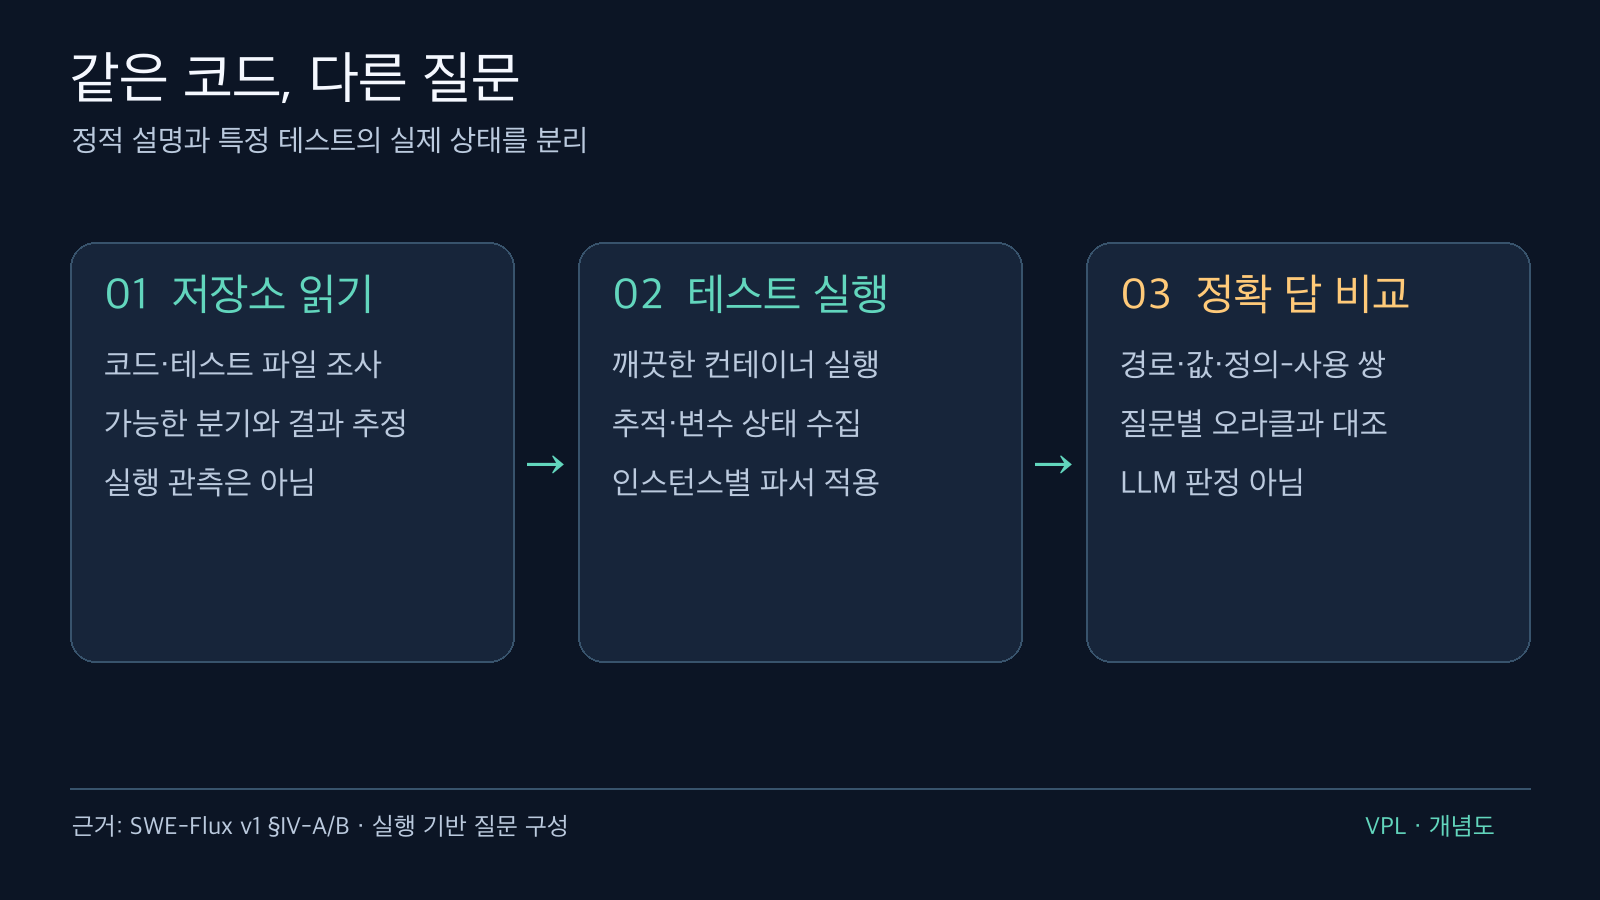
모델의 정적 추정과 컨테이너 추적·파서 기반 정답을 구분한 자체 개념도. 이 글에서는 테스트를 실행하지 않았다. 출처: arxiv.org/html/2609.28449v1#S4.
이 설계는 “도구를 쓰면 언제나 해결할 수 있다”거나 “모델에 실행 추론 능력이 전혀 없다”를 증명하지 않는다. 오히려 파일을 읽어 예상한 경로와 실제 테스트가 밟은 경로 사이의 차이를 드러낸다. 예컨대 정의-사용 관계를 묻는다면 변수 이름만 찾는 것으로는 부족하다. 테스트 중 실제로 어떤 정의가 마지막으로 적용되고 어디에서 사용됐는지를 특정해야 한다. 저자 저장소의 고정 커밋에 있는 대표 Sympy 오라클 파서도 추적 이벤트와 AST 이름을 대상 함수로 한정하고 마지막 정의·사용 쌍을 뽑는다. 우리는 그 파일을 열어 구조를 확인했을 뿐 실행하지 않았다.
전체 점수보다 중요한 분모
Table VI에서 평가된 다섯 모델 중 GPT-5.4의 전체 정답률은 480개에 대해 37.71%, GPT-5.3-Codex는 33.75%다. 논문 본문의 37%, 33%는 반올림한 서술이므로 표의 정밀도와 섞어 새 수치처럼 쓰지 않는다. 37.71%에서 역산한 정답 개수를 논문이 보고한 원시 건수라고 단정할 수도 없다. 정확 일치 형식의 JSON 답을 요구한 이 실험은 일반적인 코드 생성 성공률이나 제품 환경의 장애율이 아니다.
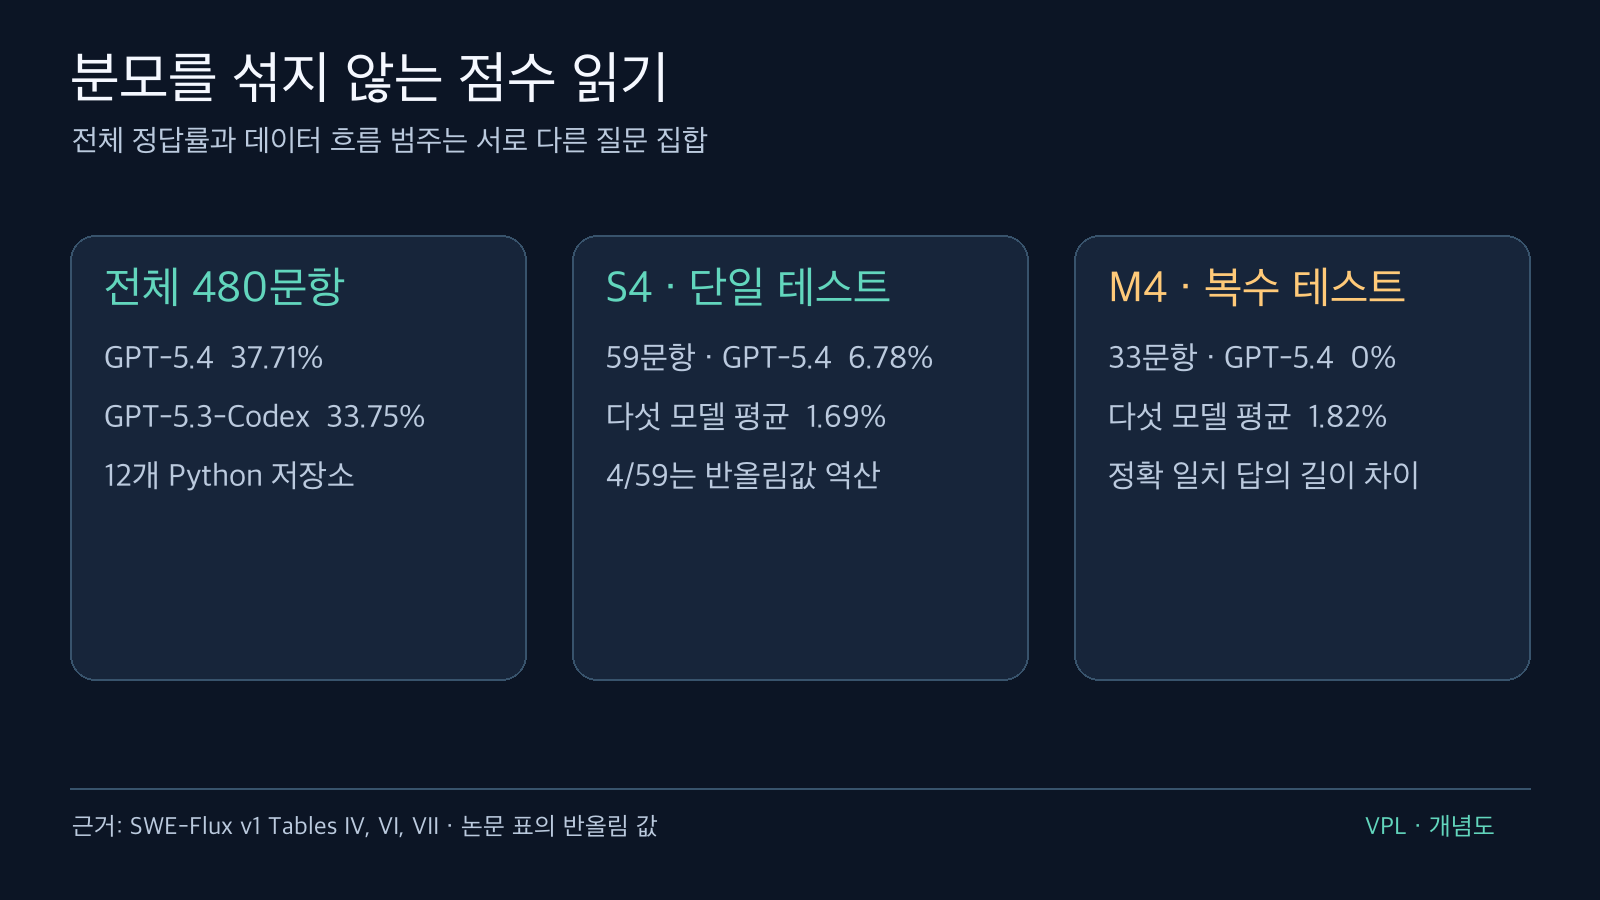
전체·범주별 분모와 모델별 점수를 분리했다. 4/59는 반올림 백분율에서 역산했으며 다섯 모델 평균은 단일 모델 점수가 아니다. 출처: arxiv.org/html/2609.28449v1#S4.T7.
더 작은 범주를 볼 때에는 분모를 바꿔 읽기 쉽다. Tables IV·VII의 단일 테스트 데이터 흐름 S4에는 질문 59개가 있고 GPT-5.4 점수는 6.78%다. 59개에서 환산한 4개는 표의 반올림 수치로 재구성한 값이다. 같은 범주의 1.69%는 다섯 모델 점수의 비가중 평균이지 GPT-5.4의 점수가 아니다. 복수 테스트 데이터 흐름 M4는 질문 33개, GPT-5.4는 0%, 다섯 모델 평균은 1.82%다. 이를 전체 480개의 “데이터 흐름 정답률”이라고 부르면 잘못된 비교가 된다. 긴 경로나 정의-사용 쌍을 정확 일치로 요구하는 답은 단일 불리언 답과 채점 난도가 달라 범주 간 차이를 순수한 추론 난도 서열로 볼 수도 없다.
틀린 답을 읽는 방식: 부분 점수와 반례
§V-B에서 저자들이 수동 분류한 GPT-5.4 오답 299개 중 약 2%는 표현만 다른 답, 5%는 근접한 답, 나머지 93%는 의미상 상당히 다른 답이었다. 이는 전체 480개에 대한 비율이 아니며, 독립적인 블라인드 재판정도 아니다. 소수의 포맷 차이만 고치면 전체 성능이 뒤집힌다는 식의 해석은 근거가 약하다. 반대로 엄격한 정확 일치는 경로·집합처럼 긴 답에 불리할 수 있으므로 숫자 하나로 모든 오류 원인을 규정하지도 말아야 한다.
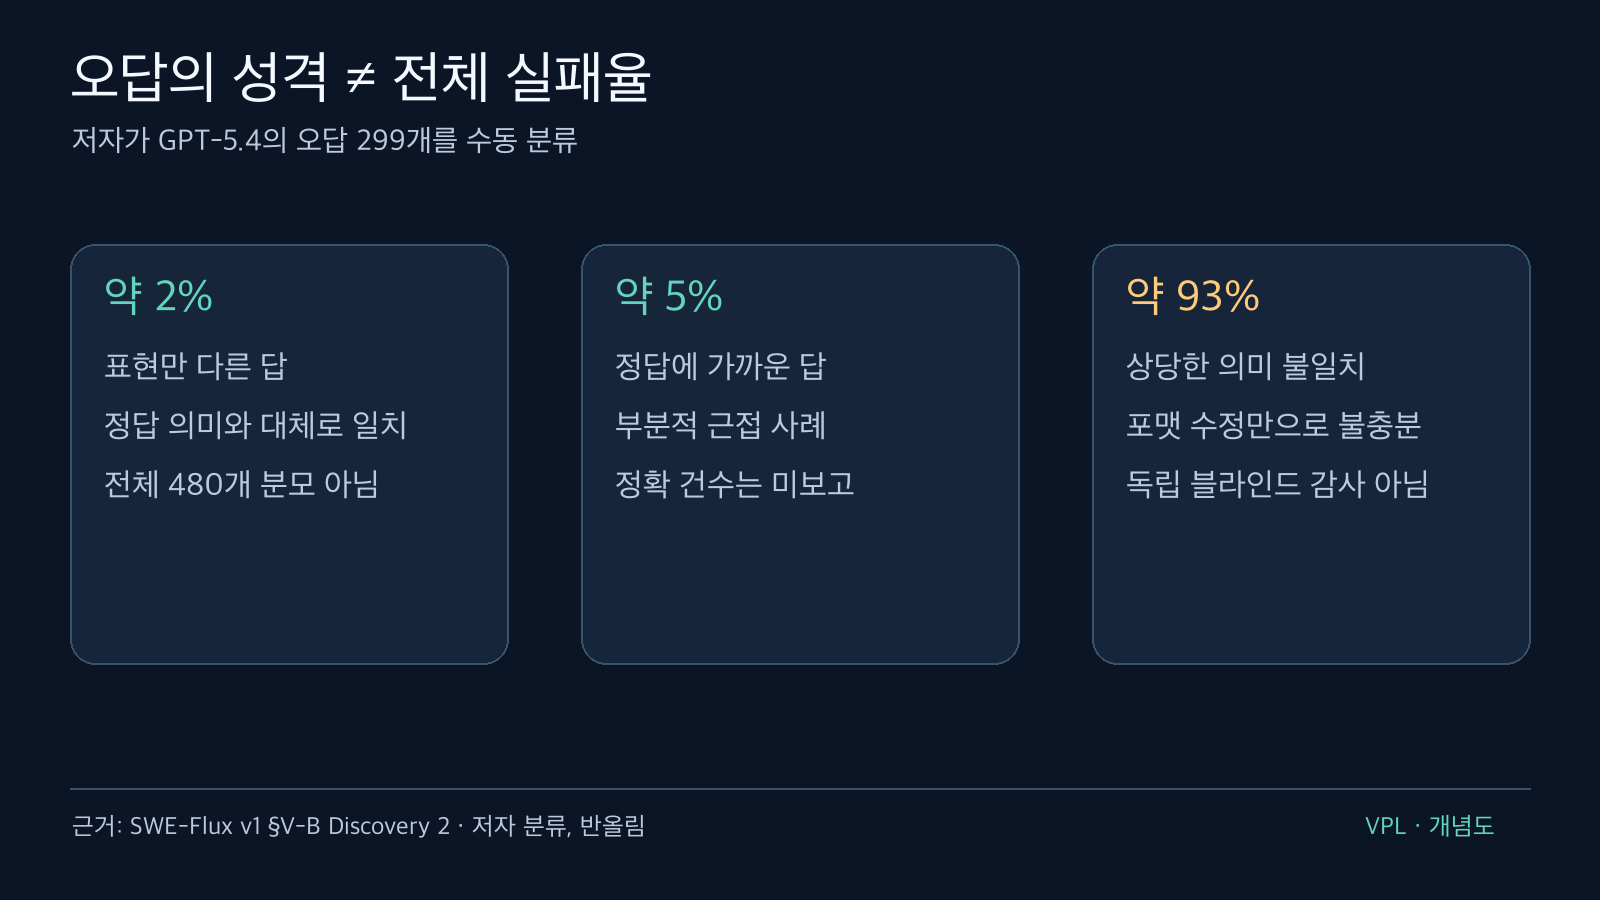
299개 오답에 대한 저자 수동 분류의 반올림 비율이다. 전체 480개 분모나 독립 감사 결과가 아니다. 출처: arxiv.org/html/2609.28449v1#S5.SS2.
입력을 살짝 바꿔 정답이 흔들리는지도 시험했다(§V-C, Tables VIII–IX). 원래 GPT-5.4가 맞힌 사례만 골라 11개 저장소의 58개 원본으로 출발했다. 초기에 유효한 변형을 수확한 것은 52/58이고, 최종 Table IX의 원본·변형 평가 행은 각각 58개다. 이 두 단계를 같은 분모의 성공률로 합치면 안 된다. 이 선택 집합에서 GPT-5.4는 원본 58/58에서 변형 25/58(43.1%)로 내려갔다. 이 변화는 전체 480개에 대한 성능 하락이 아니다. 제안·피드백 과정이 대상 모델에 맞춰졌고 오염 가능성도 완전히 없애지 못했다. 따라서 “모든 프롬프트 변형이 성능을 절반으로 깎는다”는 일반화 역시 피한다.
내 저장소에서 쓰는 세 단계 진단
정적 설명은 가설, 실행 추적은 관측, 오라클 비교는 판정으로 분리한다. 아래는 논문의 결과를 자기 코드 리뷰에 옮긴 편집상 절차다.
| 단계 | 개발자가 남길 증거 | 중단해야 할 주장 |
|---|---|---|
| 1. 가설 고정 | 정확한 커밋, 테스트 이름·입력, 에이전트가 예상한 분기·값·경로를 먼저 기록 | “코드를 읽었으니 실행 결과를 안다” |
| 2. 관측 분리 | 격리된 환경에서 해당 테스트를 실제로 실행하고 로그·상태·추적을 보존; 실행하지 못했다면 미관측으로 표기 | 추정한 경로를 실행 로그처럼 표현 |
| 3. 판정 명시 | 질문별 기대 답의 형식·정답 근거를 정하고 값·경로·정의-사용 쌍을 대조; 형식 차이와 의미 차이를 별도로 기록 | 정확 일치 실패를 모두 같은 원인으로 해석 |
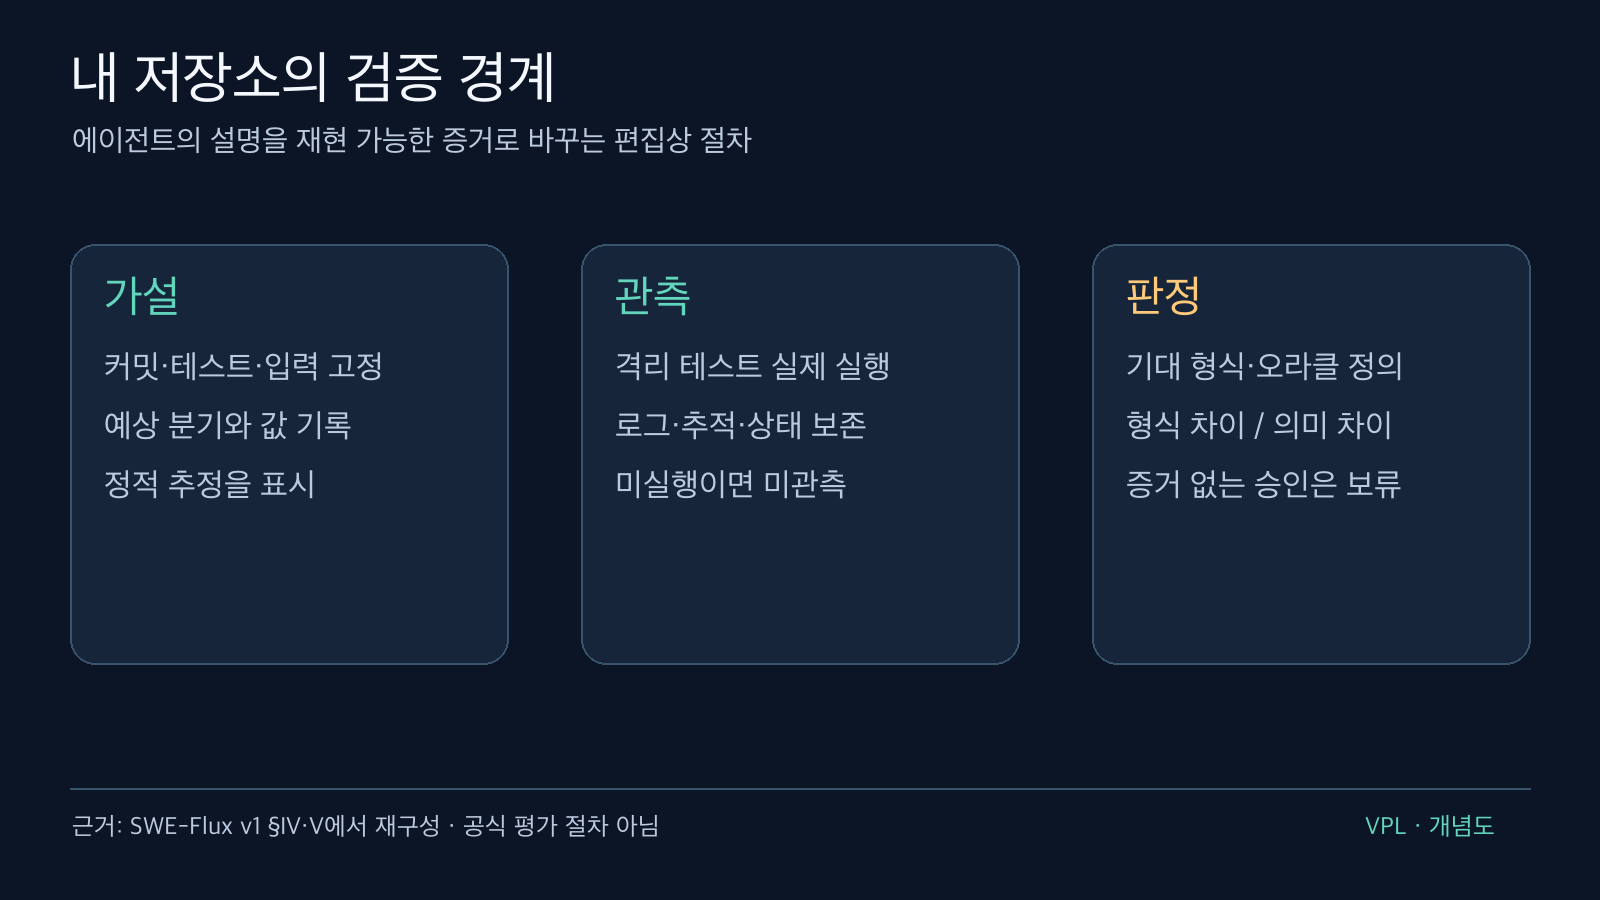
논문의 질문 구조에서 착안한 개발자용 자체 진단 절차이며 SWE-Flux의 공식 평가 규칙이나 실행 결과가 아니다. 출처: arxiv.org/html/2609.28449v1#S4.
이 진단 순서는 논문의 공식 평가 규칙이 아니라 개발자가 자기 저장소에서 확인할 항목을 재구성한 것이며, 여기서 모델이나 Docker 테스트를 직접 실행하지 않았다. 안전한 격리 환경이 없으면 2단계를 통과했다고 적지 말고 미검증으로 남겨야 한다. 평가 모델이 접근할 수 있었던 것은 읽기 도구였으므로, 실제 개발 환경에서 테스트 실행 도구를 허용했을 때 동일한 점수가 나온다고 추정할 수 없다. 실무에서는 답변이 자신감 있어 보이는가보다 해당 입력·커밋의 재현 가능한 관측이 있는가가 승인 기준에 더 가깝다.
근거와 적용 범위
논문은 파이썬의 12개 저장소·480개 질문에 국한되고 범주별 수가 고르지 않다. 원문 §V-D의 도구·검색과 추론이 얽힌다는 한계 및 엄격한 답 형식의 효과를 함께 읽어야 한다. 저자 공개 저장소의 평가 안내는 컨테이너와 공급자 설정을 설명하지만, 공개 파일이 있다는 사실은 우리가 모델 평가를 재실행했다는 뜻이 아니다. 이미지도 원문 도형 복제가 아닌 자체 개념도이며, 실제 제품 화면이나 재현 실험 그래프가 아니다. 원문: arXiv v1 전문, 저자 저장소 고정 커밋.


댓글
댓글 쓰기