같은 파일을 두 번 저장하지 않는 uv 0.12의 휠 캐시: 10% 절약 뒤에 숨은 하드링크 계약
Python 환경을 여러 개 만들다 보면 같은 파일이 캐시에 반복해서 쌓인다. 서로 다른 버전의 휠도 라이선스, 공유 라이브러리, 큰 데이터 파일을 똑같이 담을 수 있다. 그런데 기존 캐시는 보통 "어느 패키지의 어느 휠인가"를 기준으로 보관한다. 내용이 같아도 출처나 휠이 다르면 별도 복사본이 된다.
uv 0.12.7과 0.12.8에 들어간 content-addressed-cache 미리보기 기능은 이 기준을 바꿨다. 먼저 압축을 푼 휠 전체에 내용 기반 ID를 붙였고, 이어서 휠 안의 각 파일도 BLAKE3 해시로 저장한 뒤 원래 위치에는 하드링크를 만들었다. Astral 개발자가 공개한 로컬 캐시에서는 545.2MiB, 약 10%를 줄였다. 다만 무료 절약은 아니다. 공식 측정에서 cold install은 4% 미만 느려질 수 있었고, 정리 명령은 수만 개 파일의 링크 수를 읽어야 했다.
요약: 주소를 패키지 이름에서 파일 내용으로 바꾼다
기존 archive-v0는 압축을 푼 휠마다 임의 ID를 만들었다. 같은 휠을 다른 cache entry에서 다시 만나도 별도 archive가 생길 수 있었다. PR #19693은 상대 경로, 파일 내용, 빈 디렉터리를 묶어 결정적인 directory hash를 계산하고 이를 24자리 소문자 base-36 ID로 쓴다. ZIP entry 순서와 다른 archive metadata는 identity에서 빼고, 설치할 때 필요한 실행 권한은 따로 보존한다.
다음 단계는 파일 단위다. PR #21327은 각 payload를 BLAKE3 해시 아래 files-v0에 한 번 저장하고, 각 휠의 archive-v0 위치에서 그 object로 하드링크한다. 설치 경로를 읽는 후속 단계는 바뀌지 않는다. 차이는 같은 내용의 파일을 여러 archive가 가리킬 때 디스크 block이 하나라는 점이다.
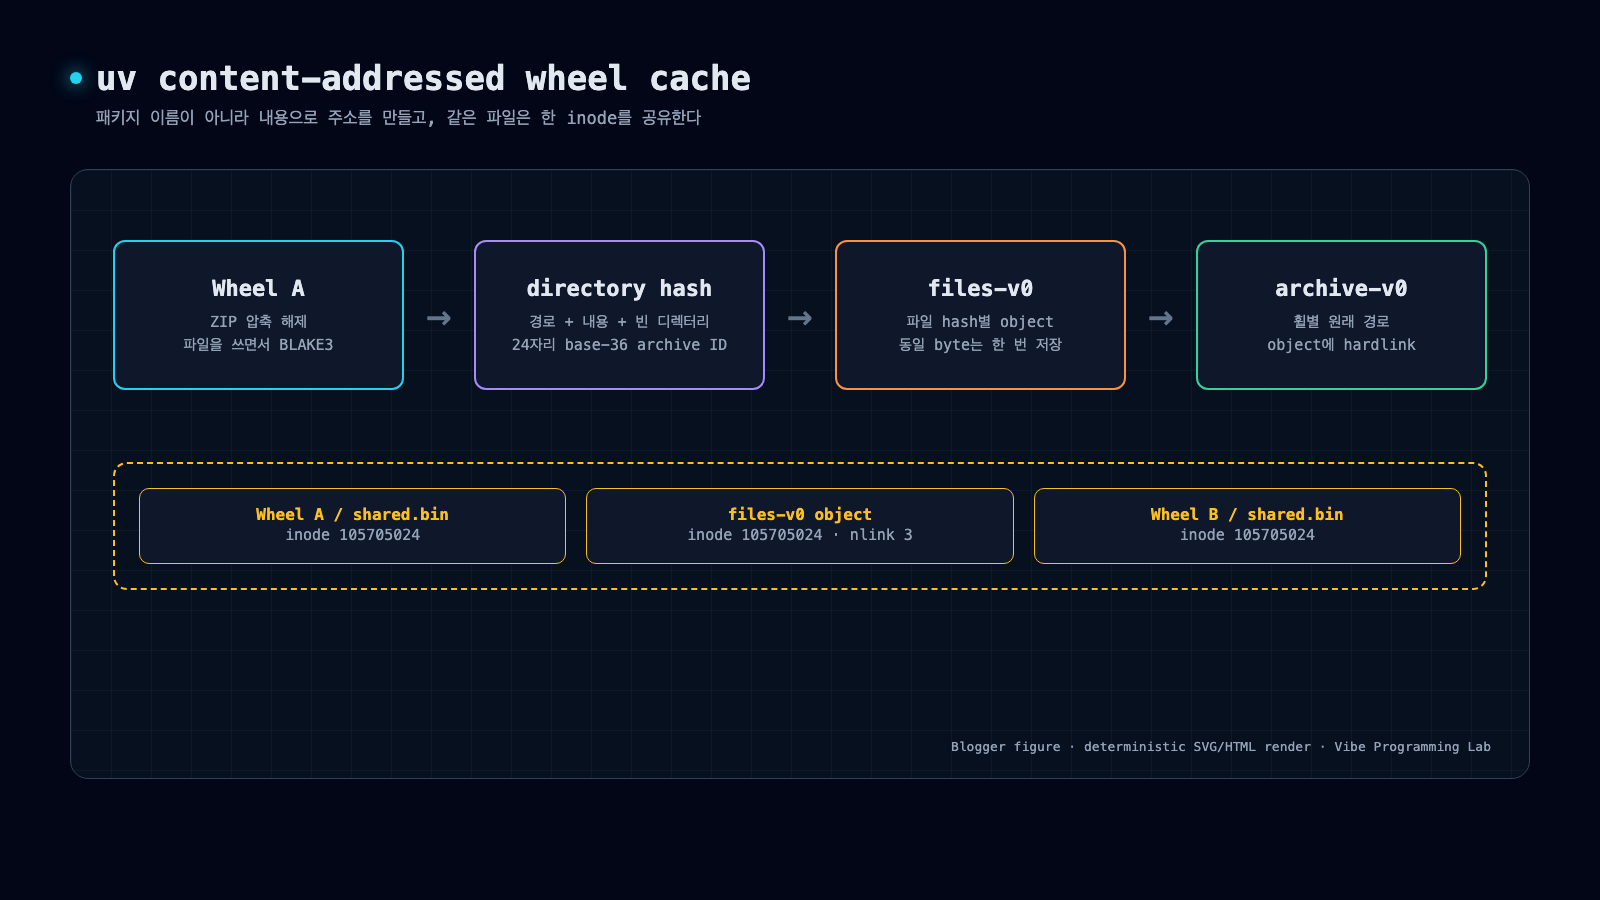
파일 내용이 같으면 files-v0 object 하나를 여러 wheel archive가 하드링크한다. 출처: github.com/astral-sh/uv/pull/21327.
이 설계에서 이름은 곧 무결성 검증값이라는 뜻이 아니다. BLAKE3 주소는 중복을 찾기 위한 내부 identity다. 패키지 공급망 검증은 lockfile hash, wheel의 RECORD, index provenance와 별도로 남는다. "내용 기반"이라는 단어만 보고 서명이나 출처 확인까지 해결됐다고 해석하면 안 된다.
두 휠을 직접 만들어 확인한 하드링크
uv 0.12.10 공식 Apple Silicon binary를 내려받아 배포 SHA-256과 대조한 뒤, 이름만 다른 두 개의 테스트 휠을 만들었다. 두 휠에는 SHA-256이 같은 1,250,000바이트 shared.bin을 넣었다. --preview-features content-addressed-cache로 둘을 같은 임시 cache에 설치했다.
결과는 archive-v0 두 디렉터리와 files-v0 object 하나가 같은 inode 105705024를 가리켰고 link count는 3이었다. 설치 target은 기본 link mode 때문에 별도 inode였지만, 캐시 내부의 중복 제거 계약은 실제 파일 시스템 metadata에서 확인됐다. 이 결과는 기능의 구조를 검증한 작은 fixture이지, 개발자가 보고한 545.2MiB 절약률을 독립 재현한 benchmark는 아니다.
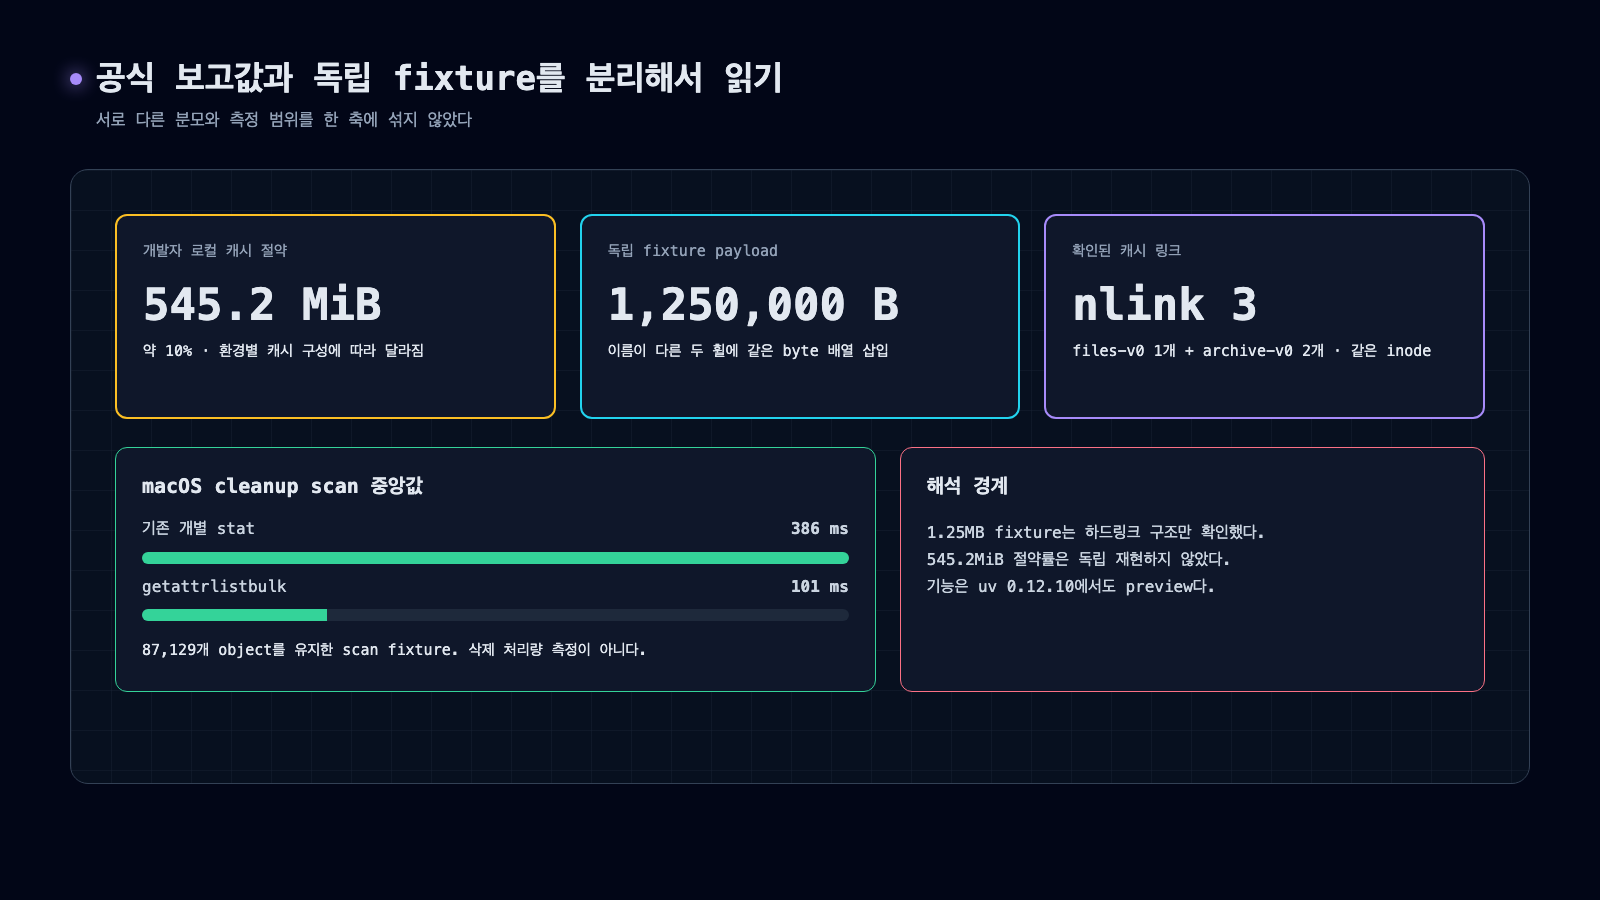
공식 보고값과 독립 fixture의 분모를 분리했다. macOS 막대는 같은 87,129-object scan fixture의 중앙값이다. 출처: github.com/astral-sh/uv/pull/21344.
숫자를 읽을 때 분모도 봐야 한다. PR의 545.2MiB는 작성자 로컬 cache에서 payload 파일 134,222개가 87,129개 object로 줄어든 결과다. 캐시 구성에 따라 절약률은 달라진다. 서로 다른 환경이 비슷한 대형 휠을 많이 공유하면 이득이 커지고, 작고 고유한 휠만 쓰면 hash 계산과 inode 관리 비용이 상대적으로 커진다.
왜 모든 파일을 해시해도 cold install 저하가 작았나
파일별 중복을 찾으려면 압축 해제 중 모든 byte를 해시에 통과시켜야 한다. 초기 구현은 파일마다 64KiB buffer를 새로 할당하고 0으로 채웠다. PyTorch fixture에서는 hashing buffer allocation이 11,120회 생겼다. PR #21340은 active wheel당 buffer 하나를 재사용했다.
이 최적화의 paired benchmark는 이전 PR 구현과 buffer 재사용 버전을 비교했다. AnyIO는 110ms에서 107ms, NumPy는 627ms에서 567ms, PyTorch CPU wheel은 6.50초에서 5.99초가 됐다. 이 값은 uv main과의 비교가 아니라 중복 제거 구현 내부의 전후 비교다. 캐시 기능 자체의 비용을 7.8% 개선했다고 읽어서는 안 된다.
핵심은 압축 해제와 hash를 별도 pass로 나누지 않은 데 있다. streaming과 seekable extraction 모두 파일을 쓰는 동안 hash를 계산한다. warm install에서는 이미 만들어진 object를 다시 해시할 필요가 적어 공식 측정에서 일관된 변화가 없었다. cold path의 추가 계산을 줄이되, 중복 판정에 필요한 byte 읽기는 피하지 않는다.
정리는 삭제가 아니라 참조 수 계산이다
files-v0 object를 곧바로 지우면 다른 휠 archive의 파일도 사라진다. uv는 hardlink count가 1일 때, 즉 object 자신 외의 archive 참조가 없을 때 정리 대상으로 본다. 따라서 cache prune은 경로 목록뿐 아니라 파일 시스템의 링크 수를 읽어야 한다.
macOS에서는 이 scan이 병목이 됐다. PR #21344는 flat shard의 이름, 파일 종류, link count를 getattrlistbulk로 묶어 읽는다. 87,129개 빈 object를 두 link씩 만든 fixture에서 uv cache prune 중앙값은 386ms에서 101ms로 줄었다. 이 측정은 object를 실제 삭제하지 않고 모두 유지한 scan 비용이다. Linux와 bulk attribute를 지원하지 않는 환경은 기존 walk를 사용한다.
하드링크는 같은 파일 시스템 안에서만 동작한다. uv cache를 removable volume에 두거나 container layer 사이에서 옮길 때는 link mode와 mount boundary를 확인해야 한다. cache 디렉터리를 일반 복사 도구로 백업하면 하드링크 관계가 풀려 실제 사용량이 커질 수도 있다. du의 논리 크기와 물리 block 사용량이 다르게 보이는 이유도 여기에 있다.
실전 적용: preview 기능은 측정 가능한 환경에서 켠다
이 기능은 0.12.10에서도 미리보기다. 전사 CI에 한꺼번에 켜기보다 별도 cache directory에서 시작하는 편이 낫다. 대표 lockfile로 cold install과 warm install을 나눠 재고, uv cache prune 시간과 실제 block 사용량을 함께 기록한다. 캐시를 공유하는 runner라면 동시 설치와 정리 작업도 시험해야 한다.
문제가 생겼을 때는 package 설치 결과와 cache 최적화를 분리한다. 새 cache로 동일 lockfile을 설치해 결과가 같은지 확인하고, preview 기능을 끈 cache와 비교한다. 하드링크 수가 예상보다 낮다면 cache와 archive가 같은 filesystem인지 먼저 본다. object hash가 같아도 설치 target의 inode가 다른 것은 link mode나 filesystem 경계 때문일 수 있다.
CI에서는 세 값을 분리해 수집하면 원인을 찾기 쉽다. 첫째, 빈 cache에서 lockfile 설치가 끝날 때까지 걸린 시간이다. 둘째, 같은 cache를 다시 쓴 warm install 시간이다. 셋째, cache directory의 실제 할당 block과 파일 수다. 논리적 파일 크기 합계만 보면 하드링크된 같은 inode를 여러 번 더할 수 있어 절약 효과를 놓친다. 반대로 du 결과만 보면 어느 package 조합에서 중복이 생겼는지 알 수 없다. lockfile hash, uv version, feature flag, cache filesystem 종류를 같은 실행 기록에 붙여야 비교가 성립한다.
공유 runner에서는 정리 주기도 별도 변수다. 설치 직후마다 prune을 실행하면 중복 object가 생존할 시간이 짧아지고 metadata scan 비용이 반복된다. 반대로 무기한 쌓아 두면 더 이상 참조되지 않는 object가 공간을 차지한다. cache hit 비율과 저장 공간 한도를 보고 정리 시점을 정하되, 여러 job이 같은 cache를 읽는 동안 강제 삭제가 어떻게 조정되는지도 작은 부하 시험으로 확인해야 한다. 미리보기 기능을 켰다는 사실 자체가 운영 정책은 아니다.
이번 변경에서 배울 만한 부분은 단순히 "해시를 쓰면 공간이 줄어든다"가 아니다. 내용 주소, hardlink lifetime, cleanup의 참조 판정, 운영체제별 scan 최적화가 한 계약으로 묶여야 한다. 공간 절약 수치보다 이 네 경계를 관찰할 수 있어야 preview 기능을 안전하게 운영할 수 있다.
범위와 주의점
이 글은 uv 0.12.7~0.12.10 release note, 관련 PR 설명과 0.12.10 source tree를 대조했다. 독립 실험은 두 개의 인공 휠과 1.25MB 동일 payload만 사용했다. PyPI의 실제 캐시 분포, 대규모 동시 설치, cache corruption 복구, 각 filesystem의 성능은 재현하지 않았다.
개발자 benchmark의 절약량과 시간은 해당 장비와 fixture의 값이다. 특히 545.2MiB와 약 10%를 일반적인 기대값으로 쓰면 안 된다. 기능이 preview인 동안 cache format과 cleanup 동작도 바뀔 수 있으므로, 운영 환경에서는 uv version과 feature flag를 함께 고정해야 한다.


댓글
댓글 쓰기