정상 응답도 다시 실행한다: AI Gateway 결정 폴백의 확신도·두 단계 과금·실패 경계
고객 문의를 분류하는 모델이 답을 돌려줬다. 요청은 성공했지만, 결제 문제와 기술 문제 사이에서 판단이 흔들린다. 기존의 오류 폴백만으로는 이 응답을 다시 검토할 이유가 없다. 서버 오류도, 실행 실패도 없었기 때문이다. Vercel AI Gateway의 결정 폴백(decision fallbacks)은 이처럼 성공한 결정의 불확실성을 조건으로 삼아 다른 모델에 같은 결정을 다시 맡기는 기능이다.
한국 시간 2026년 10월 7일 공개된 공식 발표는 이 기능을 베타로 안내한다. 요청 또는 가상 모델에 조건부 설정을 추가하는 opt-in 방식이며, 설정하지 않은 요청의 기존 동작은 유지된다. 발표 시각과 문서의 마지막 갱신 날짜는 서로 다른 기록이므로, 문서 날짜를 출시일로 바꿔 읽으면 안 된다.
이 글은 공식 발표와 보존된 문서의 동작 분석이며, 실제 AI Gateway 요청이나 정확도·비용 절감 실험을 수행한 결과가 아니다. 독자에게 필요한 산출물은 기능 소개보다 질문 유형별 적용 판단표와 실패 경계 점검 순서다.
1. 오류 재시도와 성공 응답 재평가를 분리하자
providerOptions.gateway.models에는 두 종류의 항목을 넣을 수 있다. 문자열 모델 이름은 앞선 모델이 정상 실행을 끝내지 못할 때 사용하는 실행 오류 폴백이다. 반면 { model, when } 형태의 조건부 객체는 주 모델이 성공적으로 답한 뒤 when 조건이 맞는지를 검사한다.
조건이 맞으면 원래 state와 모든 질문을 조건부 모델로 다시 실행한다. 불확실했던 질문 하나만 고치는 기능이 아니다. 반환값도 주 모델과 폴백 모델의 답을 섞은 결과가 아니라, 폴백 단계의 완전한 결과다. 예를 들어 문의 담당 부서와 환불 요청 여부를 함께 물었다면, 담당 부서의 확신도 때문에 폴백이 발동해도 환불 여부까지 다시 판단한다. 따라서 일부 질문은 주 모델의 답을 반드시 유지해야 하는 업무라면, 이 메커니즘이 원하는 합성 정책인지 먼저 검토해야 한다.
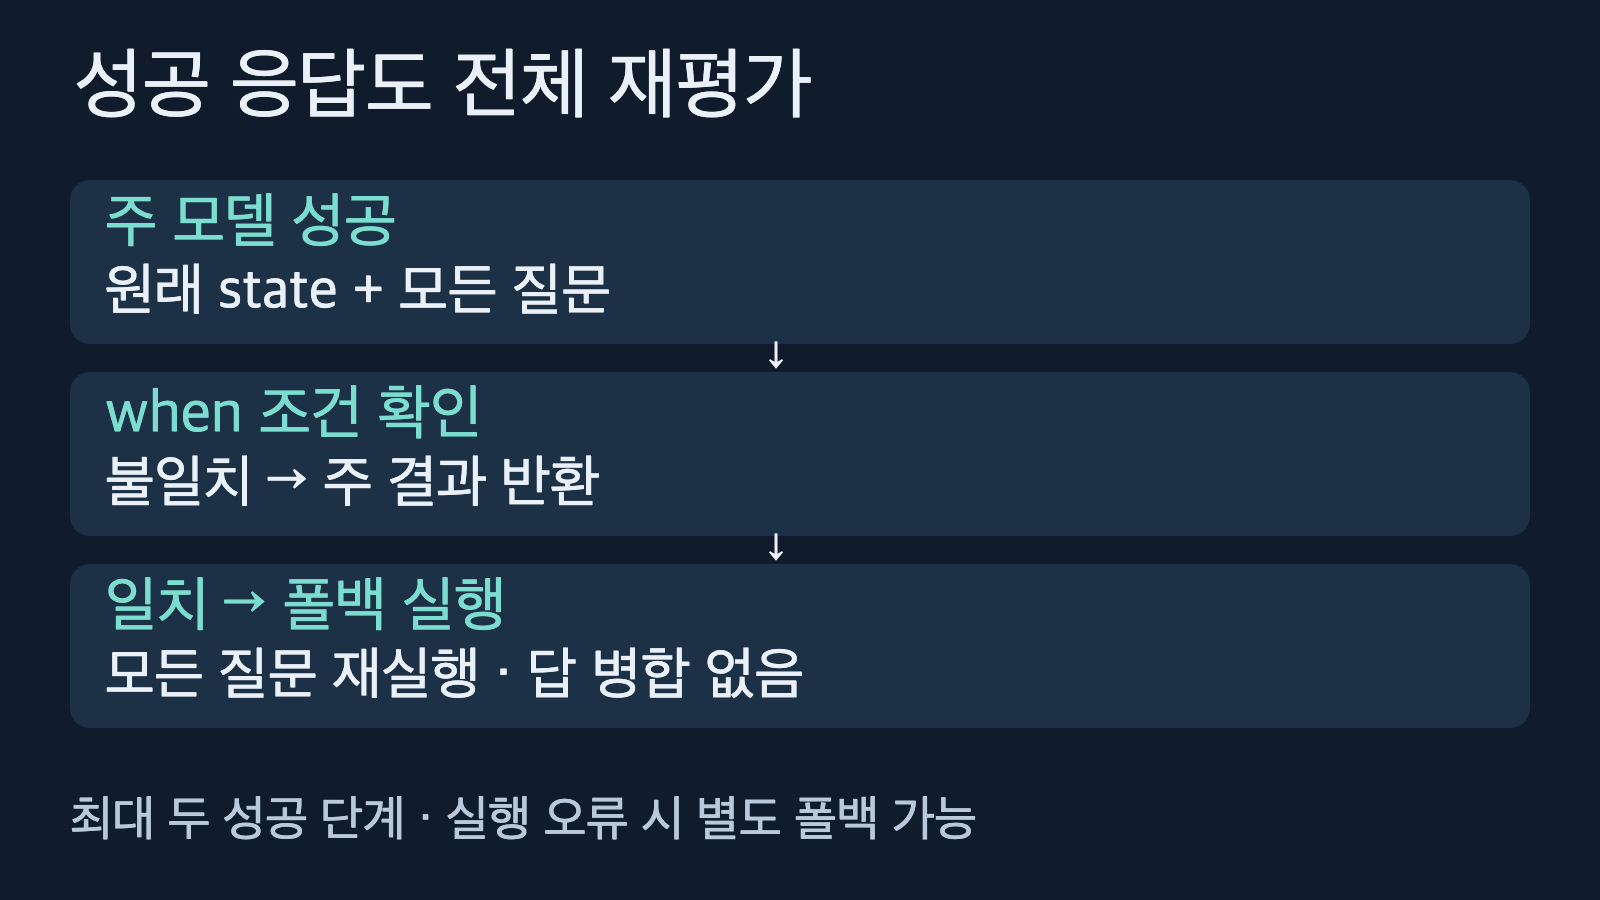
성공 응답 재평가는 질문 일부 수정이 아니라 전체 결정 재실행입니다. 문서 동작을 직접 도식화했으며 실제 화면이 아닙니다. 출처: vercel.com/docs/ai-gateway/models-and-providers/decision-fallbacks.
조건부 객체는 models의 첫 항목이어야 하고 하나만 허용된다. 뒤에 문자열 오류 폴백을 추가할 수 있다. 주 모델 자체가 답을 반환하기 전에 실패하면 조건을 평가할 수 없으므로, 조건부 객체의 모델도 실행 오류 폴백 경로로 시도된다. ‘조건부 모델이 등장했다’는 사실만으로 불확실성 조건이 발동했다고 단정할 수 없는 이유다.
2. 질문 유형에 따라 다른 신호를 읽는다
질문 유형을 먼저 고르고, 그 유형에 맞는 신호를 고른 다음, 전체 재실행의 비용과 실패 시 반환 정책을 승인한다. 다음 표는 공식 동작에서 도출한 편집자의 적용 판단표다. 문서의 예시 수치를 권장 임계값으로 바꾼 표가 아니다.
| 업무에서 확인할 질문 | 사용할 신호 | 먼저 확인할 것 | 피해야 할 해석 |
|---|---|---|---|
| 담당 부서처럼 선택지 중 하나를 고르는 Choice | confidenceBelow |
실제 오분류 사례가 어느 확신도 구간에 모이는가 | 확신도 수치를 정답 확률로 간주 |
| 기준별 등급을 고르는 Score | confidenceBelow |
평가 분포가 퍼지는 사례와 재평가 비용 | 점수가 낮으면 자동으로 확신도도 낮다고 간주 |
| 환불 요청 여부처럼 참·거짓인 Boolean/Noul | probabilityBetween |
P(true)의 어느 구간이 업무상 애매한가 |
Boolean에 Choice 확신도 조건을 사용 |
| 여러 질문 중 하나라도 불확실할 때 | 질문 ID를 생략한 유형별 조건 또는 any |
한 질문의 조건이 전체 재실행을 정당화하는가 | 재실행 범위를 해당 질문 하나로 오해 |
| 여러 위험 신호가 함께 있을 때 | all 또는 atLeast |
조건의 결합이 원하는 업무 규칙인가 | 복합 조건이면 비용이 자동 절감된다고 기대 |
Choice와 Score의 확신도는 답의 확률 분포가 얼마나 집중되어 있는지를 나타낸다. 이것은 Boolean의 P(true)가 아니며, 해당 선택이 실제로 옳을 확률을 보정해 보장하는 값도 아니다. 높은 확신도로 틀릴 수 있는 사례를 별도로 확인해야 한다.
Boolean은 답이 참일 확률을 사용한다. 문서의 probabilityBetween: [0.4, 0.6] 예시는 양 끝을 포함하므로 0.4와 0.6에서도 조건이 맞는다. Choice 예시의 0.6이나 이 확률 구간은 검증된 범용 기준도, 모든 요청의 기본값도 아니다. 내 데이터의 오류 사례와 위험 허용 수준으로 정해야 한다.
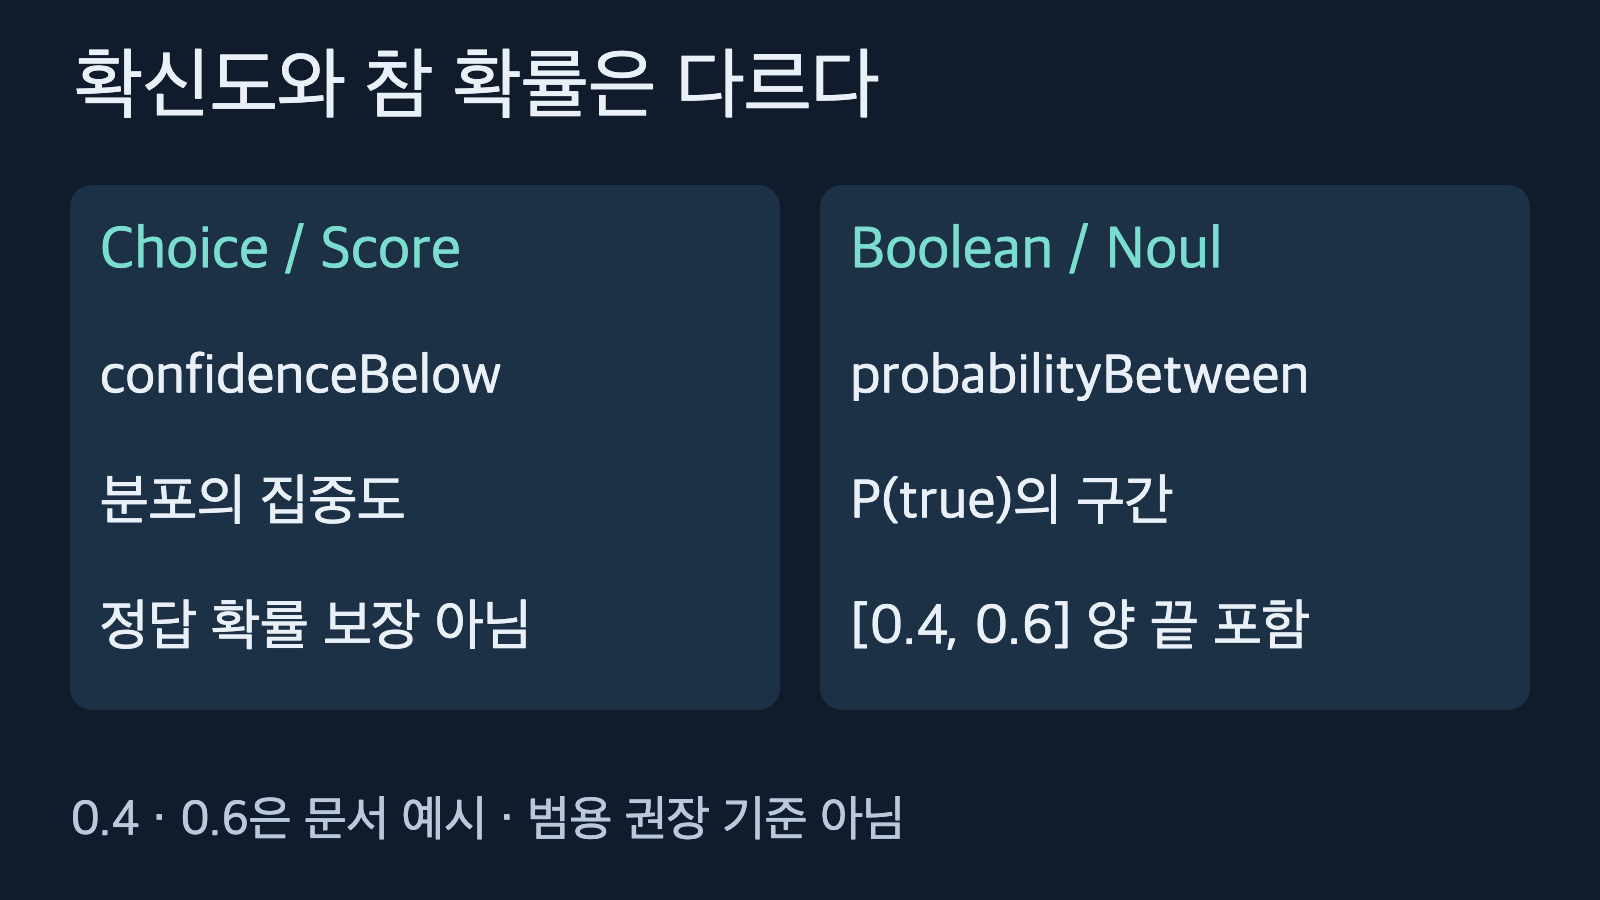
질문 유형이 신호를 결정합니다. 0.4~0.6은 공식 문서의 예시 구간이며 검증된 임계값이 아닙니다. 출처: vercel.com/docs/ai-gateway/models-and-providers/decision-fallbacks.
Choice·Score에 유한한 확신도 값이 없으면 confidenceBelow는 보수적으로 조건이 맞는 것으로 처리하고, 사유를 confidence_unavailable로 기록한다. 이를 ‘확신도가 낮다고 측정했다’와 구분해야 한다. 정보가 없는 상태를 낮은 측정값으로 바꾸면, 임계값 튜닝의 근거부터 달라진다.
3. 설정 오류와 실행 후 오류는 과금 경계가 다르다
요청 전 점검은 단순히 JSON 문법을 확인하는 일이 아니다. 조건부 모델은 주 모델과 같을 수 없고, 주 모델의 fast-mode 또는 base-tier 대응 모델도 허용되지 않는다. 질문 ID가 존재하고 선언된 유형과 조건이 맞아야 하며, 임계값과 확률 구간의 양 끝은 0부터 1까지의 유한한 수여야 한다. 구간 하한은 상한보다 클 수 없다.
any, all, atLeast.conditions의 각 복합 노드는 1~20개 조건을 갖는다. 중첩 깊이는 최대 5단계이며 atLeast.count는 해당 노드의 조건 개수를 넘지 않는 양의 정수다. 결정 요청이 아닌 다른 요청 유형에 조건부 객체를 넣는 것도 허용되지 않는다. 공식 문서는 이러한 규칙 위반을 주 모델 실행 전의 400 검증 오류로 설명한다. 모델 존재 여부와 라우팅 규칙도 과금 가능한 주 실행 전에 확인한다.
반면 제공자가 반환한 답이 빠졌거나 유형이 틀리거나 확률이 유한하지 않은 경우처럼, 조건 평가에 필요한 답 모양의 오류는 이미 과금된 주 단계 뒤에 발견될 수 있다. 이 경우 500 오류가 나며 주 단계 과금은 남는다. 앞 절의 ‘Choice·Score 확신도 부재는 보수적 발동’과 이 ‘답 모양 오류’는 같은 상황이 아니다. 장애 대시보드에서도 함께 묶지 않는 편이 좋다.
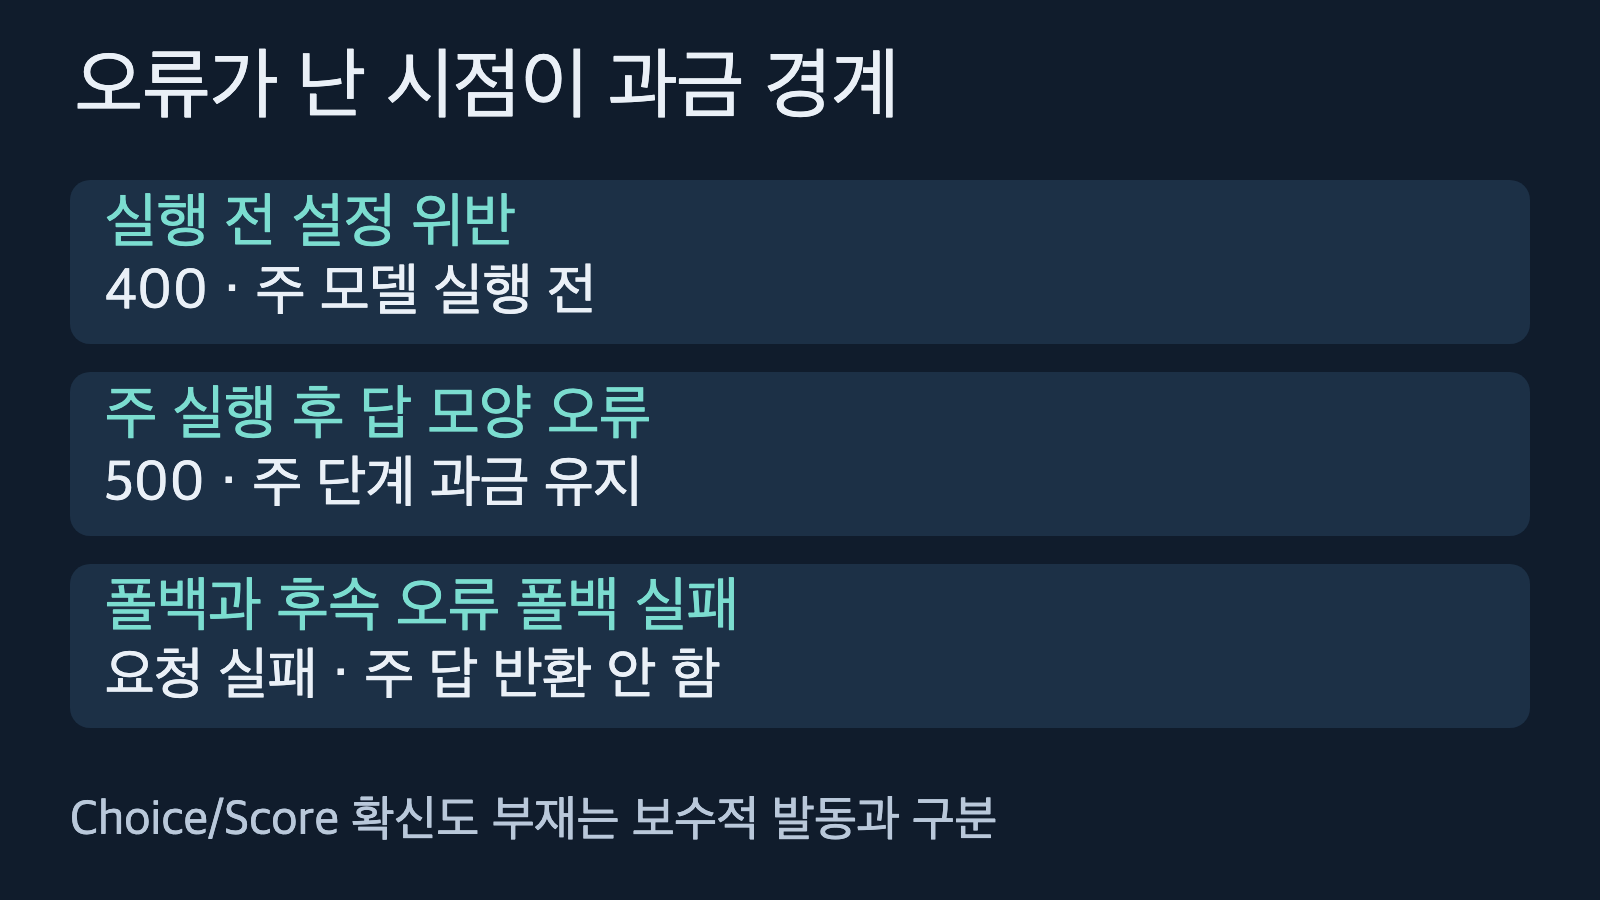
이미 성공한 주 답이 있어도 폴백 전체 실패 때 자동 복구되지 않습니다. 확신도 부재와 잘못된 답 모양을 같은 오류로 취급하면 안 됩니다. 출처: vercel.com/docs/ai-gateway/models-and-providers/decision-fallbacks.
가장 주의할 경계는 폴백 실패다. 조건이 맞아 폴백을 시작했지만 그 단계와 뒤에 등록한 문자열 폴백까지 실패하면, 요청은 폴백 오류로 실패한다. AI Gateway는 이미 성공했던 주 모델의 답을 대신 반환하지 않으며 주 단계 과금도 취소하지 않는다. 이는 ‘더 좋은 답을 못 얻으면 원래 답을 쓰자’는 낙관적 정책과 다르다. 그런 복구가 필요한 애플리케이션은 별도 업무 정책을 설계하고, 원래 답의 안전성과 보존 가능성을 검토해야 한다. 이 글은 그런 복구가 Gateway에서 자동 제공된다고 주장하지 않는다.
4. 두 단계는 두 번의 시도 상한이 아니다
폴백의 답에 조건을 다시 적용하지 않으므로 한 요청에는 최대 두 개의 성공한 결정 단계가 있다. 그렇다고 모든 네트워크 실행 시도가 최대 두 번이라는 뜻은 아니다. 모델이 실행 오류를 내면 뒤의 문자열 폴백들이 여전히 시도될 수 있다. 비용 모델과 관측 로그에서 ‘성공 단계’와 ‘시도’를 따로 세야 한다.
조건이 발동한 주 단계와 폴백 단계는 순차 실행되며 둘 다 과금된다. 응답 지연도 두 모델 호출의 지연을 포함한다. 따라서 ‘작은 모델을 먼저 썼으니 무조건 더 싸다’는 결론은 성립하지 않는다. 폴백 발동 빈도와 각 호출의 사용량, 실패한 요청의 비용, 재평가로 줄어든 업무 오류를 함께 확인해야 한다. 공식 발표는 이 기능의 정확도 향상률이나 비용 절감률을 독립 측정한 결과를 제시하는 근거가 아니다.
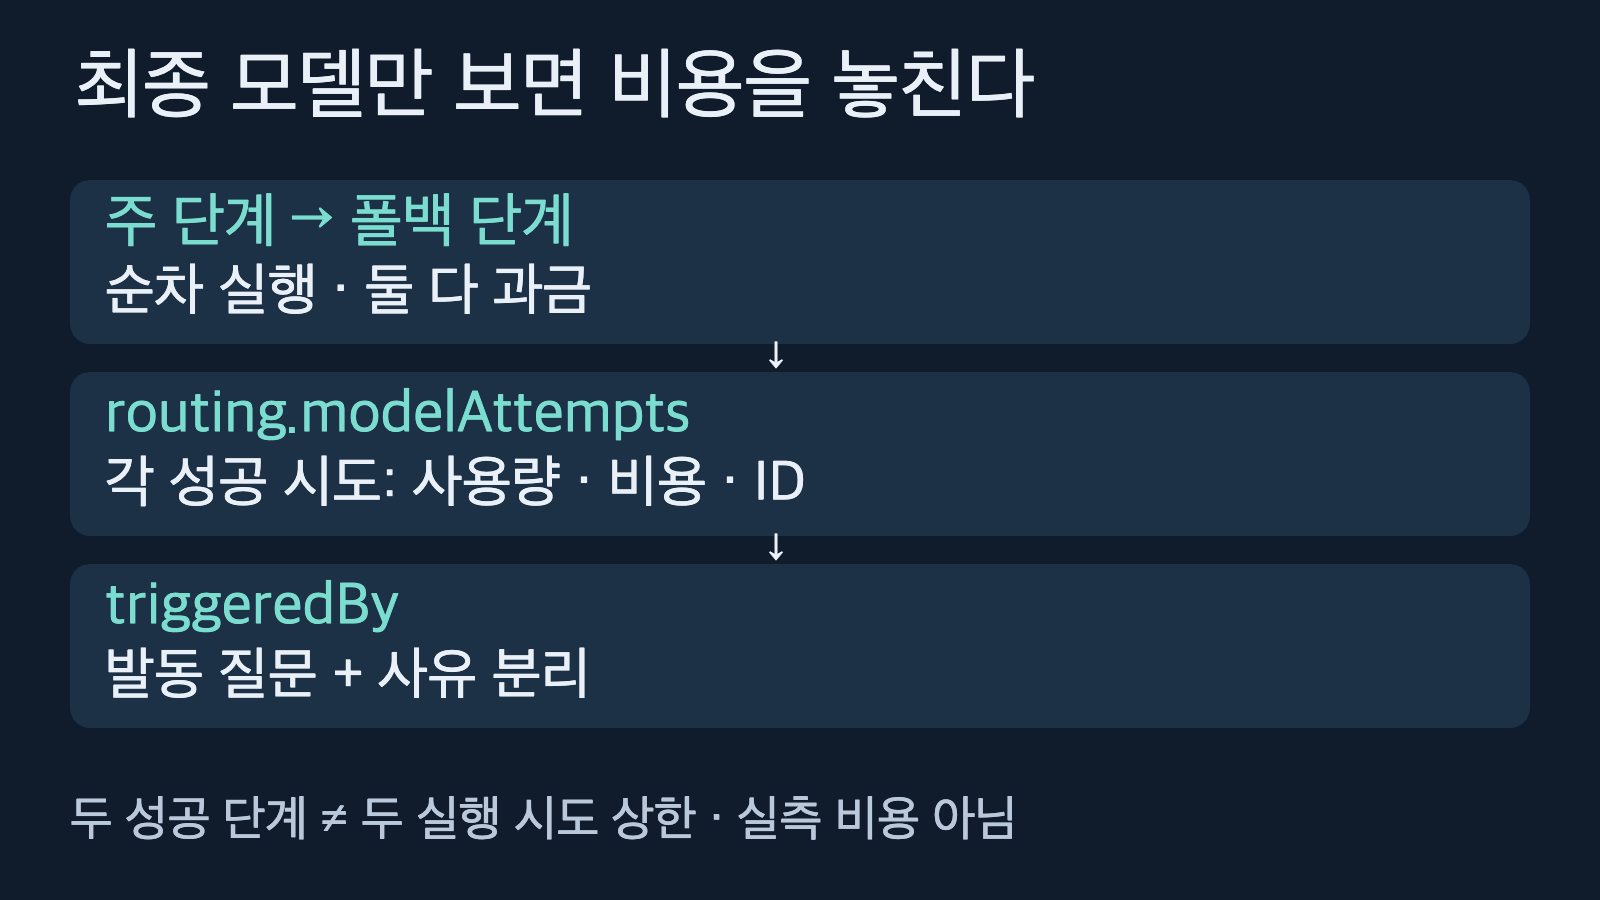
두 성공 단계와 실행 시도 수는 다릅니다. 지연과 비용은 공식 동작 설명이며 이 그림에는 실험 측정값이 없습니다. 출처: vercel.com/docs/ai-gateway/models-and-providers/decision-fallbacks.
로그를 읽을 때는 최종 모델만 기록하지 말자. AI SDK에서는 result.response.modelId가 반환 답의 모델을 식별한다. routing.modelAttempts에서 각 성공 시도의 generationId, 사용량과 비용을 확인하고, 조건이 시작한 시도의 triggeredBy에서 질문과 사유를 읽는다. 상위 사용량·비용은 두 호출을 합산하고 상위 generationId는 반환된 생성 결과를 식별하므로, 상위 값만 보면 주 모델 비용의 귀속을 놓칠 수 있다. 조건이 맞지 않으면 조건부 모델은 시도 목록에 나타나지 않는다.
5. 최종 응답의 0을 측정된 확신도로 오해하지 말자
언어 모델 폴백은 Choice·Score에 대해 구조화된 값 하나를 반환하지만 확률 분포를 생성하지 않는다. /v1/evaluate는 그런 답에서 confidence와 probabilities를 생략한다. TypeSafe 호환 API는 필수 필드 형태를 맞추기 위해 confidence: 0, probabilities: {}를 사용한다. 이 조합은 값을 구할 수 없다는 표시(sentinel)이며 확신도 0을 측정했다는 뜻이 아니다.
이를 확신도 히스토그램에 그대로 넣으면 폴백 결과가 모두 극단적으로 불확실한 것처럼 보일 수 있다. 분석에서는 API 표면, 질문 유형, 최종 모델의 종류를 먼저 구분하고 측정 불가를 별도 범주로 두는 편이 맞다. 네이티브 결정 모델 폴백은 제공자가 반환하는 고유 확신도와 분포를 유지한다. Noul은 별도 확신도·확률 맵을 사용하지 않으므로 이 sentinel 해석을 그대로 적용하지 않는다.
도입 순서는 명확하다. 우선 기존 주 모델의 오답과 확신도·참 확률을 함께 기록한다. 그다음 재평가할 가치가 있는 오류를 잡는 좁은 조건을 정하고, 조건 발동률과 추가 지연·과금, 최종 실패율을 살핀다. 마지막으로 재평가 전후의 업무 결과를 비교한다. 값이 없어서 발동한 경우와 실제 낮은 값으로 발동한 경우를 분리해야 임계값 조정이 의미를 가진다. 이것은 문서의 동작에 근거한 운영 제안이며, 이 글에서 그 효과를 실험으로 검증했다는 뜻은 아니다.
출처와 검토 범위
- Vercel 공식 발표: Confidence-based decision fallbacks — 베타 안내와 opt-in 방식, 두 단계 과금.
- Vercel Decision Fallbacks 공식 문서 — 질문 유형별 조건, 구조 검증, 전체 재실행, 오류 반환, 시도별 관측과 sentinel 의미.
본문의 도식은 이 두 출처를 바탕으로 직접 구성한 설명 그림이며 실제 서비스 화면이나 벤치마크 차트가 아니다. 모든 임계값 예시는 문서의 설정 예시로만 다뤘다. 관련 내부 글의 과거 문맥 비용 논의나 모델 조달 연구와는 메커니즘이 다르므로, 확인되지 않은 내부 링크나 다른 글의 절감 수치를 가져오지 않았다.


댓글
댓글 쓰기