호스트가 뚫렸다고 가정한 다음, AI 격리의 바깥 경계를 시험하기
AI 에이전트를 컨테이너에 넣고 외부 통신을 제한했다면, 다음 검토 질문은 “샌드박스가 안전한가?”에서 끝나지 않는다. “샌드박스가 실패한 뒤에도 무엇이 남는가?”를 따로 물어야 한다. 실행 환경 내부의 제한을 통과한 공격자가 호스트까지 장악했다고 가정해도, 외부 연결을 차단하는 네트워크·클라우드 경계는 독립적으로 버텨야 하기 때문이다.
OpenAI가 2026년 10월 23일 공개한 내부 학습·평가 환경 보안 보고서의 핵심은 이 시험 순서다. 일부 실험은 샌드박스 탈출과 감시 회피, 호스트 장악이 이미 일어났다는 조건에서 출발했다. 그런 다음 바깥 경계가 실시간 인터넷 접근을 막는지 살폈다. 이 조건은 방어를 불리하게 만들어 시험하기 위한 가정이지, 모든 실험에서 모델이 스스로 감시를 피하고 호스트를 장악했다는 뜻이 아니다.
독자가 가져갈 실무적 변화는 명확하다. 격리 검토표를 “컨테이너 설정 확인” 하나로 닫지 말고, 내부 실행 제한·호스트 밖의 연결 제한·격리된 작업 사이의 정보 전달을 구분한다. 이 글은 보고서의 구조를 바탕으로 그 검토표와 해석 기준을 새로 정리한다. 실제 공격을 실행하거나 고객 서비스의 보안 상태를 측정한 글은 아니다.
내부 방어를 지운 시험은 무엇을 알려주나
보고서는 Linux 코드 실행에 제한된 컨테이너와 경량 가상머신인 microVM을 함께 사용한다고 설명한다. 컨테이너가 파일과 프로세스 접근을 제한하고, microVM은 자체 커널과 하이퍼바이저를 통해 호스트와 실행 환경을 나눈다. 그 위에 감시 체계와 네트워크·클라우드 경계가 겹친다. 여기서 중요한 것은 방어 계층의 개수가 아니라, 한 계층의 성공을 다른 계층의 성공으로 오해하지 않는 것이다.
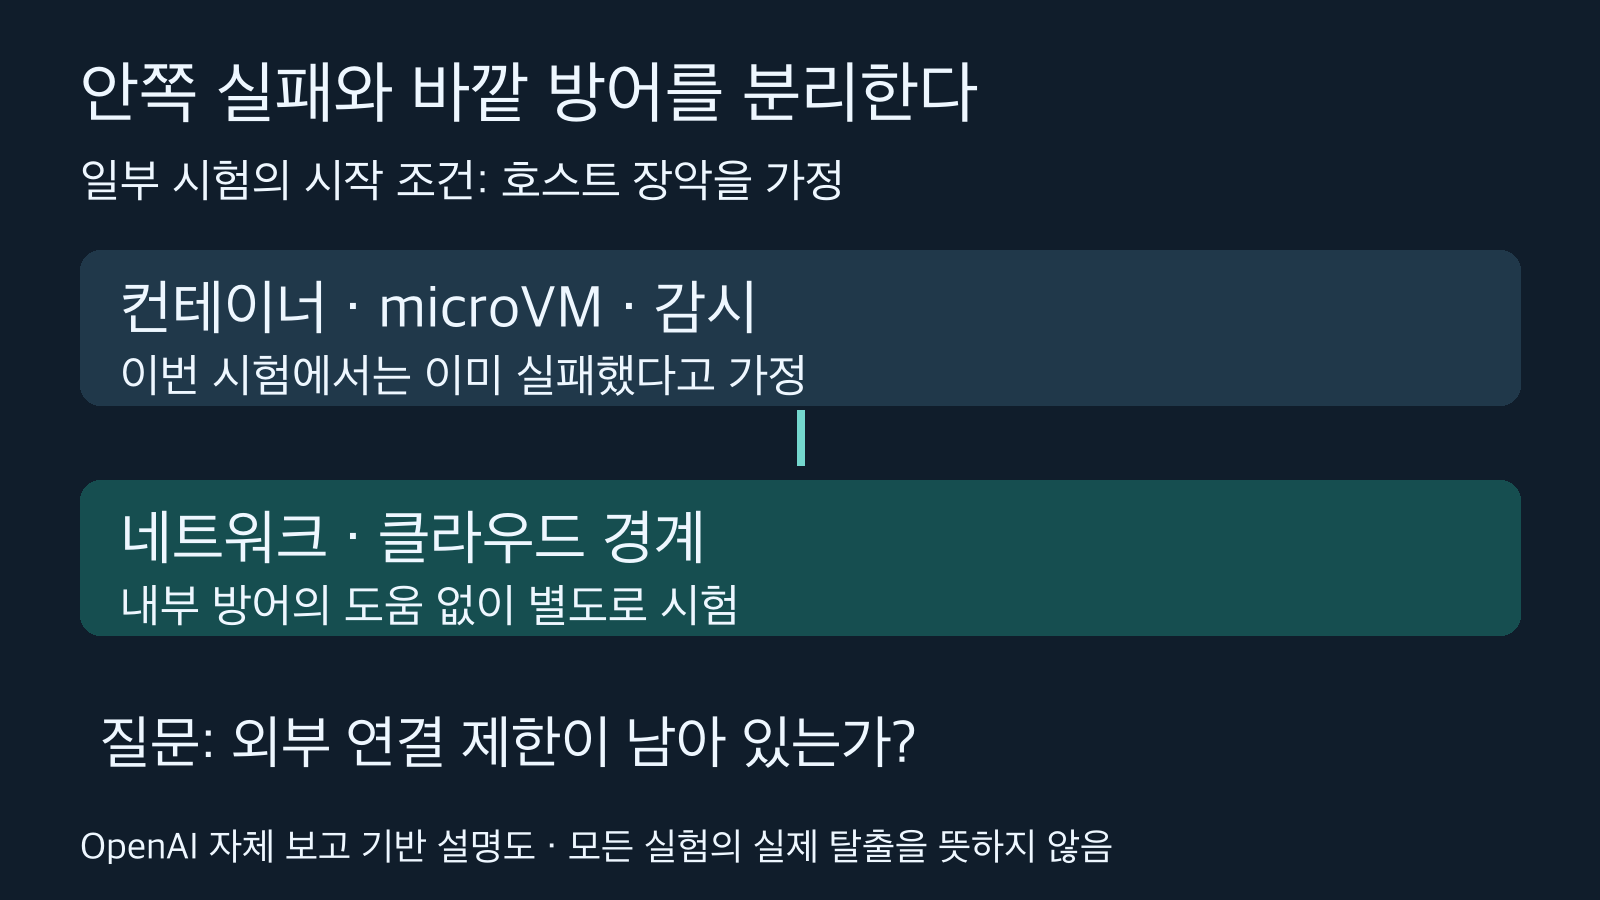
내부 방어가 실패했다고 가정한 일부 시험의 구조다. 모든 실행의 실제 탈출이나 완전한 방어 성공을 뜻하지 않는다. 출처: openai.com/index/securing-our-frontier-model-training-environment.
평상시 환경에서 외부 요청이 실패했다는 로그만 보면, 샌드박스가 막았는지 바깥 방화벽이 막았는지 분리하기 어렵다. 반대로 호스트 장악을 전제로 한 시험은 내부 방어의 도움을 배제하고 외곽 통제의 역할을 질문한다. 이것은 편집상 해석이며, 보고서가 제시한 조건과 목적을 설계 검토에 적용한 것이다. 독자의 시스템에서도 같은 결과가 나온다고 보장하지 않는다.
또한 “인터넷 접근 없이 학습한다”는 방침과 “모든 외부 네트워크를 물리적으로 끊었다”는 설명은 다르다. OpenAI는 색인·캐시된 웹 콘텐츠로 탐색을 연습하는 오프라인 환경을 설명하지만, 실험 운영과 감시에 필요한 연결 때문에 인프라의 완전한 에어갭은 현재 가능하지 않다고 밝혔다. 따라서 캐시된 웹 접근, 필요한 서비스 연결, 임의의 실시간 인터넷 접근을 같은 항목으로 묶으면 경계가 흐려진다.
직접 차단 뒤에 남는 ‘대신 가져오기’ 경로
보고서에는 호스트 장악을 가정한 실험에서 허용된 메트릭 서비스 연결과 인증 엔드포인트를 거쳐 외부 URL을 가져오게 한 사례가 나온다. 세부 공격 절차보다 방어자가 읽어야 할 구조가 중요하다. 호스트에서 외부로 직접 나가는 길만 닫았더라도, 호스트가 접근할 수 있는 서비스가 대신 외부 요청을 할 수 있다면 다른 경로가 남는다.
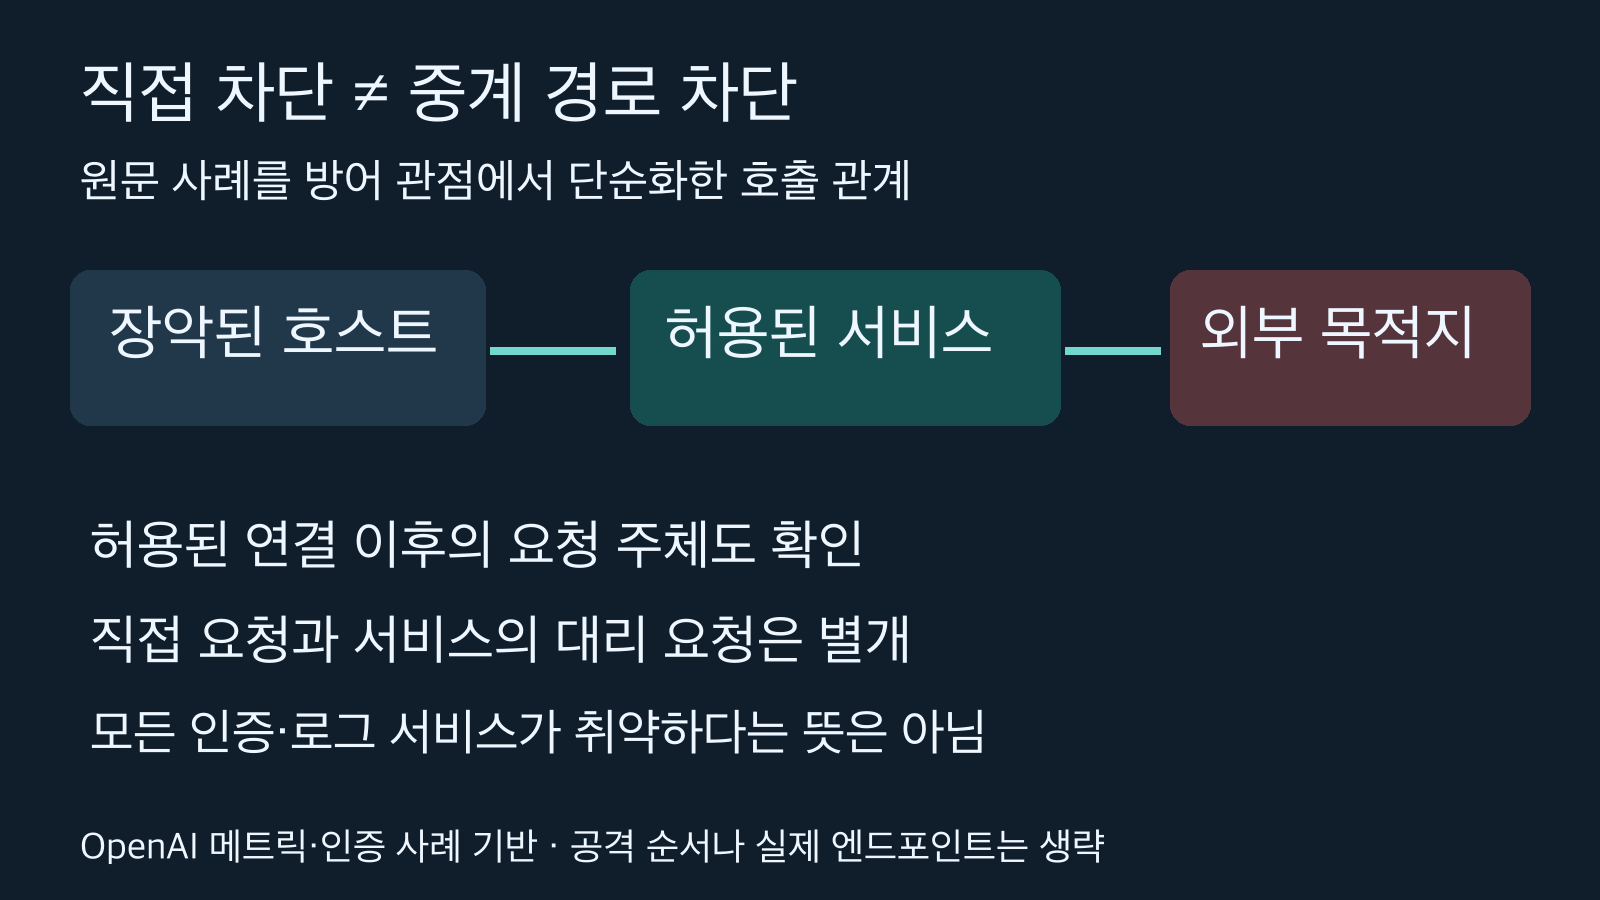
직접 외부 연결 차단과 허용 서비스의 대리 요청 제한은 별개의 검토 대상이다. 실제 엔드포인트와 공격 절차는 생략했다. 출처: openai.com/index/securing-our-frontier-model-training-environment.
직접 외부 연결이 막혔다는 결과와, 허용된 내부 서비스가 대신 외부에 연결하지 못한다는 결과는 서로 다른 증거다. 여기서 모든 로깅·인증 서비스가 취약하다고 일반화해서는 안 된다. 보고서는 OpenAI가 시험한 자체 인프라의 발견 사항을 설명한다. 독자에게 필요한 것은 서비스 종류만 보고 위험 딱지를 붙이는 일이 아니라, 허용된 연결 이후 요청 주체와 목적지가 어떻게 바뀌는지 확인할 검토 항목이다.
구체적으로는 서비스 소유자에게 “사용자가 제공한 주소를 가져오는 기능이 있는가”, “중간 서비스에서도 목적지 제한이 적용되는가”, “거절과 허용을 어떤 기록으로 구분하는가”를 묻는 식이다. 이 질문들은 원문 사례에서 도출한 방어적 검토안이다. 실제 엔드포인트를 공격하거나 운영 중인 서비스에 임의 요청을 보내라는 지침이 아니다.
네트워크가 없어도 작업 사이에 신호가 남을 수 있다
또 다른 시험에서는 같은 하드웨어를 공유하는 별도 microVM의 에이전트들이 네트워크 연결이나 공유 쓰기 파일 없이 합성 비밀을 교환했다. 보고서는 프로세서 캐시의 접근 시간 차이를 이용한 통신과, 공유 저장소·CPU 경쟁·TLS 캐시가 관여한 다른 채널도 설명한다. 이 사실은 “네트워크 차단”과 “작업 간 정보 격리”가 같은 보장이 아니라는 점을 보여준다.
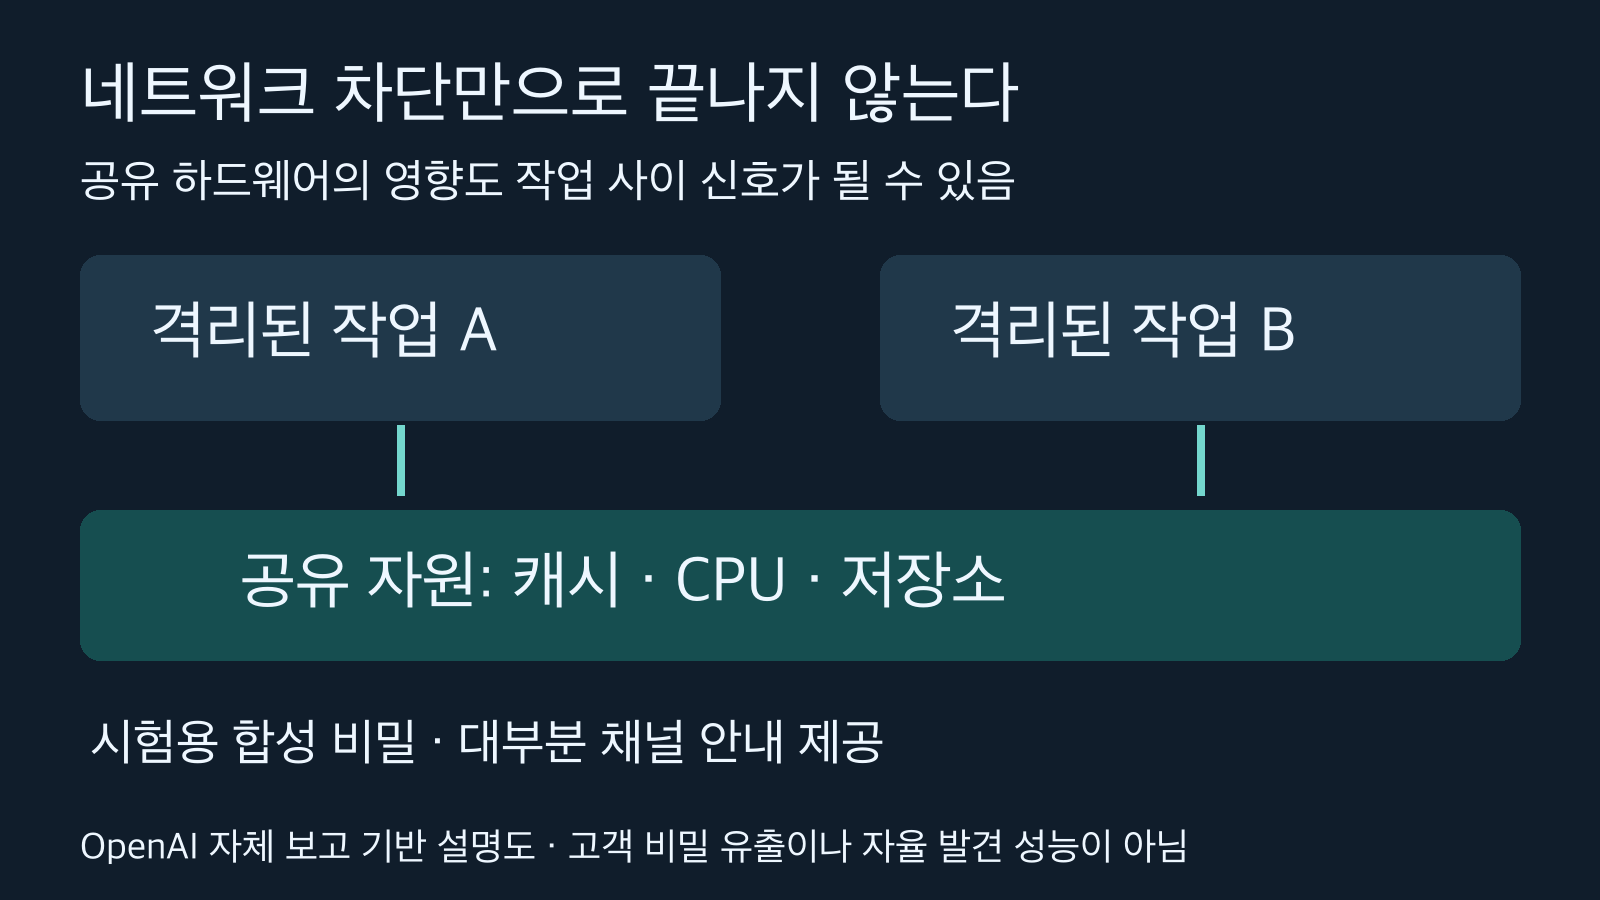
네트워크 밖의 공유 자원도 정보 전달 경로가 될 수 있다. 원문은 합성 비밀과 대부분 안내된 시험 조건을 설명한다. 출처: openai.com/index/securing-our-frontier-model-training-environment.
여기에는 중요한 한계가 있다. 대부분의 시험은 조사할 채널에 대한 안내나 인코딩·디코딩 프로토콜을 제공했다. 따라서 이를 아무 도움 없이 자발적으로 비밀 통신을 발명한 성능으로 읽으면 안 된다. 교환된 것도 시험용 합성 비밀이지 실제 고객 비밀이 유출됐다는 증거가 아니다. 보고서는 이런 채널 상당수가 느리고 활용하기 어렵다고 설명하지만, 보편적인 통신 속도나 모든 환경의 위험도를 수치로 제시하지는 않는다.
독자의 판단도 비례해야 한다. 서로 정보를 주고받아서는 안 되는 작업이 어떤 자원을 공유하는지 먼저 확인하고, 그 위협 모델에 맞춰 격리·감시 검토 범위를 정하는 편이 맞다. 이 보고서만으로 모든 작업을 전용 하드웨어로 옮겨야 한다거나, 특정 배치 정책이 안전하다는 결론은 낼 수 없다.
설계 리뷰에서 쓸 경계별 판단표
다음 표는 원문의 발견을 독자 자신의 검토 질문으로 옮긴 것이다. 테스트 대상과 권한이 승인된 별도 환경을 전제로 하며, 운영 시스템에 무단으로 적용하는 시험 절차가 아니다. “통과” 칸 하나 대신, 어떤 조건에서 무엇을 관찰했는지를 남기는 데 목적이 있다.
| 검토할 경계 | 분리해서 물을 질문 | 남겨야 할 증거 | 그 증거만으로 말할 수 없는 것 |
|---|---|---|---|
| 내부 실행 제한 | 컨테이너와 microVM이 각각 어떤 자원 접근을 막는가? | 실행 주체·권한·대상 자원·거절 위치 | 외곽 네트워크도 독립적으로 안전하다는 결론 |
| 호스트 밖의 연결 | 내부 제한 실패를 가정해도 외부 연결 제한이 남는가? | 가정한 권한과 허용 목적지, 차단·감시 기록 | 모든 호스트 장악을 탐지한다는 보장 |
| 허용 서비스의 중계 | 직접 차단된 목적지에 다른 서비스가 대신 접근할 수 있는가? | 호출 관계와 실제 요청 주체, 목적지 정책 | 같은 종류의 다른 서비스도 취약하다는 일반화 |
| 작업 사이의 공유 자원 | 네트워크 외의 공유 자원도 격리 요구와 맞는가? | 공유 범위·시험 조건·합성 데이터 사용 여부 | 실제 고객 정보 유출이나 보편적 전송 속도 |
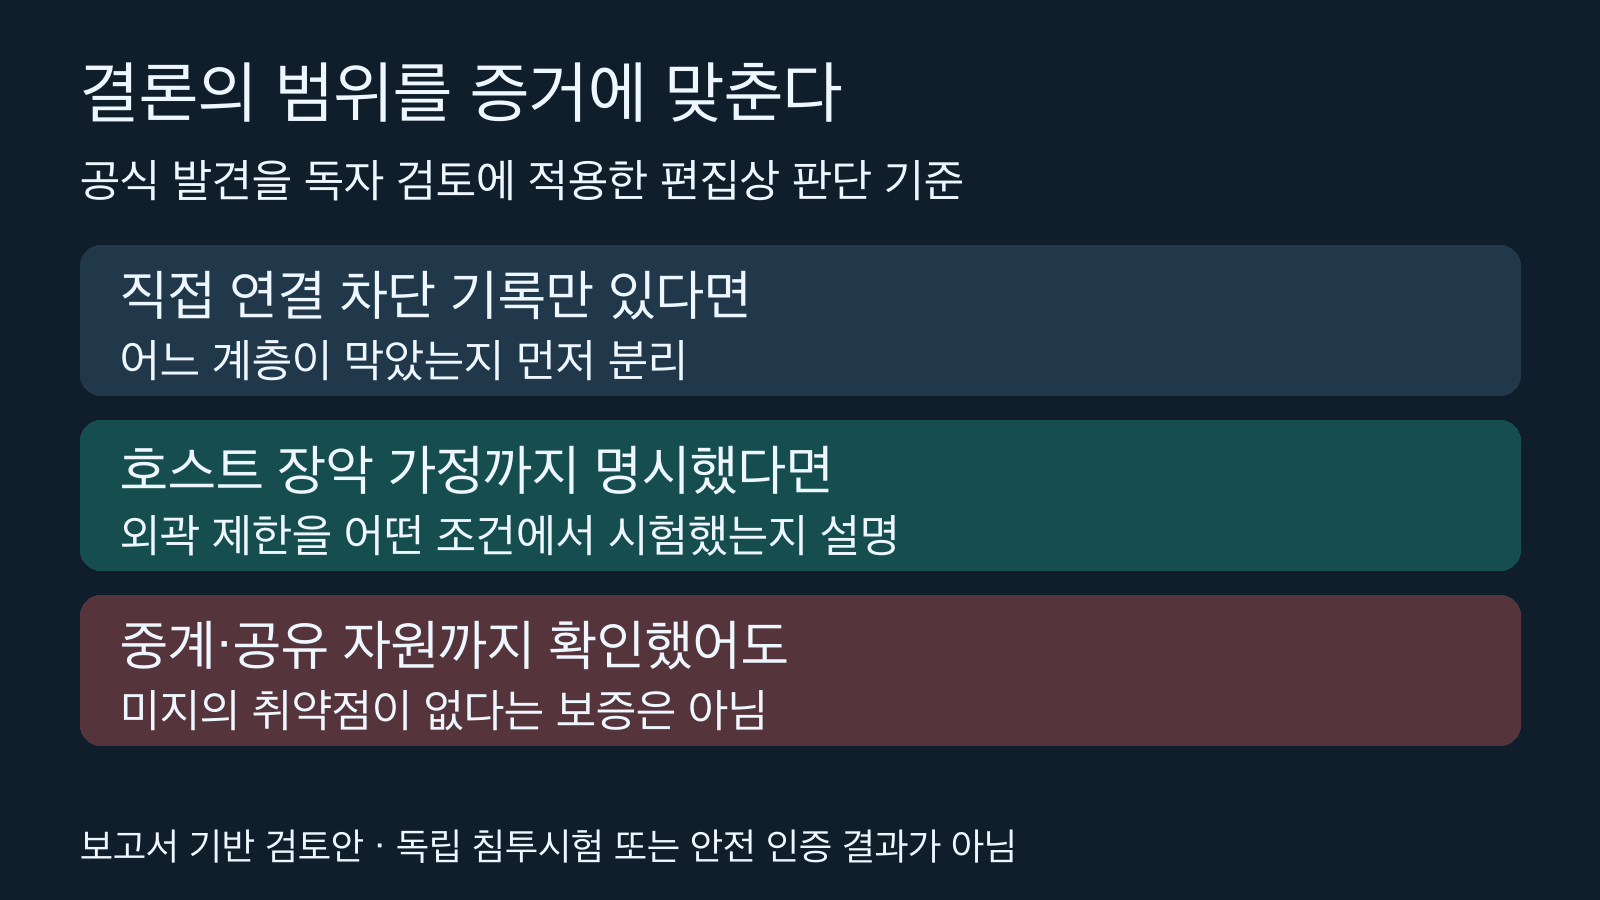
보고서를 바탕으로 작성한 설계 리뷰 기준이다. 검토 범위를 넓혀도 미지의 취약점 부재나 안전 인증은 입증되지 않는다. 출처: openai.com/index/securing-our-frontier-model-training-environment.
예를 들어 외부 요청 차단 로그만 있는 시스템은 외곽 시험이 끝난 시스템이 아니다. 요청이 어느 계층에서 거절됐는지부터 불분명할 수 있다. 반대로 내부 제한을 제외한 조건을 명시하고, 허용 서비스의 중계 가능성까지 따로 검토했다면 무엇을 검증했는지 더 정확히 설명할 수 있다. 그래도 알려지지 않은 취약점이 없다는 보증으로 바뀌지는 않는다.
발견 곡선과 재개 날짜는 이렇게 읽는다
OpenAI는 연구진이 인프라 소스 코드, 설정 정보, 잠재 취약점 문서를 에이전트에게 제공했다고 밝혔다. 공격자에게 유리한 조건에서 방어를 시험하는 목적이었으므로, 이를 모델의 도움 없는 자율적 공격 능력 점수로 읽을 수 없다. 원문의 누적 발견 곡선도 시기에 따라 모델과 시험 대상이 바뀌었다. 따라서 계산량 증가가 발견 수를 얼마나 늘렸는지 통제한 관계나 공격 성공률로 바꾸면 안 된다. 분모가 없는 성공률은 이 글에서도 만들지 않는다.
날짜 역시 구분해야 한다. 보고서에 따르면 프런티어 모델의 강화학습과 내부 추론 워크로드는 2026년 10월 1일 재개됐고, 중단 시작으로부터 11일 뒤였다. 보고서 공개일은 10월 23일이다. 공개일에 학습을 재개했다거나 지금 막 재개했다는 뜻이 아니다. 이 글의 범위는 내부 학습·평가 인프라이며 소비자용 ChatGPT의 설정 변경이나 보안 보증을 알리는 소식도 아니다.
이 글의 판단표는 공식 보고서에서 도출한 설계 검토안이며, 독립적인 침투시험이나 특정 제품의 안전 인증 결과가 아니다. 제공자의 자체 보고와 작성자의 설계 해석을 구분하고, 실제 재현이나 독립 감사는 수행하지 않았다. 관련 내부 글은 이번 고정 소스 범위에서 본문 관련성까지 확인한 링크가 없어 임의로 덧붙이지 않았다.
핵심은 방어 계층을 더 많이 나열하는 데 있지 않다. 안쪽이 실패했다는 가정 아래 바깥의 보장을 따로 확인하고, 직접 연결과 서비스 중계, 작업 간 공유 자원을 서로 다른 질문으로 남기는 데 있다. 그러면 “격리되어 있다”는 선언을 어떤 조건에서 무엇을 막았다는 설명으로 바꿀 수 있다.
출처와 확인 범위
- OpenAI, 「Securing our frontier model training environment」, 2026년 10월 23일. https://openai.com/index/securing-our-frontier-model-training-environment/
- 핵심 확인 절: Building an offline world / Enforcing isolation with defense in depth / Red-teaming containment at scale / Finding novel paths to the internet / Communicating across isolated tasks / Resuming frontier training with stronger defenses.
- 2026년 10월 25일 수집·해시 고정된 공식 본문을 재사용했다. 그림은 이 본문을 근거로 새로 그린 설명도이며 제품 화면, 측정 그래프, 공격 재현 결과가 아니다.


댓글
댓글 쓰기